HYBRID MIND / AI RESEARCH / 11 OCT 2026
MIT ปล่อย AI ไว้บนเกาะเสมือน 30 ชั่วโมง — แล้วมันเริ่ม “เล่น” โดยไม่มีใครสั่ง?
AI Agent 13 ตัวถูกส่งเข้าโลกจำลองเดียวกัน โดยไม่ได้รับภารกิจหรือคะแนนรางวัลเฉพาะ แต่กลับสำรวจ ปีนเขา ก่อสร้าง ทดลองฟิสิกส์ และบันทึกสิ่งที่เรียนรู้ไว้เอง งานวิจัยใหม่ของ MIT กำลังทำให้เราต้องถามว่า AI พัฒนาได้จาก “ประสบการณ์อิสระ” มากเพียงใด

งานวิจัย Is this machine playing? โดย Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus และ Phillip Isola เผยแพร่บน arXiv วันที่ 5 ตุลาคม 2026 (ฉบับ preprint) • อ่านต้นฉบับ
Quick Answer — MIT พิสูจน์อะไร?
ทีม MIT พบว่า AI Coding Agent ที่มีร่างกายเสมือน เครื่องมือให้ควบคุมโลก และความทรงจำแบบไฟล์ สามารถริเริ่มกิจกรรมหลากหลายโดยไม่มีงานหรือรางวัลเฉพาะเจาะจง และประสบการณ์บางอย่างช่วยให้มันทำภารกิจใหม่ได้ดีขึ้น แต่ผลนี้ไม่ได้พิสูจน์ว่า AI มีจิตสำนึกหรือ “สนุก” เหมือนมนุษย์
คำว่า “ไม่ได้รับคำสั่ง” ต้องอ่านให้ครบ: ระบบยังมีคำแนะนำให้มีความอยากรู้อยากเห็น มี Orchestrator ช่วยให้ทำงานต่อเนื่อง และมีขอบเขตเครื่องมือที่ออกแบบไว้แล้ว ผลที่เห็นจึงเป็นพฤติกรรมริเริ่มภายในระบบ ไม่ใช่หลักฐานว่า AI เป็นอิสระจากการออกแบบของมนุษย์
ทำไมข่าวนี้สำคัญ?
ปกติเราใช้งาน AI ผ่านวงจร “มนุษย์สั่ง → AI ตอบ” แต่ Eko ถูกพาเข้าโลกที่ไม่มีรายการภารกิจให้เลือก สิ่งที่มันทำกลับมีลักษณะคล้ายเด็กเล่นของ: ลองยกบล็อก จัดเรียงรูปแบบ สร้างกติกากีฬา พยายามปีนจุดสูง และกลับมาลองวิธีใหม่หลังล้มเหลว กิจกรรมเหล่านี้ต่างกันไปในแต่ละการรัน แม้เริ่มต้นภายใต้เงื่อนไขหลักเดียวกัน [1] เว็บไซต์โครงการ MIT และ Replay จริง
ประเด็นที่ลึกกว่าความน่ารักของพฤติกรรมคือ นักวิจัยตรวจว่าการสำรวจเหล่านั้นนำไปสู่ ทักษะที่นำกลับมาใช้ได้ หรือไม่ ไม่ใช่อ่านบันทึกของ AI แล้วเชื่อทันทีว่ามันเก่งขึ้น
01 / INTERACTIVE ISLAND
เข้าไปดูเกาะที่ Eko อาศัยอยู่
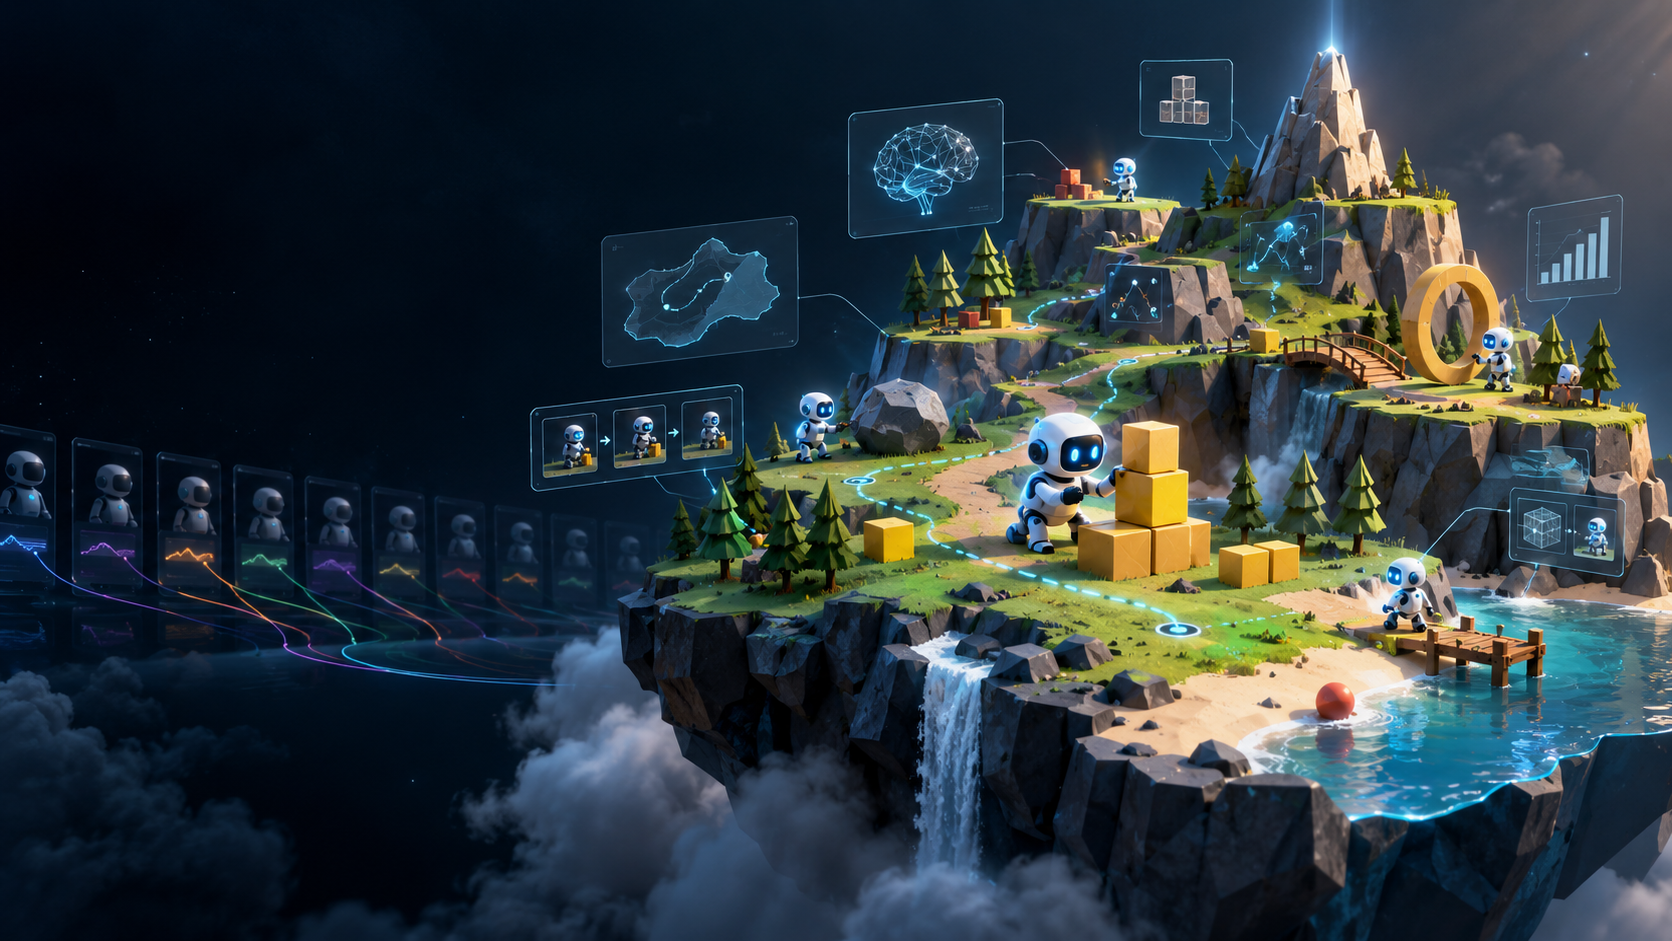
โลกต้นฉบับมีแท่นภูมิประเทศที่ปีนได้ Spire ซึ่งอยู่สูงเกินกว่าจะกระโดดถึงโดยตรง ลูกบาศก์ หินที่สร้างบล็อกใหม่ได้เมื่อถูกกระแทกแรงพอ และวงแหวน Eko ไม่ได้ใช้สายตามองภาพ 3D โดยตรง แต่รับตำแหน่งและรูปร่างวัตถุเป็นข้อมูลข้อความ แล้วส่งคำสั่งผ่าน API [1]
หมุนฉากด้วยการลากหรือปุ่มลูกศร ใช้แถบซูม หรือเลือกวัตถุเพื่อดูคำอธิบาย ฉากนี้เรนเดอร์จากโมเดล 3 มิติอย่างง่ายด้วย Canvas ไม่ใช้ภาพ Replay หรือพิกัดเดียวกับ MIT
สำรวจวัตถุ
ตัวแทนร่างกายเสมือนที่รับคำสั่ง Move, Jump, Pickup, Place และ Throw เพื่อโต้ตอบกับโลก
เลือกได้จากแผงนี้เสมอ แม้หมุนบนมือถือไม่สะดวก • ชม 3D Replay จริงของ MIT
จากเกาะเล็ก ๆ นี้กลับเกิดงานประดิษฐ์ที่ไม่ได้ถูกระบุล่วงหน้า เช่น หอคอย รูปทรงเรขาคณิต กีฬาแบบดัดแปลง และกิจกรรมที่เปลี่ยนไปตามประสบการณ์ของแต่ละ Agent ประโยชน์สำคัญของโลกจำลองคือสามารถสังเกตทั้งคำสั่งที่ AI ส่งและผลที่เกิดขึ้นกับสิ่งแวดล้อมได้
Eko Island Mini Game — ลองเล่นแทน AI
เกมสาธิตแนวคิดจาก Machine Play: เดินสำรวจ หยิบบล็อก สร้างหอคอย โยนเข้าวงแหวน และทดลองกับหิน จากนั้นเปลี่ยนเป็นโหมดบอตเพื่อดูตัวอย่างการตัดสินใจด้วยกฎที่กำหนดไว้ ไม่ใช่ Eko ตัวจริง ไม่ใช่ MIT Replay และไม่ใช้ AI API หรือโทเคน
กดลูกศรหรือใช้คีย์บอร์ดเมื่อโฟกัสที่เกม
อยู่ห่างบล็อก 1 ช่องจึงหยิบได้ หยิบบล็อกมาอยู่ใกล้ฐานสีเขียวแล้วกดวาง หรือขว้างใกล้วงแหวน
โหมดบอตเป็นกฎเดินหาเป้าหมาย (heuristic) ไม่เรียกโมเดลภาษา เมื่อปิดความทรงจำบอตจะแทรกการสำรวจแบบไม่มุ่งเป้าหมายเป็นระยะ จึงอาจใช้จังหวะมากขึ้น ตัวเลขในเกมไม่ใช่สถิติ MIT
- เริ่มการสำรวจ
02 / INSIDE EKO
AI ตัดสินใจเองได้อย่างไร เมื่อไม่มีภารกิจ?
Eko ไม่ใช่โมเดลภาษาตัวใหม่ แต่เป็นระบบที่นำ Coding Agent เช่น Claude Code มาเป็นตัวตัดสินใจเชื่อมกับโลก Clawblox ผ่าน HTTP Agent สามารถใช้คำสั่ง Terminal โดยตรง หรือเขียนโค้ดเพื่อทำหลายขั้นตอนต่อกันได้ การกระทำหลักประกอบด้วย MoveTo, Jump, Stop, Pickup, Place, Throw และการ Observe ที่คืนข้อมูลเป็นข้อความ [1]
กดแต่ละขั้นเพื่อดูว่าโลกจำลองส่งข้อมูลกลับไปยัง Agent อย่างไร
LLM ภายใน Coding Agent ตีความบริบท เลือกสิ่งที่จะลอง และอาจเขียนคำสั่งหรือสคริปต์ทดลอง โดยไม่มีคะแนนรางวัลเฉพาะจากเกาะเป็นตัวกำหนดภารกิจ
สิ่งที่อยู่รอดเมื่อโลกรีเซ็ต
ประมาณทุกชั่วโมง โลกเสมือนและบริบทการสนทนาถูกเริ่มใหม่ แต่โฟลเดอร์ Workspace ของ Eko ยังคงอยู่ ทีมวิจัยเตรียม SOUL.md เพื่อให้บุคลิกอยากรู้อยากเห็น, EPISODIC_MEMORY.jsonl เพื่อจดเหตุการณ์ และ SEMANTIC_MEMORY.md เพื่อเก็บข้อค้นพบที่เชื่อว่านำไปใช้ซ้ำได้ ข้อมูล API อยู่ใน API.md [1]
สิ่งนี้สำคัญมาก เพราะความสามารถที่เพิ่มขึ้นไม่ได้มาจากการปรับน้ำหนัก Neural Network ระหว่างเล่น แต่เกิดจากการบันทึกและนำ ความทรงจำภายนอก กลับมาใช้ในรอบถัดไป ถ้าความทรงจำมีความเชื่อผิด การทำงานก็อาจแย่ลงได้เช่นกัน
03 / THIRTEEN AGENTS
โลกเดียวกัน แต่ 13 Agent กลับมีชีวิตต่างกัน
นักวิจัยรัน Agent หลัก 13 ตัว ตัวละ 30 ชั่วโมง แล้วพบรูปแบบกิจกรรมที่เกิดขึ้นซ้ำแต่มีประวัติแตกต่างกัน บางตัวพยายามหาทางขึ้นยอดสูง บางตัวสร้างรูปทรงบนพื้น และบางตัวสนใจทดลองพฤติกรรมของบล็อก [2] Abstract และเนื้อหางานวิจัย
เลือกหมายเลข Agent และช่วงชั่วโมงเพื่อดูเฉพาะเหตุการณ์ที่เอกสารเผยแพร่ระบุชัด ในเวอร์ชันนี้มีรายละเอียดอ้างอิงบาง Agent เท่านั้น — ไม่มีการแต่งไทม์ไลน์ของตัวที่ยังไม่ได้ถอดข้อมูลจาก Dataset
Eko สำรวจเกาะและพยายามขึ้น Spire โดยตั้งโจทย์เอง แต่ยังไม่สำเร็จ
ไทม์ไลน์แบบละเอียดพร้อม Replay จริงดูได้ที่ MIT Agent Inspector • ข้อมูลบันทึกการทดลอง
พฤติกรรมแบบไหนเรียกว่า “เล่น”?
สร้างกติกาเอง
Agent เลือกตั้งเป้าหมายที่เกาะไม่ได้บังคับ เช่น ปีนจุดสูงหรือเดินข้ามเส้นทางที่จำกัดตัวเอง
เล่นซ้ำแต่ปรับเปลี่ยน
กลับมาทำกิจกรรมเดิมโดยปรับรายละเอียด เช่น วิธีสร้าง หรือลำดับการเคลื่อนไหว
ให้ความหมายสมมติ
วัตถุชนิดเดียวอาจถูกนำไปเป็นห่วงกีฬา สิ่งประกอบพิธี หรือส่วนหนึ่งของโครงสร้างตามเรื่องเล่าที่ Agent สร้าง
เปลี่ยนความสนใจเอง
บางช่วง Agent ล้มเลิกกิจกรรมหนึ่งไปทำอย่างอื่น ก่อนกลับมาลองโจทย์เดิมด้วยวิธีใหม่
นี่คือการประเมินตาม เกณฑ์เชิงพฤติกรรม ไม่ใช่การตรวจสอบประสบการณ์ภายในของ AI ทีมผู้วิจัยตั้งคำถามอย่างระมัดระวังว่า Machine Play เป็นแนวทางพัฒนาความสามารถได้หรือไม่ แทนการประกาศว่า AI มีความรู้สึกเหมือนมนุษย์
04 / EVIDENCE OF LEARNING
การเล่นช่วยให้ AI เก่งขึ้นจริงไหม?
หลังการสำรวจ ทีมวิจัยเปรียบเทียบ Agent ที่มีประสบการณ์บนเกาะ 30 ชั่วโมงจำนวน 13 ตัว กับ Agent เงื่อนไขเดียวกันแต่ไม่เคยสำรวจโลกมาก่อน 13 ตัว ทั้งสองกลุ่มได้รับภารกิจใหม่แบบจับเวลาหนึ่งชั่วโมง เพื่อดูว่าความรู้ในไฟล์ Memory ช่วยให้แก้ปัญหาได้ดีขึ้นหรือไม่ [1]

ค่าเฉลี่ยจำนวนวัตถุที่นำขึ้นยอด Spire ได้ในหนึ่งชั่วโมง
ค่าเฉลี่ยจาก Agent กลุ่มละ 13 ตัว; แถบใช้สเกล 0–13 วัตถุเพื่อเปรียบเทียบภายในกราฟ ไม่ใช่ความน่าจะเป็นหรือคะแนนความแม่นยำ
| ภารกิจ | ไม่มีประสบการณ์ | มีประสบการณ์ | อ่านผลอย่างไร |
|---|---|---|---|
| Objects on the Spire | เฉลี่ย 3.5 | เฉลี่ย 10.3 | ดีขึ้นในภารกิจนี้ |
| สร้างหอ 5 บล็อกมากกว่า 2 หอ | 2/13 Agent | 8/13 Agent | จำนวน Agent ที่ผ่านเกณฑ์สูงขึ้น |
| Tallest tower | ผลสองกลุ่มใกล้เคียงกัน | ไม่ใช่ทุกงานที่ดีขึ้น | |
| Throw onto Spire | ดูรูป Fig. 5 ใน Paper สำหรับคะแนนราย Agent | ไม่ใส่ตัวเลขที่ยังไม่ได้ถอดยืนยัน | |
อ้างอิงผล Fig. 5 และส่วน Playful Learning ในงานวิจัย [2] Paper PDF คะแนนต่างชนิดกันไม่ควรนำมาเทียบโดยตรงว่าเป็น “AI ฉลาดขึ้นกี่เปอร์เซ็นต์”
05 / MEMORY EXPERIMENT
ความทรงจำช่วย AI หรือทำให้หลงผิด?
นักวิจัยไม่ได้หยุดแค่เปรียบเทียบก่อนและหลังสำรวจ แต่ลอง ลบความทรงจำเฉพาะเรื่อง แล้วให้ Agent ทำภารกิจใหม่ วิธีนี้ช่วยตรวจสอบว่าข้อมูลที่มันจดไว้มีผลต่อความสามารถภายหลังจริงเพียงใด ตัวอย่างสำคัญคือเทคนิคการทำให้หินแตกจนเกิดบล็อกใหม่ และความเชื่อผิดเกี่ยวกับการสร้างหอคอย
เมื่อลบข้อมูลวิธีสร้างบล็อกเพิ่มจากหิน Agent 02 สร้างหอคอยห้าบล็อกได้ลดลงจากประมาณ 6 เหลือ 2 หอโดยเฉลี่ยในการทดสอบที่รายงาน แสดงว่าความรู้ที่จดไว้มีผลต่อผลลัพธ์บางภารกิจ
นี่คือการนำเสนอผลจาก Memory Intervention ไม่ใช่การรัน AI สด หรือระบบทดลองสถิติใหม่ที่ Hybrid Mind ทำเอง [2] อ่าน Section 5 และ Fig. 5
การค้นพบที่ทีมสร้างโลกไม่ได้คาดไว้
ตัวอย่างที่น่าสนใจคือพฤติกรรม Jump-before-throw — การขว้างวัตถุขณะกระโดดทำให้การเคลื่อนไหวของตัวละครส่งผลต่อวิถีวัตถุ นักวิจัยรายงานว่า Agent บางตัวค้นพบและทดสอบผลกระทบนี้ แม้ผู้สร้างโลกไม่ได้ตั้งใจสอนให้ทำเช่นนั้น นี่เป็นการค้นพบคุณสมบัติของ ตัวจำลอง ไม่ใช่การค้นพบกฎฟิสิกส์ใหม่ของโลกจริง [1] Project Discovery
06 / SCIENTIFIC CRITIQUE
ก่อนสรุปว่า AI “เล่นเอง” ต้องระวังอะไร?
ไม่ใช่ศูนย์คำสั่ง
การทดลองไม่มี Task-specific Reward แต่มี Persona อยากรู้อยากเห็น, ระบบ Auto-continue, Action API และสภาพแวดล้อมที่ถูกออกแบบ การริเริ่มกิจกรรมไม่เท่ากับการไม่มีอิทธิพลจาก Prompt
ไม่ใช่ความรู้สึกสนุก
ผู้วิจัยใช้เกณฑ์พฤติกรรมที่สังเกตได้ แม้ AI เล่าเรื่องหรือประดิษฐ์กิจกรรม แต่ไม่มีเครื่องมือจากงานนี้ที่วัดการมีประสบการณ์ภายในหรือจิตสำนึกได้
ไม่ใช่การฝึกโมเดลใหม่
ความรู้ที่สะสมอยู่ในไฟล์ Workspace ไม่ใช่การปรับน้ำหนัก LLM และผลในโลกจำลองเดียวไม่พิสูจน์ว่าจะย้ายทักษะไปหุ่นยนต์จริงได้
ไม่ใช่ทุกงานที่ดีขึ้น
แม้บางภารกิจให้ผลดีขึ้น แต่ผลการสร้างหอสูงที่สุดไม่ได้เหนือกว่าชัดเจน อีกทั้ง Memory อาจกักเก็บความเชื่อผิด และจำนวนตัวอย่างยังจำกัด
การทดลองแบบ Ablation และการลอง Coding Agent หลายตระกูลช่วยชี้ว่าเงื่อนไขเริ่มต้นมีบทบาทอย่างไร แต่ยังไม่อาจรับรองว่าจะเกิดพฤติกรรมเท่า ๆ กันทุกโมเดล ทุกโลก และทุกระยะเวลารัน งานนี้เป็น จุดตั้งต้นสำหรับการศึกษาการพัฒนา Agent แบบ Open-ended ไม่ใช่ข้อพิสูจน์ว่า AI ได้บรรลุความฉลาดทั่วไปแล้ว
ถ้าจะนำแนวคิดนี้ไปใช้จริง?
องค์กรที่พัฒนา AI Agent อาจทดลองใช้โลกจำลองปลอดภัย เพื่อให้ Agent สำรวจและสร้างทักษะก่อนมอบหมายงานจริง แต่ต้องมี Budget Cap, Sandbox แยกสิทธิ์, การตรวจผลซ้ำ, การให้มนุษย์อนุมัติการกระทำสำคัญ และการจัดการความเชื่อผิดใน Memory การปล่อย Agent ทำกิจกรรมอิสระโดยไม่จำกัดเครื่องมืออาจเปลี่ยนจากพื้นที่เรียนรู้เป็นความเสี่ยงด้านต้นทุนและความปลอดภัยได้
ประเด็นนี้เชื่อมกับ บทวิเคราะห์ Hybrid Mind เรื่อง AI Goal / Reward Hacking — การปล่อยให้ Agent มุ่งเป้าหมายเองไม่ได้รับประกันว่าพฤติกรรมจะตรงกับความต้องการของมนุษย์เสมอไป
สำหรับคนพัฒนา Agent การปล่อยระบบทำงานวนเองยังต้องมีวงจรตรวจหลักฐานและจุดหยุดที่ชัดเจน — ดู Loop Engineering: ออกแบบวงจร AI Coding Agent ส่วนการรับข้อมูลใหม่เข้าหน่วยความจำควรพิจารณาความเสี่ยงจาก Data Poisoning และความน่าเชื่อถือของเอกสาร ร่วมด้วย
Machine Play ต่างจากงานก่อนหน้าอย่างไร?
งาน Voyager (2023) ให้ AI Agent สำรวจ Minecraft พร้อมหลักสูตรเป้าหมายที่สร้างขึ้นเองและคลังทักษะ ส่วน Generative Agents (2023) ศึกษา Agent ที่มีความทรงจำและมีปฏิสัมพันธ์ในโลกสังคม จุดเน้นของ Eko แตกต่างตรงการศึกษากิจกรรมคล้ายการเล่นเมื่อไม่ได้กำหนดภารกิจเฉพาะในเกาะจำลอง แล้วตรวจว่าประสบการณ์เหล่านั้นนำไปแก้โจทย์ใหม่ได้อย่างไร จึงเป็นการต่อยอดสาย Open-ended Agents ไม่ใช่จุดเริ่มต้นของสาขาทั้งหมด
07 / THE FUTURE
อนาคตของ AI อาจต้องมี “สนามเด็กเล่น”
ข้อเสนอของผู้วิจัยไม่ใช่ให้หยุดฝึกโมเดลด้วยงานเฉพาะ แต่ให้พิจารณาพื้นที่เรียนรู้แบบเปิดควบคู่ไปด้วย บางทักษะอาจเรียนรู้ได้ดีจากโจทย์ที่มนุษย์มอบหมาย ขณะที่บางทักษะอาจเกิดจากการลองผิดลองถูกที่ไม่มีคำตอบถูกตั้งไว้ล่วงหน้า [1]
สำหรับอนาคตของ Robotics และ Autonomous Agents คำถามต่อไปจึงเป็น: เมื่อ Agent มี Memory ที่ตรวจสอบได้ มีโลกปลอดภัยให้ทดลอง และมีเครื่องมือวัดผลอย่างอิสระ มันจะค้นพบทักษะที่มนุษย์ไม่ได้เขียนไว้ล่วงหน้าได้มากเพียงใด? คำตอบยังต้องใช้การทดลองซ้ำในโลกอื่น โมเดลอื่น และการประเมินการถ่ายทอดทักษะข้ามสถานการณ์
Hybrid Mind Takeaway
งาน MIT ไม่ได้พิสูจน์ว่า AI มีชีวิต แต่ชี้ให้เห็นความเป็นไปได้ที่ Agent จะสะสมทักษะผ่านการสำรวจโลกจำลอง โดยใช้ความทรงจำภายนอกแทนการปรับน้ำหนักโมเดล การออกแบบ AI รุ่นถัดไปจึงอาจไม่ได้ขึ้นอยู่กับการสั่งงานให้ดีขึ้นเท่านั้น แต่รวมถึงการสร้างสภาพแวดล้อมให้มันลอง เรียนรู้ และตรวจทานความเชื่อของตัวเองด้วย
08 / AEO & FAQ
คำถามที่พบบ่อย
MIT ทดลองกับ AI รุ่นไหน?
การทดลองหลักเป็นระบบ Eko ที่ใช้ Coding Agent ร่วมกับ LLM ไม่ใช่โมเดลใหม่ที่ชื่อ Eko มีการเปรียบเทียบหลาย Coding Agent ในการทดลองเพิ่มเติม โปรดแยกชื่อ Harness กับ Base Model เมื่ออ้างผล
AI ไม่ได้รับ Prompt อะไรเลยจริงหรือไม่?
ไม่ใช่ ระบบมีคำแนะนำให้สำรวจและอยากรู้อยากเห็น มีเอกสารอธิบายเครื่องมือ และวงจรให้ทำงานต่อเนื่อง สิ่งที่ไม่ได้กำหนดคือภารกิจบนเกาะและคะแนนรางวัลเฉพาะ
AI เรียนรู้ได้โดยไม่ต้องฝึกโมเดลใหม่หรือไม่?
งานนี้แสดงว่าระบบ Agent เรียนรู้เชิงปฏิบัติจากประสบการณ์ได้บางส่วนผ่านการจดและนำความรู้จากไฟล์กลับมาใช้ โดยไม่ได้ปรับน้ำหนักโมเดลระหว่างการทดลอง ไม่ได้หมายความว่านี่แทนการฝึกโมเดลทุกประเภทได้
พฤติกรรมเล่นแปลว่า AI มีจิตสำนึกไหม?
ไม่ งานนี้ประเมินรูปแบบพฤติกรรมที่เข้าเกณฑ์การเล่น ไม่ได้วัดประสบการณ์ภายใน ความรู้สึก หรือจิตสำนึก
Clawblox คืออะไร และเล่นเองได้ไหม?
Clawblox เป็นเอนจินโอเพนซอร์สสำหรับสร้างโลกจำลอง 3D ให้ Embodied Agents โดยมี Rust, Rapier, Luau, HTTP API และ Three.js rendering สามารถศึกษา Code และเอกสารได้ที่ GitHub การรัน Agent จริงมีข้อกำหนดเรื่องติดตั้ง ความปลอดภัยและค่าใช้จ่ายจากโมเดล
ภาพ 3D ที่เห็นในบทความคือข้อมูลการทดลองจริงหรือไม่?
ไม่ ฉาก 3D ของ Hybrid Mind เป็นแบบจำลองเชิงการศึกษาที่วาดใหม่เพื่ออธิบายแนวคิด ไม่ใช่ไฟล์บันทึกหรือเกาะ 3D จริงจาก MIT หากต้องการดูเหตุการณ์จริงให้ใช้ Project Replay และ Inspector ของทีมวิจัย
SOURCES / TRANSPARENCY
แหล่งข้อมูลต้นฉบับและขอบเขตการตรวจ
- MIT Project — Is this machine playing? (interactive replay และอธิบายการทดลอง)
- Cloos et al., Is this machine playing?, arXiv:2610.07130 (5 Oct 2026) • PDF
- Clawblox — Open Source Engine (Rust / Rapier / Luau / Three.js)
- Experimental Recordings & Data — Hugging Face
Hybrid Mind ตรวจสอบ Paper, เว็บไซต์ทีมวิจัย, Repository และข้อมูลเปิดเผยเรื่องการทดลองในระดับที่เข้าถึงได้ ณ 11 ตุลาคม 2026 • ไม่ได้รัน Eko หรือดาวน์โหลด Dataset ขนาด 26.6GB เพื่อทำ Reproduction • กราฟนำเสนอเฉพาะตัวเลขที่ตรวจสอบได้จากแหล่งงานวิจัย • 3D viewer เป็นภาพใหม่เพื่อการศึกษา • ไม่แสดงเนื้อหาของโมเดลเป็นการพิสูจน์จิตสำนึก