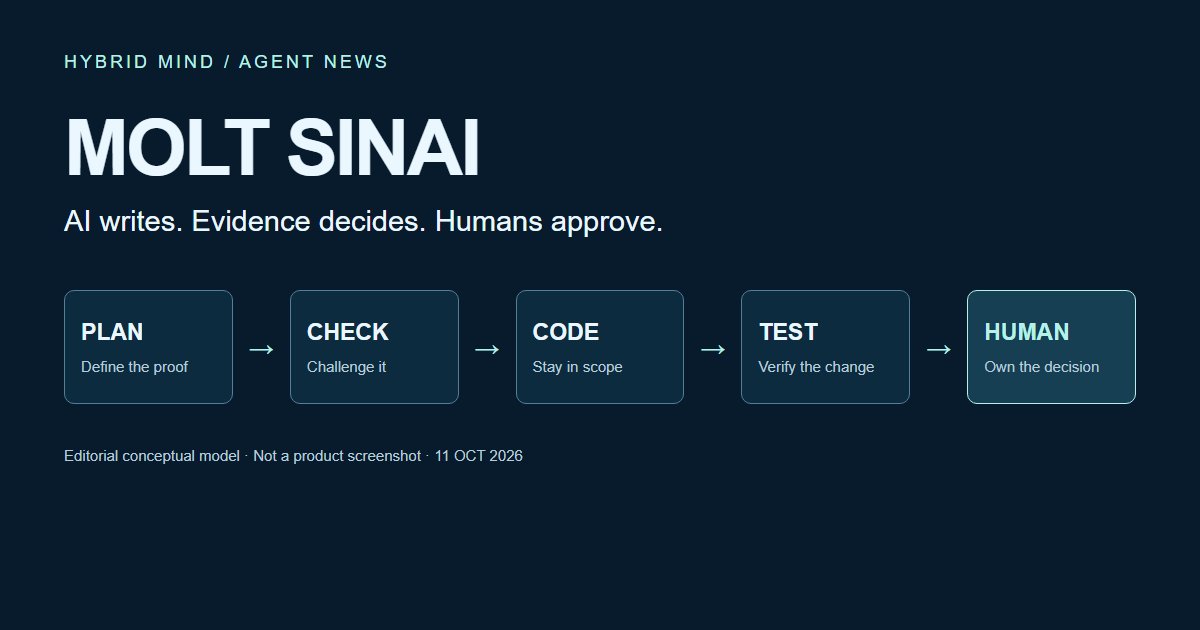
เมื่อทีม AI เขียนโค้ดถูกจัดเหมือนโรงพยาบาล
คำถามไม่ใช่แค่ “ทำได้เร็วไหม” แต่คือ “ใครตรวจว่าถูก?”
ข่าว + บทวิเคราะห์ + 3D Dynamic Quality-Gate Lab
Coding Agent ที่สร้าง Pull Request ได้เองยังไม่ใช่ระบบส่งมอบซอฟต์แวร์ที่ไว้ใจได้ เรื่องที่กำลังถูกพูดถึงจาก Cockroach Labs ชวนเปลี่ยนจุดสนใจจากความเร็วในการผลิตโค้ด ไปสู่การออกแบบคนรับผิดชอบ หลักฐาน และทางหยุดงานเมื่อยังตอบไม่ได้ว่าปลอดภัยพอหรือยัง
01 / NEWS & EVIDENCEเกิดอะไรขึ้น และทำไมเลือกเรื่องนี้
Adam Storm และ Rafi Shamim เผยแพร่กรณีศึกษา MOLT Sinai วันที่ 9 ตุลาคม 2026: การทดลองทีม Coding Agents ภายใน Cockroach Labs ราวห้าเดือน ใช้ GitHub Actions และสถานะ Issue เพื่อประสานงาน มีการตรวจแผนก่อนเขียนโค้ด และแยก Agent ผู้เขียนออกจากผู้ตรวจ [1]
เมื่อสำรวจ Hacker News ในรอบที่เริ่ม 11 ต.ค. 2026 เวลา 16:40 น. ไทย กระทู้มี 131 คะแนน / 52 ความเห็น เป็นเรื่อง Coding Agents ที่มีสัญญาณสนใจเด่นและยังไม่อยู่ในโพสต์ของ Hybrid Mind ที่ตรวจ ขณะที่ Talorys และเรื่อง Decision Model มีเนื้อหาในเว็บแล้ว จึงไม่ทำข่าวซ้ำ ตัวเลขเป็นภาพ ณ เวลาสำรวจแพลตฟอร์มเดียว ไม่ใช่หลักฐานว่าไวรัลที่สุดทั่วอินเทอร์เน็ต [2]
02 / ANALYSISข่าวนี้เปลี่ยนคำถามของทีมพัฒนาอย่างไร
บทวิเคราะห์ Hybrid Mind: มูลค่าของข่าวอยู่ที่การทำให้ “ตรวจเสร็จแล้ว” เป็นสถานะที่ต้องมีหลักฐานรองรับ ไม่ใช่เพียงประโยคที่ Agent เขียนปิดงาน ยิ่งระบบเข้าถึงโค้ดจริงและข้อมูลลูกค้าได้ ความแตกต่างระหว่างผู้ลงมือ ผู้ทดสอบ และผู้อนุมัติยิ่งมีความหมาย
การเพิ่ม Agent อีกตัวไม่สร้างความเป็นอิสระโดยอัตโนมัติ ถ้าทั้งสองอ่านข้อสรุปเดียวกัน เชื่อสมมติฐานเดียวกัน และไม่มีข้อมูลทดสอบที่หักล้างข้อสรุปได้ ก็อาจเป็นการยืนยันความผิดซ้ำสองรอบ ผู้ตรวจที่มีหน้าที่หาเหตุผลว่า “ทำไมยังไม่ควรส่ง” จึงต้องเห็นทั้งข้อกำหนดและหลักฐานดิบ ไม่ใช่เฉพาะคำอธิบายของผู้เขียน
อีกด้านหนึ่ง กระบวนการที่มีหลาย Role สามารถสร้างคิวรอและงานเอกสารมากกว่างานที่แก้ให้ผู้ใช้ได้จริง ความสำเร็จจึงควรวัดที่งานซึ่งผ่านการยอมรับและไม่สร้างภาระย้อนหลัง ไม่ใช่จำนวนข้อความ จำนวน Agent หรือจำนวนบรรทัดที่เพิ่มเข้า Repository
03 / 3D DYNAMIC LABสำรวจว่าแผนผ่าน แผนตก และงานติด ควรไปไหน
Quality-Gate Explorer
แบบจำลองบรรณาธิการ 6 จุดเพื่ออธิบายแนวคิด ไม่ใช่แผนผังทุก Role ของ Sinai และไม่ได้รัน Agent หรือ GitHub จริง เลือกสถานการณ์ แล้วหมุน Orbit/Front/Top หรือเลือกจุดเพื่ออ่านเหตุผลที่ควรตรวจ
แบบจำลองบรรณาธิการ: ระบุสิ่งที่ผู้ใช้ต้องการให้ตรวจได้ และเขียนสิ่งที่อยู่นอกขอบเขตไว้ก่อนเริ่ม
แผนไม่ผ่าน: Check → Plan · ตัดสินใจไม่ได้: Check → Human
ขั้นตอนสุดท้ายหมายถึงมนุษย์ตรวจและตัดสินใจ ไม่ใช่ Auto-merge
เดินหน้าตามลำดับ: ทำให้ข้อกำหนดตรวจได้ แล้วค่อยลงมือและทดสอบ ก่อนให้มนุษย์ตัดสินใจส่งงาน ไม่มีจุดใดในภาพนี้อนุมัติ Merge ให้ระบบจริง
หยุดก่อนเขียน: ถ้าแผนไม่มีวิธีตรวจว่าแก้ปัญหาได้จริง ให้กลับไปเติมหลักฐานและขอบเขต ไม่ควรแก้โค้ดต่อเพราะอยากให้มีความคืบหน้า
ส่งต่อการตัดสินใจ: เมื่อขอบเขตหรือสิทธิ์ไม่ชัด ให้บอกสิ่งที่รู้ สิ่งที่ยังไม่รู้ และผลกระทบของแต่ละทางเลือกแก่ผู้รับผิดชอบ แทนการขยายงานเอง
ลองเช็กว่าหลักฐานครบหรือยัง
เลือกตามกรณีสมมติของคุณ การติ๊กในหน้าเว็บไม่ใช่ผลทดสอบ ไม่ยืนยันว่าระบบปลอดภัย และไม่ให้สิทธิ์เข้าถึง Repository
ยังไม่ครบตามตัวอย่าง — อย่าใช้คำว่า “พร้อมส่ง” แทนรายการหลักฐานที่ยังขาด
ครบตามตัวอย่าง — ขั้นต่อไปยังต้องตรวจหลักฐานจริงและใช้สิทธิ์อนุมัติในระบบจริง ไม่ใช่ Merge จากหน้าเว็บนี้
04 / ECONOMICSToken Bill ไม่ใช่ต้นทุนทั้งหมด และ Autonomy ไม่ใช่ไม่มีมนุษย์
ผู้พัฒนารายงานค่า Claude Tokens รวม มากกว่า $135,000 และเฉลี่ยราว $84 ต่อ GitHub Issue พร้อมระบุว่า หลังสัปดาห์แรกของการทำงานอัตโนมัติได้เปิด Human Approval Mode ให้มนุษย์ตรวจทุก Merge ตัวเลขนี้จึงไม่ใช่ต้นทุนดำเนินงานรวม และไม่ใช่ราคาที่ระบบอื่นจะทำตามได้ [1]
บทวิเคราะห์: ค่าเฉลี่ยต่อ Issue อ่อนไหวต่อวิธีแบ่งงาน ถ้าแตกปัญหาเดิมเป็นหลาย Issue ตัวหารเพิ่มขึ้นได้โดยที่ผลส่งมอบแทบไม่เปลี่ยน สิ่งที่ควรติดตามเพิ่มคือค่าใช้จ่ายต่อความสามารถที่ผู้ใช้ยอมรับ เวลาตรวจของมนุษย์ ค่า CI/เครื่องมือ และต้นทุนแก้ Regression หลังส่งจริง
การเทียบต้นทุน Token ของงานหนึ่งกับเวลาวิศวกรของอีกงานหนึ่งอาจช่วยตั้งสมมติฐาน แต่ยังไม่ใช่การเปรียบเทียบแบบควบคุม งานต่างชนิด ขอบเขตต่างกัน และความพร้อมของเครื่องมือเดิมทำให้สรุปอัตราประหยัดทั่วไปไม่ได้ สำหรับทีมที่ประเมินนำแนวคิดนี้ไปใช้ ควรเริ่มจากชุดงานที่นิยามผลสำเร็จเหมือนกัน และบันทึกทั้งงานสำเร็จ งานค้าง และงานที่ต้องให้คนแก้แทน
05 / RISKS & CONTROLคำสั่งให้ Agent ระวัง ไม่เท่ากับขอบเขตสิทธิ์ที่บังคับได้
GitHub แนะนำให้ Workflow ใช้ Token ด้วยสิทธิ์เท่าที่จำเป็น และเตือนว่าข้อมูลจาก Issue/PR อาจเป็น Input ที่ไม่น่าเชื่อถือ หากนำไปประกอบคำสั่งโดยตรงอาจเกิด Script Injection ได้ ข้อแนะนำนี้เป็นหลักความปลอดภัยของแพลตฟอร์ม ไม่ใช่ข้อกล่าวหาว่า Sinai มีช่องโหว่ดังกล่าว [3]
GitHub ยังมี Branch Protection สำหรับ Required Reviews และ Required Status Checks รวมถึงตัวเลือกจัดการ Approval เก่าหลังเปลี่ยนโค้ด ควรออกแบบให้ผลอนุมัติผูกกับงานที่ตรวจจริง และทบทวนสิทธิ์ Bypass ด้วย ไม่ใช่ให้ Agent ผู้เขียนมีสิทธิ์เปลี่ยนกติกาที่ใช้ตรวจตัวเอง [4]
| ความเสี่ยงที่ควรทดสอบ | เหตุใดหลาย Agent ยังไม่พอ | หลักฐานที่ทีมควรเก็บ |
|---|---|---|
| ผู้ตรวจเชื่อผู้เขียน | ข้อสรุปผิดอาจถูกส่งต่อโดยไม่ถูกหักล้าง | ข้อกำหนด ผลทดสอบ และเหตุผลที่รับหรือปฏิเสธ |
| ทดสอบผ่านแต่ไม่ตรงงาน | สัญญาณสีเขียวอาจตรวจคนละส่วนหรือคนละ Commit | Commit SHA ขอบเขต Test และกรณีที่ควรล้มเหลว |
| งานที่ส่งต่อหายไป | ทุกคนอาจคิดว่าอีกคนจะทำ | เจ้าของงานที่เลื่อน เหตุผล วันตรวจ และเงื่อนไขปิด |
| คิวอนุมัติล้น | ตรวจแบบเร่งรีบทำให้ Human Gate กลายเป็นพิธี | เวลารอ ขนาดงาน และจุดที่คนต้องแก้คำตอบของ Agent |
ตารางนี้เป็นกรอบวิเคราะห์ของ Hybrid Mind ไม่ใช่รายการเหตุการณ์ที่ยืนยันว่าเกิดครบทุกข้อใน Cockroach Labs
06 / PLAYERS & WHAT TO WATCHใครได้รับผลกระทบ และหลักฐานใดจะเปลี่ยนข้อสรุป
ทีมเจ้าของ Repository ได้เครื่องมือช่วยแบ่งและตรวจงาน แต่ยังเป็นผู้รับภาระเมื่อผลส่งมอบผิด ผู้ให้บริการโมเดลและ CI อยู่ในเส้นทางต้นทุนและความเชื่อถือ ส่วน ผู้ใช้ระบบปลายทาง ต้องการความถูกต้องและความสามารถในการย้อนกลับ ไม่ได้ประโยชน์เพียงเพราะเบื้องหลังมี Agent มากขึ้น นี่คือการอ่านผลกระทบเชิงระบบ ไม่ใช่การคาดการณ์ยอดขายของผู้เล่นรายใด
- การทดลองเปรียบเทียบ: ใช้ชุดงานเดียวกันเพื่อแยกผลของ Plan Review, ผู้ตรวจแยกบริบท และการมี Human Gate
- ผลหลังใช้งานจริง: บั๊กหลุด ความยากในการแก้ไขต่อ และภาระทีมดูแลสำคัญกว่ายอดโค้ด
- ความตรวจสอบได้: หากเปิด Artifact หรือวิธีวัดผล ผู้ตรวจภายนอกจะประเมินข้อกล่าวอ้างได้ดีขึ้น
- ต้นทุนครบวงจร: แยกค่าโมเดล เวลา Reviewer, CI และงานแก้ย้อนหลัง พร้อมนิยามงานที่นับเป็นความสำเร็จ
สำหรับทีมเล็ก จุดเริ่มต้นที่เหมาะกับการทดลองเชิงวิศวกรรมคือเลือกงานเสี่ยงต่ำที่ตรวจผลได้ชัด และมีคนเป็นเจ้าของการยอมรับงาน ไม่จำเป็นต้องคัดลอกทุก Role หรืออนุญาตให้ระบบทำงานไม่มีผู้ดูแล การลดหรือเพิ่มขั้นตอนควรตามหลักฐานที่ได้จากงานของตนเอง
07 / QUICK ANSWERSคำถามที่ไม่ควรปล่อยให้กระแสตอบแทนหลักฐาน
MOLT Sinai เป็นโมเดล AI ใหม่หรือไม่?
ไม่ใช่ชื่อโมเดลใหม่ แต่เป็นการจัด Workflow และการตรวจงานรอบ Coding Agents ในกรณีศึกษานี้ [1]
ดาวน์โหลดระบบเต็มมารันได้เลยหรือไม่?
ผู้เขียนตอบใน Hacker News ว่า Artifact ยังไม่เปิดสาธารณะในตอนตอบนั้น การมีบทความอธิบายไม่เท่ากับมีแพ็กเกจพร้อมติดตั้ง [2]
แผนภาพนี้รันทีม Agent หรือแก้ Repository ให้หรือไม่?
ไม่ครับ ทั้งภาพและเช็กลิสต์ทำงานกับข้อมูลตัวอย่างในหน้าเว็บเท่านั้น ไม่มีการเรียกโมเดลหรือเชื่อมต่อ GitHub และไม่ส่งข้อมูลที่เลือกไปยังทีมผู้พัฒนา
เรื่องนี้พิสูจน์ว่าควรให้ AI อนุมัติ AI เองทั้งหมดหรือยัง?
ยังไม่ได้พิสูจน์เช่นนั้น ข้อจำกัดของการทดลองและการกลับมาใช้คนอนุมัติเป็นเหตุผลให้แยก “ทำงานได้” ออกจาก “ไว้ใจให้ส่งงานเองได้” [1] [2]
08 / SOURCESแหล่งข่าวและหมายเหตุบรรณาธิการ
- Cockroach Labs — Five months treating bugs like patients and coding agents like a medical team: รายงานของผู้พัฒนา เผยแพร่ 9 ต.ค. 2026
- Hacker News — กระทู้และคำตอบจากผู้เขียน: สัญญาณความนิยมและข้อจำกัดที่ผู้เขียนระบุ ไม่ใช่การตรวจอิสระ
- GitHub Docs — Secure use reference: การจัดสิทธิ์และความปลอดภัยของ Workflow
- GitHub Docs — About protected branches: Review และ Status Check ที่บังคับก่อน Merge
อ่านต่อ: Loop Engineering · Talorys 3D Lab
ใส่ความเห็น