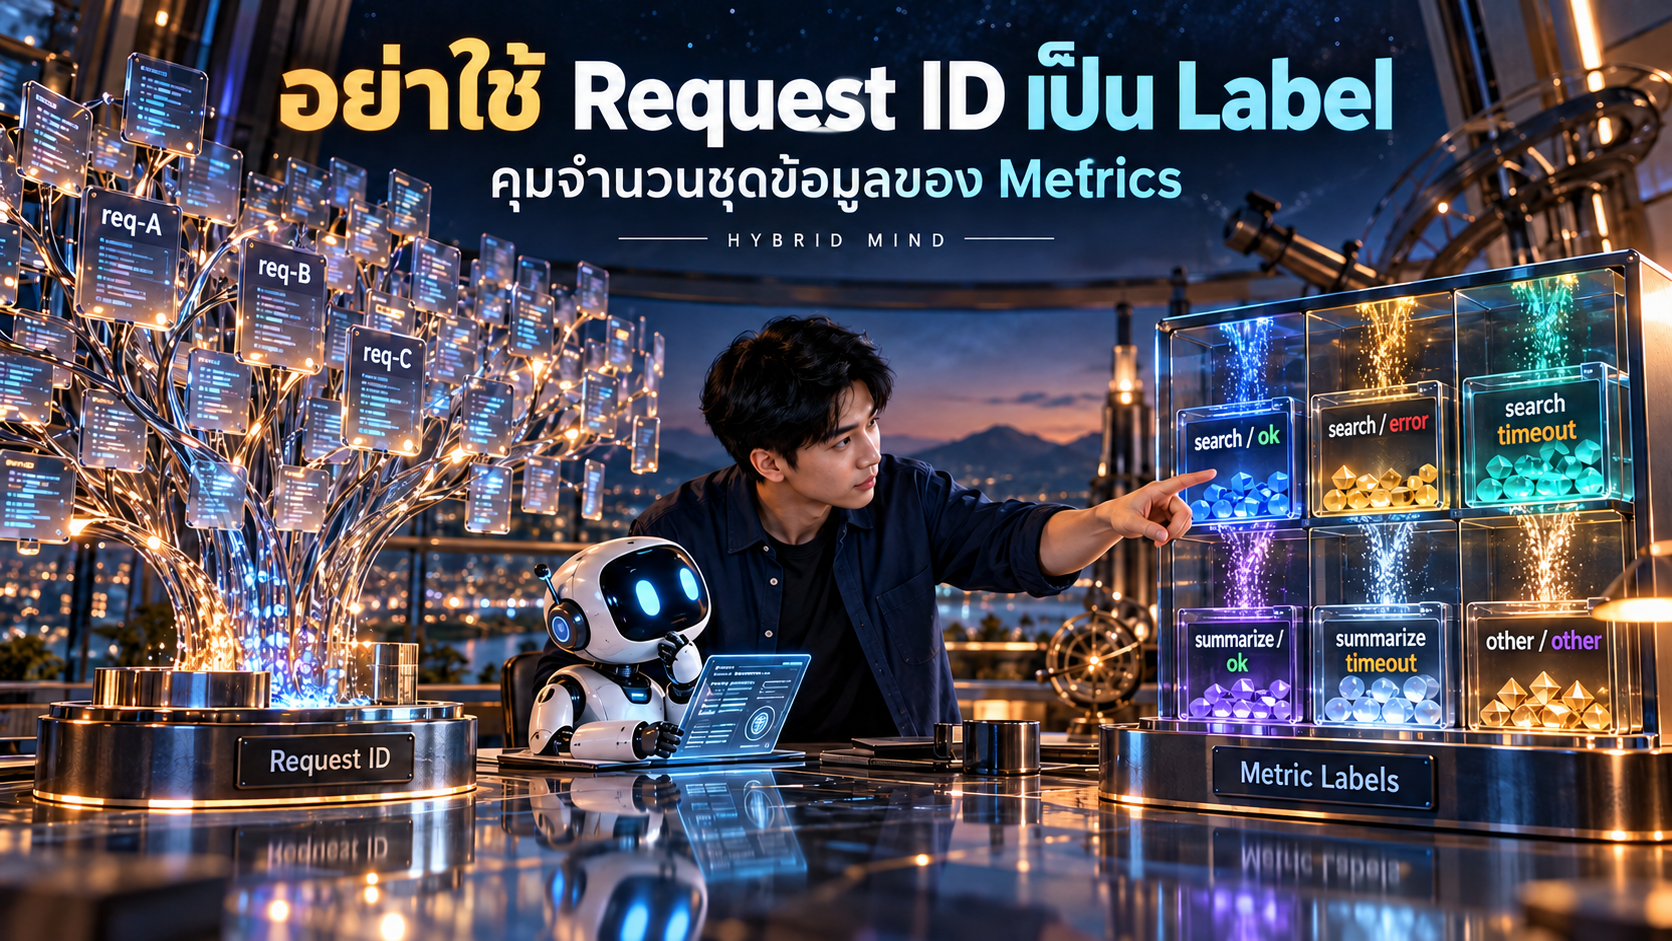

Quick Answer: จำกัด vocabulary ก่อนสร้าง metric
ถ้าต้องการนับการเรียกเครื่องมือของ AI Agent ให้กำหนดค่าของ label ที่ยอมรับไว้ล่วงหน้า แล้ว normalize ค่าที่ไม่รู้จักเป็น other ก่อนรวมตัวเลข อย่าใช้ request ID, user ID, URL หรือข้อความ error เป็น label เพราะค่าเหล่านั้นเปลี่ยนได้แทบทุกคำขอ ทำให้จำนวนชุด label โตตาม traffic แทนที่จะสะท้อนหมวดหมู่ที่ต้องการดู
บทเรียนนี้ใช้ counter จำลองชื่อ agent_tool_calls_total มี tool 3 ค่าและ outcome 4 ค่า จึงมี 12 possible logical pairs สำหรับ counter หนึ่งตัวและ label สองชุดนี้ เมื่อบันทึกตัวอย่าง 5 เหตุการณ์ มีคู่ที่มียอดมากกว่าศูนย์ 4 คู่และยอดรวม 5 นี่คือผลของ mock ใน process เดียว ไม่ได้วัด Prometheus จริง ไม่ได้กำหนดเพดาน RAM หรือจำนวน series ของระบบจริง
Observable outcome: สิ่งที่ผู้เรียนทำได้
เมื่ออ่านจบ ผู้อ่านควรอธิบายได้ว่า metric คือข้อมูลตัวเลขที่ติดตามพฤติกรรมระบบ ส่วน label คือมิติที่แบ่งข้อมูลออกเป็นกลุ่ม สามารถแยก event count, active-pair count และ possible-pair count พร้อมคำนวณจำนวนคู่จากขนาด allowlist ได้
ผลที่คาดจากชุดตัวอย่างหลักคือ search/ok = 2, search/error = 1, summarize/timeout = 1, other/other = 1 รวม 5 events, 4 active pairs และ 12 possible pairs คำว่า active pair ในบทนี้หมายถึงคู่ label ใน snapshot ที่มี count มากกว่าศูนย์ ไม่ใช่จำนวน time series ทั้งระบบ
Boundary: cardinality โตตรงไหน
สมมติ Agent เรียกเครื่องมือค้นหาและเราต้องการรู้ว่า tool ใดล้มเหลวหรือ timeout บ่อย metric อย่าง agent_tool_calls_total ช่วยตอบคำถามภาพรวมได้ label เช่น tool=search และ outcome=timeout แบ่ง counter ให้เห็นตามประเภท แต่ทุกมิติที่เพิ่มเข้ามาก็เพิ่มชุดค่าที่อาจต้องจัดการ
cardinality หมายถึงจำนวนค่าที่แตกต่างกัน หรือเมื่อมองหลาย label คือจำนวนชุดค่าผสมที่เป็นไปได้ สำหรับ label tool ที่มี 3 ค่าและ outcome ที่มี 4 ค่า จึงมี 3 × 4 = 12 คู่เชิงตรรกะสำหรับ counter นี้ภายใต้สมมติฐานว่าพิจารณาเพียงสอง label นี้
request ID โดยธรรมชาติมีค่าใหม่ต่อคำขอ หากใส่เป็น label คำขอที่ใช้ tool และ outcome เดิมก็ยังสร้างค่ามิติใหม่เมื่อ ID ต่างกัน ทำให้ cardinality ผูกกับ traffic และทำให้ metric แบ่งเป็นกลุ่มย่อยโดยไม่จำเป็นต่อคำถามแนวโน้มรวม Prometheus ระบุว่าชุด label ที่ไม่ซ้ำกันแต่ละชุดสร้าง time series ของตัวเอง และแนะนำหลีกเลี่ยง label ที่ cardinality สูงหรือไม่จำกัด ดู แนวทางชื่อ metric และ label ของ Prometheus
แนวทาง cardinality ไม่มีเลขเพดานสากลที่ใช้ได้กับทุกระบบ ขนาดที่เหมาะขึ้นกับ backend, scrape, จำนวน instance, retention, metric type และ query เลข 12 ในบทนี้เกิดจาก vocabulary ที่เราตั้งใจจำกัดเพื่อสาธิต ไม่ใช่เกณฑ์ว่าทุกระบบปลอดภัยเมื่อมีไม่เกิน 12

แยก metric, label, counter และจำนวนที่นับ
metric คือชื่อและค่าตัวเลขที่ระบบบันทึก เช่น จำนวนครั้งเรียก tool หรือเวลาที่ใช้ label คือคู่ชื่อและค่าที่แนบเพื่อแบ่งข้อมูล เช่น tool=search backend อาจเก็บอนุกรมเวลาตามชุด label ที่ไม่ซ้ำกัน จึงควรเลือกมิติจากคำถามที่ระบบต้องตอบ ไม่ใช่จากการมีฟิลด์นั้นอยู่ใน event
counter เป็น metric สะสมที่เพิ่มเมื่อเกิดเหตุการณ์ และอาจเริ่มใหม่เมื่อ process restart การอ่าน counter ต้องพิจารณาเวลาและ instance ที่เกี่ยวข้อง ค่าปัจจุบันไม่ได้แปลว่าเป็นยอดตลอดอายุระบบเสมอ ดู แนวทาง instrumentation
ในตัวอย่างนี้มีสามจำนวนที่ไม่ควรสับสน: event count คือผลรวม count ทั้งหมด; active pairs คือจำนวนคู่ label ที่มี count มากกว่าศูนย์; possible pairs คือจำนวนคู่จากค่าทั้งหมดใน allowlist แม้ count ยังเป็นศูนย์ เหตุการณ์หลายร้อยครั้งอาจรวมอยู่ในคู่เดียว ส่วนเหตุการณ์ไม่กี่ครั้งที่ ID ไม่ซ้ำอาจสร้างค่ามิติใหม่ได้
จำนวน 3 × 4 อธิบายเฉพาะคู่ของ label สองชุดใน mock ไม่ได้บอกจำนวน series ทั้งระบบ ไม่ได้บอก bytes ใน RAM และไม่ใช่เพดานทรัพยากร Backend จริงอาจมี instance/resource labels, metric อื่น และ histogram ที่เพิ่มชุดข้อมูลที่ต้องดูแล
ออกแบบ bounded vocabulary ก่อนรวมค่า
เริ่มจากคำถาม “อยากรู้ว่า tool หมวดใดสำเร็จหรือล้มเหลว” แล้วกำหนดชุดค่าที่จำกัด ตัวอย่างใช้ TOOLS = search, summarize, other และ OUTCOMES = ok, error, timeout, other การเพิ่มค่าใหม่เป็นการเปลี่ยน vocabulary ที่ตั้งใจทำ ไม่ใช่ผลจากข้อมูลผู้ใช้
normalizer ยอมรับ exact string ที่ตรงกับ allowlist เท่านั้น กรณีอื่นส่งไป other โดยไม่เรียก str() หรือ repr() กับค่าขาเข้า ไม่ trim ช่องว่าง ไม่แปลงตัวพิมพ์ และไม่ยอมรับ string subclass, list, integer หรือ None ข้อกำหนดเข้มนี้ทำให้ค่าที่ไม่คาดคิดไม่กลายเป็นหมวดใหม่โดยปริยาย แต่เป็นนโยบายตัวอย่าง ไม่ใช่ข้อบังคับของทุก instrumentation
การ hash request ID ไม่ได้ลดจำนวนค่าที่แตกต่างอย่างรับประกัน ID ต่างกันมักได้ hash ต่างกันและยังทำให้เกิด label ใหม่ตามคำขอ อีกทั้งอาจมี collision การ hash จึงไม่ได้เปลี่ยน ID รายคำขอให้เป็น vocabulary จำกัด
other ช่วยคงยอดรวมโดยไม่สร้าง key เพิ่ม แต่ทำให้สูญเสียรายละเอียดว่า tool ใหม่ชนิดใดหรือ error แบบไหนเกิดขึ้น หากต้องการทราบว่าเกิด unknown value ให้กำหนดช่องทางวินิจฉัยแยก ไม่แก้ด้วยการเพิ่ม raw input กลับเป็น metric label ทันที
Worked example: นับห้าเหตุการณ์
ก่อนนับให้กำหนดหน่วย: ตัวอย่างนี้นับ completed tool attempt ที่สังเกตได้หนึ่งครั้งเป็นหนึ่ง event และเพิ่ม counter หนึ่งครั้ง ถ้ามี retry อีกครั้งก็ถือเป็น attempt ใหม่และนับอีกครั้ง หาก metric ต้องนับ logical operation ไม่ว่าจะ retry กี่ครั้ง ต้องกำหนด identity และ deduplication แยกต่างหาก ชื่อ metric ควรบอกให้ชัดว่าหมายถึง attempts หรือ logical calls
เหตุการณ์แรกและสองคือ search/ok จึงเพิ่มช่องเดียวกันสองครั้ง ช่องนั้นมี count 2 แต่ยังมี active pair เพียงหนึ่งคู่ เหตุการณ์ที่สาม summarize/timeout เพิ่มช่องใหม่หนึ่งคู่
เหตุการณ์ที่สี่ส่ง tool เป็น fetch-user-123 และ outcome เป็น HTTP 500: raw detail ทั้งสองค่าไม่อยู่ใน allowlist จึง normalize เป็น other/other หนึ่งครั้ง เหตุการณ์ที่ห้าคือ search/error จึงเพิ่มอีกช่องหนึ่ง
ผลลัพธ์เป็น search/ok = 2, summarize/timeout = 1, other/other = 1, search/error = 1 รวม count เป็น 5 แต่มี active pairs 4 เพราะ search/ok ถูกใช้ซ้ำ Possible pairs ยังคง 12 จาก 3 × 4 ตาม allowlist ไม่ได้เปลี่ยนเป็น 5 หรือ 4 ตามจำนวนเหตุการณ์
จาก normalizer ไป aggregator
แบบจำลองทำงานเป็นลำดับ: รับค่า tool กับ outcome จาก event, ตรวจว่าตรงกับ string ใน allowlist, แทนค่าที่ไม่ตรงด้วย other, แล้วเพิ่ม count ในช่องของคู่ label ที่ normalize แล้ว Counter สร้างครบ 12 ช่องล่วงหน้าและ record(tool, outcome) เพิ่มหนึ่งช่องต่อ event
snapshot() คืนข้อมูลเป็น tuple ซ้อน tuple ตามลำดับเดิม เพื่อให้ตรวจยอดโดยไม่แก้ internal mapping ผ่าน interface ตัวอย่าง ส่วน total() รวมค่า count ทั้งหมด ตัวอย่างไม่เก็บ event ต้นฉบับ ไม่เก็บ request ID และไม่ hash ID
จำนวน key ของ counter ถูกจำกัดด้วยขนาด tuple ที่กำหนด แต่ค่าจำนวนเต็มของ count โตได้ตาม event เลข 12 ไม่ได้จำกัดจำนวนครั้งที่บันทึก อธิบายเพียงจำนวนช่องที่สร้างไว้จาก vocabulary ของตัวอย่าง
โค้ดตัวอย่างเป็น single-process ไม่มี thread safety, persistence, multiprocess aggregation หรือ replay deduplication การ restart ทำให้ count หาย และการเล่น event ซ้ำอาจทำให้นับซ้ำ ข้อจำกัดเหล่านี้ทำให้ mock นี้เป็นเครื่องมือสอนแนวคิด ไม่ใช่ implementation production
Code example: Python local mock
ตัวอย่าง Python 3.12+ ใช้ Standard Library เท่านั้น ไม่มี SDK, exporter, API, network หรือ telemetry backend โค้ดสร้าง TOOLS สามค่าและ OUTCOMES สี่ค่า ใช้ exact string allowlist และไม่ coercion ค่าที่ไม่รู้จัก หลักฐานผลที่คาดจากการอ่านโค้ดระบุไว้ด้านบน; สถานะการรันตัวอย่างคือ NOT RUN
ตัวอย่างโค้ดเต็ม: local counter ที่จำกัด label · ไฟล์ metric_labels.py
"""A finite, single-process teaching model for tool-call metrics."""

from __future__ import annotations

TOOLS = ("search", "summarize", "other")
OUTCOMES = ("ok", "error", "timeout", "other")
METRIC_NAME = "agent_tool_calls_total"


def normalize_label(value: object, allowed: tuple[str, ...]) -> str:
    """Keep only exact strings from an allowlist; collapse everything else."""
    if type(value) is str and value in allowed:
        return value
    return "other"


class ToolCallCounter:
    """Count calls in one process; this mock has no concurrency guarantees."""

    def __init__(self) -> None:
        self._counts = {
            (tool, outcome): 0
            for tool in TOOLS
            for outcome in OUTCOMES
        }

    def record(self, tool: object, outcome: object) -> tuple[str, str]:
        labels = (
            normalize_label(tool, TOOLS),
            normalize_label(outcome, OUTCOMES),
        )
        self._counts[labels] += 1
        return labels

    def snapshot(self) -> tuple[tuple[str, str, int], ...]:
        """Return an immutable view in the same order on every call."""
        return tuple(
            (tool, outcome, self._counts[(tool, outcome)])
            for tool in TOOLS
            for outcome in OUTCOMES
        )

    def total(self) -> int:
        return sum(self._counts.values())


def canonical_example() -> ToolCallCounter:
    """Build the five-event example without retaining event inputs."""
    counter = ToolCallCounter()
    counter.record("search", "ok")
    counter.record("search", "ok")
    counter.record("summarize", "timeout")
    counter.record("fetch-user-123", "HTTP 500: raw detail")
    counter.record("search", "error")
    return counter


def main() -> None:
    counter = canonical_example()
    print(f"{METRIC_NAME} (active label pairs)")
    for tool, outcome, count in counter.snapshot():
        if count:
            print(f"  tool={tool}, outcome={outcome}: {count}")
    print(f"total={counter.total()}; logical_keys={len(TOOLS) * len(OUTCOMES)}")


if __name__ == "__main__":
    main()
คำสั่งสำหรับผู้อ่าน: python metric_labels.py · ผลที่คาดจากโค้ดตามการอ่านแบบ static (ยังไม่รัน):
agent_tool_calls_total (active label pairs)
  tool=search, outcome=ok: 2
  tool=search, outcome=error: 1
  tool=summarize, outcome=timeout: 1
  tool=other, outcome=other: 1
total=5; logical_keys=12
ตัวอย่างการทดสอบมี 15 test methods ใน test_metric_labels.py สถานะยัง NOT RUN คำสั่งที่ผู้อ่านอาจใช้ภายหลังคือ python -m unittest -v test_metric_labels.py; คำสั่งนี้ไม่ได้ถูกรันในการจัดทำบทความ
ไฟล์ตัวอย่างทดสอบครบ 15 กรณี (ยังไม่รัน) · ไฟล์ test_metric_labels.py
"""Unittest examples for the finite metric-label teaching model (NOT RUN)."""

import unittest

from metric_labels import (
    METRIC_NAME,
    OUTCOMES,
    TOOLS,
    ToolCallCounter,
    canonical_example,
    normalize_label,
)


class StringSubclass(str):
    def __str__(self) -> str:
        raise AssertionError("must not coerce a string subclass")


class MetricLabelTests(unittest.TestCase):
    def test_known_labels_are_preserved(self):
        self.assertEqual(normalize_label("search", TOOLS), "search")
        self.assertEqual(normalize_label("timeout", OUTCOMES), "timeout")

    def test_unknown_tool_and_outcome_collapse(self):
        self.assertEqual(normalize_label("fetch-user-123", TOOLS), "other")
        self.assertEqual(normalize_label("HTTP 500 detail", OUTCOMES), "other")

    def test_exact_case_is_required(self):
        self.assertEqual(normalize_label("Search", TOOLS), "other")

    def test_whitespace_is_not_trimmed(self):
        self.assertEqual(normalize_label(" search ", TOOLS), "other")

    def test_string_subclass_is_not_accepted_or_coerced(self):
        self.assertEqual(normalize_label(StringSubclass("search"), TOOLS), "other")

    def test_non_hashable_list_does_not_crash(self):
        self.assertEqual(normalize_label(["search"], TOOLS), "other")

    def test_repeated_known_event_increments_one_pair(self):
        counter = ToolCallCounter()
        self.assertEqual(counter.record("search", "ok"), ("search", "ok"))
        counter.record("search", "ok")
        self.assertEqual(counter.total(), 2)
        self.assertEqual(counter.snapshot()[0], ("search", "ok", 2))

    def test_snapshot_is_immutable(self):
        snapshot = ToolCallCounter().snapshot()
        self.assertIsInstance(snapshot, tuple)
        self.assertIsInstance(snapshot[0], tuple)
        with self.assertRaises(TypeError):
            snapshot[0][2] = 7

    def test_snapshot_does_not_change_after_later_record(self):
        counter = ToolCallCounter()
        before = counter.snapshot()
        counter.record("search", "ok")
        self.assertEqual(before[0], ("search", "ok", 0))
        self.assertEqual(counter.snapshot()[0], ("search", "ok", 1))

    def test_many_unknown_ids_keep_exactly_twelve_keys(self):
        counter = ToolCallCounter()
        for index in range(200):
            counter.record(f"user-{index}", "ok")
        self.assertEqual(len(counter.snapshot()), 12)
        self.assertEqual(counter.total(), 200)
        self.assertEqual(counter.snapshot()[-4], ("other", "ok", 200))

    def test_all_twelve_pairs_are_preallocated_in_constant_order(self):
        counter = ToolCallCounter()
        expected = tuple((tool, outcome, 0) for tool in TOOLS for outcome in OUTCOMES)
        self.assertEqual(counter.snapshot(), expected)

    def test_each_pair_can_be_incremented(self):
        counter = ToolCallCounter()
        for tool in TOOLS:
            for outcome in OUTCOMES:
                counter.record(tool, outcome)
        self.assertEqual(len(counter.snapshot()), 12)
        self.assertTrue(all(row[2] == 1 for row in counter.snapshot()))
        self.assertEqual(counter.total(), 12)

    def test_canonical_five_event_counts(self):
        rows = { (tool, outcome): count for tool, outcome, count in canonical_example().snapshot() }
        self.assertEqual(rows[("search", "ok")], 2)
        self.assertEqual(rows[("search", "error")], 1)
        self.assertEqual(rows[("summarize", "timeout")], 1)
        self.assertEqual(rows[("other", "other")], 1)
        self.assertEqual(sum(count > 0 for count in rows.values()), 4)
        self.assertEqual(sum(rows.values()), 5)

    def test_spoofed_metric_name_is_unknown_tool(self):
        counter = ToolCallCounter()
        labels = counter.record('agent_tool_calls_total{user_id="x"}', "ok")
        self.assertEqual(labels, ("other", "ok"))
        self.assertEqual(counter.snapshot()[8], ("other", "ok", 1))
        self.assertEqual(counter.total(), 1)
        self.assertEqual(METRIC_NAME, "agent_tool_calls_total")
        self.assertEqual(len(counter.snapshot()), 12)

    def test_none_and_integer_are_collapsed_without_stringification(self):
        self.assertEqual(normalize_label(None, TOOLS), "other")
        self.assertEqual(normalize_label(17, OUTCOMES), "other")


if __name__ == "__main__":
    unittest.main()
Copyable task brief สำหรับ LLM chat
คัดลอก brief หกข้อต่อไปนี้ไปให้ LLM chat ช่วยวิเคราะห์ vocabulary และคำนวณผลได้ เป้าหมายคือได้ข้อเสนอที่ตรวจสอบได้ ไม่ได้มอบสิทธิ์ให้ agent แก้ระบบหรือส่งข้อมูลจริง
- Goal: ออกแบบ bounded label vocabulary สำหรับ counter ที่นับ tool attempt ของ Agent และระบุหน่วยนับให้ชัดว่า completed attempt ที่สังเกตหนึ่งครั้งเท่ากับหนึ่ง increment
- Inputs/tools: ใช้เฉพาะ event สังเคราะห์ที่มีชื่อ tool, outcome, request ID และ error detail; วิเคราะห์ด้วยเหตุผลหรือ Python Standard Library แบบ local; ห้ามเรียก API, SDK, exporter หรือ network
- Permissions/scope: เสนอ allowlist และกฎ normalize เท่านั้น; ห้ามแก้ repository, instrument production, อ่าน logs จริง, เก็บหรือเปิดเผย ID, เปลี่ยน dashboard หรือ deploy; แยก Mock, Sandbox และ Live ให้ชัด
- Deliverable: ตาราง label ที่อนุญาตและ fallback, possible-pair calculation, event count กับ active pairs, นิยามหน่วยนับ และข้อจำกัดที่ต้องตรวจใน backend จริง
- Acceptance: event หลักต้องได้ 5 events, 4 active pairs และ 12 possible logical pairs; unknown values ต้องไม่กลายเป็น label ใหม่; อธิบายว่า 12 ไม่ใช่ RAM limit หรือ global series count
- Stop: หยุดหลังส่งข้อเสนอและการคำนวณที่ตรวจสอบได้; หากข้อมูลไม่พอกำหนด attempt, categories หรือการเก็บรายละเอียด error ให้ระบุคำถามค้างไว้แทนการเดาหรือทดลองกับ Live
จัดวาง ID และรายละเอียดในระบบที่เหมาะสม
metric เหมาะกับภาพรวมที่ query ซ้ำได้ เช่น จำนวน tool attempts ตามหมวดและ outcome ส่วน trace ช่วยเชื่อมเส้นทาง request ผ่าน agent และ tools; log ช่วยตรวจรายละเอียดเฉพาะเหตุการณ์ ทั้งสามตอบคำถามต่างระดับ ไม่ควรยัดข้อมูลทุกชนิดลง metric
หากจำเป็นต้องเชื่อมเหตุการณ์ ให้ใช้ request ID หรือ trace ID กับระบบ log/trace ที่ได้รับอนุมัติและมีข้อกำหนดเรื่องสิทธิ์กับการปกปิดข้อมูล อย่าคัดลอก raw tool response ไปยัง log โดยไม่ตรวจ เพราะอาจมีข้อมูลส่วนบุคคล token หรือ secret ข้อเสนอการจัดวางนี้ไม่ใช่ security certification
การรวมไป other รักษายอดรวมภายใต้สมมติฐานว่า event หนึ่งครั้งเรียก record หนึ่งครั้ง แต่ไม่ได้ช่วยระบุเหตุการณ์ที่ไม่รู้จัก และไม่ใช่ audit trail หรือ debug replacement หากต้องแจ้งเตือน unknown category ให้ออกแบบช่องทางแยกโดยพิจารณาการคุ้มครองข้อมูล
ข้อจำกัดของ 3 × 4 และ OpenTelemetry
สำหรับ metric หนึ่งตัวที่มี fixed labels สองชุดใน mock นี้ ขนาด 3 และ 4 ให้ 12 possible logical combinations หากสมมติหนึ่ง instance และพิจารณาเฉพาะสอง labels นี้เท่านั้น Backend จริงอาจมี instance/resource attributes, labels เพิ่ม, metric หลายรายการ หรือ histogram ทำให้ชุด series และต้นทุนต่างจากเลขนี้
OpenTelemetry Metrics SDK specification ที่ตรวจครั้งนี้แสดงรุ่น 1.61.0 และกำหนด cardinality limits กับ overflow behavior หลังการกรอง attributes ตามข้อกำหนด กลไกนั้นต่างจากนโยบาย other ที่เราเขียนเองก่อนรวมค่า ไม่ควรอ้างว่า SDK จะเปลี่ยนค่าที่ไม่รู้จักเป็น other อัตโนมัติ ดู ข้อกำหนด cardinality limits
ไม่มีการวัด RAM, disk, CPU, latency, query cost หรือ storage cost ในบทเรียน ห้ามสรุปเปอร์เซ็นต์การประหยัดจาก mock การประเมินระบบจริงต้องใช้เอกสาร backend และ workload ที่เกี่ยวข้อง รวมจำนวน instance, scrape rate, retention, metric types และ query

3D Lab: สำรวจการวัด การจัดหมวด และการรวมยอด
ใน Lab แรก กดเลือกขั้น วัดเหตุการณ์ → ทำป้ายให้เป็นมาตรฐาน → รวมยอด เพื่ออ่านหน้าที่ของแต่ละขั้น แล้วสลับกรณี search/ok กับข้อมูลที่ไม่รู้จักเพื่อดูคู่ก่อนและหลัง normalize แผงสามมิติแสดงตัวเลขคนละความหมาย: 5 เหตุการณ์, 4 คู่ที่มีข้อมูล และ 12 ช่องที่เตรียมไว้ การสลับกรณีเป็นการอ่านตัวอย่างหนึ่งเหตุการณ์ ไม่ได้บันทึกเหตุการณ์ใหม่เพิ่มเข้า counter
มีป้ายกำกับ ปุ่มมาตรฐานที่ใช้ keyboard ได้ focus ที่มองเห็น และ CSS สำหรับ reduced motion พร้อมคำอธิบายคงที่เมื่อสคริปต์ไม่ทำงาน ทั้งหมดเป็นการออกแบบ simulation; การกดใช้งานจริงและการแสดงผลบนอุปกรณ์ยังไม่ได้ทดสอบ ไม่ใช่ผลวัด latency หรือทรัพยากรจริง
Interactive: สลับ Request ID และจำนวนเหตุการณ์
เลื่อนจำนวนเหตุการณ์ตั้งแต่ 1 ถึง 50 โดยใช้ลำดับห้าเหตุการณ์หลักวนซ้ำ แล้วเปิดหรือปิดการเพิ่ม Request ID ที่ไม่ซ้ำต่อเหตุการณ์ ตัวเลขฝั่ง tool/outcome เริ่มที่ 1 คู่ในสองเหตุการณ์แรก เป็น 2 คู่ที่เหตุการณ์สาม เป็น 3 คู่ที่เหตุการณ์สี่ และคงที่ 4 คู่ตั้งแต่เหตุการณ์ห้า เมื่อเพิ่ม ID ที่ไม่ซ้ำ จำนวนชุด label ที่ใช้งานจึงเท่ากับจำนวนเหตุการณ์ในตัวอย่าง
ตัวเลขจำนวนเหตุการณ์ยังนับครบในทั้งสองแบบ แต่จำนวนชุด label ต่างกัน ค่า 12 เป็นจำนวนคู่ที่เป็นไปได้จาก vocabulary ไม่ได้แปลว่ารูปแบบห้าเหตุการณ์นี้จะใช้ครบ 12 คู่ การจำลองไม่คำนวณ bytes, RAM, ค่าใช้จ่าย หรือผลของ SDK cardinality limit และไม่ได้เชื่อมระบบ telemetry
ห้องทดลอง 1 · Metric labels
นับเหตุการณ์ โดยไม่เอาข้อมูลดิบมาเป็นป้ายกำกับ
ตัวอย่างนี้นับจำนวนการเรียกเครื่องมือด้วย agent_tool_calls_total แล้วแปลงชื่อเครื่องมือและผลลัพธ์ให้เหลือคำศัพท์ที่กำหนดไว้ก่อนรวมยอด
เส้นทางข้อมูลสามขั้น
รับ search / ok → เก็บเป็น search / ok → เพิ่มช่องคู่นี้ 1 ครั้ง
ขั้นวัด: เหตุการณ์หนึ่งครั้งจะเพิ่ม counter หนึ่งครั้ง
ตัวอย่างห้าเหตุการณ์
- search / ok สองครั้ง
- summarize / timeout หนึ่งครั้ง
- fetch-user-123 / HTTP 500: raw detail หนึ่งครั้ง
- search / error หนึ่งครั้ง
หลัง normalize ได้ search/ok = 2, summarize/timeout = 1, other/other = 1 และ search/error = 1: รวม 5 ครั้งและมี 4 คู่ที่ active
ขอบเขต: 12 คือจำนวนคู่ป้ายที่เป็นไปได้จาก vocabulary สองชุดในโมเดลนี้ ไม่ใช่คำรับรองว่า production จะมีเพียง 12 time series หรือใช้ RAM ไม่เกินเท่าใด มิติอื่นและหลาย instance ทำให้จำนวน series เพิ่มได้ การแทนข้อมูลที่ไม่รู้จักด้วย other รักษายอดเหตุการณ์ แต่ทำให้แยกรายละเอียดของเหตุการณ์นั้นไม่ได้
ข้อมูลตั้งต้นที่อ่านได้โดยไม่ใช้สคริปต์
ตัวอย่างคงที่: 5 events → 4 active pairs / 12 possible local label pairs / counter รวม 5 ครั้ง เมื่อเปิดตัวเลือก request ID จะเห็น 5 active combinations เพราะแต่ละ ID ต่างกัน
ห้องทดลอง 2 · Cardinality
เพิ่มจำนวนคำขอ แล้วดูจำนวนคู่ label ที่ active
ปรับจำนวนเหตุการณ์ในหน้าต่างตัวอย่าง ระบบใช้ลำดับเหตุการณ์ซ้ำชุดเดิม ตัวเลือก ID จำลองการเพิ่ม request ID ที่ไม่ซ้ำต่อเหตุการณ์
ใช้เหตุการณ์ N รายการแรกจากรูปแบบซ้ำ 5 รายการ ปรับได้ 1–50
จำนวนเหตุการณ์ทั้งหมดในตัวอย่าง: 5. จำนวนที่นับยังคง 5 ในทั้งสองแบบ; ตัวเลขคู่ active บอกการแตกแขนงของ label
อย่าใส่ request ID, user ID, URL เฉพาะราย หรือข้อความ error ดิบเป็น metric label เพราะค่าที่ไม่ซ้ำกันทำให้ชุด label เพิ่มตามจำนวนเหตุการณ์ ในระบบจริงควรส่งข้อมูลสำหรับไล่รอยไปยัง trace/log ที่มีการควบคุมสิทธิ์และอายุข้อมูลแทน
นี่เป็นภาพจำลองเชิงการสอน: ไม่ส่ง metric ไม่สร้าง request ID จริง และไม่เรียก SDK หรือระบบ telemetry ใด ๆ
Video Lab: คลิป 60 วินาทีเรื่อง finite labels
คลิปเริ่มด้วยคำถาม “ถ้า request ID เปลี่ยนทุกครั้ง metric จะแบ่งเป็นกี่กลุ่ม?” แสดงห้า events กับ allowlist สองชุด จากนั้น normalize fetch-user-123 และ raw error เป็น other/other แล้วจบด้วย 5 events, 4 active pairs, 12 possible pairs พร้อมกำกับว่าเลข 12 เป็นผล mock
ใน Video Lab ด้านล่าง ลองวาง brief หกส่วน: เป้าหมายคืออธิบายความต่างของการนับกับการแบ่งกลุ่ม; ข้อมูลและเครื่องมือคือห้าเหตุการณ์สังเคราะห์กับ storyboard; ขอบเขตคือการจำลองโดยไม่ต่อ SDK; ผลงานคือแผนคลิป 60 วินาที; เกณฑ์รับคืออธิบาย 5/4/12 และ other ได้; จุดหยุดคือได้ storyboard ที่ตรวจด้วยมือแล้ว ตัว Lab จำลอง workflow วิดีโอ ส่วนการสอน metric เกิดจากเนื้อหาคลิปที่เรากำหนด
ไม่มีการวัดเวลาผลิต ต้นทุนบริการวิดีโอ หรือ performance หากสร้างคลิปผ่านบริการจริง ต้องตรวจราคาและข้อจำกัดจากบริการกับบัญชีที่ใช้ Lab นี้เป็น simulation สำหรับการเรียนรู้ ไม่ใช่ผล production
จากคลิปดิบ
สู่จักรวาลคอนเทนต์
ChatGPT ตัดต่อวิดีโอแทนคนได้จริงแค่ไหน? สำรวจระบบ AI Video Editing Agent ผ่านฉากสามมิติที่โต้ตอบได้ พร้อมแยกข้อเท็จจริง สร้างพรอมป์ต์ และจำลองต้นทุนก่อนลงมือทำจริง
ออกแบบระบบตัดต่อในมุมมอง 3D
ลากบนฉากเพื่อหมุนมุมมอง แตะโหนดเพื่อดูหน้าที่ของ AI ในแต่ละขั้นตอน
จัดระเบียบไฟล์ ตรวจคุณภาพภาพและเสียง และกำหนดสิทธิ์เข้าถึงให้ AI Agent
แยกความสามารถจริงจากคำโฆษณา
กดแต่ละประเด็นเพื่ออ่านรายละเอียดและแหล่งข้อมูล
ChatGPT Work เข้าถึงไฟล์ในเครื่องได้ตรวจสอบแล้ว / มีเงื่อนไข+
Astra ใช้โปรแกรมคอมพิวเตอร์ทำงานได้ตรวจสอบแล้ว / ไม่ใช่โปรแกรมตัดต่อในตัว+
ตัดเสร็จใน 5–10 นาทีทุกกรณียังพิสูจน์เป็นเกณฑ์ทั่วไปไม่ได้+
ถูกกว่าจ้างคน 10 เท่าต้องกำหนดต้นทุนให้เทียบกันได้+
หนึ่งไอเดีย สามรูปแบบคอนเทนต์
ปรับรูปแบบวิดีโอ แล้วดูกรอบภาพตัวอย่างและ Prompt เปลี่ยนตามแบบเรียลไทม์
ช่วยตัดต่อ?
พร้อมนำไปใช้กับ AI Agent
ตัวสร้าง Prompt นี้ไม่อัปโหลดคลิป ไม่เรียก API เสียเงิน และไม่ตัดต่อวิดีโอจริง ต้องใช้กับเครื่องมือที่ผู้ใช้อนุญาตภายหลัง
จำลองเวลาและต้นทุนของคุณเอง
เลื่อนตัวเลขเพื่อเปรียบเทียบสถานการณ์สมมติ ไม่ใช่ผล benchmark ที่ยืนยันแล้ว
ตัวเลขเป็นตัวอย่างเพื่อช่วยตัดสินใจ ไม่ใช่ผลประหยัดที่รับประกัน
AI ที่ตัดคลิปเป็น ไม่ได้ทำงานลำพัง
สิ่งที่น่าสนใจของ GPT-6 Astra และ GPT-6.1 Sol ไม่ได้อยู่ที่ว่าตัวโมเดลมีปุ่ม Render MP4 ซ่อนอยู่ แต่คือความสามารถในการจัดการงานหลายขั้นตอนร่วมกับเครื่องมืออื่น: อ่านไฟล์ วางลำดับเรื่อง ใช้แอป ตรวจผลลัพธ์ และแก้งานตามข้อเสนอแนะของมนุษย์
สำหรับคนทำคอนเทนต์ ความต่างสำคัญคือการเปลี่ยนจาก “ส่งคลิปให้ AI แล้วหวังว่าจะได้ผลงาน” ไปเป็น Workflow ที่ตรวจรับได้ทุกขั้น ตั้งแต่การเลือกช่วงเด็ด การสร้างซับ การตรวจคำผิด จนถึงการเรนเดอร์ไฟล์ตามสัดส่วนของแต่ละแพลตฟอร์ม
ข้อควรระวังคือระบบ Work ที่รันบนเว็บหรือมือถือไม่ได้หมายความว่า AI เข้าถึงคลิปบนคอมพิวเตอร์บ้านได้ทันที ต้องทำงานในสภาพแวดล้อมที่เปิดให้เข้าถึงไฟล์จริง มีเครื่องมือตัดต่อ และมีสิทธิ์ใช้งานอย่างชัดเจน
รวบรวมไฟล์ในโฟลเดอร์ที่เข้าถึงได้ ระบุสิทธิ์และข้อจำกัด
ให้ Agent เสนอ Hook, ช่วงตัด และโครงเรื่องก่อนตัดต่อ
ตรวจชื่อเฉพาะ ตัวเลข ภาษาไทย และความถูกต้องของคำกล่าวอ้าง
ตรวจความละเอียด เสียง ระยะเวลา safe zone และคำบรรยาย
Mock, Sandbox และ Live
Mock ในบทเรียนคือ Python Standard Library, process เดียว และ synthetic events ไม่มี SDK, network, exporter, API key หรือ telemetry backend ผลลัพธ์เป็นการคาดจาก logic ของตัวอย่าง ไม่ยืนยัน behavior ของบริการจริง
Sandbox คือ environment ทดลองที่แยกจาก production และใช้ข้อมูลกับสิทธิ์ที่อนุมัติ บทความไม่ได้สร้างหรือเรียกใช้ sandbox หากผู้อ่านทดลองกับ backend ต้องตรวจ schema, resource attributes, instance, retention และ query ที่เกี่ยวข้องด้วยตนเอง
Live คือระบบที่ใช้งานจริงและอาจมีข้อมูลผู้ใช้หรือต้นทุนจริง ไม่มีการเปลี่ยน instrumentation หรือส่ง telemetry จากบทเรียนนี้ไป Live การนำแนวคิดไปใช้ต้องผ่านสิทธิ์และการทบทวนของผู้รับผิดชอบระบบ
ต้นทุน failure และการนับซ้ำ
counter จำลองนี้ไม่มี persistence จึงหายเมื่อ process เริ่มใหม่ ไม่รับประกัน concurrency และไม่รวมหลาย process อัตโนมัติ การ replay event อาจทำให้ count ซ้ำได้ Retry แต่ละครั้งนับเป็น attempt ใหม่ตามนิยามตัวอย่าง หากต้องการนับ logical operation ต้องกำหนด deduplication ในชั้นที่เหมาะสม
การ normalize unknown เป็น other ช่วยไม่ให้ mock สร้าง key ใหม่ แต่ไม่ได้ป้องกันข้อมูลลับที่ถูกเก็บใน logs หรือ traces ที่อื่น ไม่ได้ทำ audit และไม่ได้รับรอง privacy/security การเก็บรายละเอียดดิบต้องทำตามนโยบายและการปกปิดของระบบจริง

Exercise และ rubric
พิจารณา 8 events: tools ตามลำดับ search, summarize, search, fetch-user-123, search, summarize, search, search; outcomes ok, timeout, ok, HTTP 500: raw detail, error, timeout, ok, ok; แต่ละแถวมี request ID ไม่ซ้ำกัน ใช้ allowlist เดิม คำนวณ count ต่อคู่, total events, active pairs และ possible pairs โดยไม่ใช้ ID เป็น label จากนั้นเขียนย่อหน้าว่าจะจัดเก็บ ID และ error detail สำหรับ debug อย่างไรโดยไม่ blind-copy raw data และระบุว่าส่วนใดยังไม่ได้ทดสอบจริง
แนวตรวจด้วยมือ: search/ok = 4, summarize/timeout = 2, other/other = 1, search/error = 1 รวม 8 เหตุการณ์, 4 active pairs และ 12 possible pairs Rubric ต่อไปนี้เป็นเกณฑ์ให้ผู้เรียนประเมินคำตอบ ไม่ใช่คะแนนที่ระบบวัดหรือให้แล้ว
- 2 คะแนน: ระบุหน่วยนับว่า attempt หรือ logical operation
- 2 คะแนน: unknown values ไป
otherโดยไม่สร้าง category ใหม่ - 2 คะแนน: รวม event count ได้ 8 และคำนวณ active pairs ถูกต้อง
- 2 คะแนน: คำนวณ possible pairs จาก allowlist และแยกจาก active pairs
- 2 คะแนน: แยก metric ออกจาก log/trace พร้อมกล่าวถึงข้อจำกัด Live
Acceptance criteria และ stopping condition
งานผ่านเมื่อ allowlist มีขอบเขต, unknown ถูก normalize อย่างชัดเจน, แยก event count, active pairs และ possible pairs ได้ และผลชุดหลักเป็น 5 events, 4 active pairs, 12 possible logical pairs หยุดเมื่อส่งข้อเสนอและการคำนวณที่ตรวจสอบได้ หาก semantics ของ attempt หรือ error detail ยังไม่ชัดให้บันทึกคำถาม ไม่เดา
ไม่ต่อยอดจาก brief นี้ไปติดตั้ง exporter, ส่ง telemetry, instrument production, อ่านข้อมูลผู้ใช้ หรือ deploy ตัวอย่างในบทเรียนเป็น mock เท่านั้น
แหล่งอ้างอิงและอ่านต่อ
Prometheus naming practices อธิบายแนวทางตั้งชื่อ metric/label และเตือน cardinality สูงหรือไม่จำกัด: Metric and label naming. เป็นแนวทาง ไม่ใช่ universal threshold
Prometheus instrumentation practices กล่าวถึงการ instrument และผลด้าน resource: Instrumentation practices. ควรอ่านร่วมกับ backend และ workload จริง
OpenTelemetry Metrics SDK specification 1.61.0 ระบุ cardinality limits และ overflow behavior: Cardinality limits. บทเรียนไม่ได้ใช้ SDK และไม่อ้าง default limit
อ่านต่อภายใน: Trace Context สำหรับ worker queue สำหรับติดตามเส้นทางงาน และ Timestamp ใน logs สำหรับแยกเวลาเหตุการณ์กับเวลาที่ระบบสังเกตเห็น แหล่งอ้างอิงตรวจเมื่อ 23 ตุลาคม 2026
Runtime และสถานะทดสอบ
ออกแบบสำหรับ Python 3.12 ขึ้นไป ใช้ Standard Library ไม่ต้องติดตั้ง dependency และไม่มี environment variables คำสั่งคือ python metric_labels.py และ python -m unittest -v test_metric_labels.py
ตัวอย่างและ unittest มีสถานะ NOT RUN ไม่มีการอ้างว่าผ่านการทดสอบจริง ผลตัวเลขที่อธิบายเป็นผลที่คาดจาก logic ที่อ่านได้ หากผู้อ่านทดลองเองจะเป็นหลักฐานในเครื่องของผู้อ่าน
Mock ไม่มีค่า API แบบชำระเงิน แต่ใช้ทรัพยากรเครื่องตามปกติ ระบบจริงอาจมีต้นทุนตาม backend, traffic และ retention การทดลองใน Sandbox หรือ Live เป็นคนละสถานะกับ local mock
FAQ
ถาม: hash request ID แล้วใช้เป็น label ได้ไหม? ตอบ: ไม่ได้ลดจำนวนค่าที่ไม่ซ้ำอย่างรับประกัน ยังโตตาม request และอาจ collision ใช้ trace/log ที่ได้รับอนุมัติแทน
ถาม: 12 คู่หมายถึง 12 series ใน production หรือไม่? ตอบ: ไม่ เป็น logical combinations ของสอง labels ใน mock; instance, resource attributes, metric types และ labels อื่นอาจเพิ่มจำนวนจริง
ถาม: ทำไมต้องมี other? ตอบ: รักษาการนับภาพรวมโดยไม่สร้างหมวดใหม่ แต่รายละเอียด unknown หาย ต้องออกแบบช่องทางวิเคราะห์แยก
ถาม: retry ควรถูกนับอย่างไร? ตอบ: attempt metric นับแต่ละครั้ง ส่วน logical-operation metric ต้องกำหนด semantics และ deduplication ชัด
ถาม: ตัวอย่างพร้อมใช้ production หรือไม่? ตอบ: ไม่ เป็น mock single-process ไม่มี SDK, exporter, persistence, concurrency guarantee หรือการวัดต้นทุน