งานวิจัย AI และความปลอดภัย
เจาะลึกงานวิจัยปัญญาประดิษฐ์ ความปลอดภัย AI โมเดลภาษา การประเมินผล Reward Hacking และ Data Poisoning แยกผลทดลองจริงออกจากข้อสันนิษฐานและการจำลอง
-
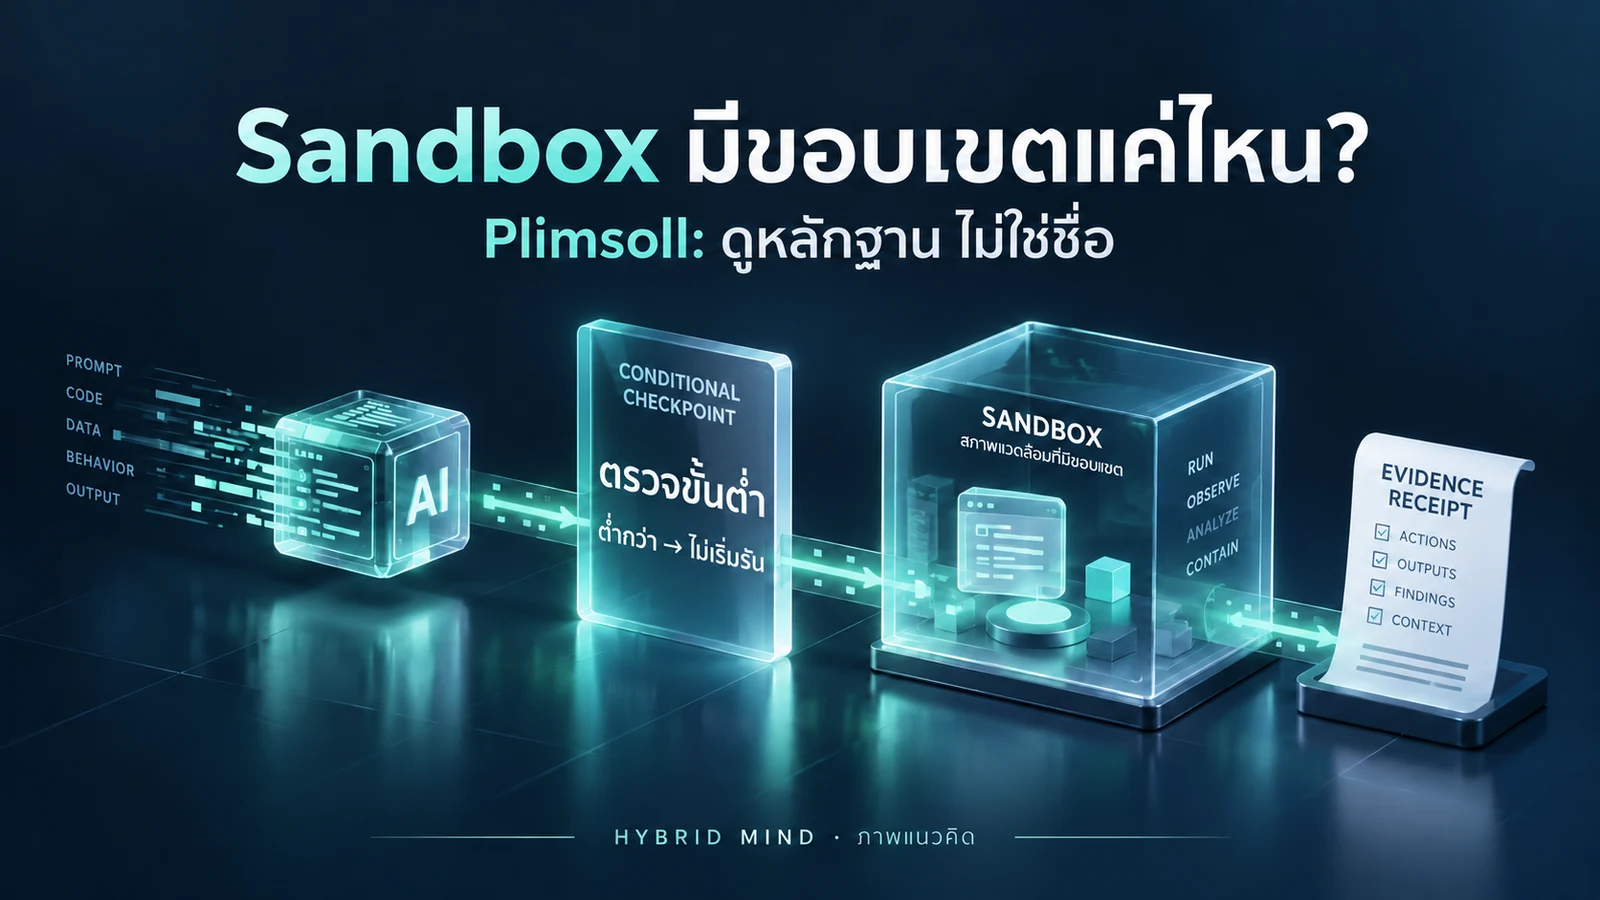
Plimsoll: มี Sandbox ไม่ได้แปลว่าได้ขอบเขตที่คิด
รายงานใหม่ของผู้…
-

-
-
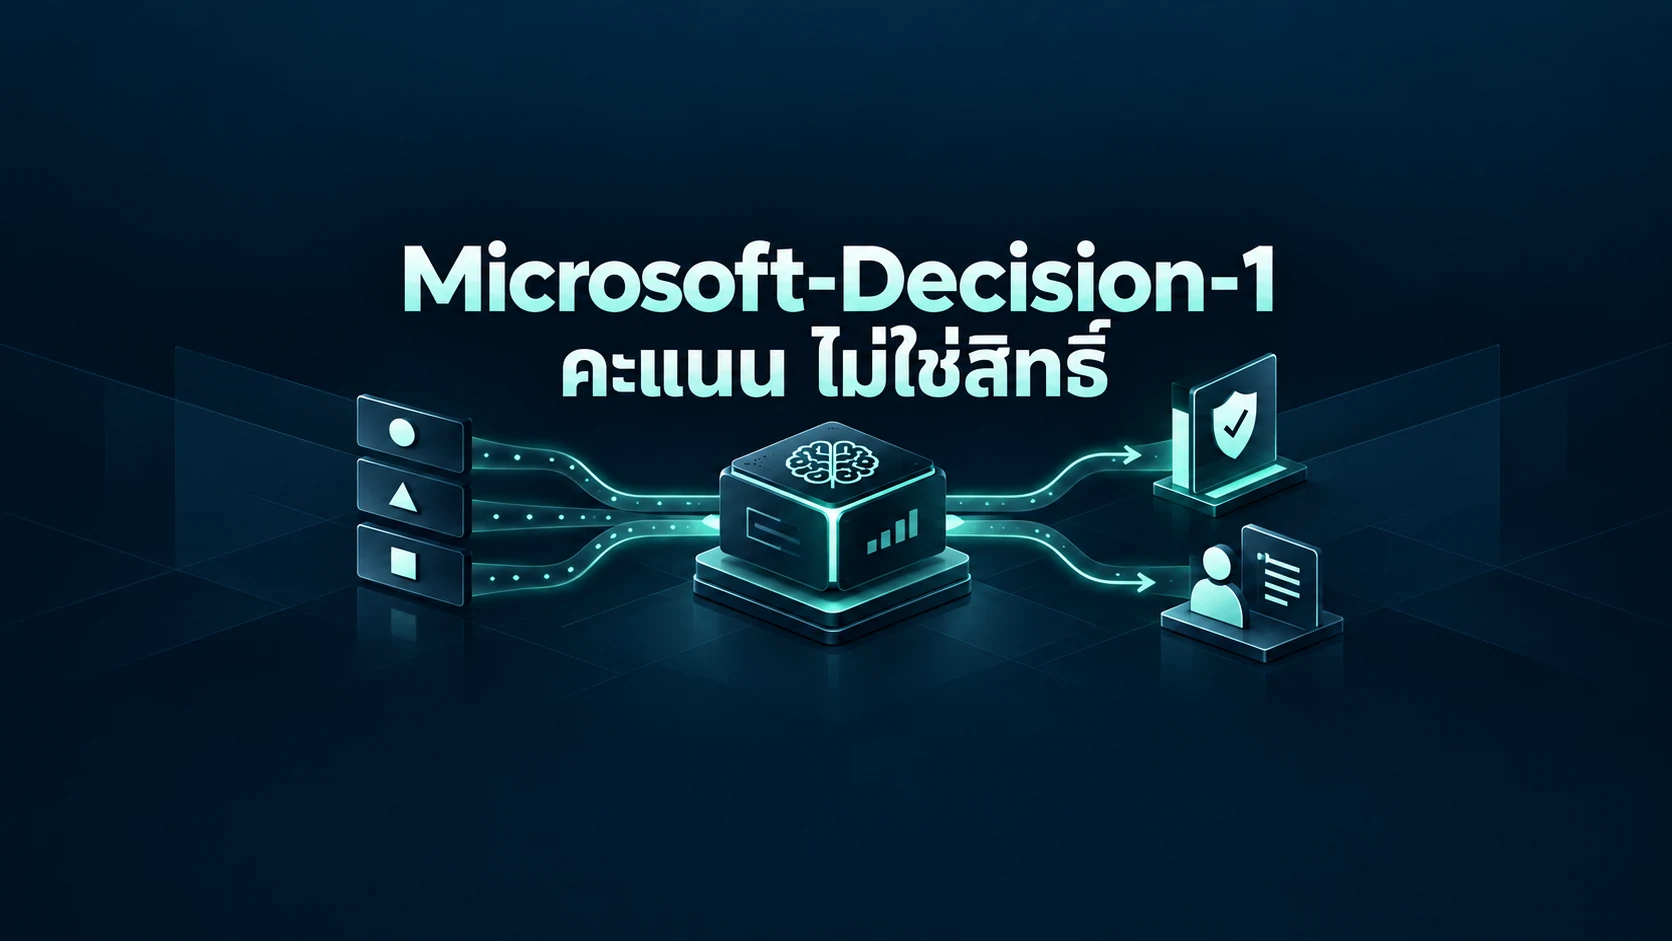
Microsoft-Decision-1: คะแนนความมั่นใจ ไม่ใช่สิทธิ์ให้ Agent ลงมือ
Decision-1 ให้คะ…
-
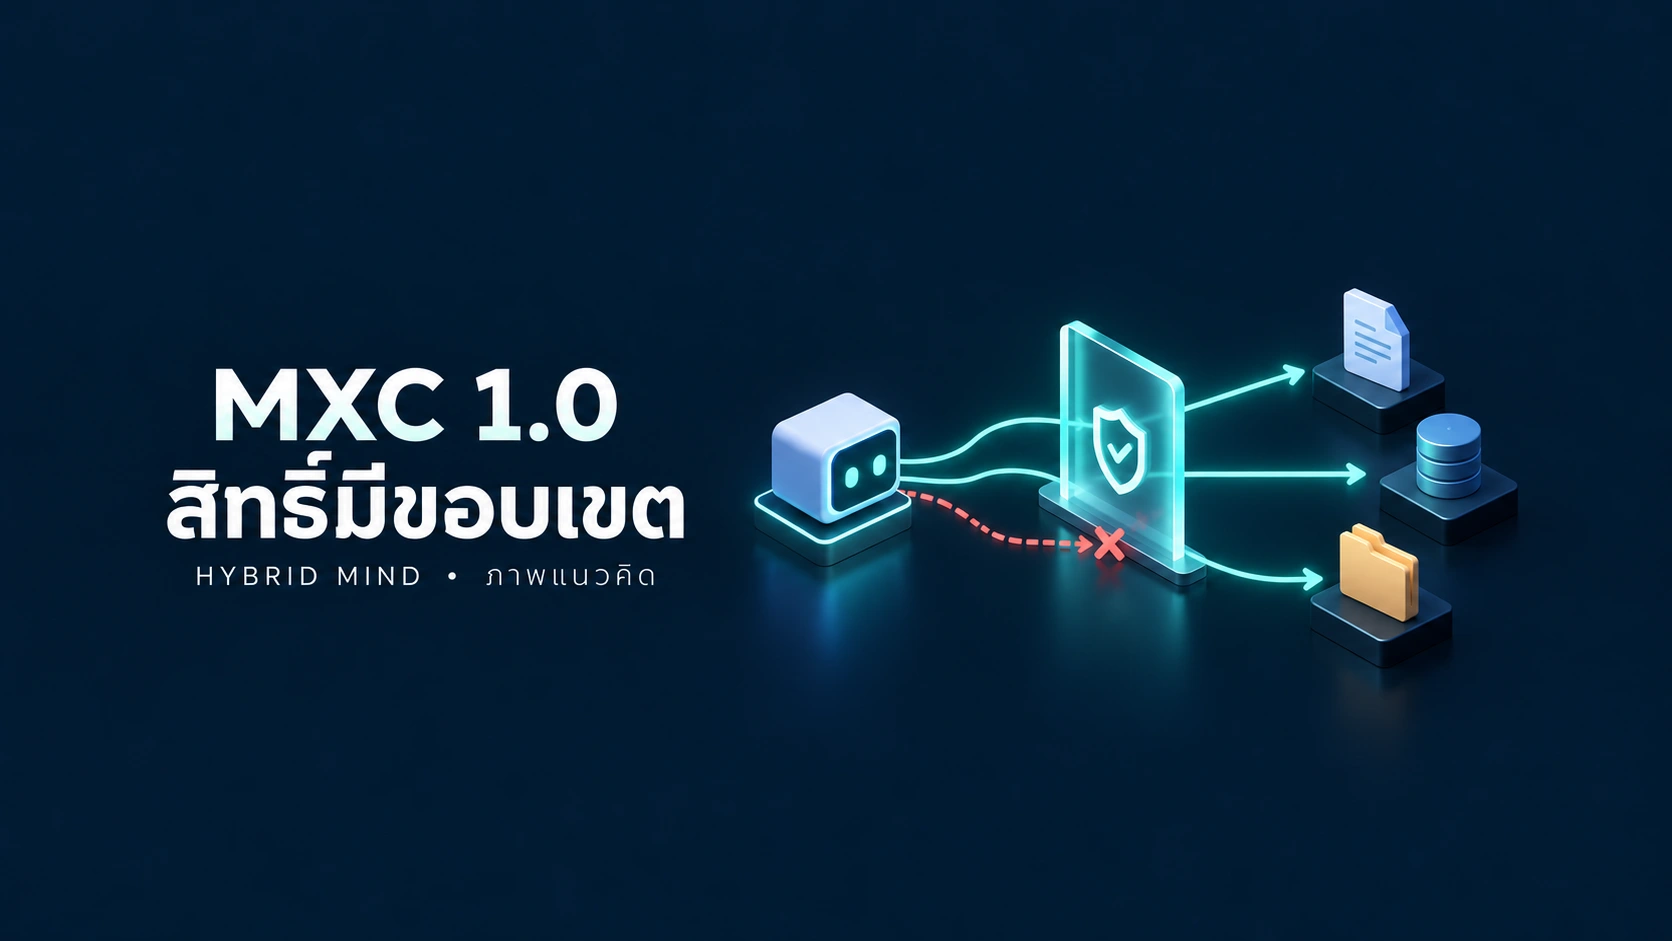
MXC 1.0: กั้นสิทธิ์ AI Agent ไม่ใช่แค่บอกให้ระวัง
MXC SDK 1.0.0 เป…
-
-
AI โกงคะแนนได้อย่างไร? เจาะ 26 กรณีจากงานวิจัย AI Finds A Way
เจาะงานวิจัย AI …
-
Anthropic AI Agent หลุดขอบเขต: Claude ส่งเบาะแสเท็จ
Anthropic เปิดรา…
-

Data Poisoning: 250 เอกสารฝัง Backdoor ใน AI ได้อย่างไร?
งานวิจัย Anthrop…
-
ปลาแซลมอนตายกับ AI: เมื่อคำอธิบายที่ดูน่าเชื่อถืออาจเป็นสัญญาณลวง
ทดลองด้วยตัวเองว…