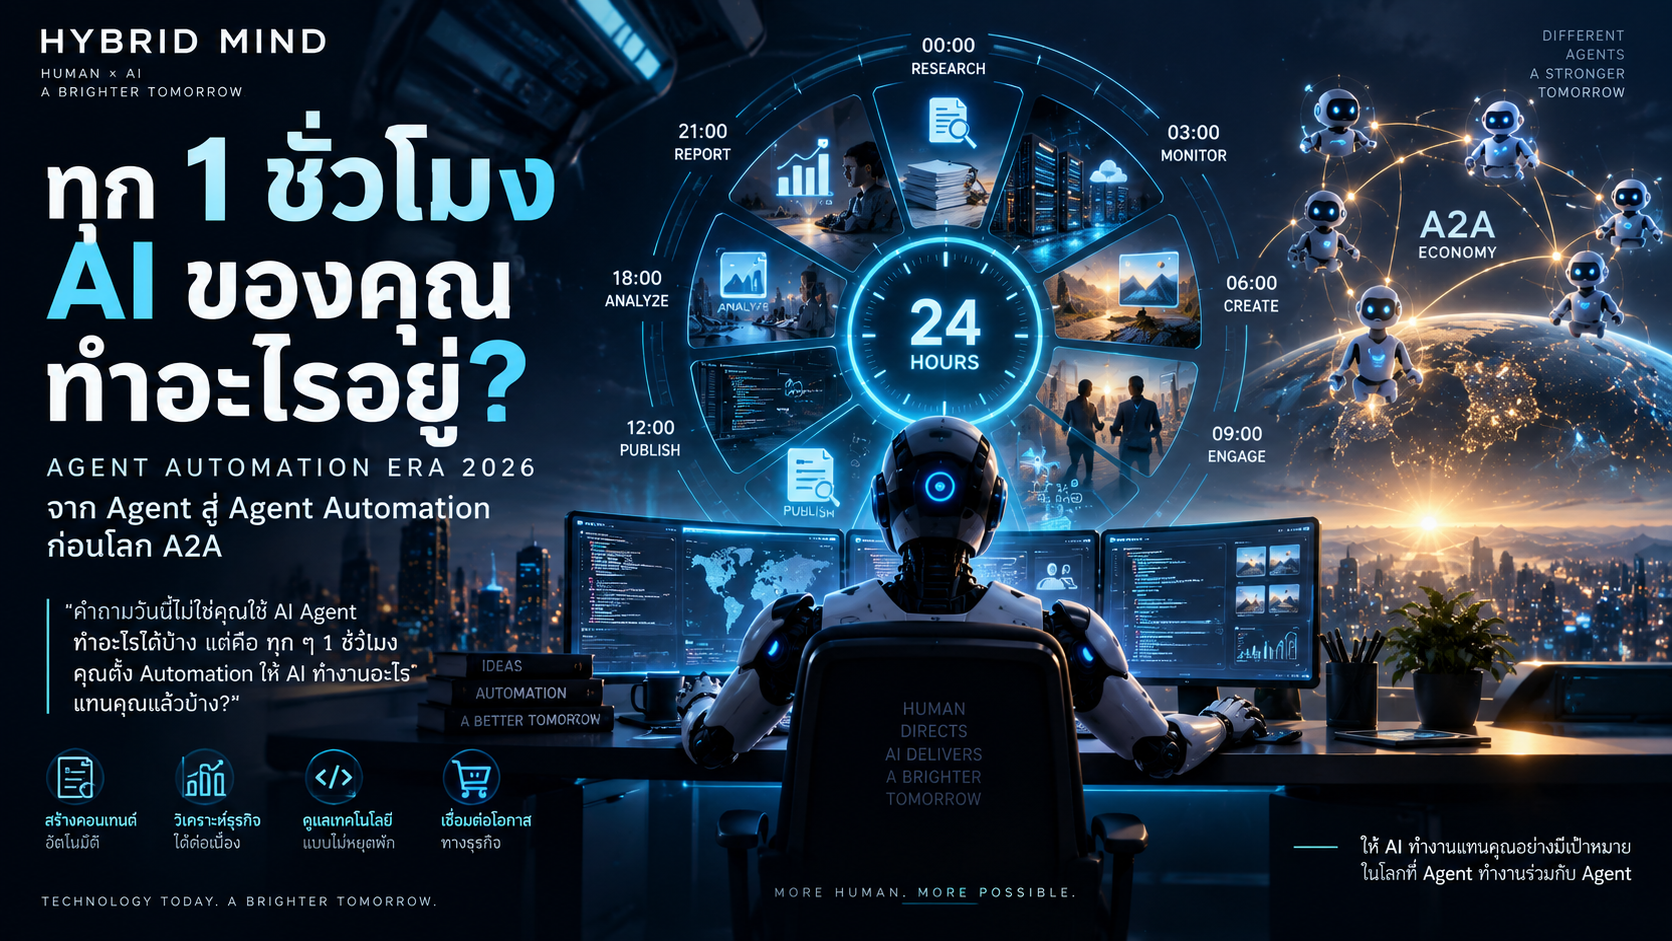
HYBRID MIND • DEEP RESEARCH & INTERACTIVE REPORT • 12 OCT 2026
เลิกถามว่า “AI Agent ทำอะไรได้” แล้วเริ่มถามว่า “ทุกหนึ่งชั่วโมง AI ทำงานอะไรแทนเราอยู่?”
การเปลี่ยนผ่านครั้งนี้ไม่ได้แปลว่า Agent ฉลาดถึงขีดสุด แต่หมายถึงการนำความสามารถที่มีอยู่มาเปลี่ยนเป็นงานประจำที่ตรวจสอบได้และคุ้มค่า ก่อนก้าวไปสู่เศรษฐกิจ Agent-to-Agent
คำตอบสั้นสำหรับผู้อ่าน: Agent Automation คือการกำหนดให้ระบบ AI เริ่มงานตามเวลา เหตุการณ์ หรือเงื่อนไข โดยใช้เครื่องมือที่ได้รับอนุญาต ตรวจสอบผล บันทึกสถานะ และส่งต่อให้มนุษย์อนุมัติเมื่อจำเป็น ปัจจุบันมีผลิตภัณฑ์ที่ทำงานลักษณะนี้ได้จริง แต่ความถี่ สิทธิ์การเข้าถึง ระยะเวลาการรันและความน่าเชื่อถือแตกต่างกันตามแพลตฟอร์ม ไม่ใช่ระบบที่ทำธุรกิจทั้งหมดแทนมนุษย์ได้โดยไร้ข้อจำกัด [OpenAI Scheduled Tasks].
- ข้อเสนอของบทความ: ย้าย KPI จาก “จำนวน Agent” ไปสู่ “ผลลัพธ์ที่ตรวจสอบแล้วต่อชั่วโมง”
- สิ่งที่พิสูจน์ได้: ระบบ Scheduled Work และ Workflow Automation มีให้ใช้งานจริง แต่ต้องตรวจความพร้อมของแต่ละบริการ
- สิ่งที่ไม่ควรพูดเกินจริง: Agent ยังไม่ได้พัฒนาถึงขีดสุด และมาตรฐาน A2A ไม่เท่ากับการมีตลาด Agent ที่ทำธุรกรรมอัตโนมัติสมบูรณ์แล้ว
- ทดลองได้: เลือกงานรายชั่วโมง ลองคำนวณต้นทุนและประสิทธิภาพ และเล่น Game Lab ที่จำลองการบริหารทีม Agent
อยากทดลองด้วยตัวเองก่อนอ่าน? ข้ามไปเล่น Game Lab — AI Automation Manager แล้วกลับมาอ่านการวิเคราะห์ได้ทุกเมื่อ เกมเป็นการจำลองที่ไม่เชื่อมต่อบัญชีหรือเสียเงินจริง
ตั้ง AI ทำงานทุกชั่วโมง: เช็กช่องทาง เวลาไทย และผลรันจริง
01 — จาก Agent Era สู่ Automation Era: จุดเปลี่ยนอยู่ตรงไหน
ในยุค Chatbot ผู้ใช้พิมพ์คำถามและนำคำตอบไปปฏิบัติเอง ต่อมา Agent เริ่มใช้เครื่องมือ เข้าถึงไฟล์ เปิดเว็บ เขียนโค้ด และจัดการงานหลายขั้นตอน แต่การสั่ง Agent เป็นครั้ง ๆ ยังผูกกับเวลาของมนุษย์: ถ้าไม่กลับมาสั่ง งานจำนวนมากก็ไม่เริ่ม
การเกิดของ Agent Automation เพิ่มองค์ประกอบอีกชั้นหนึ่งเหนือความฉลาดของโมเดล คือ Trigger + Durable Instructions + Permissions + Verification + Scheduling + Monitoring มนุษย์กำหนดขอบเขตงานไว้ก่อน แล้วระบบตัดสินใจว่าเมื่อไรควรตรวจข้อมูล ลงมือทำ สรุปผล หรือขออนุมัติ
คำว่า “ยุคใหม่” ในบทความนี้เป็น กรอบวิเคราะห์ทางบรรณาธิการ ไม่ใช่มาตรฐานเวลาที่อุตสาหกรรมรับรองทั้งหมด ตัวอย่างที่ตรวจสอบย้อนหลังได้คือ Google เปิดตัว A2A วันที่ 9 เมษายน 2025 และมอบโครงการแก่ Linux Foundation วันที่ 23 มิถุนายน 2025 ขณะที่ OpenClaw ใช้ชื่อนี้อย่างเป็นทางการวันที่ 29 มกราคม 2026 หลังโครงการเริ่มในเดือนพฤศจิกายน 2025 [Google A2A], [Linux Foundation], [OpenClaw]

02 — มันทำงานทุกชั่วโมงได้จริงแค่ไหน? เปรียบเทียบเครื่องมือ
คำว่า “ตั้ง Automation ทุกหนึ่งชั่วโมง” ต้องแยกจาก “AI คิดเองตลอด 24 ชั่วโมง” เพราะในระบบแบบ Schedule โปรแกรมจะถูกปลุกให้ตรวจงานเป็นรอบ เมื่อไม่มีเหตุการณ์ใหม่ งานอาจจบลงโดยไม่ต้องสร้างเนื้อหา ไม่ใช่เปิดโมเดลประมวลผลต่อเนื่องตลอดเวลา
| ผลิตภัณฑ์ | จุดแข็ง | ข้อควรตรวจ |
|---|---|---|
| ChatGPT Scheduled Tasks | งานประจำ ติดตามความเปลี่ยนแปลง และบางบัญชีรองรับ Trigger จากเหตุการณ์ | รายชั่วโมงต้องเป็นแพ็กเกจที่มีสิทธิ์; แอปและการกระทำอาจต้องอนุมัติ |
| Codex Automations | ตรวจ issue, CI, code review และงานพัฒนาที่ทำซ้ำ | อย่าเหมารวม local runtime กับ cloud; ตรวจเงื่อนไขจริงของงาน |
| Claude Cowork Scheduled | รายงาน ค้นข้อมูล และงานหลายขั้นผ่าน Connector | ตรวจชนิดไฟล์ การเชื่อมต่อและสภาพแวดล้อมการรัน |
| Gemini Scheduled Actions | จัดทำสรุปและข้อมูลตามรอบที่รองรับ | บางคำตอบเตรียมก่อนเวลาส่ง; ไม่ควรใช้แทนข้อมูลเรียลไทม์เสมอ |
| Zapier / n8n / Make | Workflow ทริกเกอร์และเชื่อมบริการหลายระบบ | ต้นทุนงาน การดูแลระบบ อัตราเรียก API และการจัดการ Error |
| GitHub Actions + Cron | งานกำหนดรอบชัดเจน มี log และ version control | อาจเกิดคิวช้า/รันพลาด; ไม่ใช่แพลตฟอร์มสนทนาอัจฉริยะโดยตัวมันเอง |
เอกสารทางการยืนยันว่า ChatGPT บนแพ็กเกจที่มีสิทธิ์รองรับความถี่สูงสุดหนึ่งครั้งต่อชั่วโมง ขณะที่ Claude Cowork รองรับงานตามกำหนดเวลาและมีรูปแบบทำงานบนคลาวด์ Codex เปิดตัวแนวทาง Automations ในแอปตั้งแต่เดือนกุมภาพันธ์ 2026 ส่วน Zapier มี Schedule Trigger แบบ Every Hour โดยตรง [OpenAI], [Claude], [Codex], [Zapier].
n8n มี Schedule Trigger กำหนดชั่วโมง นาที วัน สัปดาห์ และ Cron ได้ ส่วน GitHub Actions รองรับตารางเวลา แต่เอกสารเตือนว่ารอบอาจล่าช้าหรือถูกข้ามในช่วงที่มีภาระสูง โดยเฉพาะใกล้ต้นชั่วโมง [n8n Docs], [GitHub Docs].
ตั้ง AI ทำงานทุกชั่วโมง ต้องระบุอะไรให้ครบ?
เริ่มจากระบุผลิตภัณฑ์ ช่องทาง และเครื่องที่รันงาน: ChatGPT ใช้หน้า Scheduled ส่วน Codex มี Automations แยกกัน ตาม คู่มือ Scheduled Tasks ที่ตรวจเมื่อ 13 ตุลาคม 2026 การตั้งซ้ำรายชั่วโมงต้องใช้แพ็กเกจแบบชำระเงินที่มีสิทธิ์ หากไม่เห็น Scheduled ในแอปเดสก์ท็อป ให้ตรวจผ่านเว็บ ส่วนงานที่ต้องอ่านโฟลเดอร์บนเครื่องควรตรวจ Runtime ก่อนปิดเครื่อง: คู่มือแอปเดสก์ท็อป ระบุให้เปิดเครื่องและแอปไว้เมื่องานต้องใช้ไฟล์ในเครื่อง
ตัวอย่าง brief สำหรับเวลาไทย: “ตรวจแหล่งข่าวที่ระบุทุก 1 ชั่วโมง เริ่ม 09:00 น. เขตเวลา Asia/Bangkok (UTC+7) ส่งสรุปในแชตนี้เฉพาะเมื่อมีข้อมูลใหม่ พร้อม URL และเวลาที่ตรวจ ใช้สิทธิ์อ่านอย่างเดียว และหยุดเมื่อเข้าถึงแหล่งข่าวไม่ได้” จากนั้นตรวจตารางเวลาที่ระบบบันทึกและรอบถัดไปให้ตรงกับความตั้งใจ ตัวอย่างนี้เป็นคำสั่งตั้งต้น ไม่ใช่หลักฐานว่าสร้างหรือรันงานแล้ว
ตรวจแยกสามสถานะ: “บันทึกตารางแล้ว” ยืนยันเพียงการตั้งเวลา; “เริ่มรันแล้ว” ต้องมีเวลาหรือประวัติการรัน; “งานสำเร็จ” ต้องมีผลลัพธ์และหลักฐานที่ตรวจรับได้ หากรออนุมัติหรือเกิดข้อผิดพลาด ให้บันทึกตามจริง ไม่ใช้จำนวนรอบที่กำหนดไว้แทนงานที่สำเร็จ ดูพื้นฐาน Context, Memory และ Runtime ของ AI Agent ก่อนออกแบบงานที่ต้องต่อเนื่องหลายรอบ
03 — ทุกหนึ่งชั่วโมงให้ AI ทำอะไร? 24 งานที่นำไปออกแบบระบบได้
คำตอบไม่ได้ขึ้นอยู่กับความสามารถของโมเดลเพียงอย่างเดียว แต่ขึ้นอยู่กับว่าข้อมูลต้นทางเปลี่ยนบ่อยแค่ไหน ต้นทุนการตรวจมีเท่าไร และการกระทำใดต้องได้รับอนุมัติ การตั้งทุกชั่วโมงเหมาะกับงานที่ต้องเฝ้าดูความเปลี่ยนแปลง แต่บางงานควรใช้ Event Trigger หรือทำรายวันแทน

AI Newsroom & Content
- ตรวจหัวข้อ AI ใหม่จากรายการแหล่งที่เชื่อถือได้ — ทุก 1–3 ชั่วโมง — ส่ง Research Brief
- ตรวจข่าวซ้ำกับบทความที่เผยแพร่ — เมื่อมีข่าวใหม่ — ส่ง Duplicate Flag
- ตรวจ URL และข้อเท็จจริงที่อ้างอิง — ก่อนเข้าสู่ Draft — ส่ง Evidence Register
- ตรวจบทความเก่าที่ข้อมูลเปลี่ยน — รายวัน — ส่ง Update Suggestions
- ตรวจ SEO/AEO ของบทความใหม่ — เมื่อสร้าง Draft — ส่ง Checklist
Software & Development
- ตรวจ Issue ที่เพิ่มใหม่ — เมื่อมี GitHub Event — ส่ง Triage Summary
- ตรวจ CI/CD ที่ล้มเหลว — เมื่อ Workflow จบ — ส่ง Root-cause Candidates
- ตรวจ Pull Request ที่รอทบทวน — ทุก 2–6 ชั่วโมง — ส่ง Review Brief
- สำรวจ Dependency/Advisory — รายวัน — ส่ง Security Alert
- ตรวจงาน Release ที่ค้าง — รายวัน — ส่ง Release Readiness
Business & Sales
- ตรวจ Lead ใหม่ — เมื่อมี Event — ส่ง Lead Priority
- สรุปความคิดเห็นลูกค้าระหว่างวัน — ทุก 4–6 ชั่วโมง — ส่ง Theme Summary
- ติดตามสินค้าคงคลัง — ทุก 1 ชั่วโมงเมื่อจำเป็น — ส่ง Alert
- สรุป Conversion แคมเปญ — รายวัน — ส่ง Insights
- รวบรวมสัญญาณตลาดและคู่แข่ง — รายวัน — ส่ง Opportunity Brief
Personal Productivity
- คัดกรองอีเมลสำคัญ — เมื่อเข้ามาหรือทุก 1–3 ชั่วโมง — ส่งเฉพาะสิ่งที่ต้องตอบ
- ติดตามกำหนดส่ง — วันละ 1–2 ครั้ง — ส่ง Priority Queue
- เตรียมข้อมูลก่อนประชุม — ก่อนเริ่มตามเวลา — ส่ง Meeting Brief
- เตือนงานที่รอผู้อื่นตอบ — วันละ 1 ครั้ง — ส่ง Follow-up Draft
- สรุปความคืบหน้าของโปรเจกต์ — ทุกเย็น — ส่ง Daily Digest
Agent-to-Agent Readiness
- ตรวจคำขอจาก Agent คู่ค้า — เมื่อมี Event — ตรวจ Identity/Permission
- ตรวจข้อมูลสินค้าและราคา — เมื่อ Catalog เปลี่ยน — ส่ง Catalog Diff
- เตรียมข้อเสนอเงื่อนไข — เมื่อได้รับ Request — รออนุมัติมนุษย์
- บันทึกหลักฐานการอนุมัติ/ธุรกรรม — เมื่อเกิด Event — เก็บ Audit Log
หลักเลือกความถี่: ให้งานที่อันตรายหรือมีค่าใช้จ่ายสูงเริ่มแบบ Read-only ก่อน ใช้ Notification เฉพาะเมื่อพบความเปลี่ยนแปลง และเลี่ยงการผลิตบทความหรือสั่งซื้อใหม่ทุกชั่วโมงโดยไม่มีเหตุผล
04 — Interactive Lab: ทุกชั่วโมงคุ้มจะปลุก Agent จริงไหม?
เลือกประเภทงานและรอบตรวจ เพื่อเห็นจำนวนรอบใน 30 วัน นี่คือเครื่องคิดเลขเชิงจำลอง ไม่ได้เชื่อมบัญชีหรือรัน Agent จริง
AI ของคุณจะตื่นมาทำงานกี่รอบ?
ตรวจข่าวใหม่ แจ้งเตือนเฉพาะเหตุการณ์สำคัญ
จำนวนรอบ = 30 × 24 ÷ ชั่วโมงต่อรอบ • ไม่ใช่จำนวนผลลัพธ์สำเร็จ
05 — Game Lab: บริหารทีม Agent ตลอด 24 ชั่วโมง
เกมนี้ใช้ระบบ Hybrid Mind Game Lab ที่ติดตั้งบนเว็บไซต์และใช้ร่วมกับบทความเดิม ไม่ได้สร้าง Agent จริงหรือเปลี่ยนข้อมูลบนเว็บ ผู้เล่นลองจัดงาน Newsroom, Coding, Marketing และ Operations ให้ทำงานเป็นรอบ และเห็นผลกระทบของเครื่องหยุด โควตา การตรวจคุณภาพ และความเสี่ยง
วิธีเล่น 4 รอบ (รอบละ 24 ชั่วโมง): เลือกความถี่ให้ Agent 6 หน้าที่ ได้แก่ News Discovery, Fact Check, Article Draft, SEO/AEO, GitHub Monitor และ Business Intelligence เลือก Local หรือ Cloud Runtime และกำหนดว่าต้องให้มนุษย์อนุมัติก่อนเผยแพร่หรือไม่ จากนั้นกด ▶ เดินหน้า 24 ชั่วโมง เพื่อรับเหตุการณ์และดูผลการรันของวันนั้น ก่อนปรับกลยุทธ์ในรอบถัดไป
HYBRID MIND · REUSABLE GAME SYSTEM
AI Automation Manager — 1 Chat = 1 Job
จัดงาน AI แยก 1 แชทต่อ 1 หน้าที่ ควบคุมความถี่ Quota Runtime และ Human Approval แล้วจำลองสถานการณ์ 24 ชั่วโมงแบบกฎตายตัว
แม่แบบ: AI Newsroom · 6 งาน / 4 วัน
กำลังเตรียมเกม…
สิ่งที่เรียนรู้: แยก Scheduled Runs จาก Successful Runs ประเมินโควตา ความพร้อมของเครื่อง สิทธิ์และ Approval โดยไม่อ้างเป็นผลทดสอบจริงหรือราคาจริง
Educational simulation · กฎและภาพแสดงผลของ Hybrid Mind ไม่ใช่ผลทดลองต้นฉบับหรือการคำนวณจริงจากเกมเต็ม · ไม่เรียก LLM
Hybrid Mind original educational simulation · อ่านเอกสารประกอบ · deterministic adapter v1 · ไม่มีการเรียก Codex หรือเงินจริง
Game Lab: ตัวเลข Run, Credit และ Incident เป็นข้อมูลสมมติของเกมซึ่งใช้นโยบายจำลองเดียวกัน ไม่ใช่ผล Benchmark ของ ChatGPT, Codex หรือผลิตภัณฑ์ใด เกมใช้ Adapter automation-manager v1 และ Preset newsroom จากปลั๊กอิน Hybrid Mind Game Lab
ภารกิจประเมินผล: ลองตั้ง News Discovery ให้ตรวจบ่อยกว่า Article Draft แล้วสังเกตว่า Quota, จำนวน Scheduled Runs, Successful Runs และเหตุการณ์ผิดพลาดเปลี่ยนอย่างไร เมื่อพบวันเสี่ยง ให้ลองเปิด Human Approval แล้วพิจารณาว่าจำนวนงานที่ผ่านการตรวจน่าเชื่อถือกว่าจำนวนรันอย่างไร
06 — คำนวณความคุ้มค่า: ได้ผลลัพธ์จริง หรือแค่ปลุก AI มาทำงาน?
การรัน 720 รอบต่อเดือนไม่ได้หมายความว่ามีผลงาน 720 ชิ้น หรือมนุษย์ประหยัดเวลาได้ 720 ชั่วโมง เราต้องหักงานที่ไม่มีเหตุการณ์ให้ทำ งานที่ผิดพลาด การตรวจทาน และต้นทุนโมเดล/บริการ
สูตรที่ควรใช้กับแต่ละโครงการคือ ผลลัพธ์สุทธิ = (งานที่ตรวจผ่าน × เวลาที่มนุษย์จะทำ × มูลค่าเวลาต่อชั่วโมง) − (เวลาตรวจทุกงาน + เวลาแก้ข้อผิดพลาด) × มูลค่าเวลาต่อชั่วโมง − ต้นทุน AI ทั้งหมด โดยการคำนวณนี้เป็นการประเมินเชิงสถานการณ์ มิใช่ผลตอบแทนที่รับประกัน
ต้นทุนและผลงานใน 30 วัน
720
504
66
฿7,740
ต้นทุน AI และเวลาคนตรวจรวมในสูตรแล้ว ตัวเลขทุกช่องเป็นสมมติฐานแก้ไขได้
ตัวอย่างสำหรับอ่านค่าเริ่มต้น: สมมติ 720 รอบ/30 วัน งานผ่าน 70% เท่ากับ 504 รอบ; เวลาทำมือ 12 นาทีต่อผลงานที่ผ่าน = 100.8 ชั่วโมง; หักเวลา QA 24 ชั่วโมง และแก้ Incident 10.8 ชั่วโมง เหลือเวลาสุทธิที่อาจประหยัด 66 ชั่วโมง หากมูลค่าเวลา 150 บาท/ชั่วโมง และ AI คิดต้นทุน 3 บาทต่อรอบ ต้นทุน AI = 2,160 บาท มูลค่าสุทธิจากแบบจำลอง = 7,740 บาท ตัวเลขนี้เป็นการสมมติ ไม่ใช่ราคาแพ็กเกจหรือผลลัพธ์ของผู้ใช้จริง
07 — ความเสี่ยง: ถ้า Agent ทำผิดซ้ำทุกชั่วโมง ความเสียหายก็เกิดซ้ำได้
OWASP จัดความเสี่ยง Excessive Agency ไว้ใน OWASP Top 10 for LLM Applications 2025 หมายถึงระบบ AI ที่ได้รับสิทธิ ความสามารถ หรืออิสระมากเกินความจำเป็น จนอาจทำการที่ไม่เหมาะสมจากผลลัพธ์ผิดพลาดหรือคำสั่งแทรกแซง (Prompt Injection) [OWASP LLM06]. งาน Automation ยิ่งต้องคิดเรื่องนี้ เพราะความผิดพลาดเดียวกันอาจถูกรันซ้ำโดยไม่มีคนเฝ้า

- Permission Boundary: งานตรวจข่าวไม่ต้องมีสิทธิ์เผยแพร่หรือแก้ฐานข้อมูล
- Idempotency: ใช้รหัสงาน/รอบการรันเพื่อกันการสร้างบทความหรือส่งข้อความซ้ำ
- Human Approval: จำกัดการอนุมัติสำหรับการเผยแพร่ การใช้จ่าย การลบ และการส่งข้อความภายนอก
- Observability: เก็บ Scheduled At, Started At, Finished At, Source, Cost, Outcome, Error และ Reviewer
- Fail-closed: หากแหล่งข่าวไม่ชัด API ล้มเหลว หรือเกินงบ ให้หยุดและแจ้งเตือน ไม่ฝืนผลิตผลงาน
08 — จาก Automation สู่ A2A: โครงสร้างเศรษฐกิจ Agent ยังขาดอะไร?
เมื่อ Agent ฝั่งผู้ซื้อสามารถติดตามความต้องการและราคาได้เป็นประจำ อีกก้าวคือให้มันค้นหาและเจรจากับ Agent ฝั่งผู้ขาย แต่งานนี้ต้องมีภาษาสื่อสารระหว่าง Agent ระบบเชื่อมเครื่องมือ หลักฐานว่าใครอนุญาตให้ซื้อ และกลไกตรวจสอบธุรกรรม
| มาตรฐาน | ทำหน้าที่ | สถานะข้อกล่าวอ้าง |
|---|---|---|
| A2A | ให้ Agent ต่างระบบสื่อสารและประสานงาน | มีมาตรฐานเปิดและโครงการภายใต้ Linux Foundation |
| MCP | ให้แอป/Agent เข้าถึง Tools, Resources และ Context | เป็นโครงสร้างเชื่อมต่อ ไม่ได้เป็นระบบซื้อขายในตัว |
| AP2 | กรอบการให้สิทธิและพิสูจน์ความตั้งใจสำหรับ Agent Payments | AP2 v0.2 รองรับรูปแบบ Human Not Present โดยมีการให้สิทธิล่วงหน้า |
| UCP | ภาษากลางการพาณิชย์ Agent จากค้นหาสินค้าถึงขั้นตอนหลังซื้อ | มีประกาศและการพัฒนาแล้ว แต่การให้บริการจริงขึ้นกับร้านค้า/พื้นที่/แพลตฟอร์ม |
Google เปิดตัว AP2 วันที่ 16 กันยายน 2025 และประกาศบริจาคให้ FIDO Alliance วันที่ 28 เมษายน 2026 พร้อม AP2 v0.2 ซึ่งรองรับการชำระเงินในกรณี Human Not Present ตามคำอนุญาตล่วงหน้า ส่วน UCP เปิดตัว 11 มกราคม 2026 เพื่อสร้างกรอบการซื้อขายที่ทำงานข้ามบริการได้ [Google Cloud AP2], [AP2/FIDO], [UCP]
อย่างไรก็ตาม การมีโปรโตคอล ไม่ได้หมายความว่าทุก Agent ซื้อสินค้าได้ทุกที่โดยไม่ต้องอนุมัติ โลกจริงยังต้องแก้ปัญหา Identity, Fraud, Refund, Dispute, Merchant Integration, Scope of Authority และข้อกฎหมายของแต่ละประเทศ

Interactive Lab 03 — จากคำขอสู่ A2A Transaction
ลองจำลองการส่งงานจาก Buyer Agent ไป Seller Agent ผ่าน A2A แล้วตรวจว่ามีสิทธิ์อนุมัติหรือไม่ ระบบนี้เป็นเกมสถานการณ์สั้น ๆ ในหน้าเว็บ ไม่มีการส่งข้อมูล สั่งซื้อ หรือชำระเงินจริง
INTERACTIVE LAB 03 • A2A COMMERCE DRY RUN
Agent จะเดินหน้าธุรกรรมได้เมื่อไร?
สถานการณ์ใช้ราคาสมมติ 450 บาทเพื่อสาธิตการตรวจงบ ไม่ใช่ราคาสินค้าจริง และไม่มีการเรียก API หรือชำระเงิน
09 — Hybrid Mind Case Study: Autonomous Newsroom ที่เริ่มจากงานอ่านอย่างเดียว
สำหรับ Hybrid Mind การทำงานรายชั่วโมงไม่ควรแปลว่าเผยแพร่บทความใหม่ทุกชั่วโมง แต่ควรเป็นระบบ News Discovery → Deduplication → Evidence Check → Research Brief → Editorial Draft → SEO/AEO → Visual & Lab → QA → Human Approval → Publish ซึ่งแต่ละขั้นจะเริ่มเมื่อเงื่อนไขเหมาะสม ไม่ใช่ทั้งหมดพร้อมกัน
เริ่มจาก Agent อ่านรายการแหล่งข่าวและเช็ก URL ทุกชั่วโมง เมื่อพบประเด็นสำคัญใหม่จึงสร้าง Research Brief สำหรับทีมบรรณาธิการ หากตรวจแหล่งต้นทางไม่ได้ให้ระบุ UNKNOWN; จากนั้น Draft อาจทำตามงานคิวรายวัน ภาพและ Game Lab ถูกตรวจแยก ส่วนการเผยแพร่ต้องมีผู้อนุมัติ
| Architecture | จุดเด่น | ข้อจำกัด |
|---|---|---|
| Cloud-first / Scheduled Tasks | ไม่ต้องดูแล VPS สำหรับงานรายงานและเช็กข้อมูลจำนวนหนึ่ง | App Permissions, Limits, Vendor Dependency และส่วนที่เขียนกลับต้องตรวจ |
| Desktop/VPS-first / Codex + Cron | เชื่อม Repo และสคริปต์เดิมได้ดี ควบคุม Runtime เอง | ต้องดูแลเครื่อง ระบบสำรอง Log Secrets และ Security |
| Hybrid | ใช้บริการ Cloud ตรวจข่าว และ VPS ทำเฉพาะงานที่ต้องใช้โค้ด | ต้องมี Contract กลางกันงานซ้ำและการให้สิทธิข้ามระบบ |
นี่เป็น สถาปัตยกรรมตัวอย่าง ไม่ใช่หลักฐานว่า Hybrid Mind ติดตั้งและผ่านการทดสอบระบบข่าวอัตโนมัติครบวงจรแล้ว บทความเดิม Codex กับ 1 Chat = 1 Job อธิบายรายละเอียดการวางระบบและ Game Lab มากกว่า ส่วน บทวิเคราะห์ Context Window และ Agent ช่วยปูพื้นเรื่องบริบทและความจำ
10 — ทดลองเริ่มต้นใน 7 ขั้นตอน ไม่ต้องติดตั้งทุกอย่างพร้อมกัน
- 1. เลือกงานที่วัดผลได้: ตัวอย่าง ตรวจข่าว 5 แหล่งต่อวันหรือสรุป PR ที่ล้มเหลว
- 2. ตั้งความถี่ตามการเปลี่ยนแปลง: ชั่วโมงละครั้งเฉพาะงานที่จำเป็น; งานอื่นรายวันหรือ Event Trigger
- 3. กำหนด Output Contract: แต่ละรอบต้องส่งสถานะ PASS/FAIL/UNKNOWN, แหล่งอ้างอิง และเวลาที่ตรวจ
- 4. เริ่มแบบ Read-only: ยังไม่ให้สิทธิ์เผยแพร่ ลบ ส่งอีเมล หรือโอนเงิน
- 5. ทดสอบด้วยข้อมูลจริงขนาดเล็ก: บันทึกอย่างน้อยหลายรอบก่อนเพิ่มอิสระ
- 6. เก็บ Log และคำนวณต้นทุน: นับ Verified Outcomes, Total Cost, Failed Runs และ Human Review Time
- 7. ขยายอย่างมีเงื่อนไข: เพิ่ม Automation ใหม่ต่อเมื่อค่าใช้จ่าย ความถูกต้องและความเสี่ยงผ่านเกณฑ์
FAQ — คำถามที่คนเริ่มใช้ Agent Automation ถามบ่อย
Agent Automation คืออะไร?
คือระบบที่ทำให้ AI เริ่มทำงานตามเวลา เหตุการณ์หรือเงื่อนไข โดยใช้เครื่องมือภายในขอบเขตสิทธิและตรวจสอบผลที่เกิดขึ้น
ChatGPT ตั้งงานทุก 1 ชั่วโมงได้ไหม?
ได้สำหรับบัญชีและแพ็กเกจที่มีสิทธิ์ โดย Free รองรับการตั้งซ้ำสูงสุดวันละครั้งตามเอกสารทางการ
ถ้าโทรศัพท์หรือคอมปิด งานยังรันไหม?
ขึ้นกับ Runtime ของแต่ละบริการ งานบน Cloud อาจรันได้ ส่วนเครื่องมือ Local ต้องตรวจว่าตัวเครื่องหรือแอปจำเป็นต้องออนไลน์หรือไม่
1 Chat = 1 Job เป็นมาตรฐานอุตสาหกรรมหรือไม่?
ไม่ใช่มาตรฐานสากล เป็นแนวทางออกแบบให้ภารกิจแต่ละห้องชัดเจน ลดการปะปนของบริบท
ต้องมี VPS หรือ n8n ทุกกรณีหรือไม่?
ไม่จำเป็น งานสรุปและติดตามจำนวนมากอาจใช้ฟังก์ชันในบริการ AI สำเร็จรูปได้ แต่บางระบบต้องใช้ Workflow Engine หรือ Runtime ของตนเอง
ทุกชั่วโมงควรสั่งให้เขียนบทความหรือไม่?
ไม่ควรตั้งเช่นนั้นโดยไม่มีความเปลี่ยนแปลง ให้ตรวจข่าวและคุณภาพก่อนสร้างบทความใหม่
AI Agent Automation ทำผิดพลาดได้ไหม?
ได้ เช่น อ้างข้อมูลผิด เรียก API ซ้ำ หรือรับ Prompt Injection จำเป็นต้องมี Log, Boundaries และ Approval
คิด ROI อย่างไรจึงไม่หลอกตัวเอง?
ใช้จำนวนงานที่ตรวจผ่านจริง หักค่าบริการ เวลาตรวจ เวลาซ่อม และต้นทุนความเสียหาย ไม่ใช้จำนวนรันแทนจำนวนผลงาน
A2A กับ MCP ต่างกันอย่างไร?
A2A เน้นให้ Agent สื่อสารและร่วมงานกัน ส่วน MCP เน้นเชื่อม Host/Agent กับเครื่องมือและข้อมูล
Agent ซื้อของเองได้แล้วหรือยัง?
มีมาตรฐานและบริการเฉพาะกรณีที่รองรับการทำธุรกรรมด้วยสิทธิที่มอบล่วงหน้า แต่ไม่ใช่ความสามารถทั่วไปในทุกร้าน ทุกประเทศ ทุกแพลตฟอร์ม
จะเริ่มวันนี้ด้วยงานอะไรดี?
เลือกงาน Read-only ที่มีคุณค่าชัดเจน เช่น ตรวจข่าวใหม่ ตรวจ CI หรือรวบรวมอีเมลสำคัญ แล้วทดลองตามรอบด้วย Log และการทบทวน
บทสรุป — Stop Counting Agents. Start Counting Outcomes.
คำถามวันนี้ไม่ใช่คุณใช้ Agent ทำอะไรได้บ้าง หรือออกแบบ Harness มันอย่างไร แต่คือทุก ๆ 1 ชั่วโมง คุณตั้ง Automation ให้ AI ทำงานอะไรแทนคุณแล้วบ้าง?
ความสามารถของ Agent ยังพัฒนาต่อได้อีกมาก สิ่งที่ถึงเวลาต้องยกระดับวันนี้คือ วิธีนำมันไปใช้งาน จากการสั่งครั้งต่อครั้งไปสู่การกำหนดเป้าหมาย งานประจำ ขอบเขตสิทธิ ตัวชี้วัด และหลักฐานที่ตรวจสอบได้ การสร้าง Agent จำนวนมากไม่ใช่ผลลัพธ์ทางเศรษฐกิจ การคืนเวลาและความสามารถให้มนุษย์ต่างหากที่ควรเป็นเป้าหมาย
บทเรียนที่อยากฝาก: อย่ารอให้ AI สมบูรณ์แบบก่อนทดลอง Automation แต่จงเริ่มจากงานเล็ก ๆ ที่ควบคุมความเสี่ยงได้ แล้วเพิ่มความรับผิดชอบของระบบตามหลักฐานผลลัพธ์จริง เมื่อระบบเหล่านี้ทำงานร่วมกันได้อย่างน่าเชื่อถือ เศรษฐกิจ Agent-to-Agent จึงมีโอกาสเกิดขึ้นอย่างมีความหมาย
แหล่งข้อมูลต้นทาง (ตรวจสอบ ณ 12 ตุลาคม 2026)
- OpenAI — Scheduled Tasks in ChatGPT
- OpenAI — Introducing the Codex App (2 ก.พ. 2026)
- Anthropic — Schedule Recurring Tasks
- Google — Scheduled Actions in Gemini
- Zapier — Schedule Workflows
- n8n — Schedule Trigger
- GitHub — Scheduled Workflows
- Google Developers — A2A (9 เม.ย. 2025)
- MCP — Specification Update 2026-07-28
- Google Cloud — AP2
- Google — AP2 v0.2 / FIDO Alliance (28 เม.ย. 2026)
- Google — UCP (11 ม.ค. 2026)
- OWASP — Excessive Agency
- OpenClaw — Introducing OpenClaw (29 ม.ค. 2026)
Editorial Disclosure: FACT = ข้อเท็จจริงจากแหล่งต้นทาง; ANALYSIS = การวิเคราะห์ของ Hybrid Mind; SIMULATION = ผลคำนวณจากสมมติฐานที่ผู้อ่านแก้ไขได้; FUTURE SCENARIO = ภาพอนาคตที่ยังไม่ใช่ข้อเท็จจริง การแสดง Interactive Lab และ Game Lab ไม่ใช่หลักฐานการทดสอบการทำงานของผลิตภัณฑ์ AI จริง
ใส่ความเห็น