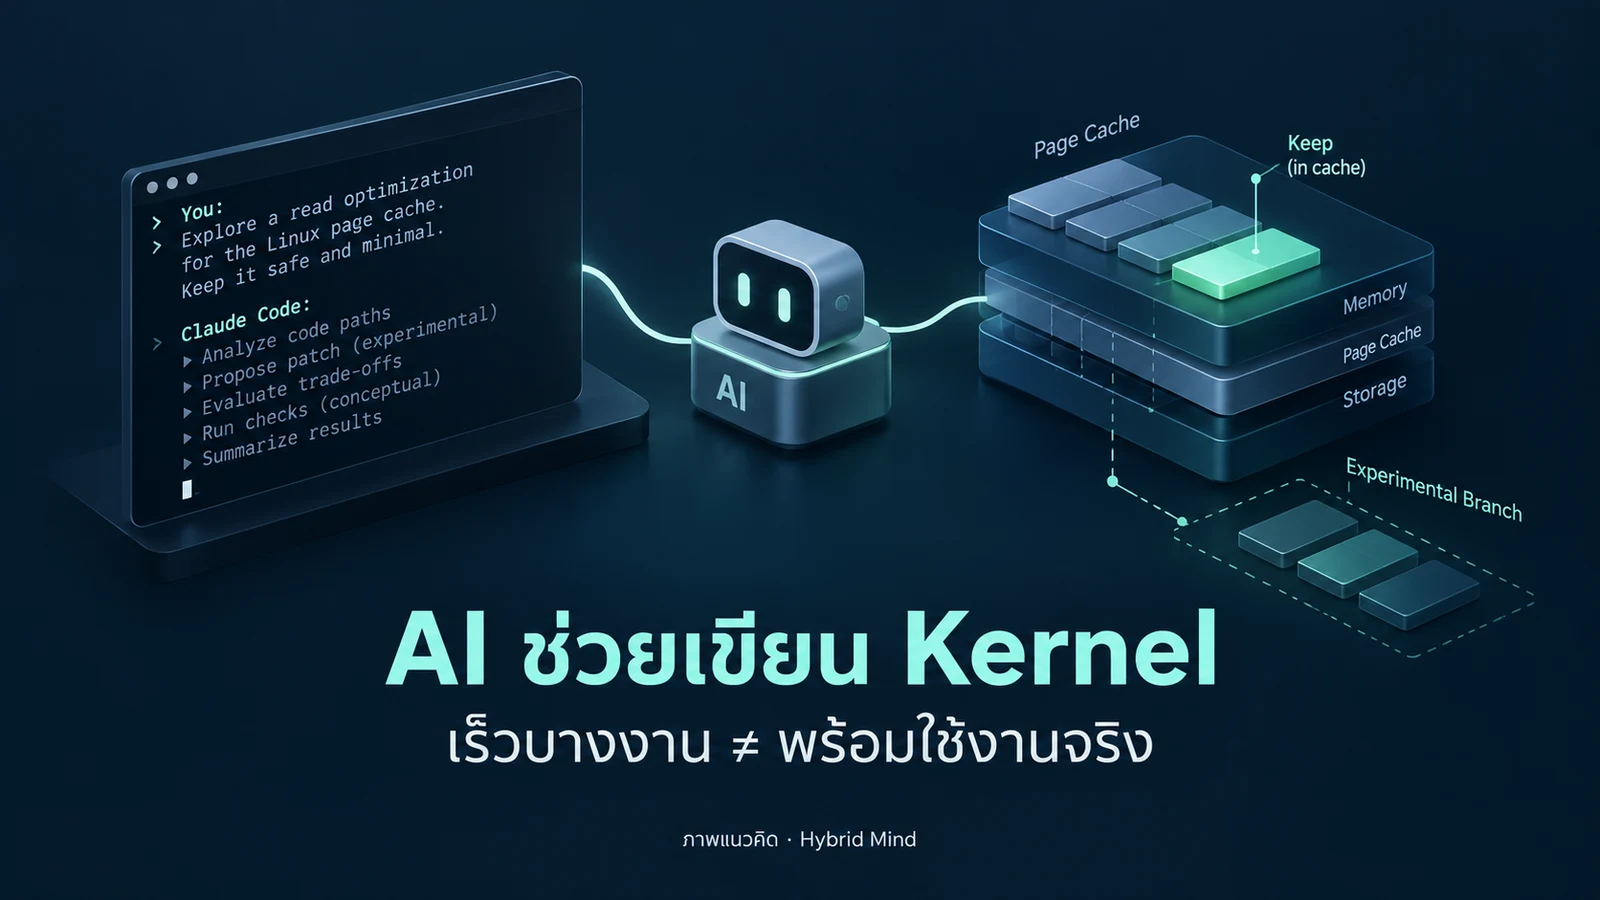
HYBRID MIND · INTERACTIVE EXPLAINER · LEVEL 2
Linus ใช้ Claude Code ช่วยแก้คอขวด Linux
แต่โค้ดยังเป็นงานทดลอง
อ่านไฟล์จาก cache โดยไม่แย่งแก้ตัวนับอ้างอิงทุกครั้ง ฟังดูเป็นชัยชนะด้านความเร็ว—จนเปลี่ยน workload แล้วพบทั้งต้นทุนที่เพิ่มและหน่วยความจำที่รอคืน

Quick Answer
Linus Torvalds เปิดเผยในข้อความประกอบ branch noref-filemap-read-with-llm ว่า Claude Code ช่วยทำโค้ด โปรแกรมทดสอบ การทบทวน และร่างข้อความ ภายใต้การกำกับของเขา ผลวัดเป็นของเครื่องเขาเอง ไม่ใช่การยืนยันอิสระ
สิ่งที่ทดลองคือให้หน่วยความจำของ page cache รอ RCU grace period ก่อนนำกลับมาใช้ใหม่ เพื่อให้เส้นทางอ่านบางกรณีไม่ต้องเพิ่ม–ลด folio reference ทุกครั้ง ผลที่รายงานดีขึ้นในงานบางแบบ แต่แย่ลงเมื่อ buffer เกิด page fault และยังมีปัญหา allocator กับการทดสอบที่ขาดอยู่ [ต้นฉบับ]
ขอบเขตข่าว: รายงานเผยแพร่ 12 ตุลาคม 2026 ตามเวลา UTC แต่ commit ของชุดทดลองอยู่ช่วง 7–10 ตุลาคม ไม่ใช่การเปิดตัว Linux รุ่นใหม่ ตรวจต้นฉบับและโค้ดแบบอ่านอย่างเดียวเมื่อ 12 ตุลาคม 2026 เวลา 07:29:43 UTC
ข่าวคือการใช้ผู้ช่วย ไม่ใช่การมอบ Kernel ให้ Agent
คำเปิดเผยของผู้เขียนครอบคลุมงานหลายช่วง แต่มีคำสำคัญคือ อยู่ภายใต้การกำกับ และวัดผลบนเครื่องของเขา เราจึงพูดได้ว่า Agent มีบทบาทในกระบวนการทดลอง ไม่ใช่สรุปว่า AI ตัดสินใจรวมโค้ดเข้า Linux ได้เอง หรือผลงานผ่านการตรวจรับจากชุมชนแล้ว รุ่นโมเดลที่ใช้ก็ไม่ได้ระบุไว้ในต้นฉบับนี้ [Tools]

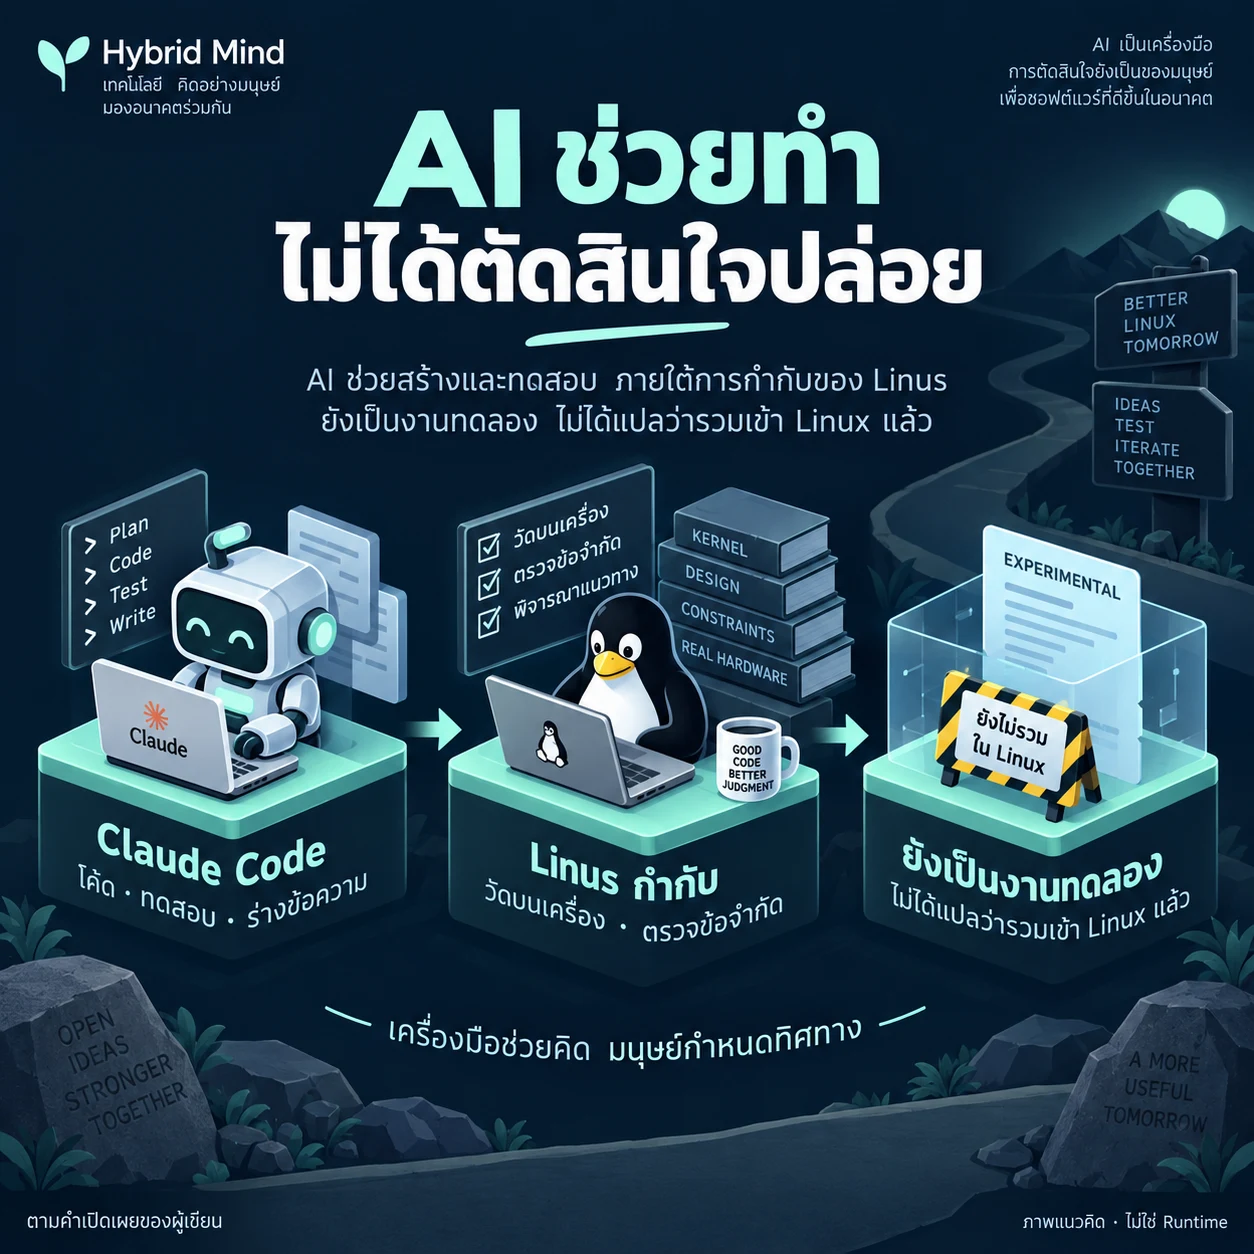
สำหรับทีมที่ใช้ coding agent นี่เป็นกรณีศึกษาเรื่องการเก็บหลักฐาน: ระบุว่าใครทำส่วนไหน แยกผลวัดจากข้อเสนอ และเปิดเผยสิ่งที่ยังไม่รู้ การตีความนี้เป็นบทวิเคราะห์ของ Hybrid Mind ไม่ใช่ผลทดลองว่าทีมใดจะทำงานเร็วขึ้นเท่าไร
คอขวด: หลายเธรดอ่านข้อมูลเดียวกัน แต่ต้องเขียนตัวนับร่วมกัน
Page cache คือข้อมูลไฟล์ที่ kernel เก็บในหน่วยความจำ ส่วน folio เป็นกลุ่มหน้าหน่วยความจำที่ kernel จัดการร่วมกัน เส้นทางเดิมที่ข้อความนี้กล่าวถึงเพิ่ม reference ก่อนอ่านและลดหลังอ่าน เมื่อหลายเธรดอ่านไฟล์เดียวกันซ้ำ ๆ การแก้ตัวนับที่ใช้ร่วมกันอาจทำให้ cache line ของ CPU ต้องวิ่งระหว่างแกน แม้ข้อมูลที่ต้องการอ่านจะอยู่ใน cache แล้วก็ตาม [Problem]
ทางเดิม
ยึด reference → อ่าน → ปล่อย reference มีค่าใช้จ่ายของตัวนับร่วมกันในกรณีที่แข่งขันกันมาก
แนวคิดที่ทดลอง
แยกการเอา folio ออกจาก cache ออกจากการคืนหน่วยความจำจริง เพื่อให้ผู้อ่านใน RCU ใช้ข้อมูลได้โดยไม่ยึด reference แบบเดิม
สิ่งที่แลกมา
หน่วยความจำที่รอ grace period ยังคืนให้ allocator ไม่ได้ การอ่านบางเงื่อนไขต้องกลับไปเส้นทางเดิม
RCU เป็นแนวคิดที่มีอยู่แล้ว ไม่ใช่สิ่งที่ Agent เพิ่งประดิษฐ์: การเอาวัตถุออกจากโครงสร้างที่ผู้อ่านค้นหาได้กับการคืนพื้นที่เป็นคนละช่วง grace period รองรับการจบของผู้อ่านเดิมที่เกี่ยวข้อง ไม่ใช่เวลาพักคงที่และไม่ได้หมายความว่าทุกการอ่านต้องหยุดรอ [เอกสาร RCU]


ใน diff ที่ตรวจจริง fast path ใช้ rcu_read_lock() และปิด page fault ชั่วคราวระหว่าง copy เมื่อข้อมูลหาย ยังไม่พร้อมอ่าน หรือมีเหตุที่ต้องใช้ทางเดิม งานอ่านส่วนที่เหลือกลับไปเส้นทางเดิมได้ ความคุ้มครองจึงอาศัยการออกแบบ lifetime ทั้งชุด ไม่ใช่ใส่ RCU lock แล้วหน่วยความจำทุกแบบจะปลอดภัยเอง [Patch 5]
Hybrid Mind Video Lab: แผนที่ของเงื่อนไข
เลือกองค์ประกอบเพื่ออ่านว่าแต่ละส่วนรับผิดชอบอะไร ฉากจาก Visual Studio เป็นแผนที่ 2.5D เชิงอธิบาย ไม่ใช่ mesh 3D หรือการรัน Linux จริง
RCU Page-cache: อ่าน กับ คืนพื้นที่
แผนที่2.5Dเชิงแนวคิดของ branchทดลอง ไม่ใช่Runtimeหรือหลักฐานรับรองความปลอดภัย;เลือกโหนดเพื่อดูเงื่อนไข
ผู้อ่าน RCU
อ่าน cached page เมื่อเงื่อนไข fast path ครบ โดยไม่เพิ่ม–ลด reference แบบเดิมตาม patchที่เสนอ
ไม่ใช่ทุกreadใช้fastpath;ความคุ้มครองอาศัยlifetime designทั้งชุด
อ่านข้อมูลทั้งหมดแบบข้อความ
- ผู้อ่าน RCU — อ่าน cached page เมื่อเงื่อนไข fast path ครบ โดยไม่เพิ่ม–ลด reference แบบเดิมตาม patchที่เสนอ ตรวจรับ: ไม่ใช่ทุกreadใช้fastpath;ความคุ้มครองอาศัยlifetime designทั้งชุด
- Cache page — ข้อมูลใน page cache ต้องพร้อมอ่านตามเงื่อนไขที่ตรวจใน diff;หลายเธรดอ่านไฟล์เดียวกันอาจแข่งขันบน refcount ในทางเดิม ตรวจรับ: ข้อมูลไม่พร้อมหรือหายเป็นเหตุใช้ทางเดิม ไม่ใช่รอแล้วสำเร็จเสมอ
- เอาออก ≠ คืน — เอา folio ออกจาก mapping แล้วชะลอ final free;ผู้อ่านเดิมที่คุ้มครองยังใช้ bytes ได้โดยพื้นที่ไม่ถูก reuse ตรวจรับ: รับประกันที่เสนอคือmemoryไม่reuse ไม่ใช่refcountอยู่เหนือศูนย์
- Grace period — เมื่อผู้อ่านเดิมที่เกี่ยวข้องจบและ grace period ครบ พื้นที่เข้าเงื่อนไขคืนได้;คิวจริงยังมีข้อจำกัด ตรวจรับ: ไม่มีเวลารอคงที่ และ allocator visibility/CMAยังเป็นปัญหาที่ผู้เขียนระบุ
- ทางอ่านเดิม — fastcopyหยุดเมื่อข้อมูลหรือbufferไม่พร้อม งานที่เหลือกลับทางเดิม;กรณีuserpagefaultที่รายงานมีต้นทุนเพิ่ม ตรวจรับ: แบบจำลองไม่ได้รันLinuxและไม่พิสูจน์ว่าpatchพร้อมproduction
แผนที่ไม่ได้หมายความว่าทุกคำขออ่านจะเดินผ่านทุกโหนด การ fallback เป็นเส้นทางตามเงื่อนไข ไม่ใช่หลักฐานว่าปัญหาทั้งหมดถูกแก้แล้ว
3D Lab: ข้อมูลออกจาก Cache แล้ว ใครยังใช้พื้นที่ได้?
สลับเหตุการณ์แล้วสังเกตชั้น mapping หน่วยความจำ และการคืนพื้นที่ เลือกชั้นเพื่ออ่านคำอธิบาย ฉากมีมิติด้วย CSS perspective และเปลี่ยนความสัมพันธ์จริงในแบบจำลอง แต่ไม่ใช่ Runtime หรือการพิสูจน์ memory ordering ของ patch
อ่านในช่วง RCU
ยังค้นพบหน้าใน Cache
คงข้อมูลไว้ระหว่างอ่าน
ยังไม่ใช่การคืนพื้นที่
ค้นข้อมูลใน Cache → อ่านภายใต้ RCU → หน่วยความจำไม่ถูกนำไปใช้ใหม่ระหว่างผู้อ่านที่คุ้มครอง
ผู้อ่าน
การอ่านแบบนี้ใช้ได้เมื่อเงื่อนไข fast path ครบ ไม่ใช่การรับประกันว่าทุกคำขอจะใช้เส้นทางนี้
การ “คืนได้” หมายถึงเข้าเงื่อนไข reclamation ในแบบจำลอง ไม่รับรองว่าจะคืนทันที ไม่ตั้งตัวจับเวลา และไม่จำลองข้อยกเว้นทั้งหมดของ kernel · ที่มา
Visual Interactive: เปลี่ยน workload แล้วข้อสรุปเปลี่ยน
นี่คือข้อมูล ผู้เขียนรายงาน ใน cover letter ฉบับเดียวกัน ไม่ใช่ผลทดสอบที่ Hybrid Mind รันเอง เลือกกรณีแล้วดูต้นทุนต่อการอ่าน ภาพแท่งใช้ค่าสูงสุดของช่วงที่รายงานเป็นความยาว ไม่ใช่ค่าเฉลี่ยที่วัดได้
16 bytes · 8 เธรดอ่านไฟล์เดียวกัน
หน่วย: kernel cycles ต่อ read · ค่าน้อย = ต้นทุน kernel ต่อ read ต่ำกว่าในกรณีนั้น
ต้นทุนลดลงในงานอ่าน Cache เดียวกันหลายเธรด ไม่ใช่ความเร็วรวมของ Linux
เครื่อง i7-8565U, 4 cores / 8 threads, ext4, mitigations ปิด และ CONFIG_HARDENED_USERCOPY ปิด ผู้เขียนระบุว่าเครื่องลดความถี่จากอุณหภูมิ จึงให้เปรียบเทียบต้นทุนต่อ read ไม่ใช่ยอด reads/s ตัวเลขข้ามกรณีมีขนาด read และเงื่อนไขต่างกัน อย่าใช้จัดอันดับแบบเดียวกันทั้งหมด [Numbers]


เลขคนละ revision อย่านำมาผสม
ข้อความใน patch ก่อนหน้ามีบางค่าต่างจาก cover letter ฉบับล่าสุด บทความและ Interactive นี้ใช้ค่าใน commit 4c0f3697118e ชุดเดียว ไม่มีการเฉลี่ยข้ามรุ่นหรือแปลง cycles เป็นเวลาและต้นทุนเงิน
คอขวดที่ลดได้ ไม่ได้ลบความเสี่ยงของหน่วยความจำ
ข้อแลกเปลี่ยนหลักคือพื้นที่ที่รอ grace period ยังไม่กลับไปยัง allocator ผู้เขียนระบุว่าการทำให้คิวสั้นลงยังไม่ได้ทำให้ allocator มองเห็นหน้าที่รอคืน และยังมี regression ของ CMA รวมถึงกรณี grace period ช้าที่ไม่จำกัดขนาดคิว นอกจากนี้ต้นทุนงานที่อยู่นอกเส้นทางอ่านยังไม่ถูกวัดครบ [Known problems]
| ประเภทหลักฐาน | สิ่งที่บอกได้ | สิ่งที่ยังบอกไม่ได้ |
|---|---|---|
| โค้ดที่อ่านจริง | มี fast path RCU และเส้นทาง fallback ใน patch | อ่านโค้ดไม่เท่ากับพิสูจน์ race และทุกสถาปัตยกรรม |
| ผลวัดของผู้เขียน | ต้นทุน kernel/read เปลี่ยนตาม workload บนเครื่องและ config ที่ระบุ | ประสิทธิภาพทั่วระบบ หรือผลบนเครื่องอื่น |
| การตรวจอิสระ | ยังไม่มีผลทดสอบอิสระแบบเงื่อนไขตรงกันที่นำมาใช้ในบทความนี้ | ไม่ควรสร้างข้ออ้างว่าชุมชนยืนยันแล้ว |
ผู้เขียนรายงานการตรวจ byte ในชุดทดสอบเฉพาะ แต่บอกด้วยว่ายังไม่ได้ตรวจ xfstests, KASAN, lockdep, 32-bit, hardened usercopy และเครื่องอื่น การไม่พบ bad read ในการทดสอบที่จำกัดจึงไม่ใช่ใบรับรองความปลอดภัยของชุด patch ทั้งระบบ การควบคุมเชิงลบบางส่วนยังเป็นผลจาก build ก่อนหน้า [Testing]
สถานะที่ตรวจได้: fast path ชุดนี้มีใน branch ทดลอง แต่ไม่พบในไฟล์ mm/filemap.c ของ master ที่ตรึงไว้ที่ 24a19b953e2a ณ การตรวจครั้งนี้ ข้อความนี้จำกัดอยู่ที่ source snapshot ดังกล่าว ไม่ทำนายว่าจะรวมใน release ใด [master ที่ตรวจ]
ผลต่อผู้อ่านและสิ่งที่ควรจับตา
- นักพัฒนา: ดู memory lifetime และ fallback พร้อม benchmark ไม่ตัดสินจากกรณีที่เร็วเพียงกรณีเดียว
- ผู้ใช้และธุรกิจ: ยังไม่มีหลักฐานจากข่าวนี้ว่าควรเปลี่ยน kernel production หรือลดข้อกำหนดความปลอดภัยตาม config ของเครื่องทดสอบ
- ติดตามต่อ: การมองเห็นหน้าที่รอคืนของ allocator, CMA, ทดสอบภายใต้ memory pressure/สถาปัตยกรรมอื่น และ review จากผู้ดูแลส่วนที่เกี่ยวข้อง
- มุม AI governance: disclosure นี้ไม่ได้ระบุการจัดการข้อมูลหรือเงื่อนไขบริการทั้งหมดของเครื่องมือ จึงไม่ควรอนุมานว่าปลอดภัยสำหรับโค้ดส่วนตัวทุกองค์กร
สรุป: ประเด็นน่าสนใจไม่ใช่ “AI เขียน Linux จบแล้ว” แต่คือคนใช้ผู้ช่วยลองเปลี่ยนความสัมพันธ์ระหว่างการอ่านกับการคืนหน่วยความจำ แล้วเผยทั้งผลดี ผลเสีย และพื้นที่ที่ต้องตรวจต่อ
FAQ
นี่คือ Linux ที่ใช้ AI ดูแลแทนคนหรือไม่?
ไม่ใช่ข้อสรุปที่หลักฐานรองรับ ต้นฉบับบอกว่า Claude Code ทำงานช่วยภายใต้การกำกับของ Linus ไม่ได้ระบุว่า Agent มีสิทธิ์รวมโค้ดหรือปล่อย kernel เอง
Linux เร็วขึ้นหลายเท่าทุกงานแล้วหรือ?
ไม่ใช่ ตัวเลขเป็น workload เฉพาะบนเครื่องเดียว บางกรณีต้นทุน kernel/read ลดลง แต่กรณี buffer ต้อง page fault ต้นทุนเพิ่มขึ้น และต้นทุนส่วนอื่นยังไม่วัดครบ
RCU หมายความว่าต้องรอทุก read หรือไม่?
ไม่ใช่ การรอเกี่ยวกับ reclamation ของหน่วยความจำที่ถูกเอาออกและผู้อ่านเดิมที่เกี่ยวข้อง ไม่ใช่หน่วงทุก read ด้วยเวลาคงที่ fast path เองก็มีเงื่อนไขและ fallback
Lab นี้ทดสอบ patch จริงหรือไม่?
ไม่ทดสอบ ไม่ build kernel ไม่สั่ง Agent และไม่เขียนระบบภายนอก 3D Lab เป็นแบบจำลอง lifetime ส่วนกราฟเป็นการแสดงค่าที่ผู้เขียนรายงานโดยแยกเงื่อนไขชัดเจน
ใส่ความเห็น