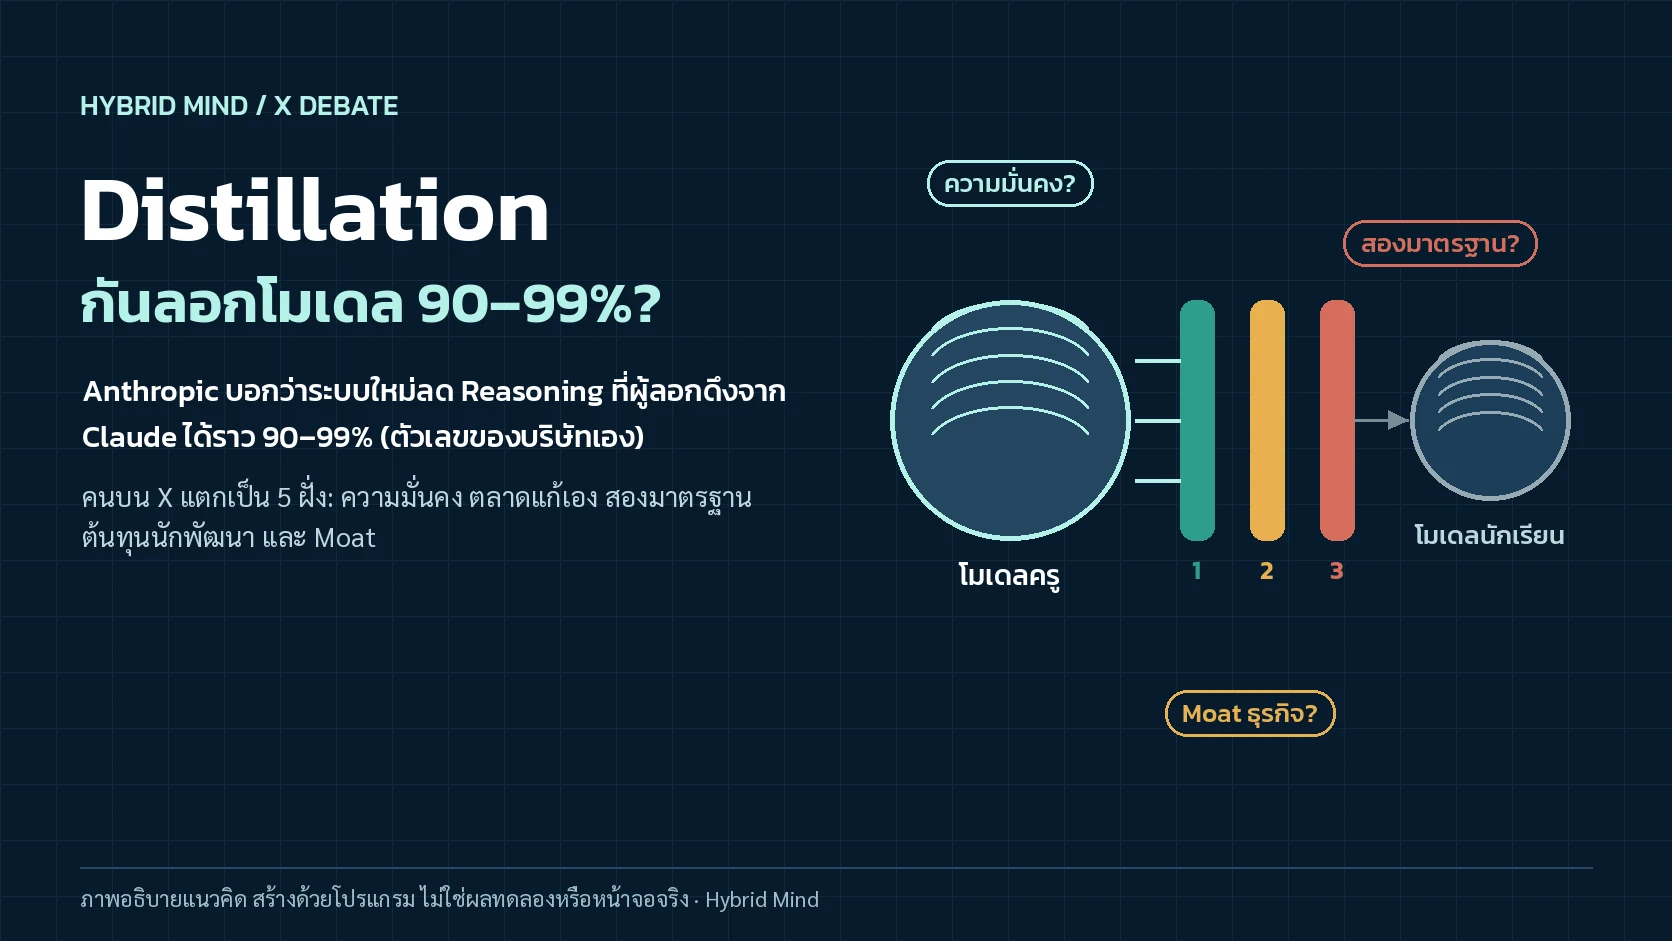
Anthropic บอกว่ากันการ “ลอก Claude” ได้ 90–99% แล้วทำไมคนบน X ถึงเถียงกัน?
คำตอบสั้น: เมื่อ 12 ต.ค. 2026 Anthropic เผยแพร่บทความ Strengthening our defenses against distillation attacks ระบุว่ามาตรการใหม่ทำให้ข้อมูลที่ผู้ทำ “Distillation Attack” ดึงออกไปจาก Claude ลดลง ราว 90–99% ตัวเลขนี้เป็นการประเมินของบริษัทเอง วัดเฉพาะบนแพลตฟอร์มของตัวเอง และยังไม่มีหน่วยงานอิสระมาตรวจซ้ำ บริษัทยอมรับเองด้วยว่ายังไม่เจอความพยายามหลบเลี่ยงที่ซับซ้อนและต่อเนื่องจริงจัง
ประเด็นที่ X เถียงกัน: โพสต์ของ Anthropic บน X มีผู้เห็นกว่า 7.7 แสนครั้ง และถูกโควตเกือบ 280 ครั้งในวันแรก คนแตกเป็นราว 5 ฝั่ง (1) นี่คือเรื่องความมั่นคงและความปลอดภัย (2) ภาคเอกชนแก้เองได้ ไม่ต้องให้รัฐออกกฎคุมโมเดลเปิด ซึ่งเป็นมุมของ David Sacks (3) มาตรฐานสองชั้น เพราะบริษัท AI เองก็เคยเอาหนังสือและเว็บของคนอื่นไปเทรน (4) นักพัฒนาที่ใช้งานปกติต้องแบกต้นทุนด้วย และ (5) ที่จริงเรื่องนี้คือการสร้าง “คูเมือง” ทางธุรกิจ ซึ่งจะกระทบโมเดล Open-weight
สิ่งที่ตรวจได้: กลไกที่ Anthropic อธิบาย เช่น Preserved Thinking ที่บังคับใช้กับบัญชี API ที่สร้างตั้งแต่ 31 ส.ค. 2026 ยืนยันได้จากเอกสารนักพัฒนา ส่วนคดี Bartz v. Anthropic ที่ฝั่ง “สองมาตรฐาน” ยกมาอ้าง มีจริง แต่ศาลแยกการเทรนจากหนังสือที่ซื้อมาซึ่งถือเป็น fair use ออกจากการเก็บหนังสือละเมิดลิขสิทธิ์ซึ่งไม่ใช่ fair use ข้อกล่าวหาต่อ Zhipu และ Moonshot เป็นคำกล่าวของ Anthropic ที่ยังไม่มีการตรวจสอบอิสระ

Distillation คืออะไร และทำไมรอบนี้ Anthropic ถึงเรียกว่า “การโจมตี”
Distillation (การกลั่นโมเดล) คือการเอาคำตอบของโมเดลใหญ่ ซึ่งเปรียบเป็น “ครู” ไปใช้สอนโมเดลที่เล็กกว่า ซึ่งเปรียบเป็น “นักเรียน” ให้ทำตาม เทคนิคนี้เป็นเรื่องปกติในวงการ รายงานของ Anthropic เมื่อ ก.พ. 2026 ก็เขียนไว้เองว่าแล็บใหญ่กลั่นโมเดลของตัวเองให้เล็กและถูกลงเป็นประจำ
สิ่งที่ Anthropic เรียกว่า Distillation Attack คือการทำแบบนั้นอย่างลับ ๆ ในระดับอุตสาหกรรม โดยเจ้าของโมเดลไม่ได้อนุญาต ซึ่งมักทำผ่านเครือข่ายบัญชีปลอม บริษัทบอกว่าสิ่งที่ผู้ลอกอยากได้มากที่สุดไม่ใช่คำตอบสุดท้าย แต่เป็น Reasoning หรือกระบวนการคิดที่ Claude เขียนออกมาก่อนตอบ เพราะช่วยให้โมเดลนักเรียนเรียนรู้ได้ว่าครูคิดอย่างไรจนได้คำตอบนั้น
80.4% เทียบกับ 71.8%
Anthropic ทดสอบโดยเอาบทสนทนาของ Claude Opus 4.8 ไปเทรนโมเดล Claude ที่ผ่านแค่ขั้น Pretrain แล้ววัดผลด้วย SWE-bench Verified ถ้าเทรนจาก Reasoning ฉบับเต็มได้ 80.4% แต่ถ้าเทรนจาก Reasoning ฉบับสรุปได้ 71.8%
ตัดเหลือแค่สรุปก็ยังเรียนได้มาก
ส่วนต่างอยู่ที่ราว 8.6 จุด มีโพสต์ภาษาจีนที่ชี้ว่าแค่สรุปก็พอให้นักเรียนเรียนรู้ได้มากแล้ว สิ่งที่ Anthropic พยายามปกป้องจึงเป็นส่วนต่างช่วงท้ายนี้ ผลนี้เป็นการทดลองภายในของบริษัท ไม่ใช่งานวิจัยที่มีคนอื่นทำซ้ำ
ขโมย “ความสามารถ” ไม่ใช่ขโมยข้อมูลส่วนตัว
หลายโพสต์ที่อธิบายเรื่องนี้ย้ำว่า Distillation Attack คือการดึงความสามารถของโมเดลไปใช้ ไม่ได้หมายความว่าข้อมูลหรือแชตของผู้ใช้ Claude ทั่วไปรั่วออกไป

ไทม์ไลน์: จากรายงานเดือน ก.พ. ถึงโพสต์ที่ถูกถกวันนี้
- Anthropic เผยแพร่ Detecting and preventing distillation attacks กล่าวหาว่า DeepSeek, Moonshot และ MiniMax สร้างบทสนทนากับ Claude รวมกว่า 16 ล้านครั้ง ผ่านบัญชีปลอมราว 24,000 บัญชี
- มีจดหมายเปิดผนึก Open Weights and American AI Leadership ขอให้รัฐบาลสหรัฐฯ อย่าเพิ่งจำกัดโมเดล Open-weight Jensen Huang ใช้โพสต์แรกในชีวิตบน X แชร์จดหมายนี้ ตามรายงานของ State of AI จากนั้นรายชื่อผู้ลงนามเพิ่มจาก 25 เป็น 50 องค์กร โดยไม่มี Anthropic
- เป็นวันเริ่มนับ “บัญชีใหม่” ของ Preserved Thinking บัญชี API ที่สร้างตั้งแต่วันนี้จะถูกตรวจทันที ถ้าแก้บริบทก่อนหน้า Thinking block แล้วส่งกลับไป จะโดนปฏิเสธ
- Anthropic ออกรายงานอีกฉบับ เล่าว่าคำขอที่ส่งถึงโมเดล Kimi ของ Moonshot ถูกส่งต่อมายัง Claude อย่างลับ ๆ ในจำนวนนั้นมีคำขอจากผู้ใช้ที่บริษัทเชื่อว่าเกี่ยวข้องกับกองทัพปลดแอกประชาชนจีน (PLA) ขอให้วิเคราะห์ภาพกล้องวงจรปิดของบุคคลหนึ่ง
- Anthropic กลับมาเก็บเงินค่าคำขอที่ระบบป้องกันบล็อกไว้ก่อนที่ Claude จะตอบ เฉพาะในหมวดที่บริษัทบอกว่าบล็อกพลาดต่ำกว่า 0.1% ซึ่งรวมหมวด Distillation ด้วย
- Anthropic เผยแพร่บทความเรื่องการป้องกัน และ โพสต์บน X เวลา 06:58 น. ตามเวลาไทย บทความระบุชื่อ Zhipu ว่ากลั่นความสามารถด้าน Cyber ของโมเดลสหรัฐฯ ระหว่างพัฒนา GLM-5.3 Reuters รายงานว่า Z.ai (Zhipu) ยังไม่ได้ตอบคำขอความเห็น
- David Sacks โพสต์แสดงความยินดี และบอกว่านี่พิสูจน์สิ่งที่เขาเคยพูดไว้ คือบริษัทต้องแก้ปัญหานี้เอง ไม่ต้องให้รัฐออกกฎคุมโมเดลเปิด หลังจากนั้นบทสนทนาก็แตกออกเป็นหลายฝั่ง

มาตรการ 3 ชั้นที่ Anthropic อธิบาย
คุมว่า Reasoning ไปไหนได้บ้าง
ใช้ Preserved Thinking กับ Claude Fable 5.1 และ Opus 5.5 บัญชี API ใหม่จะแก้บริบทก่อนหน้า Thinking block ไม่ได้ ห้ามโมเดลรุ่นเก่าที่ป้องกันอ่อนกว่ามาอ่าน Reasoning ของรุ่นใหม่ และตั้งแต่ Sonnet 5.5 เป็นต้นไป Reasoning จะใช้ได้เฉพาะในองค์กรที่ส่งคำขอนั้นเท่านั้น
Classifier สองขั้น
สร้างตามแนวงาน Constitutional Classifiers ผ่านการทดสอบเจาะระบบ (Red-team) ทั้งจากทีมในและทีมนอก บริษัทอ้างว่าแข็งแรง “พอ ๆ กับ” ระบบที่กันไม่ให้ Claude ช่วยสร้างอาวุธชีวภาพ และบล็อกพลาดต่ำกว่า 0.1%
ทำให้การลองซ้ำมีราคา
บัญชีที่พยายามดึง Reasoning ซ้ำ ๆ จะโดนลดโควตา ถ้ายังทำต่อจะถูกแบน บริษัทบอกว่าแบนไปแล้วหลายหมื่นบัญชี หลายบัญชีถูกแบนภายในไม่ถึง 2 ชั่วโมงหลังเริ่มดึงข้อมูล และคำขอที่ถูกบล็อกก็ยังต้องจ่ายเงิน

คนบน X พูดเรื่องนี้มากแค่ไหน
เรานับจำนวนโพสต์ผ่าน X Counts ด้วยคำค้นที่มีคำว่า distillation, distill, distillers, distilled หรือ distilling คู่กับ Anthropic, Claude, Zhipu, GLM-5.3, Kimi หรือ Moonshot ช่วง 12 ต.ค. 22:00 UTC ถึง 13 ต.ค. 06:54 UTC (ตรงกับ 05:00–13:54 น. วันที่ 13 ต.ค. เวลาไทย) ตัวเลขนี้บอกแค่ปริมาณ ไม่ได้บอกว่าคนส่วนใหญ่คิดอย่างไร และคำค้นนี้ไม่นับโพสต์ที่พูดเรื่องเดียวกันด้วยคำอื่น เช่นโพสต์ภาษาจีนที่ใช้คำว่า 蒸馏
* ช่วง 13:00 น. นับถึง 13:54 น. เท่านั้น จึงไม่เต็มชั่วโมง เวลาในกราฟเป็นเวลาไทย ตัวเลขเป็นการนับของ Hybrid Mind เอง ไม่ใช่สัดส่วนความเห็น
ถ้ามองย้อนไปทั้งสัปดาห์ด้วยคำค้นที่แคบกว่า คือ Anthropic หรือ Claude คู่กับ distillation หรือ distill โดยไม่นับรีโพสต์ วันที่ 7–12 ต.ค. ตามเวลา UTC มีวันละ 30–66 โพสต์ แต่เฉพาะช่วงไม่ถึง 7 ชั่วโมงแรกของวันที่ 13 ต.ค. (UTC) ก็มีถึง 290 โพสต์ แปลว่าเป็นกระแสที่เพิ่งพุ่งขึ้นจากบทความวันที่ 12 ต.ค. จริง ไม่ใช่เรื่องที่ค้างมาจากสัปดาห์ก่อน
ข้อจำกัดของตัวเลข: โพสต์ต้นทางของ Anthropic มีรีโพสต์ 311 ครั้ง และ Sacks มีคนกดถูกใจ 1,588 ครั้ง ซึ่งมากกว่ายอด Counts ของคำค้นข้างบน เพราะ Counts นับเฉพาะโพสต์ที่มีคำค้นอยู่ในข้อความ ตัวเลขทั้งสองชุดวัดคนละอย่าง อย่านำมารวมกัน
5 ฝั่งบน X: กันลอกโมเดลคือความปลอดภัย การแข่งขัน หรือมาตรฐานสองชั้น
การแบ่งฝั่งด้านล่างเป็นการจัดกลุ่มของ Hybrid Mind จากโพสต์ที่เราอ่าน ไม่ใช่สัดส่วนความเห็นของคนทั้งแพลตฟอร์ม หลายคนอยู่ได้มากกว่าหนึ่งฝั่ง ข้อความที่ยกมาแปลหรือสรุปจากต้นฉบับ ทุกโพสต์มีลิงก์ให้อ่านเอง สำหรับบัญชีขนาดเล็ก เราสรุปความเห็นโดยไม่ระบุชื่อบัญชี

“นี่คือเรื่องความมั่นคง ไม่ใช่แค่ธุรกิจ”
ตัวอย่าง: Anthropic เอง, @Hesamation, @AnatoliKopadze, @DreamTGn และผู้ใช้อีกจำนวนมากที่โพสต์สรุปข่าวพร้อมแสดงความเห็นด้วย
- ในบทความ Anthropic ให้เหตุผลหลักสองข้อ ข้อแรก โมเดลที่ได้จากการลอกมักปล่อยออกมาโดยไม่มีระบบป้องกันที่แข็งแรงเท่าต้นฉบับ จึงอาจถูกใช้ก่ออันตรายด้านชีวภาพและไซเบอร์ ข้อสอง บริษัทที่ลอกนำความสามารถไปใช้กับระบบทหาร ข่าวกรอง และการสอดแนม
- @Hesamation ซึ่งมีผู้ติดตามราว 9 หมื่นคน หยิบรายละเอียดที่คนแชร์ต่อมากที่สุดมาเล่า คือกรณีที่ผู้ใช้ซึ่ง Anthropic สงสัยว่าเกี่ยวข้องกับกองทัพจีน ขอให้ Kimi ช่วยตามตัวบุคคลจากกล้องวงจรปิด แต่คำขอนั้นถูกส่งต่อมาให้ Claude ประมวลผลแทน (โพสต์)
- @AnatoliKopadze เน้นขนาดของปฏิบัติการ เช่น บัญชีปลอมหลายแสนบัญชี ข้อมูลบัตรที่ขโมยมา และเครือข่ายเดียวที่คุมบัญชีกว่า 2 หมื่นบัญชีพร้อมกัน (โพสต์)
- บางคนในฝั่งนี้แยกประเด็นชัดเจน @DreamTGn เขียนว่า “Distillation เองไม่ใช่ปัญหา มันคือวิธีที่ AI ดีขึ้นและถูกลง” ปัญหาอยู่ที่การลอกความสามารถระดับแนวหน้าโดยไม่ลงทุนด้านความปลอดภัยเท่ากัน (โพสต์) ส่วนบัญชีขนาดเล็กรายหนึ่งสรุปว่าเส้นแบ่งคือ “การยินยอม” (โพสต์)
“บริษัทแก้เองได้ ไม่ต้องวิ่งไปหารัฐ”
ตัวอย่าง: @DavidSacks, @HackingLZ, @joemccann
- David Sacks ซึ่งมีผู้ติดตามราว 1.77 ล้านคน แสดงความยินดีกับ Anthropic และบอกว่านี่ตรงกับที่เขาพูดไว้ใน All-In ตอนที่ 282 ว่า Anthropic อยู่ในตำแหน่งที่ดีที่สุดที่จะหยุดการลอกโมเดลของตัวเอง ไม่ใช่รัฐบาล เขาเล่าว่าตอนนั้นมีแรงผลักดันในวอชิงตันให้จำกัดโมเดลเปิดด้วยเหตุผลเรื่องทรัพย์สินทางปัญญา และสรุปว่า “ไม่ใช่ทุกปัญหาทางเทคนิคที่ต้องวิ่งไปหาวอชิงตันเพื่อขอกฎใหม่” (โพสต์)
- @HackingLZ โพสต์สั้น ๆ ว่า “Turns out we didn’t need the government to get involved” (โพสต์) ส่วน @joemccann ตอบ Sacks ทำนองเดียวกันว่าภาคเอกชนป้องกันตัวเองได้โดยไม่ต้องพึ่งรัฐ (โพสต์)
- เสียงแย้งในฝั่งเดียวกัน: บัญชีภาษาจีนรายหนึ่งเห็นด้วยว่าผู้ให้บริการควรลงมือก่อน แต่ชี้ว่าต้องรู้ก่อนว่า 90–99% วัดจากอะไร เช่นวัดจากทราฟฟิกที่ตรวจพบ หรือจากข้อมูลที่ดึงได้จริง และควรมีการทดสอบซ้ำโดยอิสระ ช่องทางอุทธรณ์ และขอบเขตที่ชัดเจน (โพสต์)
“มาตรฐานสองชั้น: พวกคุณก็กลั่นมนุษย์มาก่อน”
ตัวอย่าง: @superalesha และบัญชีอีกหลายรายที่โควตโพสต์ของ Anthropic ทั้งภาษาอังกฤษ จีน โปรตุเกส และฝรั่งเศส
- โพสต์ที่ได้ไลก์สูงในฝั่งนี้คือของ @superalesha (282 ไลก์ ตอนที่เราดึงข้อมูล) เขียนว่า “You distilled HUMANITY” คุณเทรนจากความรู้ของพวกเรา สแกนหนังสือหลายล้านเล่มแล้วทิ้งเล่มจริง สร้างธุรกิจจากงานที่คนใช้ทั้งชีวิตสร้าง แล้วเก็บเงินเรา แต่พอมีคนใช้ผลงานของคุณไปสร้างคู่แข่ง กลับรับไม่ได้ (โพสต์)
- หลายโพสต์อ้างถึงเงินยอมความ 1.5 พันล้านดอลลาร์ในคดีหนังสือละเมิดลิขสิทธิ์ (ตัวอย่าง, ตัวอย่าง) บางโพสต์บอกตรง ๆ ว่าการปกป้องธุรกิจทำได้ แต่การ “แต่งการแข่งขันทางการค้าให้ดูเป็นเรื่องความปลอดภัย” ไม่ใช่เรื่องที่ควรทำ
- ความเห็นที่แยกแยะกว่า: ในฝั่งเดียวกันก็มีคนยอมรับว่าสองกรณี “ไม่เหมือนกันในทางกฎหมาย” (โพสต์แรกข้างต้น) ผู้ใช้อีกรายสรุปคำตัดสินไว้ถูกต้องว่า การเทรนจากหนังสือที่ซื้อมาเป็น fair use แต่การเก็บสำเนาละเมิดลิขสิทธิ์ไม่ใช่ แล้วสรุปเองว่า “การดึงข้อมูลโดยไม่ได้รับอนุญาตก็คือการดึงโดยไม่ได้รับอนุญาต” (โพสต์) ทดลอง 02 ด้านล่างช่วยแยกชั้นของคำถามนี้
“คนใช้งานปกติต้องจ่ายราคาด้วย”
ตัวอย่าง: @MatthewParrott, นักพัฒนาที่อ่านเอกสาร API และผู้ใช้ที่สงสัยว่าบัญชีโดนแบนเพราะถูกตรวจจับผิด
- @MatthewParrott อ้างว่าทำแบบนี้แล้ว “Claude พังสำหรับงานปกติจำนวนมาก” ถ้าพิมพ์คำว่า reason หรือ reasoning ในบางบริบทจะเจอ error ชื่อ [reasoning_distillation] จนเซสชันเสีย (โพสต์) ยังไม่ยืนยัน: เราไม่พบเอกสารทางการที่พูดถึง error ชื่อนี้ และ Hybrid Mind ไม่ได้ทดลองซ้ำ
- นักพัฒนาอีกรายสรุปจากเอกสาร Preserved Thinking ว่าเทสต์ด้วยคีย์ของตัวเองอาจผ่าน แต่ผู้ใช้ที่สร้างบัญชีใหม่หลัง 31 ส.ค. จะเจอ 400 (โพสต์) ข้อนี้ ตรงกับเอกสารทางการ อีกโพสต์สรุปว่า “Anti-distillation กลายเป็นข้อจำกัดของ Harness แล้ว” (โพสต์) ใน GitHub ของ pydantic-ai ก็มี issue #7984 ที่รายงานว่า Fable 5.1 ปฏิเสธ Thinking block เมื่อ instructions หรือชุดเครื่องมือเปลี่ยน
- บัญชีภาษาจีนรายหนึ่งตั้งข้อสังเกตกับผู้ติดตามว่าบัญชีที่เคยโดนแบนอาจโดนเพราะถูกตรวจจับผิด (โพสต์) ส่วนอีกคนแซวว่าให้เอาทรัพยากรที่ประหยัดได้ไปเพิ่ม Usage limit (โพสต์) ข้อนี้เป็นความเห็น ไม่ใช่ข้อมูล
- Anthropic เขียนในบทความเองว่ายังทำตามเป้าที่ตั้งไว้เมื่อ ก.พ. ไม่ได้ทั้งหมด คือเป้าที่จะไม่กระทบผู้ใช้ที่ถูกต้อง บางคนต้องแก้โค้ดที่เชื่อมต่อ Classifier บล็อกคำขอปกติพลาดได้ในไม่ถึง 0.1% ของกรณี และคำขอที่ถูกบล็อกนั้นก็ยังถูกเก็บเงิน
“ความปลอดภัยคือพาดหัว แต่เนื้อในคือคูเมืองทางธุรกิจ”
ตัวอย่าง: @AYi_AInotes, @sleepy0x13 และนักพัฒนาสาย Open-weight อีกหลายราย
- @AYi_AInotes ซึ่งมีผู้ติดตามราว 7 หมื่นคน เขียนเป็นภาษาจีนว่า Anthropic ยอมเสียรายได้หลายล้านล้าน Token เพื่อปิดช่องทางนี้ ไม่ใช่แค่การประชาสัมพันธ์เรื่องความปลอดภัย แต่เป็นการสกัดผู้ไล่ตามที่อาศัยการลอก เขาประเมินว่าทีมที่ไม่มีความสามารถ Pretrain ของตัวเองจะถูกเปิดโปง และโมเดลเปิดขนาดเล็กจะไล่ตามช้าลง (โพสต์)
- @sleepy0x13 มองต่างว่า API Agreement ของบริษัทอเมริกันรายเดียวไม่ควรเป็นกฎที่กำหนดว่า AI ทั้งโลกจะเรียนรู้อย่างไร และชี้ว่าในสหรัฐฯ เองผลประโยชน์ก็แตกกัน เพราะผู้ขายชิป ผู้ให้บริการคลาวด์ และสตาร์ทอัพต่างอยากได้โมเดลราคาถูก (โพสต์) เขาอ้างว่า Washington Post รายงานว่าบริษัทอเมริกันบางแห่งใช้โมเดลจีนอยู่ ยังไม่ยืนยัน: Hybrid Mind ไม่ได้ตรวจรายงานนั้น
- ความเห็นสั้น ๆ ที่เจอบ่อย เช่น “คูเมืองไม่ใช่ Weights แล้ว แต่คือ Chain-of-thought” (โพสต์) “ถ้ากันได้จริง ช่องว่างระหว่างแล็บชั้นนำกับที่เหลือจะกว้างขึ้น” (โพสต์) และ “พาดหัวคือความปลอดภัย แต่เนื้อในคือคูเมือง” (โพสต์) บางคนบอกตรง ๆ ว่าถ้า Anthropic ไม่ปล่อยโมเดลเปิดเอง ก็สนับสนุนให้คนอื่นลอก (โพสต์)
ทดลอง 01 — ถ้าคุณคุมระบบกันลอกโมเดล ชั้นไหนช่วยได้มากที่สุด และใครโดนลูกหลง
การจำลองเชิงการศึกษาแบบกำหนดสูตรล่วงหน้า ค่าทุกตัวเป็นค่าสมมติที่ Hybrid Mind ตั้งขึ้นเพื่ออธิบายแนวคิด ไม่ใช่ตัวเลขของ Anthropic และไม่ใช่ผลวัดจริง ใช้ดูว่าแต่ละชั้นทำงานร่วมกันแบบคูณกันอย่างไร และทำไมความเข้มงวดถึงแลกมากับการบล็อกผู้ใช้ปกติ
ชั้น 1: Reasoning ที่ผู้ใช้ภายนอกเข้าถึงได้
ชั้น 2: Classifier ตรวจคำขอที่พยายามดึง Reasoning
เลือกค่าด้านบนเพื่อดูผล
สูตรสมมติ: ข้อมูลที่หลุด = ค่าการเปิดเผย × (1 − อัตราที่ Classifier จับได้) × ตัวคูณเวลาก่อนแบน ทุกค่าเป็นตัวเลขอธิบายแนวคิด ช่วง 90–99% ที่แสดงเป็นตัวเลขที่ Anthropic ประเมินจากแพลตฟอร์มของตัวเอง ไม่ใช่ผลจากสูตรนี้
ฝั่ง “มาตรฐานสองชั้น” กับฝั่ง “ความมั่นคง” มักเถียงกันไม่จบ เพราะต่างคนต่างตอบคนละคำถาม คำถามแรกคือกฎหมายลิขสิทธิ์ว่าอย่างไร คำถามที่สองคือผิดข้อตกลงการใช้บริการหรือไม่ คำถามที่สามคือในทางจริยธรรมยุติธรรมไหม ภาพด้านล่างและทดลอง 02 แยกสามชั้นนี้ออกจากกัน

ทดลอง 02 — แยกชั้นคำถาม: กรณีไหนเป็นเรื่องกฎหมาย ข้อตกลง หรือจริยธรรม
ตัวอย่างการจัดหมวดเพื่อการศึกษา สถานะด้านกฎหมายอ้างอิงเฉพาะคดีและเอกสารที่ลิงก์ไว้ในบทความ ไม่ใช่คำแนะนำทางกฎหมาย และใช้ไม่ได้กับทุกประเทศ เลือกกรณีเพื่อดูว่าแต่ละชั้นมีสถานะอย่างไร และฝั่งไหนบน X ใช้กรณีนั้นเป็นข้อโต้แย้ง
เลือกกรณีเพื่อดูผล
หลักฐานสนับสนุนอะไร และอะไรที่ยังพิสูจน์ไม่ได้
ยืนยันได้จากเอกสารต้นทาง
- Anthropic เผยแพร่บทความเรื่องการป้องกันเมื่อ 12 ต.ค. 2026 และระบุตัวเลข 90–99% กับ “10 ถึง 100 เท่า” ไว้จริง
- Preserved Thinking มีอยู่จริงในเอกสาร API บังคับใช้กับบัญชีที่สร้างตั้งแต่ 31 ส.ค. 2026 00:00 UTC บน Fable 5.1, Opus 5.5, Sonnet 5.5 และ Haiku 5.5 ถ้าแก้บริบทก่อนหน้าแล้วส่ง Thinking block กลับไป จะได้ 400 เว้นแต่เลือกโหมด drop_block
- เอกสารระบุว่าผู้ที่ใช้ Claude Code, claude.ai, Claude Managed Agents หรือ Claude Agent SDK ไม่ต้องเปลี่ยนอะไร
- รายงานเมื่อ ก.พ. 2026 ระบุชื่อ DeepSeek, Moonshot และ MiniMax ว่าสร้างบทสนทนากว่า 16 ล้านครั้ง ผ่านบัญชีราว 24,000 บัญชี
- คดี Bartz v. Anthropic: คำสั่งของผู้พิพากษา Alsup เมื่อ 23 มิ.ย. 2025 ชี้ว่าการเทรนจากหนังสือที่ได้มาโดยชอบเป็น fair use แต่การเก็บสำเนาละเมิดลิขสิทธิ์ในคลังไม่ใช่ ศาลอนุมัติการยอมความ 1.5 พันล้านดอลลาร์ขั้นสุดท้ายเมื่อ 20 ก.ค. 2026 ราว 3,000 ดอลลาร์ต่อผลงาน
- จดหมาย Open-weight ลงวันที่ 24 ก.ค. 2026 มีผู้ลงนาม 50 องค์กรตามรายงานหลายแหล่ง และไม่มีชื่อ Anthropic
ยังไม่มีการตรวจสอบอิสระ หรือยังไม่มีข้อมูล
- ตัวเลข 90–99% เป็นการประเมินของ Anthropic เอง วัดเฉพาะบนแพลตฟอร์มของบริษัท ไม่ได้รวมทราฟฟิกที่ผ่านคลาวด์อื่นหรือผู้ให้บริการ Inference รายอื่น ซึ่งบทความก็ยอมรับว่าผู้ลอกใช้ช่องทางเหล่านั้นด้วย
- บริษัทเขียนเองว่า “ยังไม่รู้ว่าผลจะอยู่ได้นานแค่ไหน” และยังไม่เจอความพยายามหลบเลี่ยงที่ซับซ้อนและต่อเนื่อง
- การที่ Zhipu กลั่นความสามารถ Cyber ระหว่างพัฒนา GLM-5.3 และกรณี Kimi ส่งต่อคำขอมาให้ Claude เป็นข้อกล่าวหาของ Anthropic Reuters รายงานว่า Z.ai ไม่ได้ตอบทันที และเราไม่พบคำชี้แจงจากบริษัทที่ถูกกล่าวหา
- ข้อมูลที่หลุดน้อยลงไม่ได้แปลว่าโมเดลคู่แข่งจะแย่ลงเท่ากัน บทความไม่ได้วัดผลกระทบต่อโมเดลปลายทาง
- อัตราบล็อกพลาด “ต่ำกว่า 0.1%” เป็นตัวเลขของบริษัท และยังไม่มีข้อมูลสาธารณะว่าผู้ใช้ที่ถูกบล็อกพลาดเสียเงินไปเท่าไร
- ข้ออ้างบน X เช่น error ชื่อ [reasoning_distillation] เมื่อพิมพ์คำว่า reasoning หรือบัญชีที่ถูกแบนเพราะตรวจจับผิด ยังไม่มีหลักฐานที่เราตรวจได้

| ข้อความที่เจอบน X | สถานะ | หมายเหตุ |
|---|---|---|
| “Anthropic ลดการลอกได้ 99%” | ถูกบางส่วน | บริษัทบอกว่า “ราว 90–99%” และเป็นค่าประเมินบนแพลตฟอร์มของตัวเอง ไม่ใช่ 99% เสมอ |
| “Anthropic ใช้หนังสือละเมิดลิขสิทธิ์เทรน Claude” | ต้องระวัง | ศาลชี้ว่าการดาวน์โหลดและเก็บหนังสือละเมิดลิขสิทธิ์ไม่ใช่ fair use แต่ตามเอกสารของศาลและ Authors Guild Anthropic แถลงว่าชุดข้อมูล LibGen และ PiLiMi ไม่ได้อยู่ในชุดเทรนของโมเดลเชิงพาณิชย์ที่ปล่อยออกมา |
| “ระบบกันลอกแข็งแรงเท่าระบบกันอาวุธชีวภาพ” | คำกล่าวของบริษัท | บทความเขียนว่า “roughly as robust” ซึ่งเป็นการประเมินภายในจาก Red-team ไม่ใช่มาตรฐานภายนอก |
| “OpenAI, Anthropic, Google รวมตัวเป็นพันธมิตรต่อต้าน Distillation” | ไม่พบหลักฐาน | บทความ 12 ต.ค. เรียกร้องให้นักพัฒนาและแพลตฟอร์มทุกรายร่วมมือ แต่ไม่ได้ประกาศพันธมิตรใด |
| “นักพัฒนาต้องแก้โค้ด” | ยืนยัน | เฉพาะบัญชีใหม่และ Harness ที่แก้ประวัติบทสนทนา ตามเอกสาร Preserved Thinking และ issue ของ pydantic-ai |
ใช้ข่าวนี้อย่างไร: แยกตามกลุ่มผู้อ่าน
นักพัฒนาที่เรียก Claude API เอง
- ถ้าโค้ดแก้ system prompt ทุกเทิร์น เช่นใส่วันที่ เพิ่มหรือลดเครื่องมือกลางเซสชัน หรือสรุปเทิร์นเก่าเองฝั่ง client ให้เปลี่ยนไปใช้วิธีแบบต่อท้ายอย่างเดียว (Append-only) ตามเอกสาร
- คีย์เก่าของคุณอาจไม่เห็นปัญหา แต่ผู้ใช้ที่มีบัญชีใหม่จะเห็น ให้ส่ง beta header thinking-binding-controls-2026-08-01 แล้วดู input_transformations
- ใช้ drop_block เป็นทางออกชั่วคราวเท่านั้น เพราะเอกสารระบุว่า Output token อาจเพิ่มได้ถึง 67.1% ถ้าทิ้งทุกเทิร์นที่ระดับ max effort
ทีมที่ใช้โมเดล Open-weight
- ข่าวนี้ไม่ได้ทำให้โมเดลที่คุณดาวน์โหลดมาแล้วใช้ไม่ได้ แต่ควรประเมินระบบป้องกันของโมเดลเอง โดยเฉพาะงานด้าน Cyber
- เก็บที่มาของโมเดลและผลทดสอบ (Model card, Eval) ไว้ เผื่อลูกค้าหรือผู้ตรวจถามถึงที่มา
- อย่าใช้ “ข่าวว่าโมเดลนี้ลอกมา” แทนผลทดสอบจริงในการตัดสินใจ
ผู้อ่านทั่วไปและคนทำนโยบาย
- เวลาเห็นตัวเลขอย่าง “ลด 99%” ให้ถามว่าใครวัด วัดอะไร และวัดบนช่องทางไหน
- แยกให้ออกว่ากำลังถกเรื่องกฎหมาย เรื่องข้อตกลงการใช้บริการ หรือเรื่องความยุติธรรม เพราะคำตอบของแต่ละข้ออาจไม่เหมือนกัน
- ข้อกล่าวหาข้ามประเทศควรรอฟังคำชี้แจงของบริษัทที่ถูกกล่าวหาด้วย

Brief สำหรับ Coding Agent: ตรวจ Integration ก่อนผู้ใช้เจอ 400
ทดลอง 03 — แอปของคุณจะโดน 400 จาก Preserved Thinking ไหม
ตัวช่วยตรวจแบบจำลองตามเอกสาร Preserved Thinking ฉบับที่เราอ่านเมื่อ 13 ต.ค. 2026 ผลที่ได้เป็นการคาดการณ์ตามกฎในเอกสาร ไม่ใช่การเรียก API จริง Hybrid Mind ไม่ได้ทดลองกับบัญชีจริง และกฎอาจเปลี่ยนเมื่อมีโมเดลใหม่
บัญชี API สร้างเมื่อไร
ใครสร้าง request
ตั้งค่า prefix_mismatch_behavior
ระหว่างเทิร์นในบทสนทนาเดียวกัน โค้ดของคุณ…
เลือกค่าด้านบนเพื่อดูผล
ตัวเลขต้นทุนของ drop_block มาจากเอกสาร ซึ่งทดสอบบน Multi-turn coding benchmark ของ Anthropic เอง ทิ้งครั้งเดียวต่อเซสชันเพิ่ม 2.5% / 3.9% / 4.5% / 20.1% ทิ้งทุกเทิร์นเพิ่ม 4.6% / 9.7% / 10.3% / 67.1% ที่ระดับ low / medium / high / max ผลจริงขึ้นกับ Harness ของคุณ
อ่านต่อบน Hybrid Mind
- Claude Constitution: X ถก AI ที่ปฏิเสธได้ ปลอดภัยกว่าหรืออันตรายกว่า? เป็นอีกครั้งที่ David Sacks กับ Anthropic อยู่กลางวงถกบน X
- Anthropic AI Worm: X ถกโมเดลเล็กก๊อปตัวเองบนกล่องทีวี ภัยจริงหรือขายความกลัว? ข้อถก “ความปลอดภัย หรือขายความกลัว” ที่มีรูปแบบคล้ายกัน และใช้ GLM-5.2 ในการทดลอง
- AO3 Fanfic Scrape: X ถกนักเขียนเพิ่งเจองานใน AI Dataset ฝั่ง “การยินยอม” ของการเอาข้อมูลไปเทรน มองจากมุมนักเขียน
- บูม AI สหรัฐฯ จะจบที่ทุนหาย?: X ถกคำเตือน Jefferies ฉากหลังเรื่องโมเดลจีนราคาถูกที่กดดันแล็บสหรัฐฯ
- Data Poisoning: 250 เอกสารฝัง Backdoor ใน AI ได้อย่างไร? อีกด้านหนึ่งของความปลอดภัยข้อมูลเทรน
- สหรัฐฯ กลับลำเรื่องตรวจ AI ก่อนเปิดตัว? เจาะ UK AISI บริบทนโยบายของสหรัฐฯ เรื่องการทดสอบโมเดล
คำถามที่พบบ่อย
1. Distillation ผิดกฎหมายไหม?
ยังไม่มีคำตอบเดียว ตัวเทคนิคเป็นเรื่องปกติในวงการ แล็บใหญ่ก็กลั่นโมเดลของตัวเอง สิ่งที่ Anthropic กล่าวหาคือการทำโดยไม่ได้รับอนุญาตผ่านบัญชีปลอม ซึ่งผิดข้อตกลงการใช้บริการของบริษัท ส่วนจะผิดกฎหมายลิขสิทธิ์หรือกฎหมายอื่นหรือไม่ ยังไม่มีคำพิพากษาที่เราพบสำหรับกรณีนี้
2. ตัวเลข 90–99% เชื่อได้แค่ไหน?
เป็นการประเมินของ Anthropic เอง วัดจากจำนวน Reasoning token ที่ผู้ลอกดึงได้บนแพลตฟอร์มของบริษัท ยังไม่มีการตรวจซ้ำโดยอิสระ และไม่รวมช่องทางอื่น บริษัทเองก็เขียนว่ายังไม่รู้ว่าผลจะอยู่ได้นานแค่ไหน
3. ข้อกล่าวหา “มาตรฐานสองชั้น” ฟังขึ้นไหม?
ฟังขึ้นในทางจริยธรรมสำหรับหลายคน แต่ในทางกฎหมายเป็นคนละเรื่อง ในคดี Bartz ศาลชี้ว่าการเทรนจากหนังสือที่ซื้อมาเป็น fair use ส่วนการเก็บหนังสือละเมิดลิขสิทธิ์ไม่ใช่ จึงนำไปสู่การยอมความ 1.5 พันล้านดอลลาร์ ขณะที่กรณี Distillation เป็นเรื่องข้อตกลงการใช้บริการและบัญชีปลอม ทดลอง 02 แยกสามชั้นนี้ให้ดู
4. ผู้ใช้ Claude ทั่วไปได้รับผลกระทบไหม?
ส่วนใหญ่ไม่ได้รับผลกระทบ ตามเอกสาร ผู้ใช้ claude.ai, Claude Code, Managed Agents และ Agent SDK ไม่ต้องเปลี่ยนอะไร กลุ่มที่ได้รับผลกระทบคือนักพัฒนาที่สร้าง request เองบนบัญชีใหม่และแก้ประวัติบทสนทนา รวมถึงคำขอส่วนน้อยที่ Classifier บล็อกพลาด ซึ่งบริษัทบอกว่าต่ำกว่า 0.1% และยังถูกเก็บเงิน
5. โมเดลจีนหรือโมเดล Open-weight จะแย่ลงไหม?
ยังพิสูจน์ไม่ได้ บทความวัดแค่ข้อมูลที่หลุดออกไป ไม่ได้วัดคุณภาพของโมเดลปลายทาง ความเห็นบน X แตกเป็นสองทาง ทางหนึ่งเชื่อว่าการไล่ตามจะช้าลง อีกทางเชื่อว่าแล็บเหล่านั้นจะพัฒนาเองได้ หรือหาช่องทางอื่น
6. Zhipu หรือ Moonshot ตอบข้อกล่าวหาแล้วหรือยัง?
ยังไม่พบ ณ เวลาที่ตรวจ Reuters รายงานว่า Z.ai (Zhipu) ไม่ได้ตอบคำขอความเห็นทันที และเราไม่พบคำชี้แจงทางการจาก Moonshot เกี่ยวกับบทความ 12 ต.ค.
เอกสารอ้างอิงและขอบเขตการตรวจ
- Anthropic — Strengthening our defenses against distillation attacks (12 ต.ค. 2026)
- Anthropic — Detecting and preventing distillation attacks (23 ก.พ. 2026)
- Claude Docs — Preserved thinking
- Claude Docs — Troubleshooting thinking
- Claude Help Center — Preserved thinking: changing how the Messages API handles thinking blocks
- pydantic-ai issue #7984 — Fable 5.1 rejects replayed thinking blocks
- Reuters ผ่าน The Economic Times — Anthropic says new safeguards sharply reduce AI distillation attacks
- Bartz v. Anthropic — Order on Fair Use (N.D. Cal., 23 มิ.ย. 2025)
- Authors Guild — Court Grants Final Approval of $1.5 Billion Anthropic Copyright Settlement
- Open Weights and American AI Leadership (รายชื่อผู้ลงนาม)
- State of AI — 25 Tech Giants Just Signed a Letter Defending Open AI
- Ground Truth — The open-weights letter doubled to 50 signatories
- โพสต์ต้นทางบน X: @AnthropicAI, @DavidSacks, @Techmeme
ขอบเขตการตรวจ: Hybrid Mind ดึงโพสต์ผ่าน X API ทั้งหมด 262 โพสต์ (ไม่ซ้ำกัน) ในจำนวนนี้ 195 โพสต์เกี่ยวกับเรื่องนี้โดยตรง ช่วงเวลาคือ 12 ต.ค. 2026 12:00 UTC ถึง 13 ต.ค. 2026 06:54 UTC (ตรงกับ 19:00 น. วันที่ 12 ต.ค. ถึง 13:54 น. วันที่ 13 ต.ค. เวลาไทย) แหล่งที่ดึงมี โควตและการตอบกลับโพสต์ของ @AnthropicAI และ @DavidSacks และผลค้นหาด้วยคำค้นเรื่องความมั่นคง สองมาตรฐาน ผลกระทบต่อนักพัฒนา และโมเดลเปิด ตัวอย่างนี้ไม่ใช่ตัวแทนความเห็นของผู้ใช้ X ทั้งหมด เพราะผลค้นหาแบบ relevancy ให้น้ำหนักโพสต์ที่มี engagement สูง และเราอ่านโพสต์ภาษาจีนได้เพียงบางส่วน
เราอ่านบทความต้นทางของ Anthropic เอกสาร Preserved Thinking และเอกสารศาลในคดี Bartz ฉบับเต็มหรือบางส่วนที่เกี่ยวข้อง แต่ Hybrid Mind ไม่ได้ทดลองเรียก API จริง ไม่ได้ตรวจกราฟข้อมูลดิบของ Anthropic และไม่ได้ตรวจข้อกล่าวหาต่อ Zhipu, Moonshot, DeepSeek หรือ MiniMax โดยอิสระ ตัวเลขในทดลอง 01 เป็นค่าสมมติทั้งหมด
ใส่ความเห็น