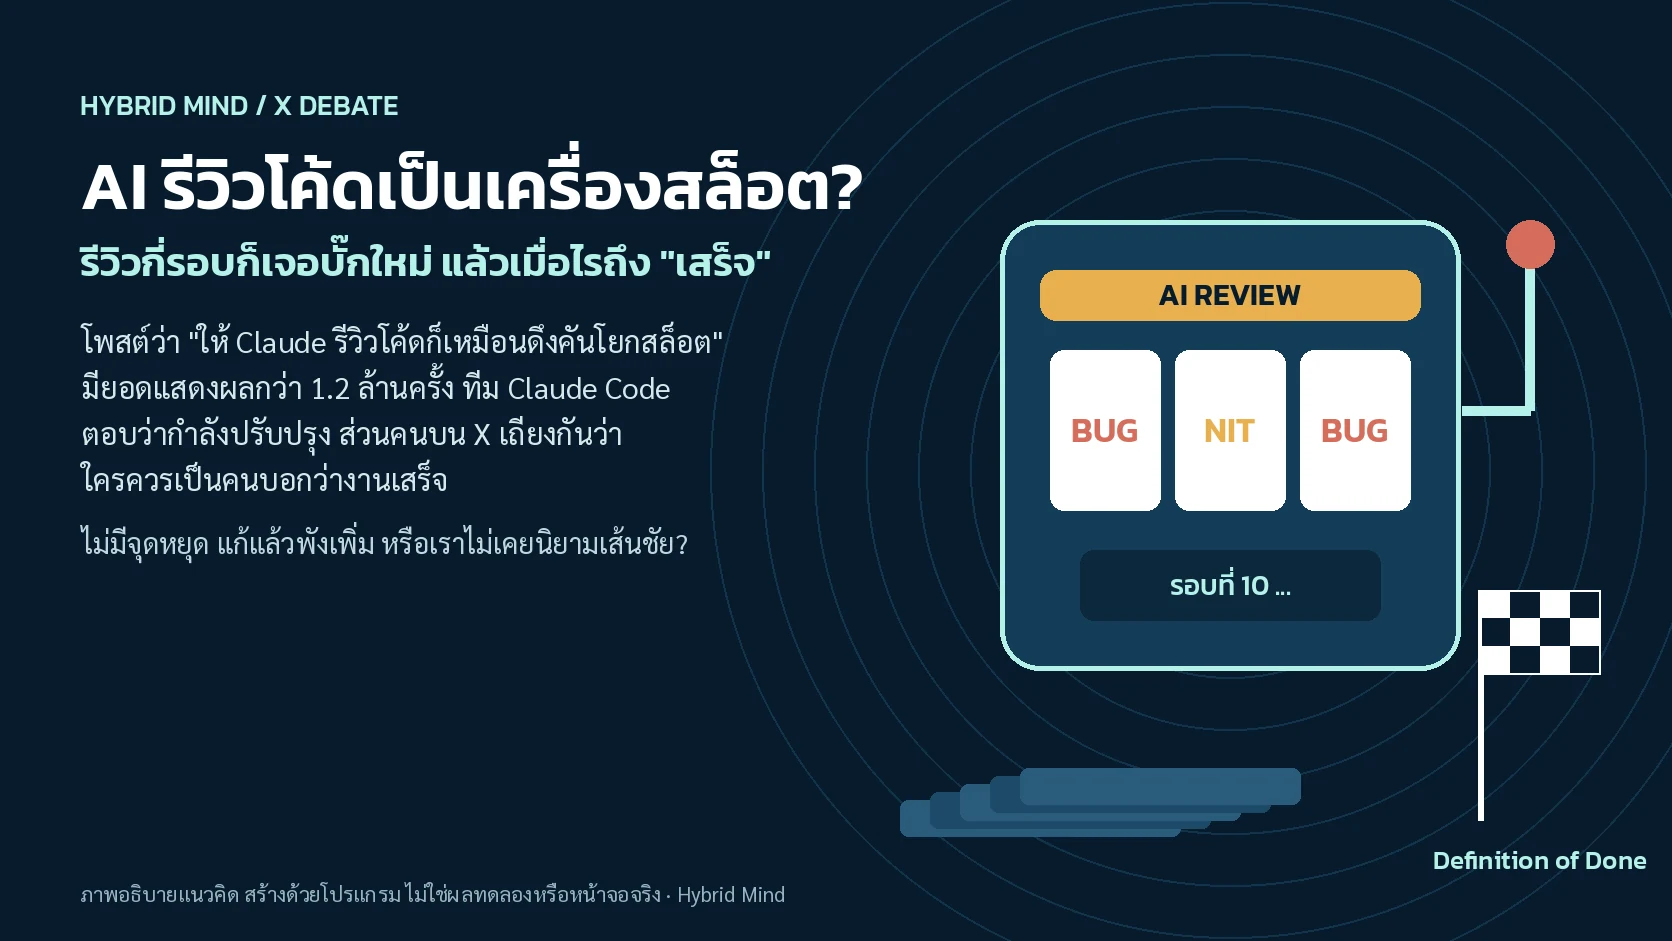
ทำไมคนบน X ถึงบอกว่าการให้ Claude รีวิวโค้ดเหมือนดึงคันโยกเครื่องสล็อต และสรุปแล้วควรรีวิวกี่รอบถึงพอ?
คำตอบสั้น: วันที่ 11 ต.ค. 2026 Lucas (@lucas_builds) โพสต์ว่า “Asking Claude to review your code is a slot machine” รีวิวรอบไหนก็เจอบั๊กใหม่ รอบที่สิบก็ยังเจอ แล้ว “จะรู้ได้อย่างไรว่าโค้ดเสร็จแล้ว” โพสต์นี้มียอดแสดงผลราว 1.24 ล้านครั้ง Boris Cherny จากทีม Claude Code ตอบว่ากำลังปล่อยการปรับปรุง ส่วน Addy Osmani ซึ่งโปรไฟล์ระบุว่าทำงาน Claude Code ที่ Anthropic ตอบว่า ต้องนิยามคำว่า “done” ให้ชัดก่อนเริ่มรีวิว
คนบน X แตกเป็นหลายฝั่ง: ฝั่งหนึ่งบอกว่าคำสั่ง “หาบั๊ก” ไม่มีจุดหยุดอยู่แล้ว ฝั่งหนึ่งบอกให้ตั้งเส้นชัยจากเทสต์และ Spec อีกฝั่งเตือนว่ายิ่งแก้ตามรีวิว โค้ดยิ่งมีบั๊กใหม่ บางคนแก้ด้วยการให้อีกโมเดลรีวิว และอีกกลุ่มใหญ่แย้งว่าซอฟต์แวร์ไม่เคย “เสร็จ” อยู่แล้ว คนก็หาบั๊กไม่หมดเหมือนกัน
หลักฐานบอกอะไร: ไม่มีตัวเลขรอบรีวิวที่ถูกต้องตายตัว สิ่งที่หลักฐานสนับสนุนคือ ผลของ LLM ไม่นิ่งจากคำสั่งเดิม และ LLM แก้ตัวเองได้ไม่ดีถ้าไม่มีสัญญาณจากภายนอก ดังนั้นเส้นชัยควรมาจากสิ่งที่รันได้ เช่น เทสต์ และเกณฑ์ที่ตกลงกันก่อน ไม่ใช่รอให้โมเดลเงียบเอง บทความนี้สรุปจาก 217 โพสต์ที่เราอ่าน ไม่ใช่ตัวแทนความเห็นทั้งหมดบน X
ตัวเลขนับด้วย X Recent Counts ณ 13 ต.ค. 2026 ราว 23:05 น. (เวลาไทย) วันที่ 13 ต.ค. นับถึงราว 23:04 น. เท่านั้น ยอดไลก์และยอดแสดงผลเปลี่ยนได้ตลอด ใช้ดูขนาดวงสนทนาคร่าว ๆ

เกิดอะไรขึ้น: โพสต์สามบรรทัดที่นักพัฒนาจำนวนมากบอกว่า “เจอเหมือนกัน”
โพสต์ต้นทางสั้นมาก ไม่มีตัวเลขหรือการทดลอง เป็นประสบการณ์ที่คนใช้ AI เขียนโค้ดจำนวนมากรู้สึกเหมือนกัน คือสั่งให้ AI รีวิว ได้รายการบั๊ก แก้ตาม สั่งรีวิวใหม่ ก็ได้รายการใหม่ วนไปไม่จบ คำถามท้ายโพสต์ว่า “so how do you decide your code is actually done?” จึงกลายเป็นคำถามเปิดให้คนเข้ามาแลกวิธีของตัวเอง
- @lucas_builds โพสต์ “Asking Claude to review your code is a slot machine. Every review finds brand new bugs. Review again: more. Review a tenth time: it still finds something.” ยอดแสดงผลราว 1.24 ล้าน ไลก์ราว 11.8K บุ๊กมาร์กราว 2.8K
- คำตอบที่ได้ไลก์สูงลำดับต้น ๆ เตือนว่า “it also will start changing code in such a way that it’ll introduce more bugs” (433 ไลก์)
- Boris Cherny ตอบ “Landing improvements now, it’s actually quite tricky to get this right and we’ve been doing a fair bit of science here. Will share more soon.” (ยอดแสดงผลราว 1.05 แสน ไลก์ราว 3.2K)
- Addy Osmani โควตโพสต์ ว่า “Clearly define ‘done’ before code review starts” และให้ Claude มีเช็กที่รันได้ เช่น คำสั่ง Bash เทสต์ หรือการคลิกผ่านแอปในเบราว์เซอร์ ราว 1.7 ชั่วโมงต่อมา เขาโพสต์ต่อว่างานของคนจะเปลี่ยนจาก “review every line” เป็น “build loops the agent can run itself”
- โพสต์สรุปแบบ “please don’t ask Claude to review ten times… set a clear finish line” แพร่ต่อ และมีโพสต์ทำนองเดียวกันตามมาอีกหลายภาษา ทั้งอาหรับ เกาหลี และจีน
- Lucas สรุปกติกา 5 ข้อ ที่เขาบอกว่าเห็นซ้ำในคำตอบราว 920 ข้อ และเล่าว่าทีม Claude Code ตอบแล้วว่ากำลังแก้
คำถามคือ “เมื่อไรถึงเสร็จ”
Lucas ไม่ได้บอกว่า Claude แย่ เขาตั้งคำถามว่าเมื่อผู้รีวิวไม่เคยหมดเรื่องให้ติ ใครเป็นคนบอกว่าพอ และตอบคนที่บอกว่าเป็นเพราะ Promptว่า “I am describing the mechanism that is at work here”
ทีม Claude Code รับรู้ปัญหา
Boris Cherny บอกว่ากำลังปล่อยการปรับปรุงและเรื่องนี้ “tricky” แต่ ณ เวลาที่เราอ่าน ยังไม่มีรายละเอียดว่าปรับอะไร บางคนในเธรดอ้างว่ารีวิวรอบหลังแคบลงแล้ว ซึ่งเรายังยืนยันไม่ได้
“done” ต้องมาก่อนรีวิว
Addy Osmani บอกว่าผู้รีวิว “human or agent” ถ้าถูกขอให้หาบั๊กโดยไม่มีนิยามว่าเสร็จ ก็ยังหาอะไรที่ปรับได้อีกเสมอ เมื่อไม่มีอะไรบล็อก ให้ “merge and ship”

ทำไม “หาบั๊กให้หน่อย” ถึงไม่มีจุดหยุด
คนในเธรดอธิบายสาเหตุไว้หลายแบบ เมื่อจัดกลุ่มแล้วมีสามกลไกหลักที่เกิดพร้อมกัน และแต่ละกลไกมีงานวิจัยที่เกี่ยวข้องอยู่บ้าง (เราแยกสิ่งที่ยืนยันได้ไว้ในหัวข้อหลักฐาน)
1. ทุกรอบคือการสุ่มใหม่
ผู้ใช้รายหนึ่งเล่าว่า รีวิว diff เดิมใน Session ใหม่ ได้บั๊กคนละชุด และรอบที่สามเจอ “race condition” ในโค้ดที่ไม่มี Thread เลย อีกคนบอกว่า รีวิว PR เดิมสามครั้ง ได้รายการ “critical” สามแบบ
2. คำสั่งไม่มีเส้นชัย
คำตอบจำนวนมากพูดตรงกันว่า “find bugs” ไม่มี Stop condition ผู้ใช้รายหนึ่งเทียบว่า ให้ LLM พิสูจน์อักษรเมื่อไร มันก็เปลี่ยนอะไรสักอย่างเสมอ ไม่เคยตอบว่า “สมบูรณ์แล้ว” อีกคนบอกว่า รีวิวเอกสาร PRD ก็เป็นแบบเดียวกัน
3. แก้แล้วเกิดบั๊กใหม่
ทุกการแก้คือโค้ดใหม่ที่รอบถัดไปต้องรีวิว ผู้ใช้รายหนึ่งสรุปวงจรว่า รีวิว สั่งแก้ รีวิวใหม่ การแก้ทำให้เกิดบั๊ก สั่งแก้การแก้ แล้ววนซ้ำ อีกคนสรุปสั้นกว่านั้นว่า “Fixes 5, introduces 4.”

ต้นทุนก็เป็นส่วนหนึ่งของวงถก: หลายคนพูดถึงค่าใช้จ่าย ผู้ใช้รายหนึ่งเล่าว่าเจอค่า Actions ราว 600 ดอลลาร์ในราว 10 วันจนต้องเปลี่ยนวิธี อีกคนอ้างว่ารีวิวด้วย Claude ครั้งละ 15–25 ดอลลาร์ แพงกว่าเครื่องมือเฉพาะทาง ตัวเลขเหล่านี้เป็นคำเล่าที่เราไม่ได้ตรวจสอบ ส่วนคำแซวว่าระบบ “ออกแบบมาให้เผา Token” นั้น ผู้โพสต์เองเรียกว่าเป็นมุมของ “conspiracy theorist” และไม่มีหลักฐานรองรับ
5 ฝั่งบน X: ไม่มีจุดหยุด ตั้งเส้นชัยก่อน แก้แล้วพัง เปลี่ยนผู้รีวิว หรือซอฟต์แวร์ไม่เคยเสร็จ
เราจัดกลุ่มจาก 217 โพสต์ที่อ่าน ส่วนใหญ่เป็นภาษาอังกฤษ มีภาษาอาหรับ เกาหลี จีน และฝรั่งเศสปนบ้าง บุคคลสาธารณะเราระบุชื่อ ส่วนบัญชีส่วนตัวขนาดเล็กเราเล่าความเห็นแบบไม่ระบุชื่อ แต่ใส่ลิงก์ให้ตรวจต้นทางได้ หลายโพสต์อยู่ได้มากกว่าหนึ่งฝั่ง การจัดกลุ่มเป็นการตีความของ Hybrid Mind ไม่ใช่สัดส่วนความเห็นจริง
1. “มันคือกลไก: คำสั่งหาบั๊กไม่มีจุดหยุด”
ฝั่งที่มองว่าปัญหาอยู่ที่ธรรมชาติของงานรีวิว ไม่ใช่ความเก่งหรือไม่เก่งของโมเดล
- ผู้ใช้รายหนึ่งสรุปว่า “find bugs” ไม่มีเงื่อนไขจบ ถ้าปล่อยไว้มันจะ “invent a p3 forever” และ “done = tests green. not when the model finally shuts up”
- อีกคนตั้งคำถามกลับว่ามันเจอบั๊กจริงหรือเปล่า เพราะโมเดลไม่ได้ถูกปรับให้ตอบว่า “ไม่เจออะไร” เมื่อสั่งให้หา มันจึงอาจสร้างขึ้นมาเอง
- Filip Hric ซึ่งโปรไฟล์ระบุว่าเป็น DevRel ของ Qodo บริษัทเครื่องมือรีวิวโค้ด อธิบายว่า เครื่องมือรีวิววัดกันด้วย Recall และ Precision และดูเหมือน Claude จะ Precision ต่ำ คือติทุกอย่างเพื่อให้มีอะไรส่งให้ เขาเสริมว่า “done” คือเมื่อเจตนาของงานสำเร็จ ไม่ใช่เมื่อไม่มีบั๊ก (ควรอ่านโดยรู้ว่าเขาอยู่ในธุรกิจนี้)
2. “นิยามคำว่าเสร็จก่อน แล้วให้เทสต์เป็นคนตัดสิน”
ฝั่งที่ถูกพูดถึงมากที่สุด และเป็นแนวเดียวกับคำตอบของคนใน Anthropic
- Addy Osmani บอกว่า ให้ Claude มีเช็กที่รันได้และต้องผ่านก่อนบอกว่าเสร็จ “When nothing blocks merge and ship.” และเมื่อมีคนถามต่อ เขาตอบว่าให้ Claude ร่าง แต่ “a human deciding ‘yes, this is what done means’” คือส่วนที่สำคัญ
- ผู้ใช้รายหนึ่งนิยามว่า “Done is when the tests pass and new findings stop being bugs and start being preferences.”
- อีกคนเสนอว่า รีวิวรอบถัดไปต้องส่งมาเป็นเทสต์ที่ล้ม ไม่ใช่รายการใหม่ ไม่อย่างนั้น “one last review” จะกลายเป็น “subscription”
- อีกคนแนะว่า เกณฑ์หยุดต้องไม่ใช่ความเห็นของโมเดล ให้ตรึง Prompt และ Commit ไว้ รีวิวเฉพาะ diff ถ้ามันเริ่มวนติเรื่องเดิมก็คือจบ
3. “ยิ่งแก้ตามรีวิว โค้ดยิ่งพัง”
ฝั่งที่ห่วงว่าการวนรีวิวไม่ได้แค่เสียเวลา แต่ทำให้โค้ดแย่ลง
- คำตอบที่ได้ 433 ไลก์เตือนว่าโมเดลจะเริ่มแก้โค้ดในแบบที่สร้างบั๊กเพิ่ม
- ผู้ใช้รายหนึ่งเล่าว่าเคยวนรีวิวและแก้ 235 รอบ เมื่อไล่ดูภายหลังพบว่าราว 30% ของปัญหาเกิดจากการแก้เอง ราว 40% เป็นบั๊กเดิมที่รอบก่อนมองข้าม และราว 30% เป็นกรณีที่โค้ดไปไม่ถึงจริง (เป็นคำเล่าส่วนตัว ไม่ได้ตรวจสอบ)
- อีกคนเตือนว่าถ้าแก้ให้ครบทุกสถานการณ์ประหลาด โค้ดจะซับซ้อนขึ้นและนำไปสู่บั๊กเพิ่ม เป็น “vicious cycle” และบอกว่าบั๊กที่เจอรอบหลัง ๆ จะ “increasingly improbable and inconsequential” จึงต้องจำกัดจำนวนรอบ
4. “ให้อีกโมเดลรีวิว แล้วมันจะนิ่งเอง”
ฝั่งนักปฏิบัติที่บอกว่าวงจรจบได้จริง ถ้าจัดผู้รีวิวให้ถูก แต่ในฝั่งนี้เองก็เถียงกัน
- วิศวกรที่โปรไฟล์ระบุว่าเป็น Founding Engineer ของ Bolt เล่าว่าวงจรรีวิวของเขามัก “converges after max 3 rounds” ถ้าตั้งขอบเขตไว้ เช่น ห้ามขยายงาน ผู้ใช้อีกคนบอกว่าจบใน 3–4 รอบสำหรับ PR ขนาดกลาง เมื่อใช้โมเดลที่ต่างกันมาก
- บางคนยืนยันว่าโมเดลของทั้ง OpenAI และ Anthropic เคยตอบว่า “looks good to me” ได้จริง และอีกคนบอกว่าไม่ได้เจออาการนี้บ่อยอย่างที่ว่า
- แต่มีคนแย้งขำ ๆว่าให้ Codex รีวิวต่อ “finds even more bugs” และอีกโพสต์เตือนว่า “Three reviewers aren’t a stopping rule” เพราะ “No more findings” ไม่ได้พิสูจน์ว่าโค้ดไม่มีบั๊ก
5. “ซอฟต์แวร์ไม่เคยเสร็จอยู่แล้ว และคนก็หาบั๊กไม่หมด”
ฝั่งที่มองว่านี่ไม่ใช่ปัญหาใหม่ของ AI บางคนในฝั่งนี้วิจารณ์ผู้ถามแรง
- คำตอบที่ได้ไลก์สูงสุดที่เราเห็น (ราว 3.7K ไลก์) เป็นมุกว่าให้ใช้ “Customer-Driven Development” ให้ลูกค้าหาบั๊กเอง ถ้าลูกค้าไม่เจอก็ไม่ใช่บั๊ก
- คำตอบอีกข้อที่ได้ 216 ไลก์เตือนว่า “hopefully no one is pretending that humans were that great at finding bugs either” และอีกคนบอกว่าเหมือนงานวิศวกรรมยุคก่อน AI ทุกอย่าง บั๊กหมดก็ต่อเมื่อเราเลือกมองข้าม
- บางคนสรุปว่า “Done is a business decision, not a consensus.” และอีกคนเสริมว่า “Done isn’t a state the code reaches. It’s a state the customer reaches.”
- ฝั่งที่แรงกว่านั้นมองว่าเป็นปัญหาของคนเขียน ผู้ใช้รายหนึ่งแปลความโพสต์ต้นทางว่า “I wrote slop and now deslopifying is too hard” อีกคนบอกว่านี่คือเส้นแบ่งระหว่างคนที่เข้าใจโค้ดกับ Vibe coder ส่วน Lucasตอบกลับคนวิจารณ์ว่าให้ส่งลิงก์ GitHub มา แล้วเขาจะให้ Claude หาบั๊กให้

ทดลอง 01 — เครื่องสล็อตรีวิว: ดึงคันโยกอีกรอบแล้วเกิดอะไรขึ้น
โค้ดสมมติมีบั๊กจริงซ่อนอยู่ 8 จุด (ร้ายแรง 3 จุด เล็กน้อย 5 จุด) ผู้รีวิวสมมติเจอบั๊กจริงได้บางส่วนในแต่ละรอบ และมีข้อค้นพบหลอกปนมาเสมอ การแก้แต่ละครั้งมีโอกาสสร้างบั๊กใหม่ เลือกกติกา แล้วกด “ดึงคันโยก” ทีละรอบ เป็นการจำลองเชิงการศึกษาที่ใช้ค่าสุ่มแบบตั้ง Seed ไว้ล่วงหน้า ค่าความน่าจะเป็นทั้งหมดเป็นค่าสมมติของ Hybrid Mind ไม่ใช่ผลวัดของ Claude, Codex หรือโมเดลใด
กติกาการรีวิว
แท่งแดง = บั๊กจริงที่เจอในรอบนั้น · แท่งส้ม = ข้อค้นพบหลอกหรือข้อติเรื่องสไตล์ · แท่งม่วง = บั๊กใหม่ที่เกิดจากการแก้ในรอบนั้น
ข้อค้นพบเยอะ ไม่ได้แปลว่าเจอบั๊กจริงเยอะ
ประเด็นที่ซ่อนอยู่ในวงถกคือ เรากำลังนับอะไร ถ้านับ “จำนวนข้อค้นพบ” ผู้รีวิวที่ติเยอะจะดูขยัน แต่ถ้านับ “สัดส่วนข้อค้นพบที่เป็นบั๊กจริง” (Precision) กับ “สัดส่วนบั๊กจริงที่ถูกเจอ” (Recall) ภาพจะต่างออกไป ผู้รีวิวที่ติเยอะแต่ตรงน้อย ทำให้คนต้องเสียเวลาแยกของจริงออกจากของหลอก และถ้าเราสั่งแก้ทุกข้อ ก็เพิ่มโอกาสให้เกิดบั๊กใหม่
Anthropic เองก็ออกแบบเครื่องมือรีวิวของ Claude Code โดยรู้ปัญหานี้ README ของปลั๊กอิน code-review บอกว่าใช้ Agent หลายตัวรีวิวคู่กัน ให้คะแนนความมั่นใจ 0–100 แล้วกรองข้อที่ต่ำกว่า 80 ออก และระบุสิ่งที่ถือเป็น False positive เช่น ปัญหาเดิมที่ไม่ได้เกิดใน PR นี้ โค้ดที่ดูเหมือนบั๊กแต่ไม่ใช่ และข้อติจุกจิก ส่วนคำสั่ง /code-review ที่คนในเธรดใช้จริงเป็นเวอร์ชันไหนและตั้งค่าอย่างไร เราไม่ทราบ

ทดลอง 02 — ด่านคัดข้อค้นพบ: กติกาไหนกันของหลอกได้ และพลาดอะไรไป
ผู้รีวิวสมมติส่งข้อค้นพบมา 7 ข้อ เลือกกติกาที่ต้องผ่านก่อน “แก้ทันที” ข้อที่ไม่ผ่านจะลงรายการไว้ทีหลัง ระบบจะเฉลยว่าข้อไหนเป็นบั๊กจริง ข้อค้นพบและเฉลยทั้งหมดเป็นตัวอย่างสมมติเพื่อการศึกษา ไม่ได้มาจากการรีวิวโค้ดจริง
กติกา 5 ข้อที่ถูกพูดถึงซ้ำ และแต่ละข้อแก้ปัญหาไหน
วันที่ 12 ต.ค. Lucas สรุปกติกาที่เขาบอกว่าเห็นซ้ำในคำตอบ เราจับคู่แต่ละข้อกับกลไกที่มันแก้ และข้อจำกัดที่คนในเธรดพูดถึง
| กติกา | แก้กลไกไหน | ข้อจำกัดที่ควรรู้ |
|---|---|---|
| 1. นิยาม done ก่อนรีวิว: เทสต์ผ่าน Spec ครบ | คำสั่งไม่มีเส้นชัย | เทสต์ที่ผ่านอาจไม่ครอบคลุม ผู้ใช้รายหนึ่งเล่าว่าโมเดลแก้บั๊กหนึ่งแล้วทำอีกส่วนพัง แต่ชุดเทสต์ที่มองเห็นยังเขียวอยู่ |
| 2. แก้เฉพาะ Critical และ High ที่เหลือลงรายการไว้ก่อน | แก้แล้วเกิดบั๊กใหม่ | ต้องตกลงกันก่อนว่าอะไรนับเป็น High ไม่อย่างนั้นโมเดลก็จัดระดับเองตามใจ |
| 3. ไม่มีเทสต์ที่ล้ม ไม่นับเป็นบั๊ก | ข้อค้นพบหลอก | บั๊กบางแบบเขียนเทสต์ยาก เช่น ปัญหา UX หรือ Timezone อาจถูกตัดทิ้งทั้งที่จริง (ลองใน ทดลอง 02) |
| 4. ให้โมเดลอื่นรีวิว ไม่ใช่ตัวที่เขียน | จุดบอดซ้ำกัน | บางคนบอกว่าจบเร็วขึ้น บางคนบอกว่ายิ่งเจอเพิ่ม และค่าใช้จ่ายเพิ่มตามจำนวนผู้รีวิว |
| 5. จำกัดไม่เกิน 3 รอบ | วงจรไม่รู้จบ และต้นทุน | เลข 3 เป็นค่าที่คนในเธรดนิยมใช้ ไม่ใช่ค่าที่มีงานวิจัยรองรับ บั๊กสำคัญอาจยังอยู่หลังรอบที่ 3 |
อีกวิธีที่หลายคนใช้คือให้รีวิวเป็นส่วนหนึ่งของวงจรตั้งแต่ระหว่างเขียน ไม่ใช่รอท้ายงาน ผู้ใช้รายหนึ่งเล่าว่าทำปลั๊กอินให้โมเดลเล็กรีวิวทุกครั้งที่ Agent ทำงานเสร็จหนึ่งช่วง แล้วส่งข้อสงสัยให้โมเดลใหญ่ยืนยัน อีกคนให้ Agent ให้คะแนนแต่ละข้อตามเกณฑ์ เช่น ผู้ใช้เห็นบั๊กไหม บล็อก Production ไหม เกิดบ่อยแค่ไหน แล้วคนเป็นคนเลือกว่าจะแก้ข้อไหน และบางคนก็แนะสั้น ๆว่า ทำ PR ให้เล็กลง

หลักฐานสนับสนุนอะไร และอะไรที่ยังพิสูจน์ไม่ได้
- ผลของ LLM ไม่นิ่งจากคำสั่งเดิม: งานวิจัย An Empirical Study of the Non-determinism of ChatGPT in Code Generation (2023) ทดสอบโจทย์ 829 ข้อ และพบว่า Prompt เดียวกันให้โค้ดต่างกันมาก สอดคล้องกับประสบการณ์ “รีวิวเดิม ได้คำตอบใหม่” แม้งานนี้ศึกษาการเขียนโค้ด ไม่ใช่การรีวิวโดยตรง
- LLM แก้ตัวเองได้ไม่ดีถ้าไม่มีสัญญาณภายนอก: งาน Large Language Models Cannot Self-Correct Reasoning Yet (ICLR 2024) พบว่าในงานด้านการให้เหตุผล การให้โมเดลแก้คำตอบตัวเองโดยไม่มี Feedback ภายนอก มักไม่ช่วย และบางครั้งทำให้ผลแย่ลง
- ผู้ผลิตเองยอมรับเรื่อง False positive: ปลั๊กอิน code-review ของ Claude Code ใช้คะแนนความมั่นใจและเกณฑ์ 80 เพื่อกรองข้อค้นพบหลอก และเอกสาร Best practices ของ Claude Code เขียนว่า “Claude stops when the work looks done. Without a check it can run, ‘looks done’ is the only signal available”
- รีวิวโดยคนก็ไม่ได้มีไว้หาบั๊กอย่างเดียว: งานศึกษาของ Microsoft Research เรื่อง Expectations, Outcomes, and Challenges of Modern Code Review (ICSE 2013) พบว่าแม้การหาข้อบกพร่องเป็นแรงจูงใจอันดับต้น แต่ผลจริงของการรีวิวเกี่ยวกับข้อบกพร่องน้อยกว่าที่คาด และให้ประโยชน์ด้านอื่น เช่น การถ่ายทอดความรู้ในทีม
- การปรับปรุงที่ Boris Cherny พูดถึง: ณ เวลาที่เราอ่าน ยังไม่มีรายละเอียดว่าเปลี่ยนอะไร หรือทำให้รีวิวจบเร็วขึ้นแค่ไหน
- “Anthropic สอนให้ใช้เหมือนสล็อตเอง”: มีโพสต์บอกว่านี่คือ “twist” ของเรื่อง เราตรวจแล้วพบว่าเอกสาร How Anthropic teams use Claude Code มีคำแนะนำ “Treat it like a slot machine” จริง แต่เป็นของทีม Data Science และ ML Engineering ที่ให้ Claude ทำงานเอง 30 นาที แล้วรับผลหรือเริ่มใหม่ ไม่ใช่คำแนะนำเรื่องการรีวิว
- ตัวเลขจากคำเล่า: 235 รอบ สัดส่วน 30/40/30% ค่ารีวิว 15–25 ดอลลาร์ หรือค่า Actions 600 ดอลลาร์ ล้วนเป็นประสบการณ์ส่วนตัวบน X ที่เราไม่ได้ตรวจ
- “อีกโมเดลรีวิวแล้วดีกว่า”: มีทั้งคนที่บอกว่าช่วยและคนที่บอกว่ายิ่งเจอเพิ่ม เรายังไม่เห็นงานวัดผลที่เทียบกันตรง ๆ ในเธรดนี้
- “ระบบตั้งใจให้เผา Token”: ไม่มีหลักฐาน เป็นข้อสงสัยที่ผู้โพสต์เองเรียกว่ามุมทฤษฎีสมคบคิด

เอาไปใช้อย่างไร: ตั้งเส้นชัยก่อนดึงคันโยก
สำหรับนักพัฒนาเดี่ยว
- เขียน Definition of Done 3–5 ข้อก่อนสั่งรีวิว และใส่ไว้ใน Prompt หรือไฟล์กฎของโปรเจกต์
- ให้ข้อค้นพบระดับร้ายแรงมาพร้อมเทสต์ที่ล้มหรือขั้นตอนทำซ้ำ ข้อที่ไม่มี ให้ลงรายการไว้ก่อน
- ตรึง Commit แล้วรีวิวเฉพาะ diff ถ้ารีวิวเริ่มติเรื่องเดิมซ้ำ ถือว่าใกล้จบ
สำหรับทีม
- ตกลงเกณฑ์ระดับความรุนแรงร่วมกัน ไม่ให้โมเดลจัดเอง
- ตั้งเพดานรอบและงบ Token ต่อ PR แล้วทบทวนจากข้อมูลจริงของทีม
- เมื่อผิดซ้ำ ให้เขียนเป็นกฎ Hook หรือเทสต์ ตามที่ Addy Osmani เรียกว่าทำให้ “taste compound”
สำหรับหัวหน้างาน
- “ไม่มีข้อค้นพบ” ไม่ได้แปลว่าไม่มีบั๊ก และ “รีวิวครบ 3 รอบ” ไม่ได้แปลว่าปลอดภัย
- คนยังต้องเป็นเจ้าของการ Merge และเจ้าของคำว่า “พอแล้ว”
- วัดบั๊กที่หลุดถึงผู้ใช้ ไม่ใช่จำนวนรอบรีวิวหรือจำนวนข้อค้นพบ

ทดลอง 03 — เขียน Definition of Done ก่อนสั่งรีวิว
ติ๊กเงื่อนไขที่อยากใช้ ปรับเพดานรอบ ระบบจะประเมินว่าเส้นชัยชัดแค่ไหน และสร้าง Brief ภาษาอังกฤษสำหรับวางให้ AI ผู้รีวิว คะแนนเป็นเกณฑ์เชิงบรรณาธิการแบบกำหนดไว้ล่วงหน้าของ Hybrid Mind ไม่ใช่มาตรฐานทางการ และ Hybrid Mind ไม่ได้ทดสอบ Brief นี้กับโมเดลใด
อ่านต่อบน Hybrid Mind
- Clean Code ยุค AI Agent: X ถกว่าโค้ดยังต้องอ่านง่ายเพื่อคน หรือเพื่อ Agent วงถกก่อนหน้าที่พบว่าคอขวดย้ายไปอยู่ที่การรีวิว
- Matt Pocock /grill-me: X ถกให้ AI ซักก่อนเขียนโค้ด อีกด้านของเรื่องเดียวกัน คือการตกลงเป้าหมายก่อนเริ่ม
- ตรวจโค้ดที่ AI เขียนอย่างไร: จับบั๊กด้วย 8 Tests วิธีเปลี่ยนข้อค้นพบให้เป็นเทสต์ที่รันได้
- วิธีตรวจงาน AI Agent ก่อนใช้งานจริง: เช็กลิสต์และหลักฐานที่ต้องขอ ใบตรวจรับที่ใช้เป็น Definition of Done ได้
- Loop Engineering: เจาะวงจร AI Coding Agents พื้นฐานเรื่องวงจร Agent และ Guardrails
- AI โกงคะแนนได้อย่างไร? เจาะ 26 กรณีจาก AI Finds A Way ทำไมเกณฑ์ที่วัดได้ต้องออกแบบให้ดี ไม่อย่างนั้น Agent อาจหาทางผ่านแบบผิด ๆ
คำถามที่พบบ่อย
1. ควรให้ AI รีวิวโค้ดกี่รอบ?
ไม่มีตัวเลขที่ถูกต้องตายตัว เลข 3 รอบเป็นค่าที่คนในเธรดนิยมใช้ ไม่ใช่ผลวิจัย สิ่งที่สำคัญกว่าจำนวนรอบคือมีเส้นชัยที่ตกลงไว้ก่อน เช่น เทสต์ผ่าน Spec ครบ และไม่มีข้อค้นพบระดับร้ายแรงที่ทำซ้ำได้
2. ที่ Claude เจอบั๊กใหม่ทุกรอบ แปลว่าโค้ดผมแย่มากหรือเปล่า?
ไม่จำเป็น ส่วนหนึ่งอาจเป็นบั๊กจริงที่รอบก่อนมองข้าม แต่ส่วนหนึ่งอาจเป็นข้อค้นพบหลอก ข้อติเรื่องสไตล์ หรือบั๊กที่เกิดจากการแก้ในรอบก่อน วิธีแยกคือขอให้แต่ละข้อมาพร้อมเทสต์ที่ล้มหรือขั้นตอนทำซ้ำ
3. Anthropic บอกเองหรือว่าให้ใช้ Claude เหมือนเครื่องสล็อต?
มีจริง แต่คนละบริบท เอกสาร How Anthropic teams use Claude Code มีคำแนะนำ “Treat it like a slot machine” ของทีม Data Science และ ML Engineering หมายถึงบันทึกสถานะ ให้ Claude ทำงาน 30 นาที แล้วรับผลหรือเริ่มใหม่ ไม่ได้พูดถึงการรีวิวโค้ดซ้ำ
4. ทีม Claude Code แก้ปัญหานี้แล้วหรือยัง?
ยังยืนยันไม่ได้ Boris Cherny ตอบเมื่อ 12 ต.ค. (เวลาไทย) ว่ากำลังปล่อยการปรับปรุงและจะเล่ารายละเอียดภายหลัง ณ เวลาที่เราเขียน เรายังไม่เห็นประกาศว่าเปลี่ยนอะไร
5. ให้อีกโมเดลรีวิวช่วยได้ไหม?
อาจช่วยลดจุดบอดที่ซ้ำกันได้ และหลายคนเล่าว่าวงจรจบใน 3–4 รอบ แต่ก็มีคนบอกว่ายิ่งเจอเพิ่ม และค่าใช้จ่ายเพิ่มตาม การมีผู้รีวิวหลายตัวไม่ใช่เกณฑ์หยุดในตัวเอง ยังต้องมีเส้นชัยที่ตกลงไว้
6. ถ้าไม่ใช่โมเดล แล้วใครควรบอกว่า “เสร็จ”?
คน หรือเกณฑ์ที่คนตั้งไว้ก่อน ทั้ง Addy Osmani และคำตอบจำนวนมากในเธรดพูดตรงกันว่าคนต้องเป็นเจ้าของคำนิยามว่าเสร็จและเจ้าของสิ่งที่ปล่อยออกไป โมเดลช่วยรันเช็กและหาข้อสงสัยได้ แต่ “พอแล้ว” เป็นการตัดสินใจของคนทำงาน
เอกสารอ้างอิงและขอบเขตการตรวจ
- @lucas_builds: “Asking Claude to review your code is a slot machine” (โพสต์ต้นทาง 11 ต.ค. 2026)
- @lucas_builds: กติกา 5 ข้อจากคำตอบ (12 ต.ค. 2026)
- Boris Cherny: “Landing improvements now” (12 ต.ค. 2026 เวลาไทย)
- Addy Osmani: นิยาม done ก่อนเริ่มรีวิว และโพสต์เรื่อง build loops the agent can run itself
- anthropics/claude-code: README ของปลั๊กอิน code-review (ตรึงที่ commit e4f6820)
- Claude Code Docs: Best practices หัวข้อ Give Claude a way to verify its work
- Anthropic: How Anthropic teams use Claude Code (PDF, หน้า 11–12)
- Ouyang และคณะ (2023): An Empirical Study of the Non-determinism of ChatGPT in Code Generation
- Huang และคณะ (ICLR 2024): Large Language Models Cannot Self-Correct Reasoning Yet
- Bacchelli และ Bird (ICSE 2013): Expectations, Outcomes, and Challenges of Modern Code Review
ขอบเขตการตรวจ: เราอ่านโพสต์ต้นฉบับที่ไม่ใช่รีโพสต์ 217 โพสต์ ช่วง 11 ต.ค. 19:00 น. ถึง 13 ต.ค. ราว 23:05 น. (เวลาไทย) จากเธรดตอบกลับของโพสต์ต้นทาง โพสต์โควต โพสต์ของ Boris Cherny และ Addy Osmani และการค้นคำ เช่น “slot machine” คู่กับ Claude, Codex หรือ code review จำนวนโพสต์นับด้วย X Recent Counts ได้แก่ 1,408 โพสต์ในเธรด (937 / 428 / 43 โพสต์ ในวันที่ 11 / 12 / 13 ต.ค. ตามเวลา UTC) และ 346 โพสต์รวมรีโพสต์ที่มีคำว่า “slot machine” คู่กับคำเกี่ยวกับ AI หรือรีวิว ช่วง 9–13 ต.ค. (134 โพสต์ถ้าไม่นับรีโพสต์) การค้นของ X API ไม่ได้คืนทุกโพสต์ จึงไม่ใช่ตัวอย่างสุ่ม และไม่ใช่ตัวแทนความเห็นของนักพัฒนาทั้งหมด
Hybrid Mind ไม่ได้ทดลองรีวิวโค้ดด้วย Claude, Codex หรือเครื่องมืออื่นเพื่อวัดผลเอง ไม่ได้ตรวจตัวเลขค่าใช้จ่ายหรือสัดส่วนบั๊กที่ผู้ใช้เล่า และไม่ทราบว่าการปรับปรุงที่ทีม Claude Code พูดถึงคืออะไร ห้องทดลองทั้งสามชุดเป็นการจำลองเชิงการศึกษาด้วยค่าสมมติ ภาพประกอบทั้งหมดสร้างด้วยโปรแกรม ไม่มีภาพบุคคลหรือภาพหน้าจอจริง ยอดไลก์และยอดแสดงผลเป็นค่าที่เราเห็น ณ เวลาที่อ่าน
ใส่ความเห็น