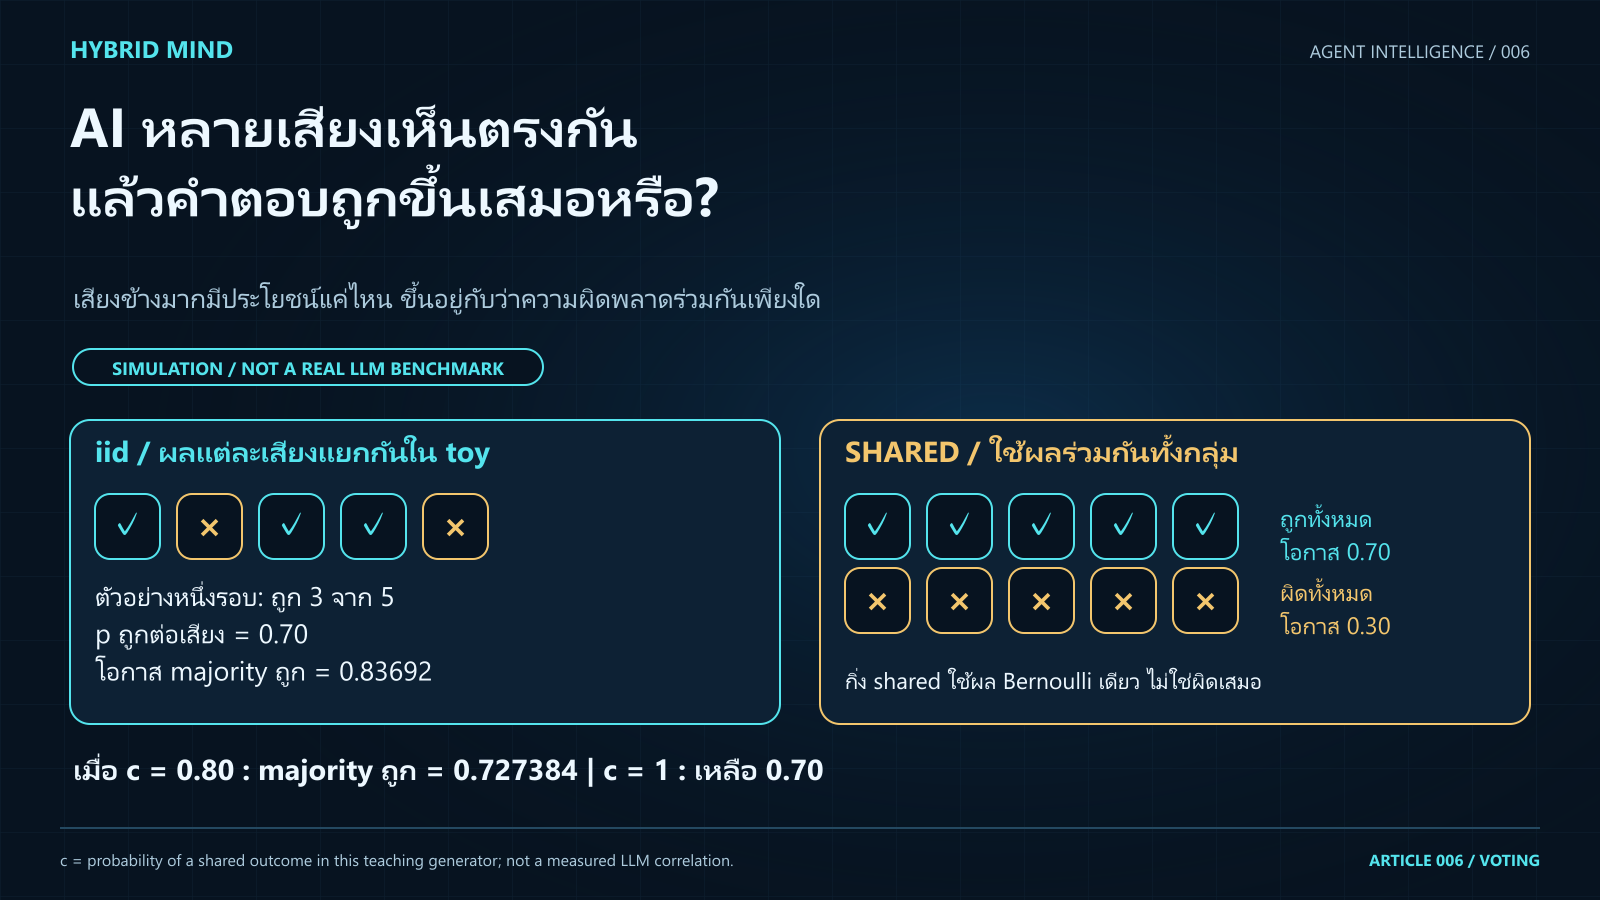
คำตอบโดยตรง: การให้ AI Agent หลายตัวโหวตอาจเพิ่มความถูกต้องเมื่อคำตอบแต่ละตัวให้ข้อมูลที่ต่างกันและกลไกรวมผลเหมาะกับโจทย์ แต่จำนวนเสียงที่เห็นพ้องกันไม่ยืนยันว่าคำตอบถูก หาก Agent ใช้ข้อมูลผิดชุดเดียวกัน หรือปรับคำตอบตามกัน ความผิดพลาดอาจเกิดร่วมกัน การประเมินจึงต้องแยกประโยชน์ของการสุ่มหลายคำตอบ การสื่อสาร และการตรวจหลักฐาน พร้อมเปรียบเทียบภายใต้งบเดียวกัน

ทำไม Agent ห้าตัวอาจให้หลักฐานเพียงชุดเดียว
สมมติ Agent ห้าตัวตอบว่าเอกสารเวอร์ชันล่าสุดอนุญาตให้ทำงานหนึ่งได้ แต่ทั้งหมดค้นคืนคู่มือเก่าจากฐานเดียวกัน การโหวตห้าต่อศูนย์แสดงความเห็นพ้องของผลลัพธ์ ไม่ได้เพิ่มเอกสารต้นทางอีกสี่ชุด ถ้าไม่มีใครตรวจเวอร์ชัน ความเห็นพ้องอาจขยายข้อผิดพลาดเดิม
อีกกรณีหนึ่ง Agent ตอบแยกกันก่อนอ่านคำตอบเพื่อน จากนั้นทั้งทีมเปลี่ยนไปใช้คำตอบของผู้ที่เขียนได้มั่นใจที่สุด ระบบดูมีฉันทามติมากขึ้น แต่ความถูกต้องอาจเพิ่ม คงเดิม หรือลดลง ต้องตรวจผลกับคำตอบอ้างอิง ไม่ใช้ความเรียบร้อยของบทสนทนาเป็นคะแนนความสำเร็จ
บทความนี้ต่อจาก กรอบ AI Agent Architecture ซึ่งอธิบายหน้าที่ของระบบ โดยเจาะคำถามเฉพาะว่า “หลายคำตอบที่นำมารวมกันให้ข้อมูลเพิ่มจริงหรือไม่” และจะทดลองความสัมพันธ์ของข้อผิดพลาดได้อย่างไร โดยไม่ถือว่าแบบจำลองของเราเป็นผลทดสอบ LLM
แยกการสุ่มหลายคำตอบออกจากการสนทนาหลาย Agent
Single Response: ตัวตั้งที่ต้องให้โอกาสเท่าเทียม
การเรียกโมเดลครั้งเดียวเป็น baseline ที่เรียบง่าย แต่ไม่ควรตั้งให้ใช้ prompt อ่อนกว่า ไม่มีเครื่องมือ หรือมีงบน้อยมากแล้วสรุปว่าทีม Agent ชนะโดยตัวสถาปัตยกรรม หากทีมใช้หลาย calls ต้องทดลองด้วยว่าการให้ระบบตัวเดียวตรวจเอกสารเพิ่มหรือทำงานนานขึ้นภายใต้งบเท่ากันให้ผลอย่างไร
Single-Agent ยังอาจเรียกเครื่องมือหลายครั้งและมีลูปตรวจผลได้ จำนวน Agent กับจำนวน calls จึงเป็นคนละตัวแปร ส่วนคำตอบหนึ่งครั้งที่ปรากฏบนจอไม่แสดงว่าระบบใช้ทรัพยากรหรือเหตุผลภายในเท่าไร
Self-Consistency: หลายตัวอย่างจากโมเดลเดียว
งาน Self-Consistency ที่ ICLR 2023 สุ่มหลาย reasoning paths แล้วรวมคำตอบปลายทาง แทนการใช้ greedy response เพียงครั้งเดียว กลไกนี้เป็นการเลือกผลในช่วง inference ไม่ใช่การฝึกน้ำหนักใหม่ และหลาย samples จากโมเดลเดียวไม่เท่ากับโมเดลที่ฝึกอย่างอิสระหลายตัว ผลที่ paper รายงานอยู่บน benchmark และรุ่นโมเดลที่ทดลอง ต้นฉบับ v4 และสถานะ ICLR 2023
สิ่งที่ตรวจได้คือข้อความที่สร้าง การดึง final answer จำนวน samples และกฎรวมผล ข้อความ reasoning ที่โมเดลแสดงไม่ควรถูกใช้เป็นหลักฐานโดยลำพังว่าเราเห็นกระบวนการคิดภายในทั้งหมด การตรวจคำตอบกับหลักฐานหรือ executable test เป็นอีกชั้นหนึ่ง
Multi-Agent Debate: การสื่อสารเป็นตัวแปรเพิ่ม
งานของ Du และคณะ ให้หลาย model instances สร้างคำตอบแล้วอ่านข้อความของกันและกันเพื่อปรับคำตอบ งานรายงานผลดีขึ้นในโจทย์บางกลุ่ม แต่ระบุด้วยว่า Agent อาจเห็นพ้องกับคำตอบผิด และการเพิ่มการสร้างข้อความกับบริบทยาวมีต้นทุน บทความนี้อ่าน arXiv v1 ปี 2023 ของงานที่ต่อมาตีพิมพ์ ICML 2024 ไม่อ้างว่ารัน camera-ready implementation แล้ว Multiagent Debate
การแบ่งบทบาทเป็น “นักวิจัย ผู้วิจารณ์ ผู้ตัดสิน” เป็นวิธีจัดงาน ไม่ใช่หลักฐานว่าความผิดพลาดของทั้งสามเป็นอิสระ ต้องดูว่าแต่ละคนได้ข้อมูลใด เห็นข้อความของใคร และผู้ตัดสินใช้เกณฑ์ตรวจจริงหรือเพียงสรุปความเห็นส่วนใหญ่
เปรียบเทียบสิ่งที่เปลี่ยนและต้นทุนที่ต้องวัด
| แนวทาง | ข้อมูลที่เพิ่ม | สิ่งที่ตรวจได้ | ข้อจำกัดสำคัญ |
|---|---|---|---|
| Single response/agent | คำตอบหรือการใช้เครื่องมือตามขอบเขตของตัวตั้ง | Calls, prompt, tool results และคำตอบสุดท้าย | ตัวตั้งที่งบหรือเครื่องมือต่างกันทำให้เปรียบเทียบผิด |
| Self-Consistency | หลาย samples และการกระจายของ final answers | Sampling configuration, answer parser, aggregation | Shared model/data bias ยังอยู่; samples ไม่ใช่ independent expertise |
| Multi-Agent Voting | หลายคำตอบก่อนอ่านกัน แล้วรวมด้วยกฎที่ระบุ | คำตอบเริ่มต้น ตัวตนต้นทาง การ normalize และผลโหวต | คำตอบต่างอาจเกิดจาก noise; ข้อมูลร่วมทำให้ผิดร่วมกัน |
| Multi-Agent Debate | ข้อความเพื่อนหรือหลักฐานใหม่ในรอบต่อไป | Message graph, round snapshots, การแก้คำตอบ | Conformity, context growth, คำตอบถูกถูกกลบ และต้นทุนเพิ่ม |

ในงาน Debate or Vote ที่ NeurIPS 2025 ผู้วิจัยแยกผลโหวตก่อนคุยออกจากผลหลัง debate และพบว่า voting อธิบายประโยชน์ส่วนใหญ่ในหลายเงื่อนไขที่ศึกษา ไม่ได้แปลว่า debate ไม่มีประโยชน์ในทุกระบบ การทดลองหลักมีทีม 5 ตัว ใช้ Qwen2.5-7B-Instruct และ Llama3.1-8B-Instruct กับ simultaneous-talk protocol จึงต้องเทียบกับงานอื่นตามขอบเขต Conference paper และ code
paper นี้ยังมีทฤษฎีการอัปเดตความเชื่อแบบ stochastic ภายใต้สมมติฐานเฉพาะ การคงอยู่ของค่าเฉลี่ยในแบบจำลองนั้นไม่ใช่บทพิสูจน์ว่าการสนทนาของ LLM ทุกชนิดเพิ่มความถูกต้องไม่ได้ หากเพิ่มหลักฐานที่สัมพันธ์กับคำตอบจริง กลไกก็เปลี่ยนไป ต้องประเมินใหม่
Majority ถูกต้องเท่าไร เมื่อข้อผิดพลาดเป็นอิสระจริง
เริ่มจากโจทย์จำลองที่มีคำตอบถูกหนึ่งในสองค่า ใช้ผู้โหวตจำนวนคี่ N ทุกตัวมีโอกาสถูก p เท่ากัน และ ตัวแปรว่าถูกหรือผิดเป็นอิสระ กำหนด B(N,p) เป็นโอกาสที่เสียงส่วนใหญ่ถูก จะได้ผลรวมของกรณีที่มีผู้ตอบถูกเกินครึ่ง
B(N,p) = sum over k > N/2:
         choose(N,k) × p^k × (1-p)^(N-k)
k คือจำนวนตัวที่ถูก choose(N,k) คือจำนวนวิธีเลือกตัวที่ถูกจาก N ตัว ส่วน p^k และ (1-p)^(N-k) เป็นโอกาสของรูปแบบนั้น การบวกทุก k ที่เป็นเสียงส่วนใหญ่ให้ความน่าจะเป็นของคำตอบรวม นี่เป็นการคำนวณจากสมมติฐาน ไม่ใช่ benchmark ของ AI
ตัวอย่าง SIMULATION: p = 0.70 และ N = 5 ได้ B = 0.83692 หรือ 83.692% สูงกว่า 70% ของผู้ตอบหนึ่งตัว เมื่อ p ต่ำกว่า 0.5 การเพิ่มเสียงแบบอิสระอาจขยายคำตอบผิด เช่น p = 0.40 และ N = 5 ได้ 0.31744
เงื่อนไข “ดีกว่าครึ่ง” นี้ใช้กับ binary correctness model ของเรา ไม่ควรนำไปตัดสินโจทย์หลายตัวเลือกโดยตรง หากคำตอบผิดกระจายอยู่หลายตัวเลือก คำตอบถูกอาจมีสัดส่วนต่ำกว่า 50% แต่ยังเป็นตัวเลือกที่พบบ่อยที่สุดได้ Plurality คือเลือกตัวเลือกที่มากที่สุด ส่วน Majority ต้องมากกว่าครึ่ง ในระบบหลายตัวเลือกต้องระบุว่าจะทำอะไรเมื่อไม่มี majority หรือเสมอกัน
ทดลองความผิดพลาดร่วมกัน โดยไม่เปลี่ยนความเก่งรายตัว
เพื่อแยกผลของการพึ่งพากัน เราสร้าง แบบจำลอง SIMULATION อีกชุด แต่ละโจทย์มีโอกาส c ที่ทุกตัวใช้ผลถูก/ผิดจากการสุ่มร่วมกันหนึ่งค่า หากไม่เข้ากิ่งนี้ แต่ละตัวสุ่มถูก/ผิดอย่างอิสระด้วย p เดิม
กิ่งผลร่วมกันอาจถูกทั้งหมดหรือผิดทั้งหมด ไม่ได้หมายความว่าเกิดความผิดแน่นอน ทุกตัวจึงยังมีโอกาสถูก p เท่าเดิม สิ่งที่เปลี่ยนคือความสัมพันธ์ของผลข้ามตัว โอกาสที่เสียงส่วนใหญ่ถูกจึงเป็น
A(N,p,c) = (1-c) × B(N,p) + c × pc คือโอกาสเลือกกิ่งผลร่วมกันในตัวสร้างข้อมูลนี้ ไม่ใช่ค่าที่วัดมาจาก LLM จริง เมื่อ c = 0 กลับไปเป็นกรณีอิสระ เมื่อ c = 1 ทุกตัวให้ผลเดียวกันและประโยชน์ของจำนวนเสียงหายไป ความถูกต้องรวมเหลือ p
ใช้ p = 0.70, N = 5, c = 0.80 ได้ A = 0.727384 หรือ 72.7384% ทั้งที่แต่ละตัวยังคง 70% สำหรับ 0 < p < 1 สามารถคำนวณได้ว่า pairwise correlation ของตัวแปรถูก/ผิดเท่ากับ c เฉพาะตัวสร้างข้อมูลนี้ หาก p เป็น 0 หรือ 1 ความแปรปรวนเป็นศูนย์และ correlation ไม่มีนิยาม จึงไม่ใช้สมการนี้เป็นสูตรสากลของระบบ Agent

Interactive: จำนวนเสียง กับข้อมูลอิสระที่เพิ่มขึ้น
หลายเสียงช่วยเมื่อไร?
เปลี่ยนความแม่นยำรายคน p จำนวนเสียง N และโอกาสใช้ผลร่วมกัน c แล้วเทียบค่าทฤษฎีกับการสุ่มจริง 200 ข้อ แบบจำลองนี้สร้างคำตอบไบนารี ไม่มี LLM หรือการสนทนาระหว่าง Agent
เสียงเดียว
p เป็นค่าที่กำหนดให้ทุกเสียง
เสียงส่วนใหญ่แบบอิสระ
B(N,p) เมื่อความถูกต้องแต่ละเสียงเป็นอิสระ
มีโอกาสใช้ผลร่วมกัน
A = (1 − c) B(N,p) + c p
ผลที่สุ่มได้จริง
ยังไม่ได้สุ่ม — ตัวเลขด้านบนเป็นค่าทฤษฎี
ในแขนงผลร่วมกัน เครื่องสุ่มความถูกต้องเพียงครั้งเดียวให้ทุกเสียง จึงอาจเห็นทุกคนผิดพร้อมกัน ส่วนแขนงอิสระสุ่มความถูกต้องแยกกัน c เป็นปุ่มของแบบจำลอง ไม่ใช่ค่าสหสัมพันธ์ที่วัดจาก LLM จริง การสุ่มเพียง 200 ข้ออาจต่างจากค่าทฤษฎี
ปรับ p, N และ c แล้วเปรียบเทียบคำตอบหนึ่งตัว ผล majority แบบอิสระ และผลร่วมกันตามสูตร กดสุ่ม 200 โจทย์เพื่อดูผลที่เกิดจริงจาก seed เดียวกัน และแยกค่าคาดหมายจากสัดส่วนที่สังเกตในรอบจำลอง จำกัดจำนวน 200 ไม่ได้พิสูจน์ว่าค่าประมาณใกล้ค่าจริงทุกครั้ง
ลองสามกรณี: p = 0.70 กับ c = 0; คง p แต่เพิ่ม c; แล้วเปลี่ยน p เป็น 0.40 โดยใช้ c = 0 การทดลองนี้เปลี่ยนสมมติฐานที่เห็นชัด ไม่มี LLM หรือการสร้างบทสนทนา จึงไม่เรียกการโหวตของตัวสร้างข้อมูลว่าเป็นการรัน Multi-Agent Debate จริง
ขอบเขต State: Lab เก็บข้อมูลระหว่างการเล่นในหน้าเดียวกัน การ Reset หรือรีเฟรชล้าง state ไม่มี external database ไม่มี weight update และไม่ได้เรียนรู้ความสามารถของ LLM จากเกม
Architecture: เก็บที่มาของคำตอบ ก่อนรวมเสียง
ผังต่อไปนี้เป็น Conceptual Architecture / HYPOTHESIS สำหรับระบบคำถามที่มีเกณฑ์ตรวจผล ไม่ใช่การทำซ้ำ paper ใดทั้งระบบ ยังไม่มี benchmark ยืนยันสถาปัตยกรรมนี้ และไม่กำหนดให้ทุกระบบต้องมีทุก Module

| Module | Input → Output / Data Structure | จุดตรวจและตัวอย่าง | Failure Mode |
|---|---|---|---|
| Task & Budget Controller | โจทย์/งบ → Task record, call limits, stop rule | บันทึกสิ่งส่งมอบและหน่วยต้นทุนเดียวกัน | สร้างงานต่อโดยไม่จำกัดรอบหรืองบ |
| Evidence Manager | เอกสาร/ผลเครื่องมือ → Evidence records มี source/version/time | แยกสำเนาข้อความออกจากเอกสารต้นทางจริง | คู่มือเก่าชุดเดียวถูกนับเป็นหลายหลักฐาน |
| Private Answer Workers | Task/evidence → Answer records พร้อม run/source IDs | เก็บคำตอบก่อนเห็นเพื่อน ตัวอย่างเลือก label จากเอกสาร | Shared bias ถูกเข้าใจว่า independent expertise |
| Communication Controller | Snapshot รอบก่อน → Messages ตาม topology | ใครเห็นใครและเวลาใด ตรวจว่าไม่มีข้อมูลอนาคต | Leakage, copying หรือส่งคำตอบคนละเวอร์ชัน |
| Normalizer & Aggregator | Answers → Canonical labels, counts, ties | กำหนด parser และกฎ plurality/majority ก่อนทดลอง | รูปคำต่างถูกนับคนละคำตอบ หรือคำตอบต่างถูกรวมผิด |
| Verifier / Escalation | Candidate/evidence → checked, rejected หรือ UNKNOWN | เทียบเอกสาร/รัน test ที่เหมาะสมแล้วอ่านผลจริง | Judge เชื่อเสียงข้างมากโดยไม่มีหลักฐานเพิ่ม |
| Evaluator & Trace Store | ผล/ground truth/cost → Accuracy, coverage, trace | แยก agree rate จาก correctness และต้นทุน | งานที่ abstain ถูกซ่อนจน accuracy ดูสูง |
Memory ของสถาปัตยกรรมนี้เก็บคำตอบและร่องรอยที่เกิดขึ้นจริงเพื่อวิเคราะห์ ไม่จำเป็นต้องปรับน้ำหนัก Context Window เป็นขอบเขตความจุของบริบท Current Context คือข้อมูลที่ใส่จริง ส่วน Retrieved Context คือข้อมูลที่ค้นคืนมาเติมให้ workers ถ้าค้นเอกสารผิดร่วมกัน การมี memory มากไม่ได้แก้ความผิดนั้นเอง
การจัดช่องส่งข้อความช่วยตรวจความสัมพันธ์ของงานได้ตาม บทความช่องสื่อสารทีม Agent แต่ช่องทางกับความถูกต้องเป็นคนละประเด็น Shared World State ควรมี task/version ที่ชัด หาก workers ตอบสถานะโลกคนละเวลา การรวมเสียงอาจรวมคำตอบคนละคำถามโดยไม่รู้ตัว
Operational Flow: วัดคำตอบก่อนและหลังคุยให้แยกกัน
Pseudocode เชิงแนวคิด ต่อไปนี้เสนอการบันทึกการทดลอง ยังไม่ได้เชื่อมรัน LLM หรือระบบ benchmark ต้นฉบับในบทความ
task = freeze_question_and_evaluation_rule()
initial = collect_private_answers(task, budget)
votes_before = normalize_and_aggregate(initial)

if communication_is_enabled_and_budget_remains:
    messages = build_round_snapshot(initial)
    revised = collect_revisions(task, messages, budget)
    votes_after = normalize_and_aggregate(revised)
else:
    votes_after = votes_before

checked = verify_with_allowed_evidence(votes_after, budget)
if evidence_is_insufficient:
    decision = UNKNOWN_or_abstain
else:
    decision = checked

record(decision, ground_truth_when_available,
       calls, tokens, elapsed_time, abstentions)
return decision_with_trace
การ freeze หมายถึงกำหนดโจทย์ เวอร์ชันข้อมูล กฎรวมผล และกฎตรวจรับก่อนเริ่ม ไม่ได้หมายถึงห้ามระบบอ่านข้อมูลใหม่ ข้อมูลใหม่ควรมี provenance และต้องบอกว่ามาจากขั้นใด เพื่อไม่ตีความผลของ retrieval ที่ดีขึ้นว่าเป็นผลจากการ debate เพียงอย่างเดียว
เก็บความถูกต้องของคำตอบรวมก่อนคุยและหลังคุย รวมถึงกรณีที่คำตอบเริ่มถูกแต่ถูกแก้ให้ผิด หากเก็บเฉพาะคำตอบสุดท้าย จะไม่เห็นว่าการคุยช่วยแก้ผิดหรือกลบคำตอบถูกไปมากน้อยเพียงใด
เกมจำลอง: จะซื้อเสียงเพิ่ม หรือซื้อการตรวจหลักฐาน
20 ภารกิจ: ซื้อเสียงเพิ่มหรือซื้อหลักฐาน?
มีงบ 60 หน่วยสมมติ เลือกเสียงเดียว แผง 3 หรือแผง 5 แล้วตัดสินใจหลังเห็นโหวต เป้าหมายคือสะสมคะแนน: ถูก +1 ผิด −2 งดตอบ 0 คำตอบจริงซ่อนจนคุณตัดสินใจ งบนี้ไม่ใช่ต้นทุนเงินจริง โทเคน หรือเวลาใช้งาน LLM
ค่าจะล็อกเมื่อขอเสียงครั้งแรก และปลดล็อกด้วย Reset
ภารกิจ 1
1. ขอเสียงหนึ่งแผง ใช้งบตามจำนวนเสียง
ยังไม่ขอเสียง — คำตอบจริงยังซ่อน
2. รับเสียงส่วนใหญ่ งดตอบ หรือตรวจคำตอบจริง
ปุ่มตรวจใช้ Oracle ที่รู้คำตอบจริงภายในเครื่องจำลอง จึงแก้ข้อนั้นได้แน่นอนเฉพาะเกมนี้ เครื่องมือตรวจของระบบจริงอาจผิดหรือไม่ครอบคลุม ความเห็นเอกฉันท์ไม่รับประกันความถูกต้อง
ผลลัพธ์และขอบเขต
Seed เดิมสร้างโลกและสตรีมความถูกต้องเดิมทุกข้อ ไม่เปลี่ยนตามจำนวนเสียงที่ซื้อ แผง 3 ใช้สามเสียงแรกจากสตรีมเดียวกับแผง 5 เกมไม่มีการเรียนรู้หรือการปรับน้ำหนัก และไม่ใช่ Benchmark ของ AI
บันทึกหลังตัดสินใจ
เกมมี 20 ภารกิจ งบ 60 หน่วยจำลอง เลือกคำตอบหนึ่งตัวราคา 1 หน่วย ทีมสามตัวราคา 3 หรือทีมห้าตัวราคา 5 เมื่อเห็นคะแนนโหวตแล้วเลือกยอมรับ งดตอบ หรือซื้อการเปิด ground truth ของ simulator เพิ่ม 2 หน่วย ผลถูกได้ +1 ผิดเสีย 2 และงดตอบได้ 0 กฎคะแนนและราคาทั้งหมดเป็นสมมติฐานเพื่อเรียนรู้ ไม่ใช่ราคาหรือคุณภาพบริการ AI จริง
การเปิด ground truth ในเกมให้คำตอบถูกตามนิยามของ simulator เป็น oracle ที่สร้างไว้ ไม่ใช่หลักฐานว่าผู้ตรวจ LLM หรือเครื่องมือภายนอกแม่น 100% เกมซ่อนคำตอบจริงก่อนตัดสินใจ จึงทำให้ผู้เล่นเห็นว่าความเห็นพ้องกับต้นทุนการตรวจเป็นคนละข้อมูล
ลองใช้ทีมห้าตัวทุกครั้งแล้วดูว่างบพอครอบคลุม 20 ภารกิจหรือไม่ จากนั้นลองเลือกทีมเล็กและกันงบไว้ตรวจ อย่าสรุปผู้ชนะจาก seed เดียว เป้าหมายคือดู trade-off ระหว่างจำนวนคำตอบ งานที่ส่งได้ ความผิดพลาด และต้นทุนภายใต้กฎที่ระบุ
งานวิจัยใช้ได้จริงตรงไหน และยังไม่รู้อะไร
Self-Consistency สาธิตการใช้ sampling/aggregation กับงานที่ดึง final answer ได้ Debate ของ Du สาธิตการอ่านข้อความจาก peers ในโจทย์ที่ทดลอง ส่วนงาน Debate or Vote เปิด repository ต้นฉบับ ให้ตรวจขั้นทดลอง สิ่งเหล่านี้เป็น implementation ที่ศึกษาได้ แต่บทความไม่ได้อ้างทำซ้ำผลของงานเหล่านั้น
งาน Should we be going MAD? ที่ ICML 2024 ศึกษาหลายกลยุทธ์ debate และพบผลที่ไวต่อการออกแบบ/การตั้งค่า การสื่อสารกับการเห็นพ้องจึงควรมี ablation และ baseline ที่เหมาะสม ไม่สรุปจากบทบาทที่ตั้งชื่อให้ดูแตกต่าง Paper และเอกสารทดลอง · DebateLLM
งาน Why Do Multi-Agent LLM Systems Fail? / MAST ใน NeurIPS 2025 Datasets and Benchmarks เสนอ taxonomy กับ trace dataset สำหรับศึกษาความล้มเหลว การวิเคราะห์ trace ช่วยชี้ปัญหาการประสานและการตรวจผล แต่ไม่ได้ให้ค่า correlation สากลของ Agent ทุกชุด ข้อมูลขนาดใหญ่มีส่วนที่ LLM ช่วย annotation จึงไม่อ้างว่าทุก label ตรวจด้วยมนุษย์แล้ว Conference PDF
ในงานใช้งานจริง เช่น extraction จากเอกสารหรือเลือกการแก้โค้ด หลายคำตอบอาจช่วยให้พบ candidate ที่ต่างกัน แต่การเลือกต้องผูก schema, source span หรือ test result ให้ตรวจได้ ข้อเสนอนี้เป็น ANALYSIS สำหรับนำไปทดลอง ไม่ใช่คำรับรองว่าทุกทีมจะลด hallucination หรือเพิ่มผลสำเร็จ
Failure Modes ที่คะแนนโหวตมักซ่อน
Common Evidence Failure: ทุกตัวอ้างเอกสารหรือ retrieval result ผิดร่วมกัน วิธีตรวจคือบันทึก source/version และลองเปลี่ยนข้อมูลที่เป็นสาเหตุ ไม่เพิ่มจำนวนสำเนาแล้วเรียกว่าหลักฐานใหม่
Conformity: คำตอบถูกของเสียงส่วนน้อยอาจหายหลังอ่านข้อความเพื่อน ต้องเก็บ private round และการเปลี่ยนคำตอบ อย่าใช้ unanimity ที่เพิ่มขึ้นเป็น correctness โดยไม่มี ground truth
Answer Parsing Failure: “ไม่อนุญาต”, “อนุญาตเมื่อได้รับสิทธิ์” และ “อนุญาต” มีเงื่อนไขต่างกัน แม้ embeddings ใกล้กัน Normalizer ที่รวมทั้งหมดเป็น yes ทำให้ผลโหวตผิดโดยที่ workers อาจให้เหตุผลถูก
Budget Mismatch: ทีมใช้ calls/context/tool มากกว่า baseline แล้วรายงาน accuracy สูงกว่าเพียงอย่างเดียว ยังตอบไม่ได้ว่าสถาปัตยกรรมคุ้มกว่าหรือแค่ใช้ compute เพิ่ม ต้องนับ retry และงานล้มเหลวด้วย
Coverage Hiding: ระบบที่งดตอบงานยากอาจมี accuracy เฉพาะงานที่ตอบสูง แต่อาจส่งงานสำเร็จจริงน้อยลง จึงรายงานทั้ง accepted correctness, coverage, error count และต้นทุนต่องานที่ผ่าน ไม่ใช้ตัวเลขเดียวแทนทุกมิติ
Correlated Judge: การเพิ่มผู้ตรวจที่ใช้ข้อมูลผิดชุดเดิมอาจไม่เพิ่มหลักฐาน ให้ตรวจว่า verifier ทำอะไรจริง และแยกการตรวจ schema ออกจากการยืนยันข้อเท็จจริง บทเรียนนี้เชื่อมกับ Reflection Loop และคุณภาพ feedback
วัดความสัมพันธ์ของข้อผิดพลาดอย่างไร
กำหนด error indicator ของแต่ละตัวในชุดคำถามเดียวกัน โดยใช้เกณฑ์ ground truth ที่ตรวจได้ แล้วดูว่า Agent คู่หนึ่งผิดพร้อมกันบ่อยแค่ไหนเทียบกับการคาดจาก error rates รายตัว สามารถคำนวณ covariance/correlation ได้เมื่อมีข้อมูลและความแปรปรวนเพียงพอ แต่ต้องระบุชุดงาน รุ่นโมเดล prompt และการแบ่งกลุ่มความยาก
การสลับชื่อบทบาท เพิ่ม temperature หรือใช้คนละ provider ไม่พิสูจน์ว่า errors เป็นอิสระ อาจเพิ่มความหลากหลายของคำตอบแต่ยังผิดจากข้อมูลหรือรูปแบบโจทย์เดียวกัน ในทางกลับกัน ความเห็นต่างมากก็ไม่ยืนยันว่ามีคำตอบถูกอยู่ในชุด
ต้องแยกการทดลอง “ไม่ให้เห็นคำตอบเพื่อน” ออกจาก “แยกข้อมูลที่ใช้” และ “แยกโมเดล” เพราะแก้ dependency คนละชนิด ควรใช้ seed/run หลายชุดและทดสอบ out-of-distribution ที่เกี่ยวข้อง ผลทั้งหมดต้องอ้างเฉพาะเงื่อนไขที่วัด ไม่ใช้ c ของ Lab เป็นค่าประมาณของทีมจริง
ทิศทางวิจัยและ Practical Takeaways
ประเด็นที่ควรศึกษาคือวิธีรักษาคำตอบส่วนน้อยที่มีหลักฐาน วิธีเลือกส่งข้อความที่เพิ่มข้อมูลมากกว่าคัดลอก และวิธีควบคุมงบเมื่อยังไม่มั่นใจ การเลือก verifier ที่อิงหลักฐานใหม่อาจช่วยได้ แต่ต้องวัดทั้งความแม่นยำของ verifier เองและผลต่อระบบรวม

สำหรับผู้พัฒนา เริ่มด้วยกฎ output/parser และ baseline ที่เหมาะกับงาน เก็บ private answers ก่อน communication แล้วค่อยเพิ่ม debate เป็นตัวแปรแยก รายงานความถูกต้องก่อนและหลังคุย ต้นทุน coverage และเหตุที่ abstain หากยังไม่มีหลักฐานเรื่อง ground truth ให้ระบุ UNKNOWN แทนการเปลี่ยนความเห็นพ้องเป็นข้อเท็จจริง
หลักที่ใช้ได้ทันทีคือบันทึกว่า “ใครรู้อะไรจากแหล่งใด เมื่อใด” เพิ่มไปพร้อมกับ “ใครตอบอะไร” สิ่งนี้ทำให้ความผิดร่วมกันมีร่องรอยให้ตรวจ และช่วยประเมินว่าการเพิ่ม Agent ให้คุณค่าใหม่หรือเพียงเพิ่มข้อความที่เห็นพ้องกัน
FAQ
Agent เห็นตรงกันห้าตัว แปลว่าคำตอบแม่นห้าเท่าหรือไม่
ไม่ใช่ ต้องดูความถูกต้องรายตัว ความสัมพันธ์ของ errors หลักฐาน และกฎรวมผล จำนวนเสียงไม่ใช่ตัวคูณ accuracy
ใช้โมเดลคนละบริษัทแล้วถือว่าเป็นอิสระได้หรือไม่
ไม่ได้ยืนยันด้วยชื่อ provider ต้องตรวจจากผลบนชุดงานและข้อมูลที่ใช้ร่วมกัน รุ่นต่างกันยังอาจมี blind spots ร่วมกันได้
Self-Consistency คือ Multi-Agent Debate หรือไม่
เป็นการสุ่มหลาย reasoning paths แล้วรวม final answers ไม่จำเป็นต้องมีการสื่อสารระหว่าง agents จึงต้องแยกประโยชน์ของ sampling กับ debate
Majority กับ Plurality ต่างกันอย่างไร
Majority ต้องเกินครึ่ง ส่วน Plurality เลือกคำตอบที่มากที่สุดแม้ไม่เกินครึ่ง โจทย์หลายตัวเลือกต้องกำหนด tie/no-majority rule
c ใน Lab คือ correlation ที่วัดจาก LLM หรือไม่
เป็นโอกาสเลือก shared-outcome branch ของ simulator การเท่ากับ pairwise correlation ใช้เฉพาะตัวสร้างข้อมูลนี้เมื่อ 0 < p < 1
ปุ่มตรวจ ground truth แปลว่า AI verifier แม่น 100% หรือไม่
เกมเปิดคำตอบที่ simulator สร้างไว้ จึงเป็น oracle เชิงจำลอง ผู้ตรวจจริงต้องประเมินแยกและอาจผิดได้
การโหวตหรือ debate ฝึกน้ำหนักโมเดลหรือไม่
กลไก inference ที่กล่าวถึงและ Lab นี้ไม่มี weight training การเปลี่ยนคำตอบ/บริบทไม่ใช่หลักฐานว่ามี optimizer ปรับโมเดล
References และสถานะหลักฐาน
- Self-Consistency v4, 7 มีนาคม 2023 — camera-ready ของงาน ICLR 2023; อ่านกลไก sampling/answer aggregation ไม่รัน benchmark ต้นฉบับ
- Du et al., Multiagent Debate v1, 23 พฤษภาคม 2023 — งานตีพิมพ์ ICML 2024; รอบนี้อ่าน arXiv snapshot ไม่อ้างอ่าน conference camera-ready ที่ดึงไม่ได้
- Debate or Vote, NeurIPS 2025 — อ่าน conference paper; official code มีให้ตรวจ แต่ไม่ได้รันผลต้นฉบับ
- Smit et al., Should we be going MAD?, ICML 2024 — paper/PMLR metadata; กลไกทดลองอ่าน arXiv v3 ไม่ผสม snapshot โดยไม่ระบุ
- MAST, NeurIPS 2025 Datasets and Benchmarks — conference taxonomy/data methodology; repository และ dataset
สถานะข้อกล่าวอ้าง: กลไกจากต้นฉบับเป็น FACT เกี่ยวกับระบบที่ศึกษา ผล performance ที่ผู้วิจัยรายงานเป็น REPORTED CLAIM การเปรียบเทียบเป็น ANALYSIS สถาปัตยกรรมที่เสนอต่อเป็น HYPOTHESIS สูตร/เกมของบทความเป็น SIMULATION การทำซ้ำ native implementations และ independent benchmarks โดย HYBRID MIND ยัง UNKNOWN ไม่มีตัวเลข benchmark ใหม่ที่สร้างขึ้น
ใส่ความเห็น