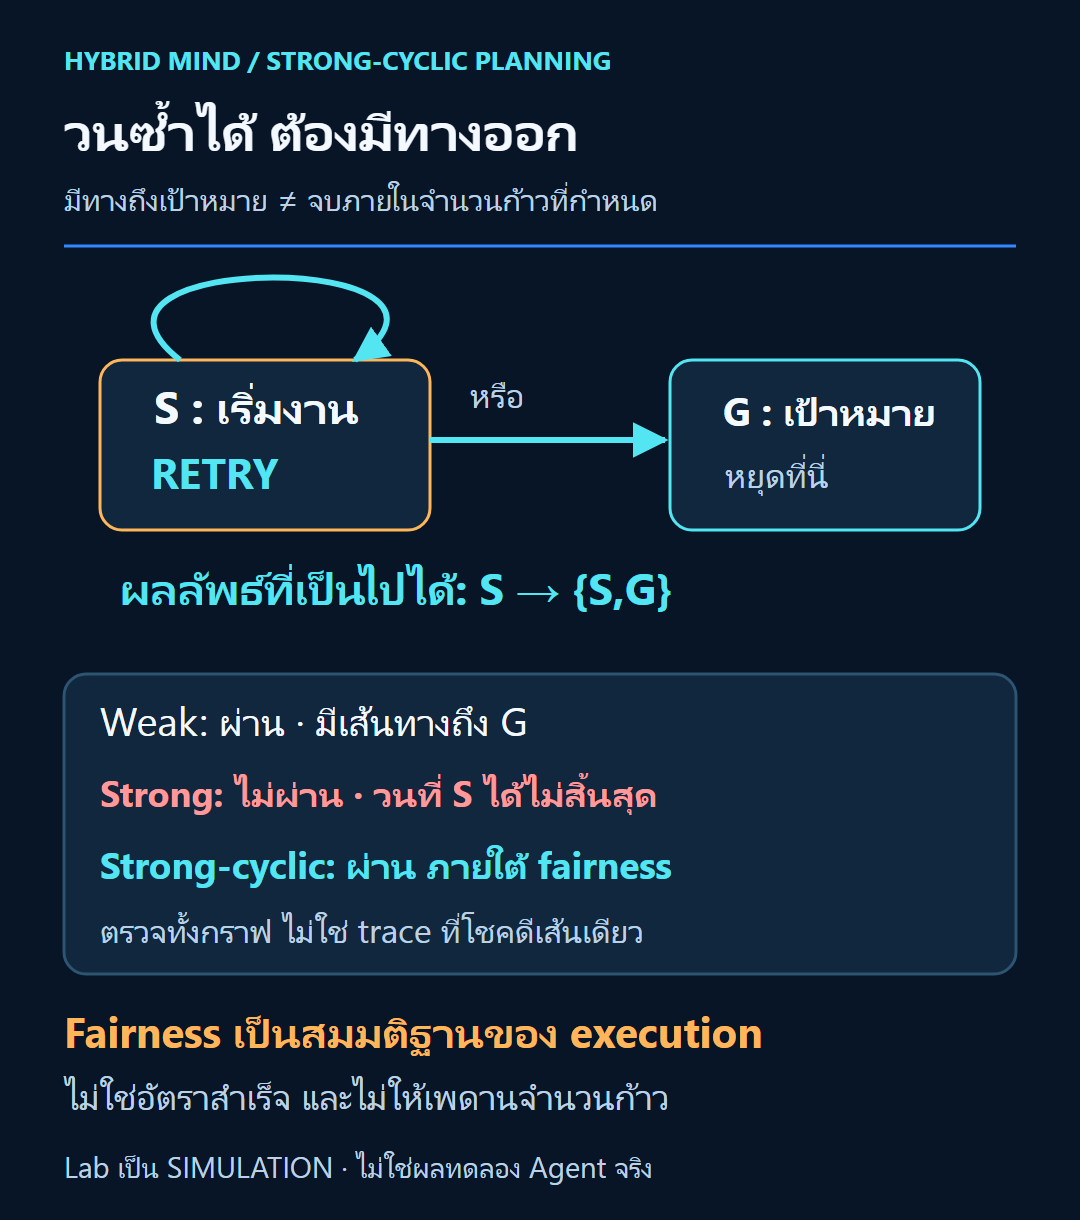

Executive Answer — วงวนไม่เท่ากับความล้มเหลวเสมอไป
Strong planning พิจารณาทุก outcome และรับประกันการถึง goal ภายในขอบเขตจำนวนก้าว Strong-cyclic อนุญาต policy loop หากทุก reachable state ยังมีทางตาม policy ไป goal และสมมติ outcome fairness: เมื่อใช้ action เดิมใน state เดิมไม่สิ้นสุด ทุก outcome ต้องเกิดไม่สิ้นสุด Weak ขอเพียงมีเส้นทางถึง goal จึงไม่รับประกัน execution จริง.
เราจะใช้กราฟเล็ก ๆ ตรวจ policy ที่กำหนดไว้แล้ว ไม่ค้นหา action ใหม่หรือใส่ probability ให้ outcomes แต่ไล่ทุกขอบเพื่อตรวจ missing action, วงวน และทางถึง goal.
Why It Matters — คำว่า retry ไม่ได้แปลว่ารับประกัน
สมมติ action RETRY จากสถานะ S อาจกลับมาที่ S หรือไปถึง G ได้ ถ้าเราเลือกผลลัพธ์ที่ดี เราก็มีเส้นทาง S → G นี่เป็น weak plan แต่ยังไม่ใช่ strong plan เพราะธรรมชาติอาจเลือก S → S แล้วเลือกวงเดิมซ้ำได้ไม่จำกัด
Strong-cyclic planning ยอมรับ policy นี้ได้ภายใต้ fairness: หากเราอยู่ S และใช้ RETRY ต่อไปไม่สิ้นสุด ผลลัพธ์ที่ไป G จะต้องปรากฏซ้ำไม่สิ้นสุด การรับประกันจึงเป็นเรื่องของ execution ที่ fair เท่านั้น ไม่ได้หมายความว่าความสำเร็จมีโอกาสครึ่งหนึ่ง ไม่ได้หมายความว่าผลลัพธ์เป็นอิสระต่อกัน และไม่ได้บอกว่าเราต้องลองกี่ครั้งก่อนสำเร็จ หากระบบจริงไม่มีเหตุผลรองรับ fairness ของ action นั้น policy นี้อาจให้ความมั่นใจเกินจริง
คำถามเชิงวิศวกรรมคือเราใส่ outcome ทุกแบบและ dead end ไว้หรือยัง และ fairness ใช้ได้กับระบบจริงไหม การ retry ใน API ยังต้องมี idempotency, receipt, attempt cap, deadline และการตรวจสถานะหลัง timeout; fairness ใช้แทนมาตรการเหล่านี้ไม่ได้.
Scientific Foundations — จากสถานะไปถึง policy graph
FOND (Fully Observable Non-Deterministic planning) สมมติว่า agent รู้สถานะปัจจุบัน แต่ action อาจมีหลายผลลัพธ์ที่เลือกเองไม่ได้และสังเกตสถานะใหม่ได้ หากไม่รู้สถานะจริงและต้องใช้ belief state หรือ observation branches นั่นคือ partial observability ซึ่งเป็นโจทย์คนละแบบ. Muise, McIlraith และ Beck อธิบาย FOND และการจำลองทุก outcome ของ action ไว้ในงาน PRP ปี 2012
ให้ S เป็นสถานะเริ่มต้น G เป็น goal และ π(s) เป็น action ที่ policy เลือกเมื่ออยู่ในสถานะ s สำหรับ action ที่ไม่กำหนดผลลัพธ์แน่นอน เราแทนผลทั้งหมดด้วยเส้นออกจากสถานะนั้น ตัวอย่าง RETRY: S → {S,G} จึงมีขอบ S → S และ S → G พร้อมกัน Policy graph บอกสิ่งที่อาจเกิด ไม่ได้บอกความถี่.
Policy เป็น closed เมื่อมี action ที่ใช้ได้กำหนดไว้สำหรับทุกสถานะที่ policy พาไปถึงซึ่งยังไม่ใช่ goal และตรวจผลลัพธ์ทุกแบบของ action ที่เลือก หากขอบหนึ่งพาไป D แล้ว D ไม่มี action และไม่ใช่ goal policy นั้นปิดไม่ครบ การพิจารณาเฉพาะเส้นทางที่อยากเห็นจะซ่อนความล้มเหลวจากอีก branch หนึ่ง
Weak, strong และ strong-cyclic
FACT (formal definitions): นิยามต่อไปนี้เป็นคุณสมบัติของ policy บน FOND ที่กำหนด ไม่ใช่ผลวัดจากเกมหรือ benchmark.
Weak หมายถึงมี execution อย่างน้อยหนึ่งแบบจากสถานะเริ่มต้นที่ไปถึง goal ได้ Policy อาจไม่กำหนด action ให้ทุกสถานะที่ไปถึงก็ได้ ตัวอย่าง RISK: S → {G,D} มีเส้นทางไป G จึง weak แต่ D เป็น dead end ดังนั้นความสำเร็จบน branch เดียวไม่ใช่การรับประกันทั้ง policy นิยาม weak และ strong-cyclic ใน PRP 2012
Strong ต้องเป็น closed และทุก execution ต้องไปถึง goal โดยไม่มีสถานะที่กลับมาเยี่ยมซ้ำ ในกราฟ policy ที่มีสถานะจำกัดและเลือก action เดียวต่อสถานะ เงื่อนไขตรวจง่ายคือส่วนของกราฟที่ไปถึงได้และยังไม่ใช่ goal ต้องไม่มี cycle และต้องไม่มี dead end ที่ไม่ใช่ goal ถ้าไม่มี cycle เส้นทาง non-goal ทุกเส้นต้องสิ้นสุดใน goal ภายในขอบเขตจำนวนสถานะที่ไปถึงได้
Strong-cyclic ต้อง closed เช่นกัน และทุกสถานะที่ไปถึงได้ต้องมีเส้นทางตาม policy ไปถึง goal แต่กราฟอาจมี cycle ได้ การรับประกันการจบจึงใช้กับ fair executions เท่านั้น ตามนิยาม outcome fairness หากคู่ (สถานะ, action) เดิมเกิดซ้ำไม่สิ้นสุด แต่ละ outcome ที่เป็นไปได้ของคู่นั้นต้องตามมาซ้ำไม่สิ้นสุด FOND-SAT นิยาม trajectory ที่ fair และแยก strong กับ strong-cyclic ไว้ชัดเจน
ดังนั้น strong เป็นกรณีที่เข้มกว่าของ strong-cyclic และ strong-cyclic ที่ closed ย่อมมีเส้นทางถึง goal จึงเป็น weak ด้วย ทั้งสามคำเป็นระดับคุณสมบัติที่ซ้อนกัน ไม่ใช่ป้ายสามชนิดที่เลือกได้อย่างใดอย่างหนึ่งโดยไม่เกี่ยวกัน ถ้าปิด fairness toggle ในตัวสำรวจ ตัวกราฟและผลจำแนก strong-cyclic ไม่เปลี่ยน แต่ระบบจะไม่อ้างการรับประกัน liveness สำหรับ fair runs
Fairness คือสมมติฐานของพฤติกรรม ไม่ใช่สถิติ
Fairness แบบ strong-cyclic พูดถึง outcome ที่จะเกิดใน run อนันต์ ไม่ได้ระบุการแจกแจงความน่าจะเป็น ไม่ได้บอกว่าทุก outcome มีโอกาสเท่ากัน และไม่ได้บอกว่าการลองแต่ละครั้งเป็นอิสระ งาน FOND+ แสดงให้เห็นว่าสมมติฐาน fairness สามารถระบุอย่างชัดแจ้งและผสมหลายแบบได้ จึงไม่ควรซ่อนมันไว้ในคำว่า “ระบบสุ่ม” หรือ “เดี๋ยวก็สำเร็จ” Rodriguez และคณะ, 2022
ในตัวอย่าง RETRY ถ้า outcome S เกิดต่อเนื่อง 20 ครั้ง ร่องรอยจำกัดนี้ยังไม่ละเมิด fairness เพราะข้อกำหนดพิจารณา run อนันต์ ถ้าเกิด S ตลอดไป เราจะเรียก run นั้นว่าไม่ fair ภายใต้สมมติฐานที่กำหนด แต่คนอ่านไม่ควรสรุปว่าการทดลอง 20 รอบพิสูจน์ fairness หรือพิสูจน์ว่าในระบบจริงจะออกจาก loop เสมอ

System Architecture — ตัวตรวจ policy ไม่ใช่ตัวค้นหาแผน
บทความนี้แยกสามส่วนที่มักถูกเรียกรวม ๆ ว่า planner ออกจากกัน ประการแรกคือ domain model: สถานะและ outcomes ที่เป็นไปได้ ประการที่สองคือ policy: action ที่เลือกสำหรับแต่ละสถานะ ประการที่สามคือ policy checker: ตัวตรวจไล่กราฟที่เกิดจาก policy นั้นเพื่อจำแนก weak, strong และ strong-cyclic
ตัวตรวจเริ่มจาก initial state และต่อทุก outcome ของ policy action จากนั้นตรวจ action ที่ขาด, cycle ใน non-goal graph และเส้นทางจากทุก reachable state ไป G มันเช็ก policy ที่มี ไม่ได้ค้น action ทางเลือก.
CONCEPTUAL PSEUDOCODE — แสดงตรรกะโดยย่อ ไม่ใช่ซอร์สโค้ดที่รันหรือทดสอบโดยตรง; ส่วนที่ทดสอบจริงคือตัวตรวจใน Lab
ตรวจ(initial, policy, outcomes, fairness):
  reachable, edges ← สำรวจจาก initial
  สำหรับทุกสถานะที่ไปถึงได้ s:
    ถ้า s เป็น goal: หยุดขยายจาก s
    ถ้า policy ไม่มี action ที่ใช้ได้ใน s: ปิดไม่ครบ
    มิฉะนั้นเพิ่มขอบทุก outcome ของ action นั้น

  weak ← มีเส้นทางจาก initial ถึง goal
  strong ← ปิดครบ และ reachable non-goal graph ไม่มี cycle
  cyclicCandidate ← ปิดครบ และทุก reachable state มีเส้นทางถึง goal
  guarantee ← strong หรือ (cyclicCandidate และ fairness ถูกสมมติ)
  คืน reachable, edges, deadends, cycle witness,
       weak, strong, cyclicCandidate, guarantee
weak ใช้การมีเส้นทางถึง goal เท่านั้น strong ใช้ closure และการไม่มี cycle ส่วน cyclicCandidate ใช้ closure และการมีทางออกถึง goal จากทุกสถานะที่ไปถึงได้ ค่าของ fairness เปลี่ยนคำอธิบาย guarantee สำหรับ strong-cyclic policy ไม่ได้เปลี่ยนขอบหรือคุณสมบัติของกราฟ การหยุดที่ goal ทำให้เราไม่ขยายผลลัพธ์หลังบรรลุเป้าหมาย ซึ่งถือว่าไม่เกี่ยวกับโจทย์ achievement goal นี้

Operational Flow — ตรวจทุก outcome ก่อนเรียกว่าปลอดภัย
- กำหนด initial state และ goal ให้ชัด ในตัวอย่างนี้เริ่มที่
SและGเป็นสถานะหยุด - เลือก action เดียวที่ policy จะใช้เมื่ออยู่
SและPถ้าเลือกMISSINGหรือไม่มี action ให้บันทึกสถานะที่ policy ไม่ครอบคลุม - เพิ่มขอบจาก action ทุก outcome ที่เป็นไปได้ ไม่เลือกเฉพาะ outcome ที่พาไป goal
- เดินต่อจาก successor ที่ไม่ใช่ goal จนสำรวจครบทุกสถานะที่ไปถึงได้
- ตรวจ closure, dead end, cycle และเส้นทางถึง goal แยกกัน อย่าให้ผล weak กลบความล้มเหลวของ closure
- แสดง strong-cyclic guarantee เฉพาะเมื่อ policy ปิดครบ ทุก reachable state มีทางถึง goal และผู้ใช้ยอมรับ outcome fairness สำหรับ execution จริง
Pseudocode นี้จำแนก policy โดยไม่สร้าง policy หรือจำลอง probability การตรวจใช้เวลาแปรตาม reachable states และ edges; การค้นหา policy เป็นอีกปัญหาที่อาจต้องสำรวจ state space ใหญ่.
Lab — ตัวสำรวจ policy graph แบบจำกัด
ทางที่อาจถึงเป้าหมาย รับประกันว่าจะถึงหรือไม่?
เครื่องมือนี้ตรวจนโยบายคงที่ที่กำหนดไว้หนึ่งชุดในระบบสถานะจำกัดและมองเห็นสถานะครบถ้วน โดยไล่ทุกผลลัพธ์ที่เป็นไปได้ของการกระทำ เป้าหมายเป็นสถานะปลายทาง นี่คือตัวตรวจ ไม่ใช่ตัววางแผนค้นหานโยบาย
ตั้งค่านโยบาย
Fairness หมายถึง หากใช้การกระทำเดิมในสถานะเดิมไม่สิ้นสุด ผลลัพธ์ที่เป็นไปได้แต่ละแบบต้องเกิดซ้ำไม่สิ้นสุด ไม่ได้กำหนดความน่าจะเป็น ความเป็นอิสระ หรือจำนวนรอบสูงสุด
ผลการจำแนก
เส้นเชื่อมที่ตรวจ
สถานะกับการกระทำ
| สถานะ | การกระทำ | ผลลัพธ์ที่เป็นไปได้ | เข้าถึงหรือไม่ |
|---|
ทดลองเดินหนึ่งเส้นทาง
ปุ่มเลือกผลลัพธ์ใช้สำรวจกราฟเท่านั้น ตัวแทนจริงเลือกผลทางกายภาพเองไม่ได้
บันทึกเส้นทางยาวไม่เกิน 20 ก้าวและไม่อาจพิสูจน์ fairness หรือลักษณะนโยบายทั้งหมดจากการเดินครั้งเดียวได้
ตัวอย่างมีสถานะ S, P, G, D และการกระทำตามรายการนี้ ผลลัพธ์ของการกระทำเป็น nondeterministic โดยไม่มีตัวเลขโอกาส
ตัวสำรวจที่แนบมากับบทความใช้สถานะ S, P, G, D และชุด action ที่กำหนดไว้ล่วงหน้า ผู้ใช้กำหนด initial state เลือก action ของ S กับ P และเปิดหรือปิด fairness assumption ได้ ผลที่แสดงประกอบด้วยสถานะที่ไปถึงได้ ขอบที่ policy เปิดไว้ ตารางสถานะ-action-outcome ตัวอย่าง dead end หรือ cycle witness ป้าย weak/strong/strong-cyclic และประโยคอธิบาย guarantee
โครงสร้างข้อมูลใน core ที่ตรวจจริง: สถานะถูกแทนด้วยรหัส S, P, G, D; queue ใช้เป็น worklist และ seen ป้องกันการเพิ่มสถานะซ้ำระหว่างสำรวจ reachable set; edges เก็บคู่ต้นทาง/action/ปลายทาง และ adjacency เก็บ successor IDs สำหรับแต่ละสถานะ. DFS ใช้ stack เพื่อดึง cycle witness; จากนั้นการค้นหาแบบ forward จากแต่ละ reachable state เติมผล canReachGoal. ตารางผลลัพธ์จึงแสดงโครงสร้างและ witnesses ที่มาจาก core ปัจจุบัน.
Fairness toggle เปลี่ยนคำอธิบาย guarantee ไม่เปลี่ยนผลจำแนกกราฟ ร่องรอยทดลองเลือก successor ทีละก้าวและหยุดที่ goal, dead end หรือ 20 transitions จึงพิสูจน์คุณสมบัติของ run อนันต์ไม่ได้; classification มาจากกราฟ policy ที่สำรวจครบ.

Three Approaches — สร้าง policy, ค้น controller หรือเช็กกราฟ
| แนวทาง | ทำอะไร | หลักฐานที่ได้ | ข้อจำกัดที่ควรรู้ |
|---|---|---|---|
| PRP แบบ classical replanning | หาคลาสสิก weak plan ภายใต้ all-outcomes determinization แล้วต่อ policy และตรวจ outcomes ที่ยังไม่ครอบคลุม ใช้ regression เพื่อแทน policy ด้วย partial states | policy สำหรับ FOND ที่อาจกระชับและรับมือ dead ends ผ่านการวางแผนใหม่ | เป็นการค้นหา planner มี heuristic และต้นทุนตาม domain; ไม่ใช่ตัวตรวจกราฟเล็ก ๆ |
| FOND-SAT | เข้ารหัส controller ที่มีจำนวน node จำกัด k เป็น CNF แล้วเพิ่มขนาด controller เมื่อยังไม่พบคำตอบ | แก้โจทย์ policy synthesis ด้วย SAT และมี variation สำหรับ strong กับ dual-FOND | ผลขึ้นกับ encoding, solver และขอบเขต k; การทดลองในปี 2018 ใช้ชุด benchmark และเครื่องตามที่รายงานไว้ ไม่ใช่ผลปัจจุบัน |
| ตัวตรวจกราฟในบทความ | รับ policy หนึ่งชุด ไล่ทุก successor ที่ reachable แล้วตรวจ closure, cycle และ goal reachability | เห็น counterexample ที่ทำให้ policy ไม่ closed, ไม่ strong หรือไม่มีทางถึง goal | ไม่ค้นหา action ใหม่ ไม่เปรียบเทียบคุณภาพหลาย policy และไม่จำลอง probability |
PRP สร้าง policy ทีละส่วน โดยใช้ weak plans จาก all-outcomes determinization และพิจารณาผลลัพธ์ทุกแบบของ action ส่วน FOND-SAT ให้ SAT solver สร้าง bounded controller จาก encoding; ในงานปี 2018 จำนวน controller nodes มีขอบเขต k และ strong-cyclic encoding บังคับให้ reachable node ยังไปถึง goal ได้ Geffner และ Geffner, 2018 REPORTED CLAIM (2018 experiment setup): งานนั้นเทียบ PRP, MyND และ Gamer บน benchmark เดิมและ domain ใหม่ ด้วย AMD Opteron 6300 ที่ 2.4 GHz, limit หนึ่งชั่วโมง/4 GB (Gamer 10 GB) และ MiniSAT เงื่อนไขเหล่านี้เป็นของการทดลองปี 2018 ไม่ใช่การจัดอันดับปัจจุบัน.
Code availability: ผู้เขียนเผยแพร่ source repository ของ PRP และ FOND-SAT ทั้งสองเป็นแหล่งโค้ดของงานวิจัยที่รายงาน ไม่ได้ถูก build หรือรันซ้ำในงานเขียนนี้ สถานะ commit/release ปัจจุบันและค่าใช้จ่าย benchmark ปัจจุบันยังไม่ตรวจยืนยัน จึงไม่กล่าวอ้างผลเทียบเครื่องมือในปัจจุบัน.
REPORTED CLAIM (2012 experiment setup): PRP ปี 2012 ใช้ state relevance, policy regression และ dead-end detection ประเมิน runtime, policy size และ execution บน FOND/probabilistic benchmarks ด้วย Linux desktop 2.5 GHz, limit 30 นาทีและ 2 GB; runtime ไม่รวม preprocessing. Muise et al., 2012 ส่วน MBP งานปี 2003 ใช้ symbolic model checking และ BDD ตาม abstract กับ metadata ที่เข้าถึงได้ แต่หน้า full text ถูกปฏิเสธการเข้าถึงในรอบนี้ จึงไม่ยกผล benchmark, hardware หรือ performance number ของ MBP มาอ้าง Cimatti et al., 2003: abstract/metadata
Applications with Limits — วาง fairness ไว้ตรงที่ผู้ใช้ต้องตัดสินใจ
ANALYSIS: ใช้แนวคิดนี้ทบทวน agent ที่ retry, reconnect หรือรอ outcome โดยถามว่าใส่ทุก outcome/failure state แล้วหรือยัง ทุก reachable state มีทางไปสู่ goal หรือไม่ และต้องอาศัย fairness แบบใด สำหรับ network timeout ต้องแยก “server ไม่ตอบ” จาก “server ไม่ได้ทำงาน” และตรวจ receipt หรือ idempotency ก่อนส่งคำสั่งซ้ำ.
FOND ไม่ระบุ probability และ graph checker ไม่รู้ความหมาย API, transaction หรือ permission การใช้งานจริงต้องยืนยัน outcomes จาก contract/logs และแยกสิ่งที่ fair ได้จาก adversary, crash หรือ rate limit ถ้าสมมติฐานไม่รองรับ ให้เลือก strong policy หรือเพิ่ม recovery/human handoff.
HYPOTHESIS / Conceptual workflow: สำหรับ workflow จริง อาจเริ่มจากสถานะ success, retryable failure, terminal failure, waiting และ reconciliation แล้ววาด outcomes ทั้งหมดก่อนกำหนด policy ถ้า action เป็น write ให้ตรวจ receipt หรือสถานะ operation ก่อน retry พร้อมกำหนด attempt cap และ deadline แนวทางนี้ต้องตรวจด้วยข้อมูลระบบจริง ไม่ใช่ข้อสรุปจาก benchmark FOND.
ในการวิเคราะห์ agent ให้แยกข้อมูลสี่ชั้นด้วย: context window คือข้อความที่โมเดลเห็นในรอบปัจจุบัน; retrieved context คือเอกสารที่ระบบดึงมาแนบ; external memory คือบันทึกที่เก็บข้ามรอบ; weight updates คือการฝึกที่เปลี่ยนพารามิเตอร์โมเดล การบันทึก trace หรือการแก้ prompt ไม่ได้ฝึก weight โดยตัวมันเอง ควร log policy/version, state ID, action และ outcome ที่สังเกตจริงแยกจากข้อความที่ดึงมาและบันทึกภายนอก เพื่อให้ตรวจย้อนว่าอะไรเปลี่ยนพฤติกรรม.
Game — ห้าสถานการณ์สำหรับอ่านกราฟด้วยตัวเอง
คุณแยก “อาจสำเร็จ” ออกจาก “รับประกัน” ได้ไหม?
เลือกภารกิจแล้วปรับ action ของนโยบายให้ตรงโจทย์ ระบบแสดงผลลัพธ์ทุกแบบที่เข้าถึงได้ แฟร์เนสเปลี่ยนเฉพาะการตีความการรับประกัน ไม่เปลี่ยนกราฟหรือคลาส
ภารกิจ
ยังไม่ได้ตรวจคำตอบของภารกิจนี้
คลาสของนโยบาย
กราฟนโยบาย
ทุกภารกิจเป็นแบบจำลองขนาดเล็กที่กำหนดผลลัพธ์ไว้ชัดเจน ไม่มีคะแนนความน่าจะเป็น เกมนี้ตรวจนโยบายที่ให้มา ไม่ได้ค้นหานโยบายแทนผู้เล่น
ใช้ตัวสำรวจตั้ง initial state เป็น S และเปลี่ยน action ของ S หรือ P ตามโจทย์ จากนั้นดูกราฟทั้งหมดก่อนอ่านคำตอบ
- ตั้ง
S = RETRY,P = FINISHแล้วเปิด fairness: มี cycle หรือไม่ และ policy เป็น strong-cyclic candidate หรือไม่? - ใช้
S = RETRYเหมือนเดิม แต่ปิด fairness: ป้ายจำแนกกราฟเปลี่ยนหรือเปลี่ยนเฉพาะ guarantee? - ตั้ง
S = RISK: เพราะเหตุใด weak ยังเป็นจริง ทั้งที่ policy ปิดไม่ครบ? - ตั้ง
S = PREPARE,P = FINISH: นับขอบจาก S ถึง G และบอกเหตุผลที่ policy นี้เป็น strong - ตั้ง
S = PREPARE,P = LOOP: เส้นS ↔ Pมีทางถึง G หรือไม่? การมี cycle อย่างเดียวทำให้เป็น strong-cyclic หรือไม่?
แนวตรวจ: ข้อ 1 มี self-loop และมีทางออกไป G; ถ้า closure ครบและรับ fairness จะเป็น strong-cyclic แต่ไม่ strong ข้อ 2 graph class ไม่เปลี่ยน แต่ไม่อ้าง liveness guarantee จาก fairness ข้อ 3 เส้น S → G ทำให้ weak จริง ส่วน D ทำให้ closure และ strong-cyclic ล้มเหลว ข้อ 4 มีเส้นทาง S → P → G ไม่มี non-goal cycle จึง strong ข้อ 5 เป็น closed cycle แต่ไม่มีทางถึง G จึงไม่ strong-cyclic การไล่ trace ที่สั้นกว่านั้นบอกได้เพียงว่า outcome ที่เลือกเกิดขึ้น ไม่ได้ตัดสิน run อนันต์
Failure Modes — จุดที่ policy checker อาจถูกอ่านเกินจริง
- ดูแต่เส้นทางสำเร็จ: weak เป็นจริงได้ทั้งที่ branch อื่นไป dead end เช่น
RISKหากต้องการ guarantee ต้องตรวจทุก outcome และ closure - เรียกทุกวงวนว่าแข็งแรง: cycle ทำให้ไม่ strong โดยอัตโนมัติ แต่ strong-cyclic ต้องมีทางถึง goal จากทุก reachable stateและต้องระบุ fairness สำหรับ guarantee
- ซ่อน state ที่ policy ไม่ครอบคลุม: missing action เป็น closure failure แม้เส้นทางนั้นจะไม่ได้อยู่ใน happy path
- ตีความ fairness เป็นโอกาส: fairness เป็นข้อจำกัดว่าลำดับ outcome แบบใดนับว่า fair ไม่ใช่ตัวเลข chance หรือเวลารอ
- สรุปจาก trace จำกัด: การเห็น loop ซ้ำ 20 ครั้งไม่พิสูจน์ว่า outcome อื่นไม่มีวันเกิด และการเห็น goal หนึ่งครั้งไม่พิสูจน์ว่า policy ทั้งชุดถูกต้อง
- ใช้ partial observability ปนกัน: ถ้า agent สังเกตสถานะไม่ได้ การเลือก action จากสถานะจริงอาจทำไม่ได้ ต้องแปลงเป็น belief-state หรือเพิ่ม observation model ก่อน
- ใช้ตัวตรวจแทนการวางแผน: checker ตอบว่า policy ที่ป้อนเข้ามาผ่านคุณสมบัติใด ไม่ได้เสนอทางเลือกที่ดีกว่าเมื่อ policy fail
Future Directions — จาก graph check ไปสู่ระบบจริง
ระบบจริงอาจต้องใช้ fairness หลายชุด เช่น action ที่ขับโดย scheduler อาจยุติธรรม ขณะที่ผลจาก network, user หรือ adversary อาจไม่มีข้อรับประกัน FOND+ แสดงกรอบที่เขียน assumptions เหล่านี้อย่างชัดเจนและผสมกันได้ แต่การสร้าง model ที่ซื่อสัตย์ยังต้องอาศัย domain knowledge และ contract Rodriguez et al., 2022
State space ที่ใหญ่ต้องการวิธีค้นหาและแทน policy เช่น controller SAT ใน FOND-SAT, regression/classical planner ใน PRP หรือ BDD ใน MBP (ตาม abstract ปี 2003) ตัวตรวจบทเรียนแคบกว่า: แสดงว่า guarantee มาจาก closure, reachability และ assumption ใด.
Takeaways — สามคำถามก่อนเรียก policy ว่ารับประกัน

- ทุก outcome ถูกเชื่อมต่อหรือยัง? ถ้ามี reachable non-goal state ที่ไม่มี action policy ยังไม่ closed
- มีทางไป goal แบบใด? มีเพียงบางเส้นทางคือ weak; ทุกเส้นทางมี finite bound คือ strong; ทุกสถานะยังมีทางออกและทุก fair run จบคือ strong-cyclic
- Fairness สมเหตุผลกับระบบจริงไหม? ถ้าไม่รู้ว่าทำไม outcome ที่ช่วยให้ progress ต้องเกิดในท้ายที่สุด อย่าใช้ strong-cyclic เป็นคำรับรอง
ดังนั้นการอ่าน policy graph เริ่มจากทุก edge ไม่ใช่เส้นที่ดูดีที่สุด และจบที่สมมติฐานซึ่งทำให้คำว่า “เดี๋ยวก็ถึง” มีความหมาย ตรวจ policy ที่เรามีให้ครบก่อน แล้วค่อยถามว่าระบบจริงทำตาม fairness ที่ใช้พิสูจน์ได้หรือเปล่า
FAQ — คำถามที่มักเกิดหลังเห็นวงวน
1. Weak plan ถือว่าล้มเหลวหรือไม่?
ไม่จำเป็น มันบอกว่ามี execution อย่างน้อยหนึ่งแบบที่ถึง goal แต่ไม่รับรองผลลัพธ์อื่น จึงเหมาะเป็นหลักฐานว่า goal เข้าถึงได้ ไม่ใช่หลักฐานว่า policy ปลอดภัยกับทุก branch
2. Strong-cyclic หมายถึงสุ่มแล้วมีโอกาสสำเร็จสูงหรือไม่?
ไม่ใช่คำกล่าวเรื่องโอกาสหรืออัตราสำเร็จ แต่เป็นคำรับรองสำหรับทุก fair execution ภายใต้โมเดลที่กำหนด ถ้าไม่มี probability distribution เราไม่ควรเพิ่มตัวเลข probability เอง
3. ถ้าเห็น loop ซ้ำหลายครั้ง ยังถือว่า fair ได้ไหม?
ได้สำหรับ trace ที่ยังมีขอบเขต เพราะ fairness จำกัด infinite runs ในตัวอย่าง RETRY การกลับ S หลายครั้งแล้วภายหลังไป G ยังสอดคล้องกับ fairness
4. Strong-cyclic รับประกันจำนวนก้าวสูงสุดหรือไม่?
ไม่รับประกันเสมอไป Strong มีขอบเขตจากกราฟ non-goal ที่ไม่มี cycle แต่ strong-cyclic อนุญาตการวนซ้ำ และความเป็นไปได้ของวงวนอาจยาวได้ตามจำนวนรอบ แม้ทุก fair run จะจบในท้ายที่สุด
5. ถ้า policy มีทางถึง goal จากทุกสถานะ ทำไมต้องมี fairness เพิ่ม?
เพราะความมีอยู่ของทางออกไม่บังคับ outcome ให้เลือกทางออก ลำดับ outcome แบบไม่สิ้นสุดอาจเลือก edge วนซ้ำเสมอ Fairness ตัด run อนันต์ที่หลีกเลี่ยง outcome บางแบบของ action ที่ใช้ซ้ำออกจากชุด run ที่ต้องรับประกัน
6. Lab นี้ค้น policy ที่ดีที่สุดหรือพิสูจน์ fairness ใน production ได้ไหม?
ไม่ได้ มันตรวจกราฟของ policy ที่ตั้งไว้ในตัวอย่างและแสดง trace แบบจำกัดสูงสุด 20 transitions ไม่ค้น action ใหม่ ไม่วัดความน่าจะเป็น และไม่ตรวจระบบ production ผู้ใช้งานต้องยืนยัน domain model และ fairness assumption แยกต่างหาก
References — แหล่งที่ใช้กำหนดขอบเขตคำกล่าว
- Muise, C., McIlraith, S. A., & Beck, J. C. (2012). “Improved Non-Deterministic Planning by Exploiting State Relevance.” Proceedings of ICAPS 2012, 172–180. Full paper. นิยาม weak/strong/strong-cyclic, all-outcomes exploration, PRP method และ evaluation protocol.
- Geffner, T., & Geffner, H. (2018). “Compact Policies for Fully-Observable Non-Deterministic Planning as SAT.” Proceedings of ICAPS 2018, 88–96. Full paper. FOND semantics, fairness, bounded controller SAT encoding, strong variant และ experimental setup.
- Rodriguez, I. D., Bonet, B., Sardina, S., & Geffner, H. (2022). “Flexible FOND Planning with Explicit Fairness Assumptions.” Journal of Artificial Intelligence Research. Full paper. ความหมายของ fairness assumptions และ FOND+.
- Cimatti, A., Pistore, M., Roveri, M., & Traverso, P. (2003). “Weak, strong, and strong cyclic planning via symbolic model checking.” Artificial Intelligence, 147(1–2), 35–84. Publisher abstract and metadata, DOI: 10.1016/S0004-3702(02)00374-000374-0). Full text returned 403 during research; only abstract/metadata were accessed, so no detailed experiment claim is attributed here.
- บทความ Conformant Planning: วางแผนที่ต้องสำเร็จในทุกโลกที่ยังเป็นไปได้ และ Contingent Planning: เมื่อ Agent ต้องวางแผนรองรับทุกการสังเกต ใช้เทียบกับโจทย์ partial observability และ observation branching.
- Agent Retry Budget: คุมค่าใช้จ่ายและ deadline เมื่อเรียกเครื่องมือซ้ำ ใช้เป็นบริบทปฏิบัติการเรื่อง receipt, retry budget และการตรวจสถานะ ไม่ใช่หลักฐานของ FOND fairness.
ใส่ความเห็น