Agent Engineering · Deployment · แบบจำลองการศึกษา · Python 3.12+ · Code NOT RUN / UI UNKNOWN

เดินตัวอย่าง · โค้ดครบชุด · ทดลองกติกา · ฝึกกับ Video Lab
Quick Answer: ปิด Worker ให้มีเส้นตายที่เข้าใจตรงกัน
คำตอบสั้น: เมื่อระบบแจ้งให้ปิด Worker ให้เปลี่ยนจาก ACCEPTING (รับงานใหม่) เป็น DRAINING (ระบายงานที่กำลังทำ) ปฏิเสธการเริ่มงานใหม่ แล้วให้เวลางานที่เริ่มไปแล้วจบภายในงบเวลาคงเหลือ ก่อนเข้าสู่ STOPPED (หยุดรับงานและหยุดรอ) งานที่เลยเส้นตายต้องถูกบันทึกว่า “ยังไม่เสร็จ” ไม่ควรตอบรับหรือกล่าวว่างานสำเร็จเพียงเพราะกำลังจะปิดโปรเซส
ทักษะของบทนี้คือกำหนดงบปิด Worker และเส้นตายที่ไม่เลื่อนเมื่อมีคำขอซ้ำ โดยใช้แบบจำลองนาฬิกาตรรกะ ไม่เชื่อม broker หรือคลัสเตอร์จริง
ผลลัพธ์การเรียนรู้: หลังอ่าน คุณจะสามารถเขียนนโยบายปิด Worker ที่กำหนดเวลา grace รวม เวลาที่ขั้นตอนก่อนหยุดใช้ไป เวลาสำรองสำหรับ cleanup เส้นตายของงาน และเงื่อนไขรายงานงานค้างได้ โดยแยกสิ่งที่ระบบตั้งใจทำออกจากสิ่งที่พิสูจน์ว่าเกิดขึ้นจริง
ทำไมแค่ส่งสัญญาณปิดจึงยังไม่พอ
Worker คือโปรเซสหรือบริการเบื้องหลังที่รับงานจากคิวแล้วประมวลผลต่อเนื่อง เช่น เรียกโมเดล สรุปเอกสาร หรือเตรียมผลลัพธ์ให้ผู้ใช้ เมื่อแพลตฟอร์มต้องย้ายหรือหยุด Worker การปิดทันทีอาจตัดงานกลางทาง ส่วนการรอโดยไม่มีขอบเขตอาจทำให้การหยุดบริการติดค้าง การออกแบบจึงต้องตอบให้ชัดว่าเมื่อเริ่มปิดแล้วงานใหม่เข้ามาได้หรือไม่ งานเดิมมีเวลาต่ออีกเท่าไร และเมื่อถึงเวลาแล้วสถานะใดที่ระบบกล้ายืนยัน
การ “หยุดรับงาน” กับ “งานที่เริ่มแล้วจบ” เป็นคนละการควบคุม บริการเว็บอาจถูกเอาออกจากการส่ง traffic แล้ว แต่ตัวดึงงานจาก message broker (ระบบคิวข้อความ) อาจยัง poll คิวอยู่ หากกลไกรับงานไม่ได้หยุดพร้อมกัน ก็ยังมีโอกาสเริ่มงานใหม่ระหว่างปิด การเชื่อมต่อหรือการส่งสัญญาณจากแพลตฟอร์มจึงไม่ใช่หลักฐานโดยตัวมันเองว่าทุกช่องทางรับงานถูกปิด
เอกสาร Kubernetes อธิบายวงจรยุติ Pod โดยทั่วไปว่าเริ่มส่งสัญญาณ TERM แล้วภายหลังส่ง KILL เมื่อพ้นช่วง grace ที่กำหนด และค่าเริ่มต้น 30 วินาทีไม่ใช่คำแนะนำให้ทุกแอปใช้เท่ากัน จึงต้องออกแบบเวลาของแอปให้สอดคล้องกับเวลาที่แพลตฟอร์มให้จริง เอกสาร Pod Lifecycle ให้รายละเอียดพฤติกรรมนี้ การอ่าน readiness อาจช่วยหยุด traffic บางชนิด แต่ไม่พิสูจน์ว่า poller ภายนอกหยุดอ่านคิวแล้ว
แบ่งงบเวลา: grace รวมไม่ใช่เวลาทำงานทั้งหมด
เริ่มจากกำหนด grace period (ช่วงเวลาผ่อนผันสูงสุด) ที่แพลตฟอร์มยอมให้ปิด จากนั้นหักเวลาที่ขั้นตอนก่อนส่งสัญญาณหยุดใช้ไป และกัน reserve (เวลาสำรอง) สำหรับเก็บสถานะ ปิดการเชื่อมต่อ หรือทำ cleanup สูตรของบทเรียนคือ เวลาทำงานที่เหลือ = max(0, grace รวม − เวลาก่อนเริ่ม drain − เวลาสำรอง) และ work_deadline = เวลาเริ่ม drain + เวลาทำงานที่เหลือ เวลาสำรองไม่ใช่การรับประกันว่า cleanup จะเสร็จ แต่เป็นขอบเขตที่ผู้ออกแบบจัดไว้ไม่ให้เอาเวลาทั้งหมดไปใช้กับงาน
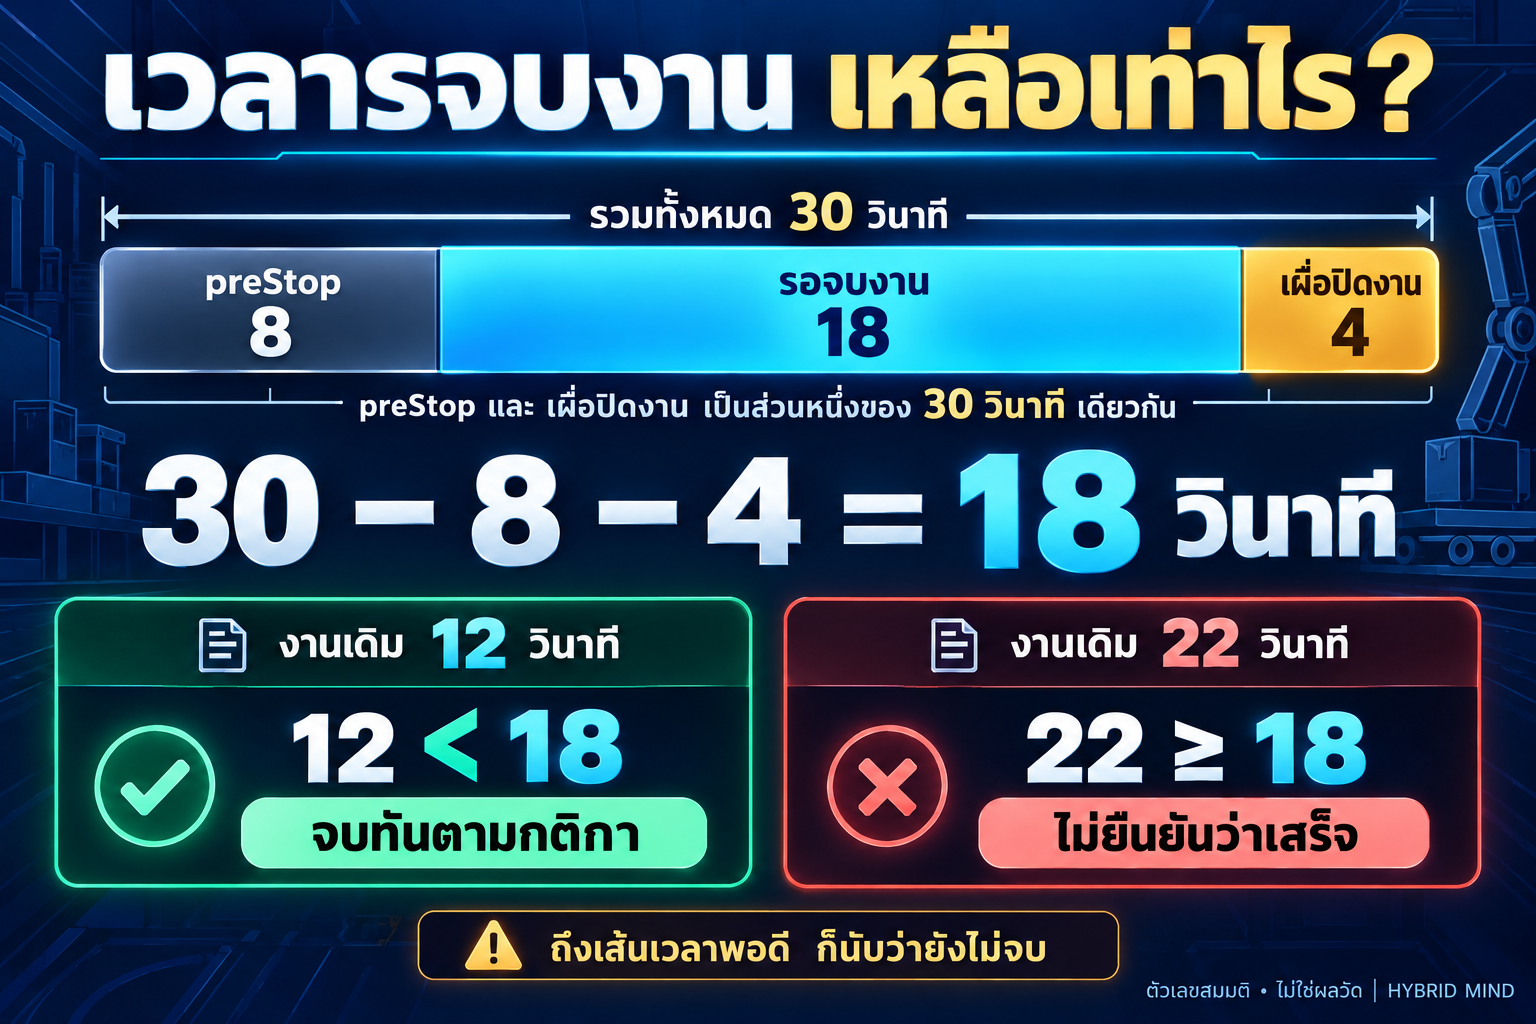
ตัวอย่างจำลอง: มี grace รวม 30 วินาที ขั้นตอน preStop ใช้ไปแล้ว 8 วินาที และกัน cleanup ไว้ 4 วินาที จึงเหลือเวลาทำงานสูงสุด 18 วินาที (30 − 8 − 4) หากงานที่กำลังทำเหลือ 12 วินาที งานนี้อาจจบก่อนเส้นตายได้ ส่วนคิวที่ยังไม่เริ่มหนึ่งงานคงรออยู่ ไม่ได้ถูกแอบนับว่าเสร็จ หากงานเหลือ 22 วินาที มันเกินหน้าต่าง 18 วินาทีและต้องรายงานเป็นงานยังไม่เสร็จเมื่อหมดเวลา
บน Kubernetes คำสั่ง preStop ทำงานก่อนส่ง TERM และเวลาของ hook ถูกนับอยู่ใน grace เดียวกับเวลาที่แอปใช้หยุด ดังนั้นการใช้เวลานานใน hook ไม่ได้เพิ่มเวลาปิดให้แอป เอกสาร Container Lifecycle Hooks ระบุขอบเขตเวลาร่วมนี้ ตัวเลข 30/8/4 เป็นเพียงเลขสาธิต ไม่ได้มาจากค่าแนะนำของระบบหรือการวัดบริการจริง
เมื่องบเหลือศูนย์ ให้ปิด admission (ด่านรับงานใหม่) โดยไม่เติม grace ใหม่เอง คำขอหยุดซ้ำต้องคง deadline เดิม เพื่อไม่ให้การปิดยืดออกไปไม่สิ้นสุด

ใช้สถานะสามช่วงเพื่อแยกการรับงานออกจากการระบายงาน
สถานะเดินไปข้างหน้า: ACCEPTING รับและเริ่มงานได้ → DRAINING ปิดทางรับและเริ่มงานใหม่ แต่ติดตามงาน active (เริ่มแล้ว) → STOPPED หยุดรอ ส่วน pending (รอเริ่ม) คงแยกอยู่ในคิว แบบจำลองเป็น Worker ลำดับเดียว ไม่มี thread หรือ signal handler และติดตามผลจบเฉพาะช่วง drain
ในตัวอย่างเชิงตรรกะ เวลาป้อนเข้าเป็นจำนวนเต็มที่ไม่ลดลง และงาน active มีเวลาที่คาดว่าจะเสร็จ การจบงานจะถือว่าอยู่ในเวลาได้เมื่อเวลาจบ น้อยกว่า work deadline และระบบสังเกตเห็นการจบก่อนเส้นตาย หากเสร็จตรงขอบเขตพอดี ให้จัดเป็นยังไม่เสร็จอย่างระมัดระวัง วิธีนี้ป้องกันการอ้างสำเร็จจากความละเอียดของนาฬิกาหรือจังหวะอ่านสถานะที่ไม่แน่นอน
เมื่อคำขอ drain เข้ามาซ้ำ ให้คง deadline เดิมไว้ คำขอซ้ำอาจถูกบันทึกเป็นเหตุการณ์ซ้ำ แต่ห้ามเลื่อนเส้นตายออกไป การกำหนดค่านี้ช่วยป้องกันการปิดระบบที่ไม่สิ้นสุดจากสัญญาณซ้ำหรือผู้เรียกหลายราย หากมีการขยายเวลาอย่างเป็นทางการในระบบจริง ต้องเป็นนโยบายที่ระบุชัด มีเพดาน และสอดคล้องกับแพลตฟอร์ม ไม่ใช่ผลข้างเคียงจากการเรียกฟังก์ชันซ้ำ


เส้นตายแบบร่วมมือไม่ใช่ hard kill
ตัวอย่างนี้ใช้คำว่า “หยุดรอเมื่อ deadline” ในความหมายของแบบจำลอง ไม่ได้ตัดการทำงานของโค้ดที่ติดค้างจริง งานใน Python อาจกำลังรอ I/O, อยู่ใน native library หรือไม่คืนการควบคุมให้ event loop; การตั้งตัวแปรสถานะเป็น STOPPED ไม่ได้หยุด CPU หรือยุติ thread เหล่านั้น การออกแบบจริงจึงต้องให้แต่ละงานมี timeout ที่เหมาะสม ตรวจ cancellation point และมีขอบเขตการปิดที่แพลตฟอร์มบังคับได้
ใน Python ตัวจัดการ signal จะทำงานบน main thread ณ จุดที่ interpreter ประมวลผลได้ และการเรียกใช้อาจล่าช้าหากโค้ดกำลังทำงานยาวโดยไม่กลับมาที่จุดตรวจ ส่วน SIGKILL บน Unix จับ บล็อก หรือเพิกเฉยไม่ได้ จึงต้องออกแบบ cleanup ให้เสร็จก่อนถึงสัญญาณบังคับ ไม่ถือว่าการมี handler ทำให้ทุกงานถูกหยุดอย่างปลอดภัย เอกสาร Python signal อธิบายข้อจำกัดของ thread และสัญญาณเหล่านี้
concurrent.futures ก็แยกการปิดตัวจัดการงานจากการฆ่างานที่กำลังทำ: shutdown(cancel_futures=True) ยกเลิกงานที่ยังไม่เริ่มได้ แต่ future ที่กำลังรันจะทำต่อ และ wait=False ไม่ใช่ hard kill เอกสาร concurrent.futures จึงรองรับหลักการสำคัญของบทเรียนว่า “ขอให้หยุด” ไม่เท่ากับพิสูจน์ว่า “หยุดแล้ว”
เดินตัวอย่างจากคำขอปิดจนถึงรายงานผล
สมมติ Worker จำลองมีงาน active หนึ่งงานซึ่งเหลือ 12 วินาที และมีงาน pending หนึ่งรายการ เมื่อเริ่มปิดด้วย grace 30 วินาที หลังใช้ preStop ไป 8 วินาทีและกัน cleanup 4 วินาที จะได้หน้าต่างทำงาน 18 วินาที ระบบบันทึกเวลาเริ่ม drain และ deadline คงที่ จากนั้นปิดทาง admission งานใหม่ แต่ยังติดตาม active งานเดิม
ถ้านาฬิกาจำลองสังเกตว่างานเดิมเสร็จที่ 12 วินาทีก่อน deadline งานนั้นจึงถูกบันทึกว่าเสร็จในแบบจำลอง แล้ว Worker เข้าสู่ STOPPED ได้ทันที ส่วน pending หนึ่งรายการยังไม่ถูกประมวลผล การรายงานควรแยก “active สำเร็จ” ออกจาก “pending ไม่ได้เริ่ม” และไม่กล่าวว่าคิวภายนอกได้รับการคืนงาน เพราะ mock ไม่มี broker ให้สังเกต
กรณีเปรียบเทียบ: ถ้างานใช้เวลา 22 วินาที จะพ้นหน้าต่าง 18 วินาที ตัว Worker บันทึก active ว่ายังไม่เสร็จและหยุดรอที่ deadline ตามกฎจำลอง แม้เวลาที่วางแผนไว้จะบอกว่างานเสร็จภายหลัง ก็ไม่เปลี่ยนผลเป็น success หลังจากหยุดรอแล้ว กรณีนี้สอนให้เห็นความแตกต่างระหว่างเวลาคาดการณ์กับหลักฐานที่สังเกตก่อนเส้นตาย


เก็บโค้ดอย่างไรและทดสอบอะไรต่อ
ตัวอย่างด้านล่างใช้ Python 3.12 ขึ้นไปกับ Standard Library เท่านั้น ไม่มี dependencies เพิ่ม ไม่มี environment variables หรือ credentials ไม่ต้องติดตั้งแพ็กเกจ ให้นำไฟล์สองชุดไปบันทึกในโฟลเดอร์เดียวกันก่อนใช้คำสั่งที่ระบุ โค้ดไม่เปิดเครือข่าย ไม่ส่งสัญญาณให้โปรเซสอื่น และไม่สร้างบิล API ค่าใช้จ่ายจริงของ Worker ที่เปลี่ยนเป็น live ต้องประเมินแยกตามระบบปลายทาง
คำสั่งที่ผู้อ่านใช้ภายหลังบันทึกไฟล์: python demo.py และ python -m unittest -v test_graceful_drain.py ทั้งสองคำสั่งยังไม่ได้รันในงานนี้
อ่านตามสามจุด: request_drain คำนวณ deadline ครั้งแรก; start_next ปฏิเสธเริ่มงานเมื่อไม่ใช่ ACCEPTING; tick ตัดสินจากเวลาจบและเวลาที่สังเกต แล้วคืนรายการจบ ค้าง และรอเริ่ม ไม่มีการ ACK หรือบันทึกถาวรจากโค้ดนี้
graceful_drain.py — NOT RUN
"""A deterministic, in-memory model of bounded worker draining (not a broker adapter)."""
from dataclasses import dataclass, field
from enum import Enum


class State(str, Enum):
    ACCEPTING = "ACCEPTING"
    DRAINING = "DRAINING"
    STOPPED = "STOPPED"


@dataclass(frozen=True)
class Job:
    job_id: str
    duration: int


@dataclass
class DrainResult:
    state: State
    deadline: int | None
    admission_open: bool
    finished_ids: list[str] = field(default_factory=list)
    unfinished_active: str | None = None
    pending_ids: list[str] = field(default_factory=list)


class GracefulDrain:
    """Single sequential worker driven by caller-supplied integer logical time."""

    def __init__(self) -> None:
        self.state = State.ACCEPTING
        self.now = 0
        self.queue: list[Job] = []
        self.active: Job | None = None
        self.started_at: int | None = None
        self.deadline: int | None = None
        self.finished: list[str] = []
        self._ids: set[str] = set()

    @staticmethod
    def _integer(name: str, value: int) -> None:
        if isinstance(value, bool) or not isinstance(value, int):
            raise TypeError(f"{name} must be an integer (not bool)")

    def _time(self, now: int) -> None:
        self._integer("now", now)
        if now < self.now:
            raise ValueError("logical clock must be nondecreasing")
        self.now = now

    def submit(self, job_id: str, duration: int, now: int) -> bool:
        self._time(now)
        if not isinstance(job_id, str) or not job_id:
            raise ValueError("job_id must be a nonempty string")
        self._integer("duration", duration)
        if duration <= 0:
            raise ValueError("duration must be positive")
        if job_id in self._ids:
            raise ValueError("job_id must be unique")
        if self.state is not State.ACCEPTING:
            return False
        self._ids.add(job_id)
        self.queue.append(Job(job_id, duration))
        return True

    def start_next(self, now: int) -> str | None:
        self._time(now)
        if self.state is not State.ACCEPTING or self.active is not None or not self.queue:
            return None
        self.active = self.queue.pop(0)
        self.started_at = now
        return self.active.job_id

    def request_drain(self, now: int, total_grace: int,
                      prestop_spent: int = 0, reserve: int = 0) -> DrainResult:
        self._time(now)
        for name, value in (("total_grace", total_grace),
                            ("prestop_spent", prestop_spent), ("reserve", reserve)):
            self._integer(name, value)
            if value < 0:
                raise ValueError(f"{name} must be nonnegative")
        if self.deadline is None:
            self.deadline = now + max(0, total_grace - prestop_spent - reserve)
            if self.state is State.ACCEPTING:
                self.state = State.DRAINING
        # A later request can observe time, but cannot extend the original deadline.
        return self.tick(now)

    def tick(self, now: int) -> DrainResult:
        self._time(now)
        if self.state is State.ACCEPTING:
            return self._result()
        if self.active is not None:
            assert self.started_at is not None and self.deadline is not None
            finish_at = self.started_at + self.active.duration
            # Strict comparison and observation before the deadline are conservative.
            if finish_at < self.deadline and now < self.deadline and now >= finish_at:
                self.finished.append(self.active.job_id)
                self.active = None
                self.started_at = None
        if self.active is None:
            self.state = State.STOPPED
        elif self.deadline is not None and now >= self.deadline:
            self.state = State.STOPPED
        return self._result()

    def _result(self) -> DrainResult:
        return DrainResult(
            state=self.state,
            deadline=self.deadline,
            admission_open=self.state is State.ACCEPTING,
            finished_ids=list(self.finished),
            unfinished_active=self.active.job_id if self.active else None,
            pending_ids=[job.job_id for job in self.queue],
        )
demo.py — NOT RUN
"""Runnable illustration of the bounded drain state machine (MOCK)."""
from graceful_drain import GracefulDrain

worker = GracefulDrain()
worker.submit("A", 12, 0)
worker.submit("B", 1, 0)
worker.start_next(0)
print(worker.request_drain(0, total_grace=30, prestop_spent=8, reserve=4))
print(worker.tick(12))

late = GracefulDrain()
late.submit("A", 22, 0)
late.start_next(0)
late.request_drain(0, total_grace=30, prestop_spent=8, reserve=4)
print(late.tick(18))
test_graceful_drain.py — NOT RUN
import unittest
from graceful_drain import GracefulDrain, State


class GracefulDrainTests(unittest.TestCase):
    def test_budget_subtracts_prestop_and_reserve(self):
        d = GracefulDrain(); d.submit("A", 12, 0); d.start_next(0)
        r = d.request_drain(0, 30, 8, 4)
        self.assertEqual(r.deadline, 18)

    def test_active_finishes_before_deadline_but_pending_stays_queued(self):
        d = GracefulDrain(); d.submit("A", 12, 0); d.submit("B", 1, 0); d.start_next(0)
        r = d.request_drain(0, 30, 8, 4); r = d.tick(12)
        self.assertEqual(r.finished_ids, ["A"])
        self.assertEqual(r.pending_ids, ["B"])
        self.assertEqual(r.state, State.STOPPED)

    def test_exact_finish_boundary_is_conservatively_unfinished(self):
        d = GracefulDrain(); d.submit("A", 18, 0); d.start_next(0)
        d.request_drain(0, 30, 8, 4); r = d.tick(18)
        self.assertEqual(r.unfinished_active, "A"); self.assertEqual(r.state, State.STOPPED)

    def test_late_observation_is_unfinished_even_if_finish_time_was_early(self):
        d = GracefulDrain(); d.submit("A", 12, 0); d.start_next(0)
        d.request_drain(0, 30, 8, 4); r = d.tick(19)
        self.assertEqual(r.unfinished_active, "A"); self.assertEqual(r.finished_ids, [])

    def test_zero_remaining_budget_stops_with_active_unfinished(self):
        d = GracefulDrain(); d.submit("A", 1, 0); d.start_next(0)
        r = d.request_drain(0, 10, 8, 4)
        self.assertEqual(r.deadline, 0); self.assertEqual(r.unfinished_active, "A")

    def test_empty_drain_stops_immediately(self):
        r = GracefulDrain().request_drain(0, 10)
        self.assertEqual(r.state, State.STOPPED); self.assertFalse(r.admission_open)

    def test_admission_and_start_are_closed_during_drain(self):
        d = GracefulDrain(); d.submit("A", 5, 0); d.submit("B", 1, 0); d.start_next(0)
        d.request_drain(0, 10)
        self.assertFalse(d.submit("C", 1, 0)); self.assertIsNone(d.start_next(1))
        self.assertEqual(d.tick(1).pending_ids, ["B"])

    def test_repeated_drain_does_not_extend_deadline(self):
        d = GracefulDrain(); d.submit("A", 12, 0); d.start_next(0)
        first = d.request_drain(0, 30, 8, 4)
        again = d.request_drain(2, 100, 0, 0)
        self.assertEqual(again.deadline, first.deadline)

    def test_stopped_worker_rejects_admission(self):
        d = GracefulDrain(); d.request_drain(0, 0)
        self.assertFalse(d.submit("A", 1, 0))

    def test_input_validation_rejects_bool_and_bad_clock(self):
        d = GracefulDrain()
        with self.assertRaises(TypeError): d.submit("A", True, 0)
        with self.assertRaises(TypeError): d.submit("A", 1, False)
        d.submit("A", 1, 1)
        with self.assertRaises(ValueError): d.tick(0)

    def test_duplicate_ids_are_rejected(self):
        d = GracefulDrain(); d.submit("A", 1, 0)
        with self.assertRaises(ValueError): d.submit("A", 2, 0)

    def test_invalid_id_and_nonpositive_duration(self):
        d = GracefulDrain()
        with self.assertRaises(ValueError): d.submit("", 1, 0)
        with self.assertRaises(ValueError): d.submit("A", 0, 0)


if __name__ == "__main__":
    unittest.main()
Input สาธิต: งาน A ใช้ 12 หน่วยวินาทีตรรกะ งาน B รอเริ่ม ใช้งบ 30/8/4; กรณีเปรียบเทียบเปลี่ยน A เป็น 22 วินาที ผลที่คาดหมาย: deadline 18; ที่เวลา 12 มี finished_ids = [A], pending_ids = [B], state = STOPPED; กรณี 22 ที่เวลา 18 มี unfinished_active = A ผลนี้เป็นความคาดหมายจากแบบจำลอง ไม่ใช่ log ที่รันแล้ว
Testing Status: NOT RUN — คำสั่งและผลที่ระบุเป็นวิธีตรวจและผลที่คาดหมายจากกติกา ไม่ใช่บันทึกที่รันแล้ว การอ่านโค้ดหรือ saved rendering ไม่ยืนยันว่าการควบคุมหน้าเว็บ คีย์บอร์ด อุปกรณ์จริง หรือการหยุดโปรเซสผ่านการทดสอบ
สิ่งที่ต้องตกลงก่อนต่อแบบจำลองเข้ากับระบบจริง
ก่อนเชื่อมระบบจริง ต้องระบุว่าใครเริ่มนับ grace เวลาใด hook ใช้งบส่วนใด และจะปิดตัวดึงงานอย่างไร การเปลี่ยน readiness ของบริการเว็บไม่ยืนยันว่าปิด poller ของ broker แล้ว ส่วนการปิด admission พร้อมกับ claim งานที่เกิดพร้อมกันต้องมีกลไก atomic ซึ่ง mock ลำดับเดียวนี้ยังไม่ได้ทำ
ข้อมูลในตัวอย่างอยู่ในหน่วยความจำ จึงไม่มี persistence หรือคำรับรองการกู้คืน/redelivery ระบบจริงต้องเลือกสัญญาคิว การเก็บผล timeout/cancellation และการตรวจผลภายนอกตาม runtime ที่ใช้ ไม่เพิ่มสิทธิ์เพื่อให้ cleanup ผ่าน และต้องได้รับอนุญาตก่อนเชื่อม Sandbox หรือ Live
Task brief แบบคัดลอกได้
ใช้ brief ต่อไปนี้มอบหมายงานออกแบบนโยบาย shutdown ให้ทีม โดยคงขอบเขตเป็นเอกสารหรือแบบจำลองจนกว่าจะมีสิทธิ์และสภาพแวดล้อมที่ชัดเจน:
เป้าหมาย: ออกแบบ graceful shutdown ของ Agent Worker ที่ปิด admission และให้เวลางาน active จบภายใน deadline คงที่
ข้อมูลและเครื่องมือ: ใช้สัญญาเวลา grace, เวลาที่ preStop ใช้, reserve และรายการงานจำลองที่ผู้มอบหมายให้เท่านั้น
สิทธิ์: อ่านข้อมูลจำลองและเสนอการเปลี่ยน state ได้ ห้ามเรียก broker/API จริง ห้าม deploy หรือแก้ infrastructure
สิ่งส่งมอบ: state machine, สูตรคำนวณ work deadline, ตัวอย่างงานทัน/ไม่ทัน, รายงาน active และ pending พร้อมข้อจำกัด
เกณฑ์ตรวจรับ: deadline ไม่ขยายเมื่อ drain ซ้ำ; งานใหม่ไม่เริ่มหลัง DRAINING; งานเสร็จตรง deadline จัดเป็น unfinished; ไม่มีการอ้างว่ายกเลิกงานจริง
จุดหยุด: หยุดเมื่อกฎและตัวอย่างผ่านการทบทวน หรือเมื่อข้อมูล grace, cleanup, broker semantics หรือสิทธิ์ไม่พอ แล้วระบุคำถามค้าง
ผู้ตรวจรับควรเทียบผลลัพธ์กับหลักฐานของสภาพแวดล้อมที่ระบุ หากไม่มีข้อกำหนดแพลตฟอร์ม ให้รายงานค่าเป็นสมมติฐานแทนการเดาว่าค่าใดเหมาะสม การหยุดเพื่อถามข้อมูลเพิ่มเมื่อไม่มีเวลาปิดหรือ semantics ของ broker เป็นพฤติกรรมที่ถูกต้อง ไม่ใช่ความล้มเหลวของ agent
เกณฑ์ตรวจรับและจุดหยุด
หยุดและส่งให้ผู้รับผิดชอบเมื่อไม่ทราบ grace จริง cleanup อาจเกิน reserve หรือผล action ภายนอกคลุมเครือ อย่าสุ่มรหัสงานใหม่เพื่อส่งซ้ำ และอย่าเปลี่ยน UNKNOWN เป็น PASS จากการออกแบบ การทดสอบโค้ดทั้งหมด NOT RUN; UI จริงยัง UNKNOWN
แบบฝึกหัด: วินิจฉัย deadline ด้วยตัวเลขใหม่
ลองใช้ค่า grace รวม 40 วินาที, preStop ใช้ 10 วินาที, reserve 5 วินาที และ active job ที่เหลือ 25 วินาที พร้อม pending job หนึ่งรายการ คำนวณเวลาทำงานที่เหลือ แล้วตัดสินว่า active job ทันหรือไม่ตามกฎแบบจำลอง ให้เขียนผลสองบรรทัดแยก active กับ pending จากนั้นอธิบายว่าคุณจะรายงานอย่างไรหากมีผู้เรียก drain ซ้ำหลังผ่านไป 3 วินาที
เฉลยสำหรับตรวจตนเอง: หน้าต่างที่เหลือคือ 40 − 10 − 5 = 25 วินาที หากงานคาดว่าจะจบตรงขอบ deadline พอดี กฎของบทเรียนถือว่า unfinished เพราะรับเฉพาะ finish time ที่น้อยกว่า deadline และต้องสังเกตก่อน deadline; pending ยังคงไม่ได้เริ่ม เมื่อ drain ซ้ำหลัง 3 วินาที deadline เดิมยังคงเดิม ไม่คำนวณหน้าต่างใหม่เพื่อยืดเวลา
เกณฑ์ตรวจคำตอบ 5 ข้อ: (1) คำนวณ 25 วินาทีถูกต้อง (2) ระบุว่างานตรงเส้นตายยังไม่ถือว่าเสร็จ (3) แยก pending ออกจาก active (4) ไม่เลื่อน deadline เมื่อ drain ซ้ำ (5) ระบุว่าเป็นผลจำลองและไม่ยืนยันการยกเลิกจริง หากพลาดข้อใด ให้แก้คำอธิบายก่อนนำ brief ไปใช้กับทีม
อ่านต่อ: ปัญหาใกล้เคียงแต่คนละทักษะ
บทเรียน Bulkhead สำหรับ AI Agent เน้นจำกัดคิวและความจุแยกตาม dependency เพื่อไม่ให้งานค้างลาม ส่วนบทเรียนนี้เน้นเวลาสิ้นสุดของ Worker และการหยุดรับงานขณะปิดบริการ แม้ทั้งสองเรื่องแตะคิวและสถานะงาน แต่ไม่ควรสรุปว่าการจำกัดคิวทำให้ shutdown ถูกต้องโดยอัตโนมัติ
Agent Retry Budget พิจารณาว่ายังมีเวลาเท่าใดจึงควรลองเรียกเครื่องมือซ้ำ ขณะที่ graceful shutdown กำหนดจุดเริ่ม drain และเพดานเวลาปิด Worker การประสานกันในระบบจริงต้องกำหนดว่า deadline ของงานและ deadline ปิดบริการสัมพันธ์อย่างไร แต่อย่าผสมตัวอย่างนี้เข้ากับ retry algorithm ที่บทเรียนนี้ไม่ได้ออกแบบ
คำถามที่พบบ่อย
ถ้างานไม่ทัน deadline ควร kill ทันทีไหม? แบบจำลองนี้ไม่ได้ kill งานจริง แต่บันทึกว่ายังไม่เสร็จและหยุดรอตามนโยบาย ระบบจริงต้องพิจารณาว่าแพลตฟอร์มยุติโปรเซสอย่างไร งานมี cancellation point หรือไม่ และผลข้างเคียงภายนอกเกิดไปแล้วหรือยัง
ทำไมไม่ให้ grace 30 วินาทีทุกบริการ? ค่าเริ่มต้นของแพลตฟอร์มไม่ใช่เวลาเหมาะสมของทุก workload ต้องรวมเวลาหยุดรับงาน งานคงค้าง และ cleanup ให้อยู่ในขอบเขตที่แพลตฟอร์มยอมให้ พร้อมใช้ข้อมูลการทำงานจริงของบริการเพื่อกำหนดค่า
งานที่ยังรอในคิวจะหายหรือกลับมาทำใหม่? ตัวอย่างนี้มี pending อยู่ในหน่วยความจำเท่านั้นและไม่มี broker จึงตอบไม่ได้ ระบบจริงต้องอ่าน semantics การยืนยัน การปล่อย lease และการส่งซ้ำจากเอกสารของ broker ที่ใช้ ไม่ควรอ้างว่าจัดการ pending แล้วจากการปิด admission อย่างเดียว
ถ้าได้รับคำขอปิดซ้ำควรทำอย่างไร? คงเส้นตายเดิมและบันทึกเหตุการณ์ซ้ำตามต้องการ การเลื่อน deadline ทุกครั้งทำให้การปิดไม่มีเพดาน ส่วนการขยายเวลาแบบมีผู้อนุมัติต้องเป็นนโยบายแยกที่มีขอบเขตและเข้ากับเวลาที่ runtime อนุญาต
แยก Mock, Sandbox และ Live
| ขอบเขต | สิ่งที่มี | สถานะจริง |
|---|---|---|
| MOCK ของบทความ | Python กับนาฬิกาตรรกะและรายการงานในหน่วยความจำ ไม่มี signal, broker, API หรือผลภายนอก | โค้ดและ tests เขียนไว้ แต่ NOT RUN |
| Sandbox ที่จะทำภายหลัง | เชื่อม broker/worker ทดสอบที่แยกจากจริง วัด admission race, signal forwarding, deadline และการกู้คืน | ยังไม่เชื่อมและยังไม่ทดสอบ |
| Live / Production | ต้องมีสิทธิ์เฉพาะ ข้อมูลถาวร การตรวจผลภายนอก และเงื่อนไข broker ที่พิสูจน์แล้ว | ไม่ได้ deploy และไม่รับรองพร้อมใช้งาน |
Lab เฉพาะเรื่อง: สำรวจสถานะและงบเวลา
ห้องทดลองจำลอง · graceful drain
ปิดรับงานใหม่ แล้วจัดการงานที่กำลังทำ
ลองมองลำดับการปิด worker แบบสามมิติ: ประตูรับงานหยุดก่อน งานที่เริ่มแล้วมีเวลาจำกัด และเมื่อหมดเวลา งานที่ยังไม่เสร็จยังไม่ยืนยันว่าเสร็จ การเลือกสถานการณ์จะเปลี่ยนเส้นทางและคำอธิบายด้านล่าง
๑ · ประตูรับงาน
เปลี่ยนสถานะเป็น DRAINING และปฏิเสธงานเข้าใหม่
๒ · งานที่กำลังทำ
ติดตามเวลาที่เหลือ ไม่สมมติว่าสั่งหยุดแล้วงานจะหายทันที
๓ · ผลลัพธ์
บันทึกว่างานเสร็จหรือยังไม่เสร็จเมื่อถึงเส้นตาย
เลือกสถานการณ์เพื่อดูผลจำลอง
แบบจำลองนี้แสดงแนวคิดเท่านั้น ไม่มี agent, broker, ระบบปฏิบัติการ, การส่งสัญญาณ หรือการยืนยันงานจริง การจำลองไม่รับประกันการกู้คืนหรือการส่งงานซ้ำ
ห้องวางแผนงบเวลา · ตัวเลขสมมติ
เหลือเวลาให้ active work เท่าไร?
ระยะ grace ทั้งหมดคือเวลารวมที่ระบบให้ก่อนบังคับปิด ส่วน preStop คือเวลาที่ hook ใช้ไปก่อน worker ได้รับสัญญาณ และ reserve คือเวลาสำรองสำหรับการปิดอย่างเรียบร้อย กรอกจำนวนวินาทีเป็นจำนวนเต็มไม่ติดลบเพื่อเห็นงบที่เหลือ
สูตร: เวลาที่เหลือ = max(0, grace ทั้งหมด − preStop − เวลาสำรอง) ตัวอย่าง 30 − 8 − 4 = 18 วินาที งานที่ใช้ 12 วินาทีจบก่อนขอบเขตได้ งานที่ใช้เท่ากับ 18 วินาทีถือว่ายังไม่เสร็จตามเกณฑ์จำลองนี้
แถบแบ่งงบเวลา
เวลาพร้อมให้งาน 18 วินาที · ภายใต้สมมติฐานว่าเห็นผลก่อนเส้นตาย งานที่กำลังทำจบได้
งานที่รอเริ่มยังคงค้าง ไม่ได้นำมาหักงบและไม่เริ่มระหว่าง drain ตัวเลขวินาทีเป็นการคำนวณสมมติ ไม่ใช่การพยากรณ์ latency, ค่าใช้จ่าย หรือพฤติกรรมของ Kubernetes/agent ใด
ฝึกกับ Video Lab: หยุดก่อนเริ่มขั้นตอนวิดีโอถัดไป
Video Lab รุ่น active 1.4.0 เป็นแบบจำลองวงจรงานวิดีโอ ใช้สำรวจว่าขั้นใดกำลังทำและขั้นใดยังไม่เริ่ม แล้วนำมาวางนโยบาย drain ข้างนอก Lab นี้ ไม่ได้จำลอง SIGTERM หรือบังคับ deadline ของ Worker ให้เรา และไม่ได้เรียกบริการสร้างวิดีโอจริง
เป้าหมาย: ออกแบบการหยุด Worker ที่กำลังเตรียมรายการตรวจวิดีโอหนึ่งชิ้น
ข้อมูลและเครื่องมือ: ใช้ Video Lab เพื่อสำรวจขั้นงาน และใช้ตัวเลขสมมติจากบทความ; ไม่เรียก LLM/API
ขอบเขตสิทธิ์: ออกแบบและจดสถานะเท่านั้น ไม่สร้าง ส่ง เผยแพร่วิดีโอ หรือแก้ระบบจริง
สิ่งส่งมอบ: ตารางงานที่เริ่มแล้ว งานที่ยังรอ และ deadline ที่หัก preStop กับเวลาเผื่อปิดงานแล้ว
เกณฑ์ตรวจรับ: หลังขอ drain ไม่มีขั้นงานใหม่เริ่ม; ระบุจบเฉพาะงานที่ตรวจพบว่าจบก่อน deadline; แยกสถานะ Worker จากผลภายนอก
จุดหยุด: เมื่อถึง deadline ข้อมูลเวลาไม่ชัด หรือผลบริการภายนอกคลุมเครือ ให้คงสถานะไม่ยืนยันและส่งหลักฐานให้ผู้รับผิดชอบจากคลิปดิบ
สู่จักรวาลคอนเทนต์
ChatGPT ตัดต่อวิดีโอแทนคนได้จริงแค่ไหน? สำรวจระบบ AI Video Editing Agent ผ่านฉากสามมิติที่โต้ตอบได้ พร้อมแยกข้อเท็จจริง สร้างพรอมป์ต์ และจำลองต้นทุนก่อนลงมือทำจริง
ออกแบบระบบตัดต่อในมุมมอง 3D
ลากบนฉากเพื่อหมุนมุมมอง แตะโหนดเพื่อดูหน้าที่ของ AI ในแต่ละขั้นตอน
จัดระเบียบไฟล์ ตรวจคุณภาพภาพและเสียง และกำหนดสิทธิ์เข้าถึงให้ AI Agent
แยกความสามารถจริงจากคำโฆษณา
กดแต่ละประเด็นเพื่ออ่านรายละเอียดและแหล่งข้อมูล
ChatGPT Work เข้าถึงไฟล์ในเครื่องได้ตรวจสอบแล้ว / มีเงื่อนไข+
Astra ใช้โปรแกรมคอมพิวเตอร์ทำงานได้ตรวจสอบแล้ว / ไม่ใช่โปรแกรมตัดต่อในตัว+
ตัดเสร็จใน 5–10 นาทีทุกกรณียังพิสูจน์เป็นเกณฑ์ทั่วไปไม่ได้+
ถูกกว่าจ้างคน 10 เท่าต้องกำหนดต้นทุนให้เทียบกันได้+
หนึ่งไอเดีย สามรูปแบบคอนเทนต์
ปรับรูปแบบวิดีโอ แล้วดูกรอบภาพตัวอย่างและ Prompt เปลี่ยนตามแบบเรียลไทม์
ช่วยตัดต่อ?
พร้อมนำไปใช้กับ AI Agent
ตัวสร้าง Prompt นี้ไม่อัปโหลดคลิป ไม่เรียก API เสียเงิน และไม่ตัดต่อวิดีโอจริง ต้องใช้กับเครื่องมือที่ผู้ใช้อนุญาตภายหลัง
จำลองเวลาและต้นทุนของคุณเอง
เลื่อนตัวเลขเพื่อเปรียบเทียบสถานการณ์สมมติ ไม่ใช่ผล benchmark ที่ยืนยันแล้ว
ตัวเลขเป็นตัวอย่างเพื่อช่วยตัดสินใจ ไม่ใช่ผลประหยัดที่รับประกัน
AI ที่ตัดคลิปเป็น ไม่ได้ทำงานลำพัง
สิ่งที่น่าสนใจของ GPT-6 Astra และ GPT-6.1 Sol ไม่ได้อยู่ที่ว่าตัวโมเดลมีปุ่ม Render MP4 ซ่อนอยู่ แต่คือความสามารถในการจัดการงานหลายขั้นตอนร่วมกับเครื่องมืออื่น: อ่านไฟล์ วางลำดับเรื่อง ใช้แอป ตรวจผลลัพธ์ และแก้งานตามข้อเสนอแนะของมนุษย์
สำหรับคนทำคอนเทนต์ ความต่างสำคัญคือการเปลี่ยนจาก “ส่งคลิปให้ AI แล้วหวังว่าจะได้ผลงาน” ไปเป็น Workflow ที่ตรวจรับได้ทุกขั้น ตั้งแต่การเลือกช่วงเด็ด การสร้างซับ การตรวจคำผิด จนถึงการเรนเดอร์ไฟล์ตามสัดส่วนของแต่ละแพลตฟอร์ม
ข้อควรระวังคือระบบ Work ที่รันบนเว็บหรือมือถือไม่ได้หมายความว่า AI เข้าถึงคลิปบนคอมพิวเตอร์บ้านได้ทันที ต้องทำงานในสภาพแวดล้อมที่เปิดให้เข้าถึงไฟล์จริง มีเครื่องมือตัดต่อ และมีสิทธิ์ใช้งานอย่างชัดเจน
รวบรวมไฟล์ในโฟลเดอร์ที่เข้าถึงได้ ระบุสิทธิ์และข้อจำกัด
ให้ Agent เสนอ Hook, ช่วงตัด และโครงเรื่องก่อนตัดต่อ
ตรวจชื่อเฉพาะ ตัวเลข ภาษาไทย และความถูกต้องของคำกล่าวอ้าง
ตรวจความละเอียด เสียง ระยะเวลา safe zone และคำบรรยาย
ลองเลือกขั้นงานใน Lab แล้วเขียนว่าหากได้รับคำขอหยุดตรงนี้ งานใดควรอยู่ในรายการ in-flight และอะไรต้องรอ ผู้ใช้ต้องเพิ่มขอบเขตสิทธิ์ เกณฑ์ตรวจรับและจุดหยุดจาก brief นี้เองหาก prompt ของ Lab ยังไม่มีครบ เมื่อปุ่มหรือ JavaScript ไม่พร้อม ยังใช้ brief กับภาพสถานะและสูตรในบทความทำแบบฝึกบนกระดาษได้ ค่าเวลาและเงินใน Lab เป็นสมมติฐานที่ผู้ใช้ปรับ ไม่ใช่ผลวัดต้นทุนหรือความเร็วของระบบนี้
แหล่งข้อมูลต้นฉบับและสถานะตรวจ
ตรวจเอกสารต้นฉบับวันที่ 18 ตุลาคม 2026; Python อ้างเอกสารสาย 3.12 ส่วน Kubernetes เป็นเอกสารปัจจุบันที่อ่านในวันตรวจ กลไกการแบ่งงบและกฎ strict deadline ใน mock เป็นการออกแบบของบทความ ไม่ใช่สัญญาจาก Kubernetes
Kubernetes: Pod Lifecycle (TERM, grace period, KILL)
Kubernetes: Container Lifecycle Hooks (preStop อยู่ในงบ grace เดียวกัน)
Python 3.12: signal (main thread, จุดประมวลผล handler, SIGKILL)
ใส่ความเห็น