
ถ้า A* เก็บ frontier และโหนดที่เคยค้นไว้จนหน่วยความจำเริ่มเต็ม เราจะรักษาความสามารถในการหาเส้นทางต้นทุนต่ำโดยเก็บสถานะไว้เพียงเส้นทางที่กำลังสำรวจได้อย่างไร? คำตอบหนึ่งคือ IDA* หรือ Iterative Deepening A*: ทำ depth-first search ซ้ำหลายรอบ แต่จำกัดแต่ละรอบด้วยค่าประเมิน f = g + h แทนการจำกัดด้วยความลึกอย่างเดียว เมื่อกิ่งหนึ่งมีค่า f เกินขอบเขต ระบบจะหยุดขยายกิ่งนั้นและจดค่าที่เกินไว้ ขอบเขตถัดไปคือค่าที่เกินขอบเขตเดิมน้อยที่สุด วิธีนี้ใช้หน่วยความจำตามความลึกของเส้นทางที่กำลังค้น แต่ต้องยอมค้นสถานะเดิมซ้ำในรอบถัดไป
คำตอบสั้น: IDA* เหมาะกับโจทย์ค้นหาเส้นทางที่มีค่าใช้จ่ายและ heuristic แบบไม่ประเมินสูงเกินจริง เมื่อต้องการจำกัดหน่วยความจำให้ใกล้เคียงกับ DFS มันไม่ได้ขยายทุกเส้นทางตามความลึกที่เพิ่มทีละหนึ่ง แต่ทำ DFS ภายใต้งบ f แล้วเพิ่มงบด้วยค่า f ต่ำสุดที่เพิ่งถูกตัดทิ้ง ถ้า heuristic ใช้ได้และเงื่อนไขของโจทย์เหมาะสม คำตอบแรกที่พบจะมีต้นทุนเหมาะที่สุด อย่างไรก็ดี การค้นซ้ำอาจทำให้ช้ากว่า A* โดยเฉพาะเมื่อสถานะซ้ำกันหลายเส้นทาง หรือขอบเขตต้องเพิ่มหลายรอบ
ทำไมต้องค้นซ้ำแทนการเก็บทุกโหนด

อัลกอริทึมค้นหาแบบ best-first เช่น A* เลือกขยายโหนดจาก frontier ตามคะแนน f แล้วเก็บโหนดที่รอค้นและข้อมูลสถานะที่จำเป็นไว้ เพื่อหลีกเลี่ยงการสร้างเส้นทางเดิมซ้ำ โครงสร้างเหล่านี้ช่วยให้ระบบใช้ข้อมูลที่ค้นพบแล้ว แต่จำนวนสถานะที่เก็บอาจเพิ่มขึ้นอย่างรวดเร็วตามขนาดของโจทย์
IDA* แลกหน่วยความจำส่วนนี้กับการทำงานซ้ำ ภายในหนึ่งรอบมันเก็บเส้นทางจากจุดเริ่มถึงโหนดปัจจุบัน และข้อมูลที่จำเป็นสำหรับย้อนกลับ เมื่อจบการค้นรอบนั้น ระบบทิ้งสถานะระหว่างทาง แล้วเริ่ม DFS ใหม่ภายใต้งบ f ที่สูงขึ้น การใช้หน่วยความจำจึงสัมพันธ์กับความลึกของ stack และข้อมูลบนเส้นทาง มากกว่าจำนวนโหนดทั้งหมดที่ค้น
สถาปัตยกรรมของ HMIDA039 ในบทความนี้:
| ขั้น/โมดูล | ข้อมูลเข้า → ผลลัพธ์ | ขอบเขตความรับผิดชอบ |
|---|---|---|
taskFor |
preset หรือ task {nodes, edges, heuristic, start, goal} → task ที่ตรวจและคัดลอกแล้ว |
ตรวจรูปแบบและค่าที่รองรับ ไม่ได้พิสูจน์ admissibility ของ heuristic ที่ผู้ใช้กำหนดเอง |
| ตัวควบคุม threshold | task และ h(start) → ค่า B, nextBound, สถานะรอบ |
เริ่มที่ h(start) และตั้งรอบถัดไปจากค่า cutoff ต่ำสุด |
| DFS frames | node, g, ตำแหน่งลูกถัดไป, active path → expand/cutoff/backtrack/cycle event |
เดินตามลำดับ edge ใน fixture และกันวงจรเฉพาะ active path |
cutoff ledger / validatePath |
ค่า f>B และ edge IDs ของคำตอบ → minimum exceeded / ตรวจเส้นทางกับต้นทุน |
ledger สนับสนุน trace; validator ตรวจความต่อเนื่องถึง goal และต้นทุน ไม่ได้ตรวจว่าโมเดลแทนโลกจริง |
นี่คือ I/O ของตัวอย่างเพื่อการเรียนรู้ ไม่ใช่สัญญาสากลของ planner ทุกตัว และ UI เก็บ event กับ trace ไว้ให้ย้อนดู
ข้อจำกัดของตัวอย่างในบทความ: O(depth) อธิบาย IDA* แบบ DFS ขั้นต่ำที่เก็บเฉพาะเส้นทางและข้อมูลต่อเฟรม ไม่ใช่หน่วยความจำจริงของ interactive lab นี้ ซึ่งเก็บ event, trace และค่า cutoff ไว้แสดงผล peakActivePath นับความยาวเส้นทางที่ active จึงไม่ใช่การวัด RAM ของโปรเซส
FACT: Korf อธิบายแนวคิด depth-first iterative-deepening ว่าเป็นการค้นหาแบบ depth-first ซ้ำโดยเพิ่มขอบเขต และต่อยอดเป็น heuristic search ที่แต่ละรอบถูกจำกัดด้วยต้นทุนสะสม g บวกค่าประเมินส่วนที่เหลือ h เขาระบุว่ารอบถัดไปใช้ค่าต้นทุนต่ำสุดที่เกินขอบเขตเดิม Korf, Artificial Intelligence, 1985, Section 6 บทความฉบับวารสารตีพิมพ์ใน Artificial Intelligence เล่ม 27 ฉบับ 1 หน้า 97–109 เดือนกันยายน 1985 หน้าสำนักพิมพ์
อ่านค่า g, h และ f ให้ถูก
สำหรับโหนด n บนเส้นทางที่กำลังสำรวจ:
g(n)คือต้นทุนจริงที่สะสมจากจุดเริ่มจนถึงnh(n)คือ heuristic ซึ่งประมาณต้นทุนที่ยังเหลือจากnไปยังเป้าหมายf(n) = g(n) + h(n)คือค่าประมาณต้นทุนรวมของเส้นทางที่ผ่านn
คำว่า “ประมาณ” มีเงื่อนไขสำคัญ หากต้องการรับประกันคำตอบต้นทุนต่ำสุด h ต้อง admissible หรือไม่ประเมินต้นทุนที่เหลือสูงกว่าความจริง กล่าวคือ สำหรับทุกสถานะ n, h(n) ต้องไม่เกินต้นทุนจริงต่ำสุดจาก n ไปยังเป้าหมาย และโดยทั่วไปกำหนด h(goal)=0 เมื่อ h เป็น lower bound ค่า f(n) ก็เป็น lower bound ของคำตอบที่อาจผ่านโหนดนั้น
ถ้า f(n) สูงกว่างบปัจจุบัน B เส้นทางผ่าน n ยังไม่ถูกทิ้งตลอดไป แต่ถูกเลื่อนไปยังรอบที่มีงบสูงขึ้น เพราะค่า f ที่ admissible บอกเพียงว่าคำตอบที่ผ่าน n ยังต้องมีต้นทุนอย่างน้อยเท่านี้ ไม่ได้บอกว่าไม่มีคำตอบอยู่
หนึ่งรอบของ IDA* ทำอะไร

เริ่มด้วยขอบเขต B = h(start) จากนั้นทำ depth-first search จากจุดเริ่ม สำหรับแต่ละโหนด คำนวณ f=g+h ถ้า f>B ให้ตัดการขยายโหนดนั้นและบันทึกค่า f ที่เกินไว้ ถ้าโหนดเป็นเป้าหมายและผ่านขอบเขต ให้คืนเส้นทาง ถ้าไม่ใช่เป้าหมายและยังอยู่ในงบ ให้สำรวจลูกทีละตัวตามลำดับที่กำหนด เมื่อ DFS สำรวจทุกกิ่งที่อนุญาตในรอบนั้นแล้ว ให้กำหนดงบใหม่เป็นค่าต่ำสุดของ f ทั้งหมดที่ถูกตัดเพราะเกินงบ
CONCEPTUAL PSEUDOCODE — ไม่ใช่ implementation ของ planner จริง:
bound = h(start)
repeat:
    nextBound = infinity
    result = depthFirst(start, g=0, bound, activePath={start})
    if result is a solution:
        return result
    if nextBound is infinity:
        return no solution
    bound = nextBound

depthFirst(node, g, bound, activePath):
    f = g + h(node)
    if f > bound:
        nextBound = min(nextBound, f)
        return cutoff
    if goal(node):
        return solution
    for each (child, cost) in successors(node):
        if child is not in activePath:
            recurse(child, g + cost, bound, activePath + child)
ตัวแปร nextBound ต้องเก็บค่าต่ำสุดที่เกินงบจากทุกกิ่ง ไม่ใช่ค่าที่เกินจากกิ่งแรกเท่านั้น เมื่อสำรวจครบทั้งรอบ จึงมั่นใจได้ว่าขอบเขตถัดไปเป็นค่าต่ำที่สุดที่ทำให้ส่วนใดส่วนหนึ่งของ frontier ถูกค้นต่อได้ ใน implementation จริงควรส่งค่าต่ำสุดกลับผ่าน recursion หรือเก็บในตัวสะสมอย่างชัดเจน การตั้งงบถัดไปเป็น B+1 อาจถูกต้องในบางกรณีที่ต้นทุนเป็นจำนวนเต็มต่อเนื่องและทุกค่าที่ขาดหายมีความหมาย แต่ทั่วไปอาจทำรอบที่ไม่เพิ่มงาน หรือข้ามค่าที่ควรตรวจได้ จึงใช้ค่า minimum-exceeded ตามนิยาม
ไล่ตัวอย่าง: ทำไมงบเปลี่ยนจาก 3 เป็น 4 แล้วเป็น 5
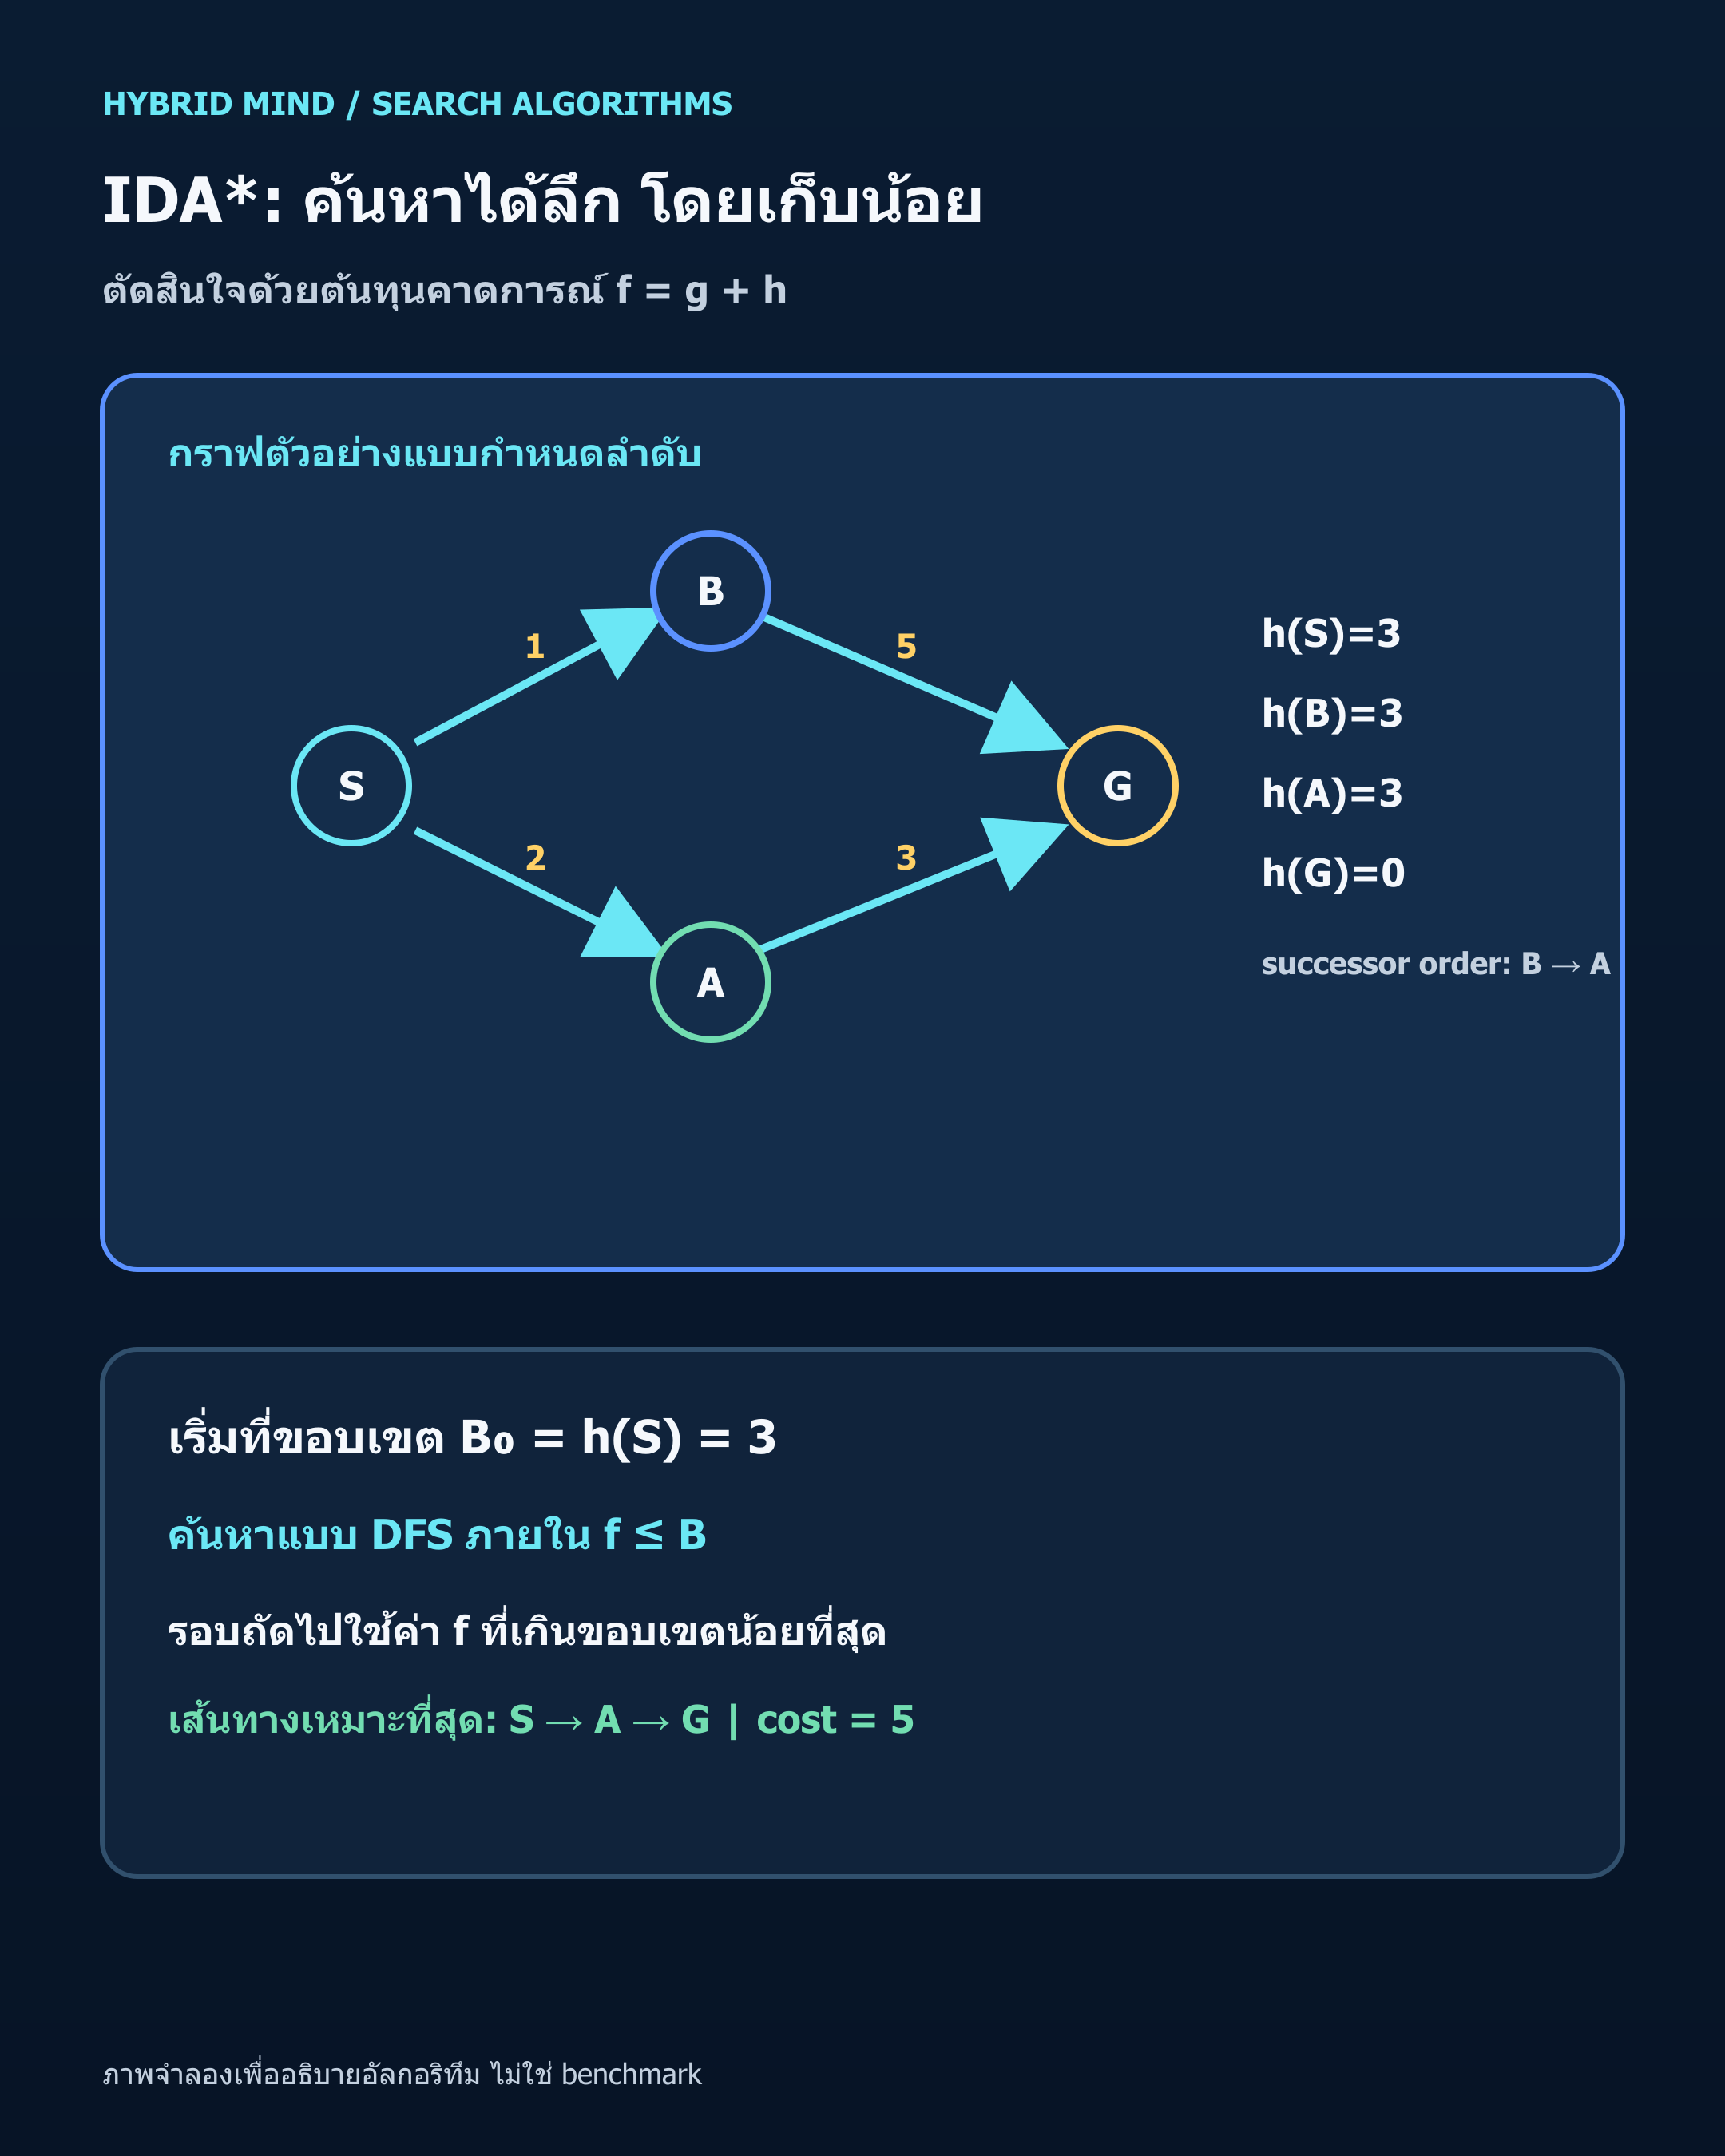
กำหนดกราฟเล็กที่มีจุดเริ่ม S, เป้าหมาย G และทางเลือกสองทาง ตามลำดับการสำรวจให้ไป B ก่อน A:
S --1--> B --5--> G

S --2--> A --3--> G
ต้นทุนจริงของทาง S→B→G คือ 6 ส่วนทาง S→A→G คือ 5 ดังนั้นเส้นทางเหมาะที่สุดมีต้นทุน 5 ใช้ heuristic ดังนี้: h(S)=3, h(B)=3, h(A)=3, h(G)=0 ค่าเหล่านี้ไม่เกินต้นทุนจริงที่เหลือจากแต่ละสถานะ
SIMULATION: รอบแรกเริ่มด้วย B=3 ที่ S ค่า f=0+3=3 จึงขยายได้ ลูก B มี g=1 และ f=1+3=4 ส่วนลูก A มี g=2 และ f=2+3=5 ทั้งคู่เกินงบ ระบบจึงยังไม่ขยายลูก และบันทึกค่าที่เกินคือ 4 กับ 5 ค่าต่ำสุดคือ 4 ทำให้รอบถัดไปใช้ B=4
เมื่อ B=4 ระบบลงไปขยายสถานะ B ได้ แต่เป้าหมายที่ตามมาจาก B มี g=6, h=0, f=6 จึงถูกตัดไว้ก่อน ส่วนทาง A ยังมี f=5 และยังเกินงบ รอบนี้จึงเก็บค่าที่ถูกตัดเป็น 5 กับ 6 และเลือก B=5 เป็นงบถัดไป ในรอบที่สาม เส้นทางผ่าน A มี f=5 จึงค้นต่อจนถึง G และคืนเส้นทางต้นทุน 5
ความจำที่ประหยัดลง แลกกับการขยายซ้ำ
ตัวสำรวจขอบเขต IDA*
ติดตามเหตุการณ์ DFS ทีละขั้น ใช้ค่า f ที่เกินขอบเขตซึ่งน้อยที่สุดเป็นขอบเขตรอบถัดไป
SIMULATION · แบบจำลองเพื่อการเรียนรู้ ตัวสำรวจเก็บลำดับเหตุการณ์ทั้งหมด; ค่าสูงสุดของเส้นทางเป็นตัวนับเชิงอัลกอริทึม ไม่ใช่การวัดหน่วยความจำ.
ตัวสำรวจแบบโต้ตอบด้านบนมีไว้ให้ดูการเปลี่ยนงบและการย้อนกลับของ DFS บนกราฟตัวอย่างขนาดเล็ก โดยแสดงค่าของ g, h, f, ขอบเขตปัจจุบัน และค่าที่จะใช้ในรอบถัดไป เส้นทางที่อยู่บน stack คือข้อมูลที่ต้องใช้เดินหน้าและถอยกลับ ส่วนโหนดที่ผ่านไปในรอบก่อนจะไม่ถูกเก็บเป็น closed list แบบ A* ตัวสำรวจเป็นสื่ออธิบาย ไม่ใช่ตัว planner สำหรับใช้งานจริงหรือการวัดประสิทธิภาพ
ANALYSIS: A* มี frontier ที่เรียงตามคะแนนและโดยทั่วไปเก็บสถานะที่ค้นแล้วเพื่อหลีกเลี่ยงการขยายซ้ำ จึงมักต้องใช้หน่วยความจำตามจำนวนสถานะที่เข้าถึงได้ IDA* เก็บเพียงเส้นทางปัจจุบันและข้อมูล recursion ซึ่งเติบโตตามความลึกของการค้น แต่เมื่อยกงบขึ้น มันอาจต้องคำนวณ g, h และลูกของสถานะที่เคยผ่านแล้วอีกครั้ง ทั้งสองวิธีจึงแก้ปัญหาคนละด้าน: A* ซื้อการหลีกเลี่ยงงานซ้ำด้วยหน่วยความจำ ส่วน IDA* จำกัดหน่วยความจำด้วยการยอมทำงานซ้ำ
อย่าตีความว่า IDA* “เร็วกว่า A*” เสมอ Korf วิเคราะห์ความเหมาะสมเชิง asymptoticภายใต้สมมติฐานเรื่องต้นไม้ค้นหาและรูปแบบการเติบโตของโหนด ไม่ใช่หลักประกันเวลาในทุกกราฟ งานซ้ำอาจมากเมื่อกราฟมีเส้นทางหลายแบบไปยังสถานะเดียว หรือเมื่อ heuristic อ่อนจนมีโหนดจำนวนมากอยู่ใต้ขอบเขตเดิม การเลือกใช้จึงขึ้นกับขนาดหน่วยความจำ โครงสร้างปัญหา คุณภาพของ heuristic และลักษณะการเกิดสถานะซ้ำ
คำว่า memory ในระบบ agent มีหลายชั้น: ContextWindow คือ token ที่อยู่ในคำขอ LLM ปัจจุบัน; RetrievedContext คือรายการภายนอกที่ค้นมาเลือกใส่ในคำขอนั้น; ExternalMemory คือข้อมูลที่บันทึกข้ามคำขอ; ส่วน WeightUpdates คือการเปลี่ยนพารามิเตอร์ที่เรียนรู้ของโมเดล IDA* ใช้ working stack และ trace ชั่วคราว จึงไม่ใช่การอัปเดต weights การบันทึก prompt หรือดึงเอกสารกลับมาก็ไม่เท่ากับ training
IDA* ต่างจาก IDDFS และ A* อย่างไร

| วิธี | ขอบเขตที่ใช้ | จุดเด่น | ต้นทุนที่ต้องยอมรับ |
|---|---|---|---|
| IDDFS | เพิ่มความลึกทีละระดับ | หน่วยความจำต่ำ และค้นพบคำตอบที่มีจำนวนก้าวน้อยสุดเมื่อทุกก้าวมีราคาเท่ากัน | ไม่ใช้ heuristic ที่บอกค่าต้นทุนเหลือ และค้นซ้ำหลายระดับ |
| A* | เลือกขยายโหนดที่มีค่า f ต่ำจาก frontier |
ใช้ข้อมูลเดิมที่เก็บไว้เพื่อลดการค้นซ้ำ และหาเส้นทางต้นทุนต่ำสุดภายใต้เงื่อนไข heuristic | frontier และข้อมูลสถานะอาจใช้หน่วยความจำมาก |
| IDA* | ทำ DFS โดยจำกัด g+h และเพิ่มงบเป็นค่าที่เกินต่ำสุด |
ใช้หน่วยความจำใกล้เคียงเส้นทางปัจจุบัน พร้อมรับประกันต้นทุนเหมาะที่สุดภายใต้เงื่อนไข | อาจสร้างโหนดซ้ำในแต่ละรอบและผ่านเส้นทางซ้ำในกราฟ |
IDDFS เหมาะเมื่อการนับจำนวนก้าวสะท้อนต้นทุนของโจทย์ หรือเมื่อยังไม่มี heuristic ที่ใช้ได้ IDA* มีประโยชน์เมื่อแต่ละ action มีต้นทุนต่างกันและเรามี lower bound ของต้นทุนที่เหลือ A* เหมาะเมื่อการจำสถานะที่ค้นแล้วมีค่ามากกว่าภาระหน่วยความจำ ตารางนี้เป็นการเปรียบเทียบโครงสร้างอัลกอริทึม ไม่ใช่ผล benchmark ของระบบทั้งสามบนชุดข้อมูลเดียวกัน
วงจร ความลึก และเงื่อนไขการหยุด
ใน graph search การใช้เพียง DFS โดยไม่ตรวจวงจรอาจวนตามขอบ S→B→S ไปเรื่อย ๆ หากทุกขอบมีต้นทุนศูนย์หรือ heuristic ไม่ช่วยตัดกิ่ง การจดสถานะที่อยู่บนเส้นทางปัจจุบันแล้วปฏิเสธการกลับไปยังสถานะเดิมช่วยป้องกันวงจรบนเส้นทางนั้นได้ โดยยังคงหน่วยความจำตามความลึก อย่างไรก็ตาม นี่ไม่ใช่ global duplicate detection: สถานะเดียวกันที่ไปถึงได้จากสองเส้นทางต่างกันยังอาจถูกค้นซ้ำ
FACT: Korf เขียนว่าการจำกัดการพิสูจน์ให้อยู่กับ cost function ที่ monotone ทำให้พิสูจน์ง่ายขึ้น แต่ข้อจำกัดนี้ไม่จำเป็น เพราะเขาระบุว่าสามารถพิสูจน์ผลเดียวกันโดยไม่ใช้ข้อจำกัดดังกล่าวได้ แม้พิสูจน์จะซับซ้อนขึ้น และยังอธิบาย pathmax ซึ่งสร้าง monotone cost function จาก admissible function Korf 1985, Section 6 ดังนั้น admissibility ไม่จำเป็นต้องมาพร้อม consistency เสมอเพื่อให้ IDA* คืนคำตอบต้นทุนต่ำสุด
ทฤษฎีบท 6.4 ของ Korf ให้คำกล่าวอ้างเชิง asymptoticที่แคบกว่า: heuristic ต้อง admissible และ monotone มี constant relative error และทฤษฎีบทเปรียบเทียบ search บนต้นไม้กับคลาส admissible best-first searches เท่านั้น ไม่ใช่คำรับรองเวลาสำหรับ graph search ทั่วไป ในกราฟที่มีสถานะซ้ำ IDA* อาจสร้างสถานะเดิมผ่านหลายเส้นทาง แม้จะปฏิเสธวงจรบน active path
การหยุดอย่างมีเหตุผลเกิดได้สองแบบ ถ้าเจอเป้าหมายที่อยู่ในงบรอบนั้น ให้คืนเส้นทาง หาก DFS จบรอบโดยไม่มีโหนดถูกตัดเพราะเกินขอบเขต แปลว่าในพื้นที่ที่ค้นได้ไม่มีเส้นทางที่ยังรอให้เพิ่มงบแล้วไปถึงเป้าหมาย สำหรับกราฟจำกัดที่มี branching จำกัด การป้องกันการวนซ้ำบนเส้นทางทำให้ความลึกของเส้นทางที่พิจารณาถูกจำกัดด้วยจำนวนสถานะ ส่วนต้นไม้อนันต์ต้องมีเงื่อนไขเพิ่ม เช่น ขอบเขต f จำกัดจำนวนโหนดที่เข้าถึงได้ และต้นทุนก้าวมีค่าบวกขั้นต่ำ ห้ามสรุปว่า IDA* จะจบสำหรับทุกพื้นที่ค้นหาอนันต์หรือทุกระบบต้นทุนศูนย์
จากปริศนาสู่การวางแผนของ agent
REPORTED CLAIM: Korf เปรียบเทียบ IDA* กับ A* บน Fifteen Puzzle จำนวน 100 โจทย์สุ่มที่แก้ได้ ใช้ Manhattan distance heuristic และรันบน DEC 2060 เขารายงานว่า IDA* แก้ได้ครบ โดยใช้เวลา median 30 CPU minutes ขณะที่ A* แก้ไม่สำเร็จก่อนหน่วยความจำหมดหลังเก็บโหนดราว 30,000 จุด ผู้เขียนยังระบุว่า IDA* สร้างโหนดมากกว่า แต่เร็วกว่าในชุดทดสอบนี้เพราะต้นทุนต่อโหนดต่ำกว่า Korf 1985, Section 6 ตัวเลขนี้เป็นผลจากอุปกรณ์และซอฟต์แวร์ปี 1985 ไม่ใช่การทำซ้ำของเราและไม่ใช่ค่าคาดการณ์บนฮาร์ดแวร์ปัจจุบัน
ความเชื่อมโยงกับสถาปัตยกรรม agent
IDA* เป็นตัวควบคุมการค้นหาบนแบบจำลอง ไม่ใช่ระบบความจำระยะยาวของ agent ข้อมูลที่ algorithm เก็บระหว่างค้น ได้แก่ stack ของเส้นทาง ต้นทุนสะสม ขอบเขต และค่าต่ำสุดที่เกินขอบเขต สิ่งเหล่านี้เป็น working state ชั่วคราว ไม่ใช่ retrieved memory หรือ external memory ที่ agent ใช้เรียกความรู้จากภายนอก
trace ก็ไม่เท่ากับ reasoning ทั้งหมด มันแสดงว่าสถานะใดถูกขยาย กิ่งใดถูกตัด และขอบเขตเพิ่มอย่างไร แต่ไม่ได้พิสูจน์ว่า heuristic ถูกสร้างเหมาะสม แบบจำลองตรงกับโลกจริง หรือเป้าหมายที่ระบุถูกต้อง การตรวจ trace กับการตรวจโมเดลจึงเป็นคนละงาน
ทดลองดูการเปลี่ยนงบ
เลือกขอบเขต IDA* รอบถัดไป
เริ่มค้นหาให้จบรอบ ตรวจค่า f ที่เกินขอบเขต แล้วเลือกค่าต่ำสุด หากเลือกผิด สถานะการค้นหาจะไม่เปลี่ยน
SIMULATION · แบบจำลองเพื่อการเรียนรู้ เมื่อพบเป้าหมาย ระบบตรวจต้นทุนจากขอบในเส้นทาง ค่านี้ไม่ใช่ผลทดสอบประสิทธิภาพ
เกมจำลองให้ผู้ใช้เลือกหนึ่งในกราฟเล็ก แล้วดูว่าเส้นทางใดผ่านงบปัจจุบันหรือถูกตัดไว้เพื่อรอบต่อไป ชุด threshold-trace ใช้ตัวเลขจากตัวอย่างข้างต้น ชุด cycle เพิ่มขอบ B→S เพื่อแสดงการปฏิเสธโหนดที่อยู่บน active path ชุด unreachable ไม่มีเส้นทางถึงเป้าหมาย และชุด zero-edge มีขอบต้นทุนศูนย์แต่ไม่มีวงจรต้นทุนศูนย์ ส่วนกรณีเริ่มต้นที่เป็นเป้าหมายแสดงว่าเมื่อ h(goal)=0 คำตอบมีต้นทุนศูนย์ทันที
SIMULATION: ผลที่แสดงเป็นการไล่สถานะตามกติกาของกราฟจำลอง ไม่ใช่ benchmark หรือการรับรอง heuristic สำหรับปัญหาจริง
ข้อจำกัดที่ควรจำ
IDA* พึ่งพา g, h, goal test และ transition model ที่ถูกต้อง ถ้า heuristic ประเมินสูงเกินจริง เส้นทางต้นทุนต่ำสุดอาจถูกตัดก่อนถึงเป้าหมาย ต้นทุนติดลบทำลายสมมติฐานการเพิ่ม g และขอบเขต ส่วนสถานะซ้ำจำนวนมากอาจทำให้ค้นซ้ำบ่อย การค้นหาในพื้นที่ไม่จำกัดก็ไม่มีหลักประกันว่าจะจบ
สำหรับต้นทุนทศนิยม ต้องกำหนดความละเอียดและการเปรียบเทียบให้เหมาะกับโจทย์ เพราะ floating point อาจคลาดเคลื่อนจนเปลี่ยนการตัดกิ่ง
IDA* ลดหน่วยความจำของการค้นหา แต่ไม่ได้ซ่อมโมเดลหรือเลือก heuristic ให้อัตโนมัติ และไม่ได้เหนือกว่า A* ทุกโจทย์ การเลือกจึงขึ้นกับว่าหน่วยความจำหรืองานค้นซ้ำเป็นคอขวด
คำถามที่พบบ่อย
IDA* เพิ่มขอบเขตทีละหนึ่งหรือไม่?
ไม่ใช่ในรูปแบบทั่วไป หลังแต่ละรอบจะใช้ค่า f ต่ำสุดที่ถูกตัดเพราะเกินขอบเขต การเพิ่มทีละหนึ่งอาจทำให้เกิดรอบที่ไม่เพิ่มงาน โดยเฉพาะเมื่อต้นทุนไม่ใช่จำนวนเต็มต่อเนื่อง
IDA* รับประกันเส้นทางต้นทุนต่ำสุดหรือไม่?
ภายใต้ heuristic ที่ admissible และสมมติฐานเรื่องต้นทุน/พื้นที่ค้นหาที่ทำให้การค้นจบได้ มันคืนคำตอบต้นทุนต่ำสุดได้เมื่อขอบเขตและการตรวจเป้าหมายใช้ถูกต้อง Korf ให้ผลพิสูจน์พร้อมเงื่อนไข monotone cost function และการวิเคราะห์ tree search ในบทความต้นฉบับ จึงควรระบุเงื่อนไขแทนการอ้างคำรับประกันแบบไม่มีขอบเขต
ทำไมไม่ใช้ A* ทุกครั้ง?
ถ้าหน่วยความจำพอและการหลีกเลี่ยงการขยายซ้ำสำคัญ A* อาจเหมาะกว่า ส่วน IDA* มีประโยชน์เมื่อ frontier ที่ต้องเก็บโตเกินทรัพยากร แต่ต้องยอมสร้างโหนดเดิมซ้ำ การตัดสินใจขึ้นกับกราฟ heuristic และงบหน่วยความจำ ไม่มีกฎว่าอัลกอริทึมหนึ่งชนะทุกโจทย์
การเก็บ active path ป้องกันการค้นซ้ำได้ทั้งหมดไหม?
ไม่ ป้องกันเฉพาะการวนกลับไปยังสถานะเดิมบนเส้นทางปัจจุบัน สถานะเดียวกันที่มาถึงจากคนละเส้นทางยังถูกสำรวจซ้ำได้ การเพิ่ม transposition table อาจลดงานซ้ำ แต่จะใช้หน่วยความจำเพิ่มและทำให้ implementation มีรายละเอียดมากขึ้น
อนาคตและแนวทางประเมิน
การเปรียบเทียบที่ตรวจสอบได้ควรใช้โจทย์ ชุด heuristic ลำดับลูก และเงื่อนไขเป้าหมายเดียวกัน แล้วรายงานจำนวนโหนดที่ขยาย จำนวนรอบ และหน่วยความจำที่วัดจริง แยกผลกราฟที่มีสถานะซ้ำมากออกจากต้นไม้ค้นหา พร้อมตรวจ admissibility แยกจากความเร็ว วิธีนี้ช่วยบอกได้ว่าเวลาเพิ่มเพราะ cutoff หลายรอบหรือเพราะ heuristic อ่อน โดยไม่เหมารวมว่าผลจากกราฟสาธิตเป็น benchmark
สรุปสิ่งที่ควรจำ

- IDA* ใช้ DFS ซ้ำโดยจำกัดค่า
f=g+hไม่ใช่จำกัดความลึกอย่างเดียว - ขอบเขตเริ่มต้นที่
h(start)และรอบต่อไปใช้ค่าfต่ำสุดที่เกินขอบเขตเดิม - Heuristic ต้องไม่ประเมินต้นทุนที่เหลือสูงเกินจริง หากต้องการรับประกันต้นทุนเหมาะที่สุด
- หน่วยความจำใกล้เคียง active path แต่การค้นซ้ำและสถานะซ้ำใน graph อาจเพิ่มเวลา
- การป้องกันวงจรบนเส้นทางไม่ใช่การจดจำทุกสถานะที่เคยพบ
- ไม่มีคำกล่าวอ้างว่า IDA* เร็วกว่า A* ทุกกรณี; เลือกตามข้อจำกัดและโครงสร้างโจทย์
แหล่งอ้างอิง
- Richard E. Korf, “Depth-first iterative-deepening: An optimal admissible tree search,” Artificial Intelligence 27(1), 97–109, September 1985. DOI: 10.1016/0004-3702(85)90084-0. ฉบับเต็ม PDF. ใช้สำหรับนิยาม IDA*, threshold schedule, ข้อพิสูจน์และขอบเขตการทดลอง Fifteen Puzzle.
- Richard E. Korf, “Iterative-Deepening-A*: An Optimal Admissible Tree Search,” Proceedings of the Ninth International Joint Conference on Artificial Intelligence, 1985, pp. 1034–1036. ดัชนี proceedings อย่างเป็นทางการของ IJCAI ระบุชื่อและหน้า 1034–1036 แต่ไม่มี PDF; เราไม่ได้อ่านฉบับประชุมฉบับเต็ม และใช้บทความวารสารที่อ่านครบสำหรับรายละเอียดอัลกอริทึม.
ใส่ความเห็น