
คำตอบสั้นสำหรับผู้สร้าง Agent
เมื่อ Agent วางแผนซ้ำทุกครั้งที่ได้รับข้อมูลใหม่ เพดานความเสี่ยงของแผนสั้นแต่ละรอบอาจถูกนำกลับมาใช้ซ้ำ หากแผนใหม่เริ่มต้นด้วยงบเดิมเสมอ ความเสี่ยงที่อนุญาตในแต่ละแผนอาจสะสมเกินขอบเขตของภารกิจจริง งานของ Huang และคณะเสนอ Interval Risk Bound (IRB) และ Risk-Budget Receding-Horizon Control (RB-RHC) เพื่อให้ Agent พกยอดคงเหลือข้ามการวางแผนแต่ละรอบ พร้อมกันงบสำหรับการหยุดฉุกเฉินหลังการเคลื่อนที่ครั้งแรก
แก่นของบัญชีเมื่อแผนรอบปัจจุบันทำได้คือ
rho_next = rho_now - q - s + delta
โดย q คือความเสี่ยงของการเคลื่อนที่ถัดไปที่คำนวณจาก belief แบบ open-loop, s คือความเสี่ยงสำรองของแผนหยุดฉุกเฉินจาก belief หลังการเคลื่อนที่ และ delta คือวงเงินความเสี่ยงที่เพิ่มตามเวลา ทั้ง q และ s ถูกหักเมื่ออนุมัติการเคลื่อนที่ แม้สุดท้ายจะไม่ต้องใช้แผนหยุดก็ไม่คืน s หากการหาคำตอบรอบหน้าล้มเหลว ระบบใช้แผนหยุดที่กันเงินไว้แล้ว และเมื่อหยุดอยู่แล้วให้ทำ NO-OP โดยไม่หัก s ซ้ำ
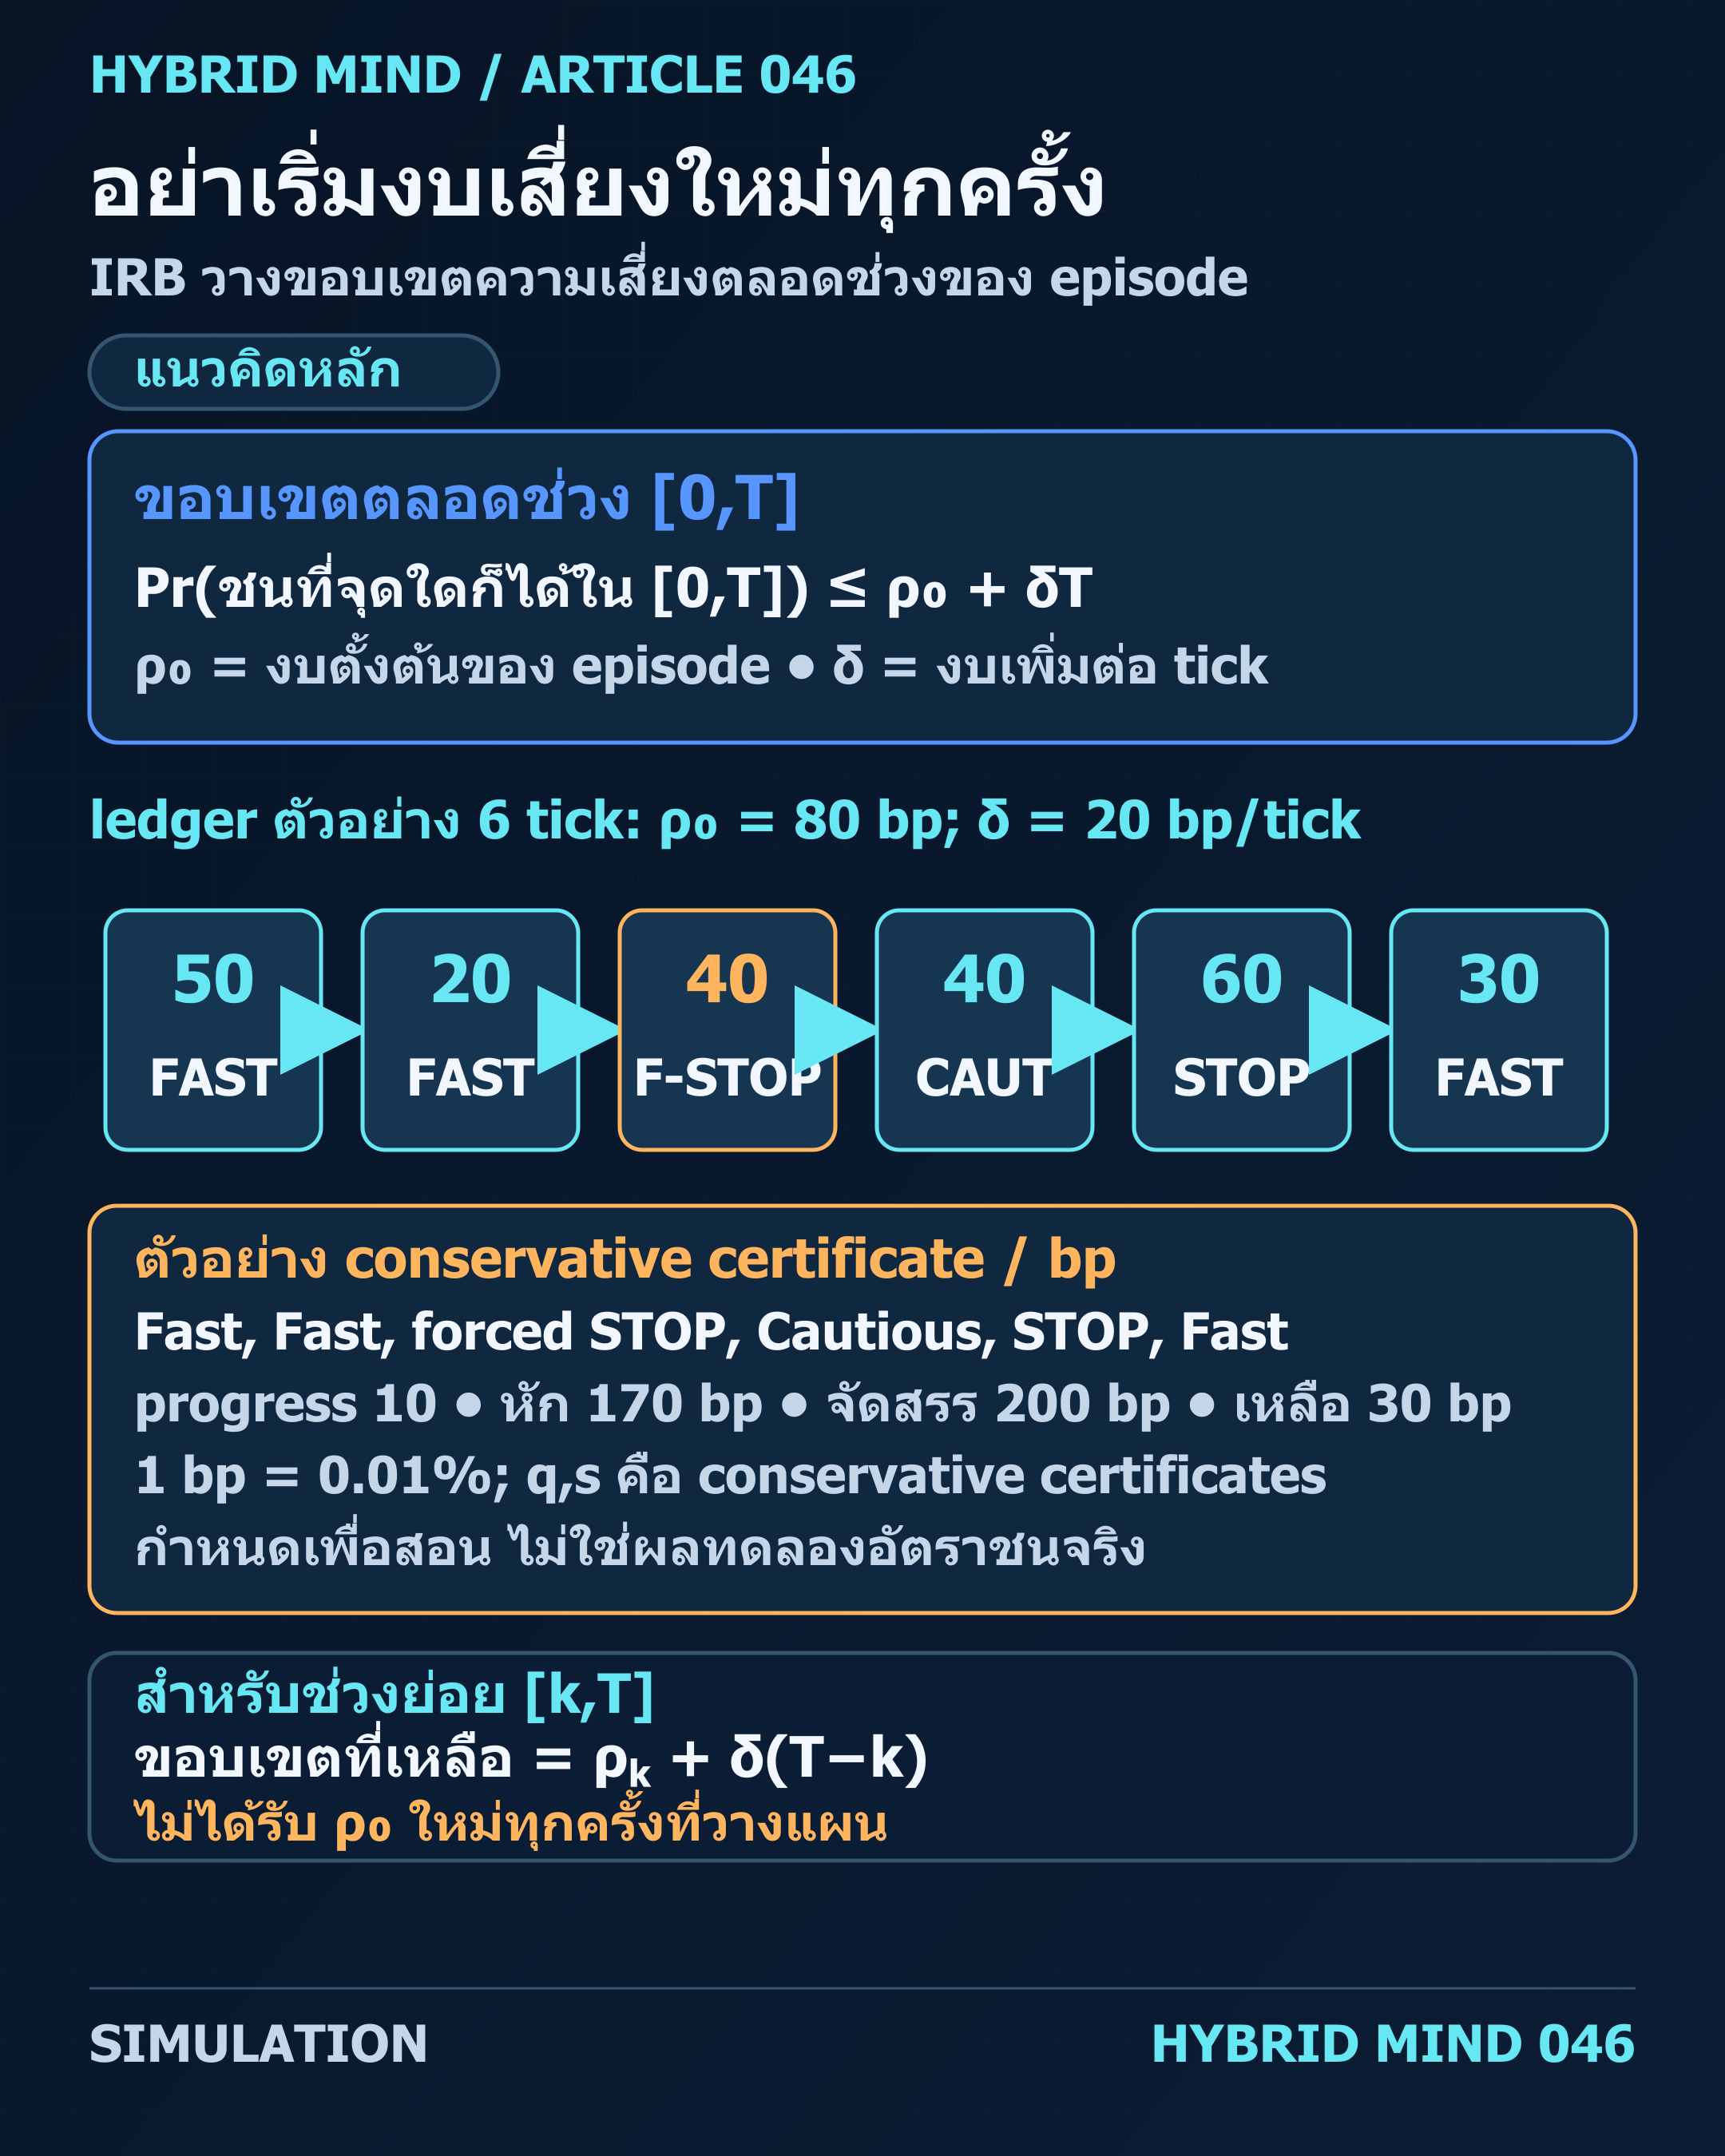
ขอบเขต Pr(เกิดการชนอย่างน้อยหนึ่งครั้งใน [0,T]) <= rho_0 + delta T ใช้กับช่วงภารกิจที่กำหนดจุดเริ่มต้นไว้ ไม่ใช่คูปองงบใหม่สำหรับทุก rolling window หรือทุก replan การรับประกันขึ้นกับโมเดลความน่าจะเป็น การคำนวณ risk bound การอัปเดต belief และสมมติฐานว่าการหยุดพา belief ไปถึงเซตที่ปลอดภัยตามนิยามในงาน แบบจำลองที่แทรกระหว่างบทเป็นบัญชีจำนวนเต็มเพื่อสอนกลไก ไม่ใช่ตัวแก้ RB-RHC และไม่ได้คำนวณความน่าจะเป็นการชนจริง
ทำไมการวางแผนซ้ำทำให้งบเสี่ยงซ้ำได้
Receding-horizon planning สังเกตสถานะ วางแผน ทำก้าวแรก รับ observation แล้ววางแผนอีกครั้ง แต่แผนใหม่ไม่ควรลบประวัติความเสี่ยงที่ใช้ไปแล้ว
ถ้า planner อนุญาต risk สูงสุด alpha ต่อแผนและใช้ allowance เกือบเต็ม เมื่อ replan ด้วย alpha เดิมก็เปิดโอกาสใช้ allowance ซ้ำ ตัวอย่าง paper ให้ joint chance constraint .1 สองช่วงต่อเนื่องกัน ซึ่งอาจรวมเป็น .19 ไม่ใช่ .1 ตลอดภารกิจ ตัวเลขนี้อธิบายความเสี่ยงสะสม ไม่ใช่ recurrence ของ RB-RHC
ปัญหาคือบัญชีไม่เชื่อมรอบใหม่กับช่วงที่ผ่านไป เวลา งบ และทางหนีจึงต้องเป็น persistent state ไม่ใช่ค่าที่ prompt สร้างใหม่ทุกครั้ง
รากฐานทางวิทยาศาสตร์: IRB และบัญชีที่หักก่อนใช้
บทความของ Huang และคณะ “Planning on a (Risk) Budget: Safe Non-Conservative Planning in Probabilistic Dynamic Environments” เผยแพร่เป็น arXiv:2106.09127 v1 วันที่ 16 มิถุนายน 2021 ความยาวเก้าหน้าพร้อมภาคผนวก และมีฉบับ ICRA 2021 หน้า 10257–10263 DOI 10.1109/ICRA48506.2021.9561745 บทนี้อ้างฉบับ arXiv; หน้า IEEE Xplore เปิดไม่ได้เพราะระบบตรวจยืนยัน แต่ proceedings และแค็ตตาล็อกอิสระยืนยันข้อมูลประชุม arXiv · PDF · proceedings · bibliography
FACT — นิยามใน paper. IRB จำกัดความน่าจะเป็นที่จะละเมิดความปลอดภัยอย่างน้อยหนึ่งครั้งภายในช่วง [0,T] ด้วย rho_0 + delta T โดย rho_0 เป็น allowance เริ่มต้นของ episode และ delta เป็น allowance ที่เพิ่มต่อหนึ่งก้าว สำหรับช่วงย่อยตั้งแต่ก้าว k ขอบเขตที่ paper รักษาไว้เขียนเป็น rho_k + delta (T-k) ไม่ได้ให้ตั้ง rho_0 ใหม่ทุก rolling window การเริ่ม episode ใหม่ต้องมีนิยามและ guarantee แยกชัดเจน
FACT — recurrence ของอัลกอริทึม. ให้ b_k แทน belief ปัจจุบัน และ u*_k แทน action แรกจากแผนที่ feasible กำหนด g_b(b) เป็นความน่าจะเป็นการชนตาม belief และ g_b^stop(b) เป็นค่าขอบบนความเสี่ยงตลอดเส้นทางหยุดจาก belief นั้น ก่อนอนุมัติ action ระบบมอง belief หลัง action แบบ open-loop แล้วกันเงินสองรายการ: ความเสี่ยงของ belief ก้าวหน้า q = g_b(f_b^OL(b_k,u*_k)) และความเสี่ยงของแผนหยุดจาก belief เดียวกัน s = g_b^stop(f_b^OL(b_k,u*_k)) จากนั้นจึงบวก allowance ต่อก้าว delta บัญชีจึงอัปเดตเป็น
rho_(k+1) = rho_k - g_b(f_b^OL(b_k,u*_k)) - g_b^stop(f_b^OL(b_k,u*_k)) + delta
การหักก่อนใช้เป็นส่วนสำคัญของกลไก ไม่ใช่การบันทึกเฉพาะเหตุการณ์ที่เกิดแล้ว เพราะระบบต้องจ่ายล่วงหน้าให้กับความเสี่ยงที่ยอมรับในการก้าวถัดไปและตัวเลือกหยุดที่คุ้มครองเมื่อการวางแผนรอบหน้าไม่สำเร็จ การสงวนไว้ช่วยให้ action แรกไม่ใช้ allowance จนทางหนีฉุกเฉินที่แผนรับรองทำไม่ได้
หยุดฉุกเฉินเป็น contingency ที่มีต้นทุน
ในแบบจำลอง passive-safety ของ paper การหยุดฉุกเฉินใช้การชะลอสูงสุดและสมมติว่าสามารถไปถึงเซต belief ของสถานะหยุด B_stop ภายใน t_stop ก้าวจาก belief เริ่มต้นที่กำหนดไว้ ผู้เขียนสมมติว่าความเสี่ยงชนใน stopped belief ภายในเซตนี้เป็นศูนย์ตาม collision set ของโมเดล และรวมความเสี่ยงระหว่างการชะลอไว้ใน g_b^stop นี่เป็นคุณสมบัติเฉพาะของ collision set และพลวัตการหยุดที่นิยามไว้ ไม่ได้แปลว่าวัตถุหรือหุ่นยนต์ใดก็ตามหยุดแล้วจะปลอดภัย
เมื่อตัว optimizer หาแผนที่ feasible ไม่ได้ Algorithm 1 ใช้ emergency stop ถ้ายังเคลื่อนที่ หรือ NO-OP หากหยุดอยู่แล้ว ขั้น NO-OP ไม่ได้เพิ่ม action เคลื่อนที่และไม่ต้องกัน stop reserve รอบที่สอง เพราะ reserve นั้นถูกหักใน certificate ของ action ก่อนหน้าแล้ว ถ้าระบบกำลังหยุดตาม contingency ที่กันไว้ การคิด debit s ซ้ำจะนับค่าเดิมสองครั้ง แต่การคืนเงินเพราะ “ไม่ได้เกิดเหตุ” ก็ผิดหลักบัญชี เพราะ s เป็นสำรองขอบบนที่อนุมัติไว้ ไม่ใช่เงินมัดจำที่คืนจากผลสุ่มหนึ่งครั้ง
ขอบเขตของทฤษฎีอยู่ภายใต้โมเดล
ทฤษฎีเริ่มจาก belief ที่ไม่ irrecoverable และทำให้ปัญหา optimization (7) feasible ในก้าวศูนย์ หลักฐานใช้การหักความเสี่ยงและ contingency reserve เพื่อให้ยังมีวิธีดำเนินต่อที่อยู่ในขอบเขตตามโมเดล ไม่ได้แปลว่า optimizer จะหาแผนเดินหน้าได้ทุกก้าว Lemma 1 กล่าวถึงก้าว feasible ที่เกิดภายหลังในฐานะสมมติฐานของการอุปนัยเพื่อจำกัด suffix หากมีการกลับมา feasible ไม่ใช่เงื่อนไขใหม่ว่าระบบจะต้องกลับมาหาคำตอบได้ก่อนสิ้น horizon หากไม่ feasible ต่อเนื่อง ระบบใช้ stop ที่กันไว้แล้วและ NO-OP ตราบที่หยุดอยู่
คำรับประกันจึงเป็นขอบบนแบบ ex ante ภายใต้ transition, observation และความเชื่อที่โมเดลกำหนด การตีความ collision risk และขอบบนความน่าจะเป็นต้องถูกต้องตามโมเดลด้วย ผลนี้ไม่ได้พิสูจน์ความทนต่อ model misspecification, distribution shift, อันตรายที่ไม่ได้จำลอง หรือบั๊กการนำไปใช้ และไม่ใช่การรับรองความปลอดภัยของระบบจริง
สถาปัตยกรรม: ตัววางแผนกับบัญชีต้องแยกหน้าที่

เส้นทางข้อมูลควรตรวจสอบได้: belief estimator อัปเดต b_k; risk evaluator คำนวณ q,s ด้วย model version ที่ระบุ; optimizer ตรวจ risk อนาคตและ contingency; action gate ตรวจ certificate; executor ทำ action เดียวแล้วส่ง observation กลับไปอัปเดต belief กับ ledger
ใน optimization (7d) ต้องตรวจ sum_(i=k+1)^(k+N) [g_b(b_i)+g_b^stop(b_i)] <= rho_k โดย N คือความยาวแผนที่มองล่วงหน้า การตรวจ q+s <= rho_k ของ action แรกจึงเป็นเพียงส่วนหนึ่ง ไม่ใช่การทดแทนข้อจำกัดทั้ง horizon Paper ใช้ open-loop belief สำหรับ immediate และ stop risk แต่ยอมใช้ PCL update แบบประมาณในการจัดสรร risk อนาคต หากนำ heuristic อื่นมาแทน ต้องแยก upper bound ตามทฤษฎีจาก estimate เพื่อเลือกแผน และห้ามแปลง confidence ของ LLM เป็น collision probability โดยไม่มี event model และ calibration
ANALYSIS / Conceptual Architecture — ข้อเสนอสำหรับ Software Agent. ledger บันทึก episode ID, จุดเริ่มนาฬิกา, rho_0, delta, rho_k, q, s, action, model/belief version, certificate และผล execution ต้องกู้คืนหลัง restart ได้ และปฏิเสธ certificate หมดอายุ รายการบันทึกนี้เป็นข้อเสนอด้านระบบ ไม่ใช่รายละเอียด implementation ที่ paper ทดสอบ Context window อาจถูกตัด ส่วน retrieved context เป็นข้อมูลที่ดึงมาเติมบริบท การบันทึก external memory หรือ ledger ไม่ใช่การฝึกหรือเปลี่ยนน้ำหนักโมเดล
สำรวจงบความเสี่ยง (SIMULATION)
This educational ledger uses integer basis points: 1 bp = 0.01%. Each move precharges immediate exposure and a conservative next-stop certificate. That certificate is bookkeeping, not a measured probability or collision outcome. This is not the full RB-RHC solver, theorem, or reproduction.
| Tick | Action | Before | q | Stop reserve | Debit | δ | After | State | Fallback source | Global allocation | Reset adjustment |
|---|
Carry mode never refunds an unused stop reservation. Reset comparison reissues a local cap of ρ₀ before each tick while the original episode allocation remains ρ₀+δk. A debit above that allocation is an accounting breach in this toy ledger; it alone does not establish an actual collision rate or an IRB violation.
LLM ใช้ context/retrieval เพื่อ reasoning แต่ให้ external ledger เป็นแหล่งจริงของ rho_k สรุปเหตุผลไม่ใช่ hidden chain trace หรือหลักฐานยอดบัญชี รอบใหม่ต้องอ่าน ledger
วงจรปฏิบัติการเมื่อมี observation ใหม่
หนึ่งก้าวเริ่มจากอ่าน state ที่รับรองแล้ว ยืนยัน episode clock และ model version แล้วอัปเดต belief จาก observation ระบบคำนวณขอบบนความเสี่ยงของ move และ stop contingency สำหรับ action แรก ตรวจงบกับเงื่อนไขแผนอนาคต และบันทึก certificate พร้อม action ก่อนส่งไป executor

หลัง action ระบบอ่าน observation, อัปเดต belief และ ledger ถ้า optimizer ล้มเหลวก่อนอนุมัติ action ใหม่ ให้ใช้ contingency ที่บันทึกไว้ ไม่ใช้ certificate หมดอายุ ถ้ายังเคลื่อนที่ให้ STOP หากหยุดแล้วให้ NO-OP การบวก delta ต้องสัมพันธ์กับ tick ตามอัลกอริทึม ไม่ใช่จำนวนครั้งที่เรียก LLM หรือ retry
เฝ้าระวัง ledger mismatch, action ที่ไม่มี stop certificate, clock reset โดยไม่มี episode ใหม่, belief update ล้มเหลว และ stop model ที่ไม่ตรงสภาพแวดล้อม เมื่อพบปัญหาอย่าเริ่ม rho_0 ใหม่เพื่อกลบข้อผิดพลาด ให้หยุดตาม fail-safe ที่กำหนดและบันทึกสถานะ
เปรียบเทียบกับวิธีจัดการความเสี่ยงแบบอื่น

Joint chance-constrained RHC จำกัด risk ของแผนรอบนั้น แต่ allowance ที่แจกซ้ำไม่มีบัญชีข้ามรอบ RB-RHC พกงบคงเหลือและ contingency reserve เพื่อให้ action แรกกับทางหยุดอยู่ในขอบเขต episode บทความ Chance-Constrained Planning กล่าวถึงภารกิจคงที่; POMCP คือ belief-tree search; LPA* ซ่อมเส้นทางตามต้นทุน ทั้งหมดไม่พก risk ledger ข้าม replan
JCC finite-horizon ไม่ replan; JCC-RHC replan; ส่วน PCL-RHC เป็น heuristic ที่ไม่มี guarantee แบบ RB-RHC ใน simulation แรก PCL-RHC รายงาน collision rate สูงกว่าเป้าหมาย .01 ขณะที่ RB-RHC ใกล้ .01 เฉพาะ scenario ที่ทดสอบ
วิธี shrinking-horizon MPC กับ conformal prediction ของ Stamouli, Lindemann และ Pappas แก้ recursive feasibility ด้วยการผ่อน safety constraint เมื่อ prediction regions แคบลง จึงไม่ใช่อัลกอริทึมต่อยอดหรือ guarantee ที่เทียบเท่า RB-RHC ซึ่งพก risk budget และ contingency reserve PMLR L4DC 2024
ตัวอย่างคำนวณ: ใช้แผนเร็ว แล้วหยุดเมื่อ planner ล้มเหลว
วางแผน สำรองความเสี่ยง และวางแผนใหม่ (SIMULATION)
Choose moves to earn progress while keeping enough budget for the next-stop certificate. Fixed episode: ρ₀=80 bp, δ=20 bp, H=6. A move spends both q and its stop reservation up front; the stop button uses that already charged certificate without charging it twice. At tick 3, a forced solver failure requires the contingency. Certificates are conservative values supplied by this toy model, not measured probabilities.
Goal: maximize progress. Fast earns 3 (q=30, stop=20); Cautious earns 1 (q=10, stop=10); STOP/NOOP earns 0. No random outcomes or chance-based scoring.
Show all 15 optimal sequences
| Tick | Action | Before | q | Stop reserve | Debit | δ | After | State | Fallback source | Global allocation |
|---|
Budget conservation while carrying: remaining + cumulative debits = ρ₀ + δk. The emergency stop is a contingency action after a failed next solve, using its precharged certificate. This small deterministic teaching model does not implement full RB-RHC or inherit its theorem.
ก่อนดูตัวเลข ให้แยกหน่วยของ lab นี้จาก paper จริง: lab ใช้ basis point จำนวนเต็มเพื่อให้คนอ่านตรวจบัญชีได้ 1 bp เท่ากับ 0.01 เปอร์เซ็นต์ตามหน่วยเชิงตัวเลข แต่ค่า q และ stop reserve ที่ป้อนเป็นค่าของเกม ไม่ใช่ความน่าจะเป็นที่วัดหรือสอบเทียบได้ เกมไม่มีการสุ่มชน ไม่มี probability tree ไม่มี belief propagation และไม่มี optimizer แบบ chance-constrained จึงเป็น scalar teaching model เท่านั้น ไม่ใช่ RB-RHC, reproduction หรือ solver ที่ผ่านการตรวจสอบ
ตั้ง episode ที่ rho_0 = 80 bp, delta = 20 bp/tick, H = 6 มี action Fast ให้ progress 3 โดยจ่าย q=30 และ s=20 รวม debit ล่วงหน้า 50; Cautious ได้ progress 1 โดยจ่าย q=10, s=10 รวม 20 การเคลื่อนที่ทำได้เมื่อยอดปัจจุบันครอบคลุม q+s เท่านั้น ก้าว 3 บังคับให้ solver ล้มเหลวเพื่อให้เห็น fallback ที่กันไว้แล้ว
ตัวอย่างแผนคือ Fast, Fast, forced STOP, Cautious, STOP โดยสมัครใจ และ Fast ยอดหลังแต่ละก้าวและ progress เป็นดังนี้:
| ก้าว | การกระทำ | ยอดก่อน | q+s ที่หัก | delta | ยอดหลัง | progress สะสม |
|---|---|---|---|---|---|---|
| 1 | Fast | 80 | 50 | +20 | 50 | 3 |
| 2 | Fast | 50 | 50 | +20 | 20 | 6 |
| 3 | contingency STOP | 20 | 0 เพิ่มเติม | +20 | 40 | 6 |
| 4 | Cautious | 40 | 20 | +20 | 40 | 7 |
| 5 | STOP โดยสมัครใจ | 40 | 0 เพิ่มเติม | +20 | 60 | 7 |
| 6 | Fast | 60 | 50 | +20 | 30 | 10 |
ที่ก้าว 2 การหัก s=20 กันการหยุดจากสถานะหลัง Fast เมื่อก้าว 3 พบ solver failure จึงใช้ certificate นี้โดยไม่หักซ้ำ Tick 3 ได้ allowance แต่ไม่มี q ใหม่เพราะไม่ได้เคลื่อนที่ หากก้าวถัดไปกลับมา feasible ก็เริ่มเคลื่อนที่ได้อีกครั้ง ไม่คืน stop reserve ที่ไม่ได้ใช้จริง
ยอด debit 170 bp ประกอบด้วย q รวม 100 bp และ stop reserve ล่วงหน้า 70 bp; allowance ถึงก้าว 6 คือ 80 + 20×6 = 200 bp จึงเหลือ 30 bp ตรวจสมดุลด้วย remaining + cumulative debits = rho_0 + delta×k หากโหมด reset แจก cap 80 bp ซ้ำจน debit สะสมเกิน allocation ของ episode ให้เรียก ACCOUNTING BREACH ในเกมเท่านั้น ไม่ใช่หลักฐานว่าชนจริงหรือผิด IRB
เปรียบเทียบ Fast กับ Cautious เมื่อยอดลดลง: การหยุดอาจเป็นคำตอบที่เหมาะสม ไม่ใช่ความล้มเหลวเสมอไป การเพิ่มยอดเพื่อให้เกมเล่นได้นานขึ้นเปลี่ยนโจทย์ ไม่ได้พิสูจน์ความปลอดภัย
ผลที่ paper รายงานและสิ่งที่ตัวเลขบอกไม่ได้
REPORTED CLAIM — Simulation 1 (paper). ฉาก trailer-yard T-junction มีรถเลี้ยวซ้ายอีกคัน ตั้ง rho_0=.01, delta=0, horizon 25 วินาที, timestep 1 วินาที, replan 1 Hz ผู้เขียนใช้ชุดข้อมูลขนาดเล็กของเส้นทางเลี้ยวซ้ายที่มนุษย์ขับเพื่อฝึก RR-GP แล้วสุ่มสถานะเริ่มต้นและเส้นทางจากโมเดลใน 1,000 trials รายงาน collision rate RB-RHC .010 ± .003, JCC-FH .007 ± .003, JCC-RHC .001 ± .001, PCL-RHC .015 ± .004 ตั้งเป้าความเสี่ยงสูงเพื่อให้เห็น event ได้ในจำนวนทดลองจำกัด ผลนี้ไม่พิสูจน์ทุก distribution
REPORTED CLAIM — Simulation 2 (paper). ฉากมีรถด้านหน้าและรถสวนทางที่เจตนาไม่แน่นอน (prior เลี้ยวขวา 70%, ตรง 30%) ตั้ง rho_0=10^-6, delta=0 และทดลอง 1,000 ครั้ง ไม่พบ collision ในทุกวิธี ซึ่งยืนยันความถี่ระดับหนึ่งในล้านไม่ได้ ค่า navigation cost คือ RB-RHC 19.246 ± .061 เทียบ JCC-RHC 21.280 ± .075 ต่ำกว่าราว 9.6% ใน setup นี้
REPORTED CLAIM — รถบรรทุก mixed reality (paper). การสาธิต Class 8 truck ใช้รถ virtual ใน trailer yard, replanning 20 Hz, rho_0=10^-5, delta=10^-6 และรายงานการ maneuver สำเร็จ นี่ไม่ใช่หลักฐานความถี่ชนจริงหรือการรับรองความปลอดภัยบนถนน
ใช้แนวคิดนี้กับ Agent แบบไหนได้บ้าง
HYPOTHESIS — การถ่ายโอนหลักคิด. ระบบกายภาพที่มี action เสี่ยงต่อเนื่องและ fallback ชัด เช่น หุ่นยนต์ทำงานร่วมกับคน อาจใช้หลักนี้ได้ ส่วน Software Agent ยืมหลักไม่แจกสิทธิ์ซ้ำได้เชิงแนวคิด แต่ห้ามเรียกยอดว่า collision probability หากไม่มี event model และ calibration ที่ตรง domain
สำหรับ Agent ใช้เครื่องมือ contingency อาจหมายถึงยกเลิกงานหรือ rollback หากสถานะหลังหยุดไม่ปลอดภัย หลักฐาน RB-RHC ใช้ไม่ได้; การตรวจว่า restart/retry ไม่รีเซ็ต cap เป็นการตรวจบัญชี ไม่ได้ประเมินโอกาสชน
ข้อจำกัดและคำถามก่อนนำไปใช้
ผล formal ผูกกับแบบจำลองความน่าจะเป็น belief update, collision-risk bound และ contingency ที่ไปถึง safe set ส่วน tracking error แบบ Gaussian และ RR-GP สำหรับรถอื่นที่ไม่ขึ้นกับสถานะ ego เป็นรายละเอียด implementation ในการทดลอง ไม่ใช่ข้อกำหนดทั่วไปว่าทฤษฎีใช้ได้เฉพาะ Gaussian หรือ RR-GP การย้าย domain ต้องตรวจสมมติฐานใหม่
Paper ใช้ open-loop belief สำหรับ immediate risk กับ stop contingency แต่ใช้ PCL estimate สำหรับ risk อนาคต ต้องแยก upper bound จากค่าประมาณ
simulation ไม่ทดแทน validation อิสระเมื่อ model อาจขาด common cause หรือเหตุการณ์หายาก ตรวจ ledger แยกจาก model: บัญชีถูกไม่รับรอง q,s และ model ที่ดีไม่ช่วยหากยอด reset
สถานะ code/revision ของงาน Huang et al. คือ UNKNOWN / ไม่พบ pointer ใน paper, metadata และ targeted search ที่ทำในรอบวิจัยนี้ ไม่ควรสรุปว่าไม่มี source code อยู่ การทดลองที่บทนี้ยกมาเป็นค่าที่ paper รายงาน ไม่ใช่การรัน benchmark ต้นฉบับซ้ำ
แนวทางพัฒนาต่อ
การนำไปใช้ควรเริ่มจากระบุ event, episode clock, safe set และ contingency ที่ทำได้จริง ก่อนพัฒนาตัวประเมินขอบบน q,s จากข้อมูลของระบบ แล้วตรวจความสอดคล้องของ ledger เมื่อเกิด restart, solver failure และ model-version change งานต่อไปคือ validation แบบอิสระและการวิเคราะห์ความไวต่อ distribution shift ไม่ใช่การเพิ่มความมั่นใจจากจำนวน replanning อย่างเดียว
สรุปสิ่งที่ควรจำ

- เมื่อ replanning ให้คง
rho_kข้ามก้าวของ episode อย่าแจกrho_0ซ้ำทุกครั้งที่มี observation ใหม่ - เมื่ออนุมัติการเคลื่อนที่ ให้หักทั้ง immediate risk
qและ stop contingency reservesก่อน แล้วบวกdeltaตามก้าวที่ผ่านไป:rho_next = rho_now - q - s + delta. - หาก optimizer รอบใหม่ infeasible ให้ใช้ contingency ที่ action ก่อนหน้ากันไว้แล้ว; เมื่อหยุดอยู่แล้วให้ NO-OP และไม่หัก stop reserve ซ้ำ
- IRB
rho_0 + delta Tอ้างถึงช่วงภารกิจที่มีจุดเริ่มต้น ไม่ได้มอบงบใหม่ให้ทุก rolling window - หลักประกันเป็น model-conditional และขึ้นกับความถูกต้องของ collision-risk bounds, belief updates และ passive-safe stop set
- ตัวอย่าง 80/20 bp ในบทนี้เป็น ledger toy model; ACCOUNTING BREACH เป็นสัญญาณว่ามีการ reissue allowance เทียบกับกรอบบัญชีเดิม ไม่ใช่ข้อพิสูจน์การชนหรือการละเมิด IRB จริง
คำถามที่พบบ่อย
IRB แตกต่างจาก chance constraint ของแต่ละแผนอย่างไร
IRB ผูกขอบเขตความน่าจะเป็นของการละเมิดกับช่วง episode และ allowance ที่เพิ่มตามเวลา ส่วน constraint ของแผนรอบหนึ่งอาจไม่บันทึกว่าแผนก่อนหน้าใช้ allowance ไปเท่าไร เมื่อ replanning แล้วตั้งค่าเดิมซ้ำ ความเสี่ยงของหลายรอบจึงอาจสะสมเกินงบรวมได้ RB-RHC พกยอดคงเหลือและเงื่อนไข contingency เพื่อผูกการตัดสินใจปัจจุบันเข้ากับช่วงที่ผ่านไปแล้ว
ทำไมต้องหัก stop reserve ถ้ายังไม่หยุด
เพราะ action ที่เลือกต้องมีแผน fallback หาก optimizer หาแผนถัดไปไม่ได้หลัง action นี้ Paper นับ stop exposure จาก belief หลัง action และบังคับให้แผนอยู่ในงบเมื่อรวมความเสี่ยงเคลื่อนที่กับความเสี่ยงหยุด Reserve เป็นเงื่อนไขการรับรอง action ไม่ใช่ค่าใช้จ่ายที่เกิดเฉพาะเมื่อกดปุ่มหยุด
ACCOUNTING BREACH ในเกมหมายถึงเกิดอุบัติเหตุแล้วไหม
ไม่ใช่ เกมเปรียบเทียบการนำวงเงินเริ่มต้นกลับมาใช้กับ allocation เดิมของ episode หากยอด debit สะสมสูงกว่า rho_0 + delta k เกมติดป้ายว่าบัญชี reissue เกินกรอบที่ตั้งไว้ แต่เกมไม่มี collision outcome แบบสุ่มและค่า bp ไม่ใช่ความน่าจะเป็นที่สอบเทียบแล้ว
เอกสารอ้างอิง
- Huang, H.-J., Huang, K.-C., Čáp, M., Zhao, Y., Wu, Y. N., & Baker, C. L. (2021). “Planning on a (Risk) Budget: Safe Non-Conservative Planning in Probabilistic Dynamic Environments.” arXiv:2106.09127v1, submitted 16 June 2021. Abstract and metadata · Full PDF.
- Huang et al. (2021). ICRA 2021 conference version, pp. 10257–10263, DOI 10.1109/ICRA48506.2021.9561745. Publisher content was blocked by robot verification in the research session; proceedings and independent bibliographic records corroborated the details.
- Stamouli, C., Lindemann, L., & Pappas, G. (2024). “Recursively feasible shrinking-horizon MPC in dynamic environments with conformal prediction guarantees.” L4DC 2024, PMLR 242, 1330–1342. Official PMLR page.
ใส่ความเห็น