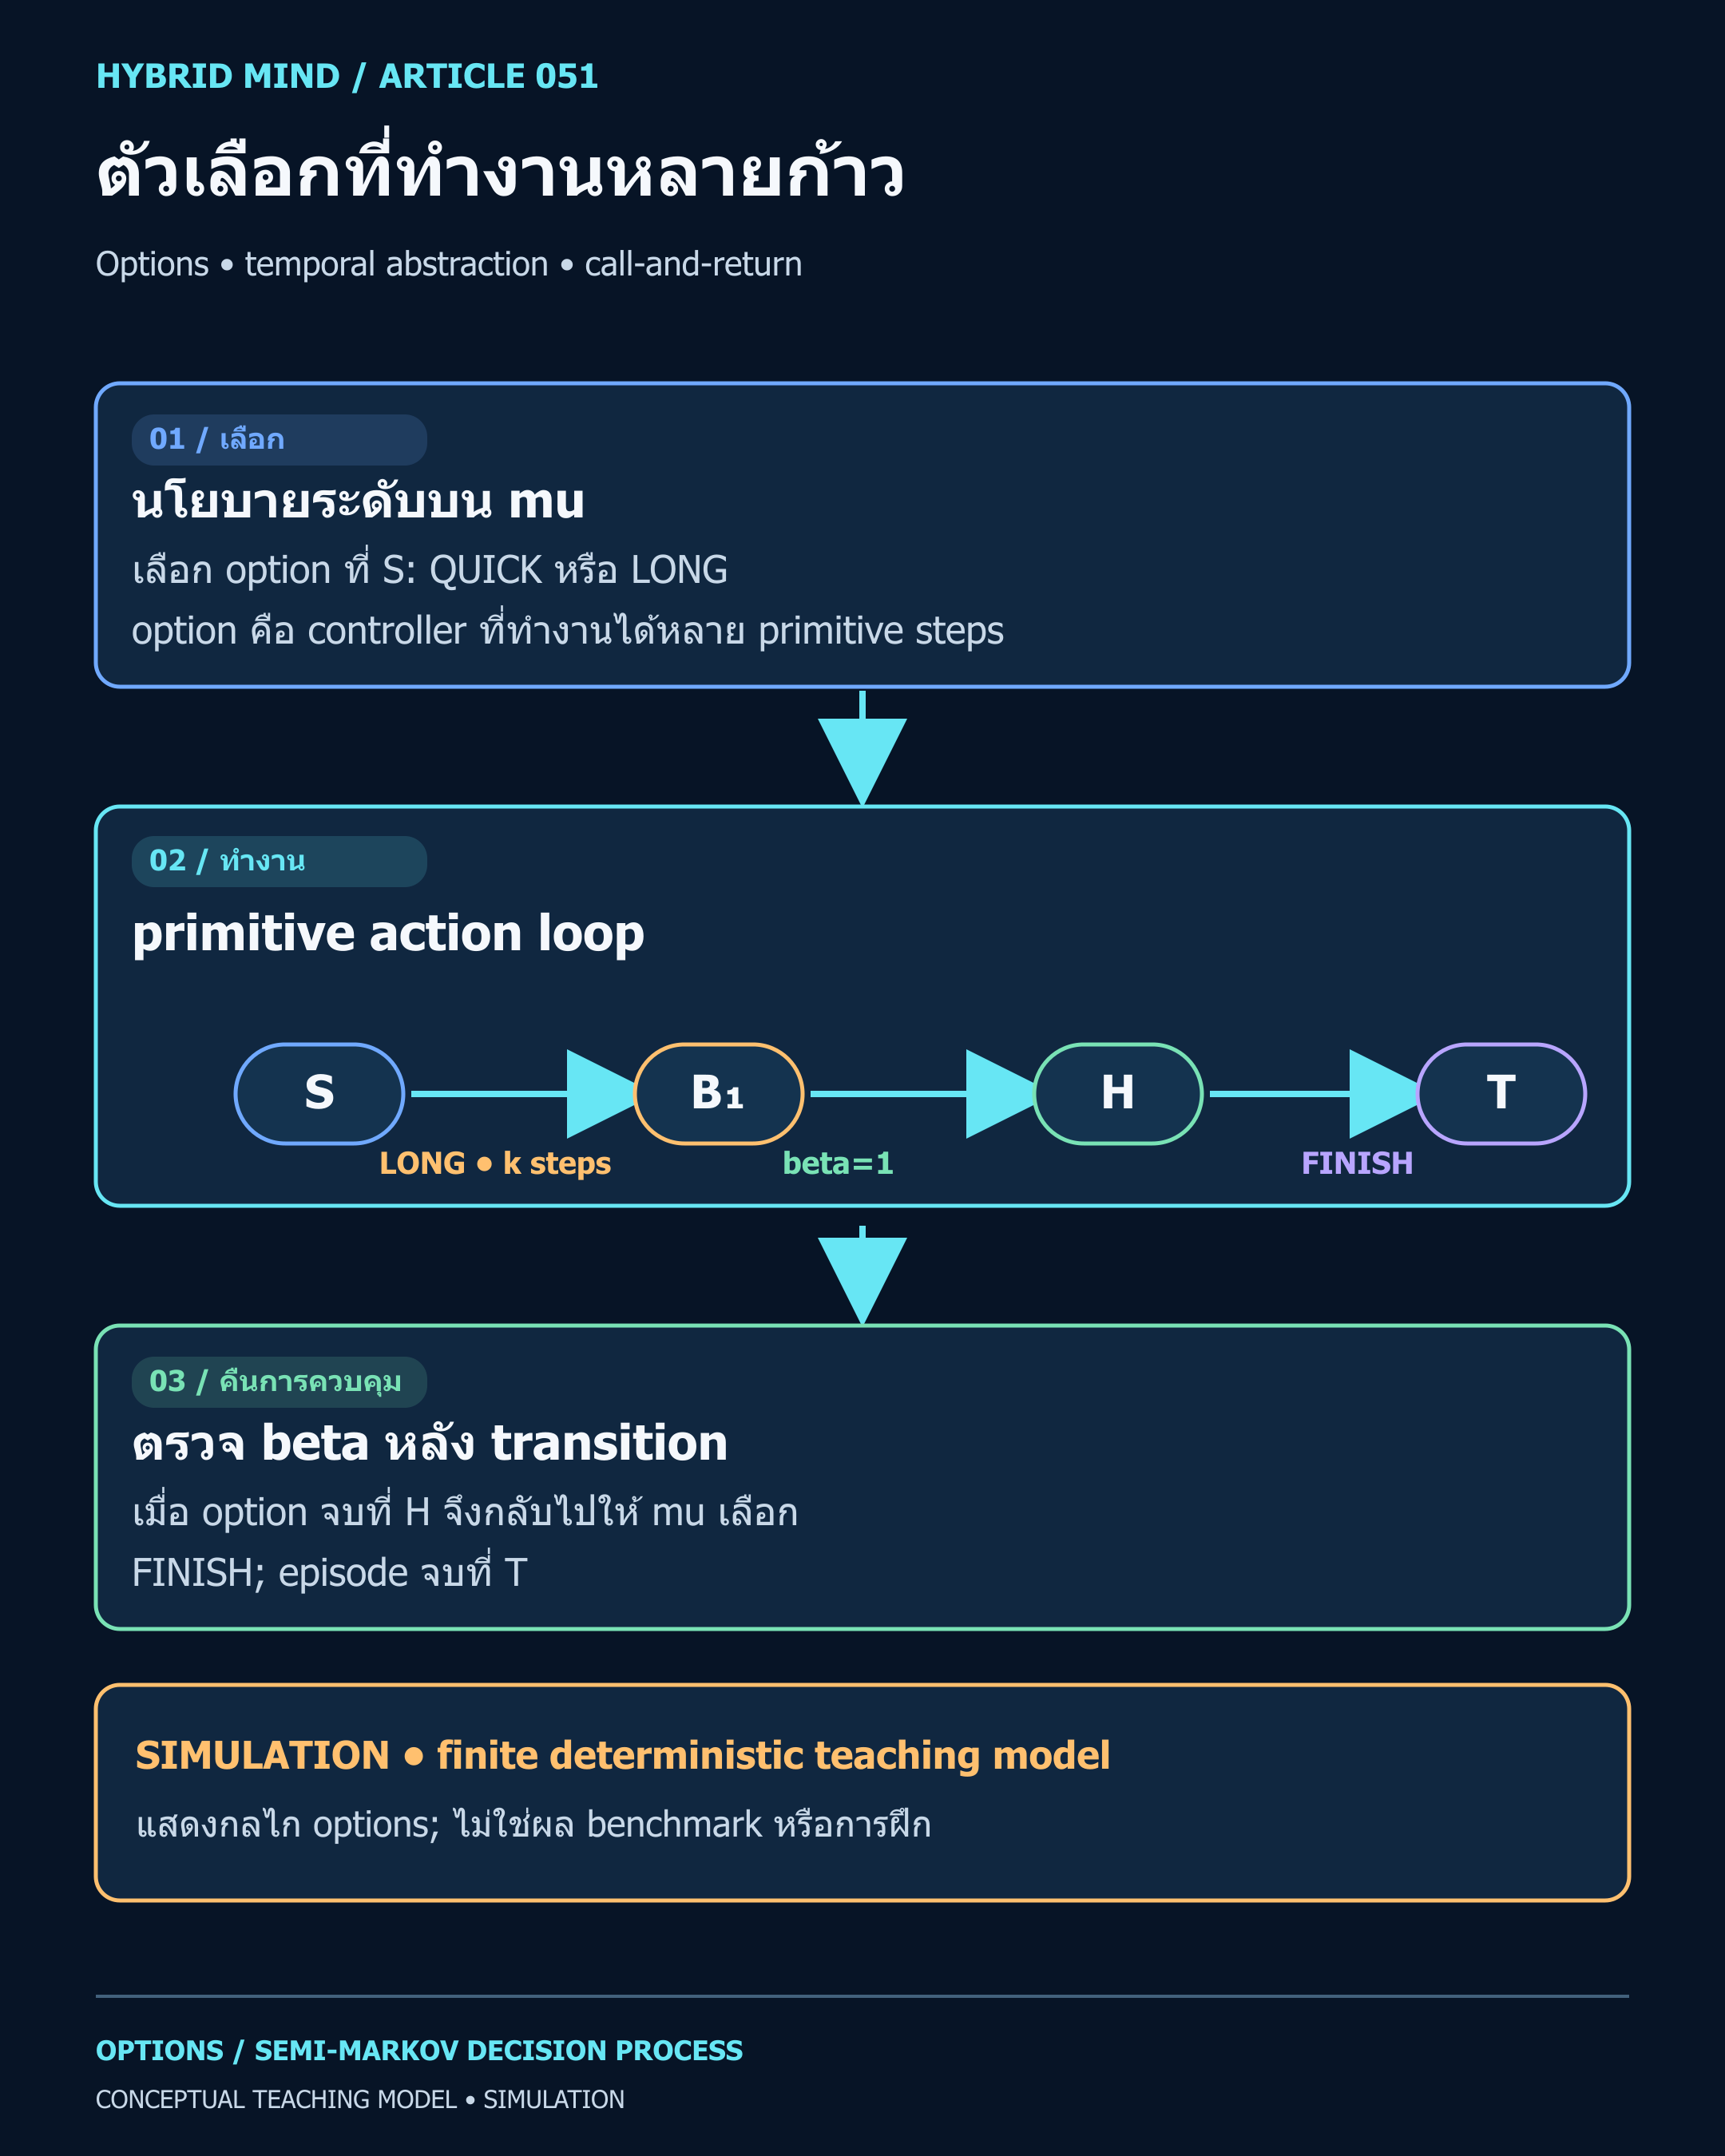
คำตอบสั้น: Options ให้ตัวแทนเลือกงานย่อยที่มีนโยบายภายในและเงื่อนไขจบ แทนการเลือกแอ็กชันทีละก้าว เขียน option เป็น o=(I, π, β): I คือสถานะเริ่มได้, π เลือกแอ็กชันระหว่างทำงาน, β คือโอกาสจบหลังย้ายสถานะ เมื่อใช้ k ก้าว ต้องคิดรางวัลระหว่างทางตามเวลา และคิด continuation ด้วยส่วนลด γ^k ไม่ใช่ γ ครั้งเดียว
ทำไมตัวแทนจึงต้องนับเวลาให้ถูก
สมมติหุ่นยนต์เลือกได้ระหว่างเดินไปจุดหมายหนึ่งก้าว หรือทำภารกิจเดินผ่านหลายช่วง ตัวเลือก “ไปจุดหมาย” ให้ระดับบนเลือกงานที่มีความหมาย โดยตัวควบคุมภายในจัดการแต่ละช่วง
ตัวเลือกจึงต้องบอกว่าเริ่มที่ใด ทำอะไรระหว่างทาง และจบเมื่อใด หากใช้เวลาหลายก้าว รางวัลปลายทางจะถูกลดค่าตามเวลาที่ผ่านไปด้วย
งานของ Sutton, Precup และ Singh ปี 1999 เสนอ options เป็นนโยบายปิดวงจรหลายก้าว และแสดงว่าชุด options เหนือ MDP กำหนด SMDP ได้ บทความฉบับเต็ม เนื้อหาต่อไปแยกข้อเท็จจริง ผลที่ผู้เขียนรายงาน และตัวอย่างจำลองออกจากกัน

พื้นฐาน: จากแอ็กชันหนึ่งก้าวสู่ option
ใน MDP ทั่วไป ตัวแทนอยู่ในสถานะ (s_t) เลือกแอ็กชัน (a_t) แล้วได้รับรางวัล (r_{t+1}) พร้อมย้ายไปสถานะ (s_{t+1}) ก้าวถัดไป การตัดสินใจระดับบนเกิดซ้ำทุกก้าว กรอบ options เพิ่มการกระทำที่อาจใช้หลายก้าว โดยยังอธิบายสิ่งที่เกิดขึ้นภายในผ่าน MDP เดิม ไม่ได้ทำให้เส้นทางหลายก้าวกลายเป็นกล่องดำโดยจำเป็น
นิยาม o=(I, π, β)
FACT — Markov option มีองค์ประกอบสามส่วนดังนี้
- I หรือ initiation set คือสถานะที่อนุญาตให้เริ่ม option; หาก s ไม่อยู่ใน I ระดับบนเลือก option นี้ไม่ได้
- π(a|s) คือนโยบายภายใน (intra-option policy) ที่เลือก primitive action ระหว่างทำงาน สำหรับ Markov option ใช้สถานะปัจจุบัน
- β(s′)∈[0,1] คือโอกาสจบหลังมาถึงสถานะ s′ การตรวจจบเกิดหลัง transition
ตัวอย่าง “เดินไปยังสถานีชาร์จ” อาจเริ่มได้เฉพาะเมื่อแบตเตอรี่ต่ำ นโยบายภายในเลือกเลี้ยวตามแผนที่และตำแหน่งปัจจุบัน ส่วนเงื่อนไขจบตรวจว่าไปถึงสถานีแล้วหรือเกิดเหตุที่ทำให้ภารกิจใช้ต่อไม่ได้ นิยามนี้ทำให้ตรวจสอบและเปลี่ยนพฤติกรรมภายในได้ แทนการถือว่า “เดินไปสถานี” เป็นปุ่มวิเศษที่ไม่รู้ว่าทำอะไร
FACT — Semi-Markov option อาจใช้ประวัติภายใน เช่น จบเมื่อครบเวลาที่กำหนด ถ้า β ดูเฉพาะสถานะปัจจุบัน จะนับเวลาที่ผ่านไปไม่ได้ เว้นแต่จะเพิ่มเวลา/ประวัติในสถานะ งานปี 1999 อธิบาย options ทั้งสองแบบ

การควบคุมแบบ call-and-return
FACT — ในแบบ call-and-return นโยบายระดับบนเลือก option ที่เริ่มได้ในสถานะปัจจุบัน จากนั้นนโยบายภายในของ option เลือกแอ็กชันพื้นฐานซ้ำไปจนเงื่อนไขจบเกิดขึ้น เมื่อจบแล้ว นโยบายระดับบนจึงเลือก option ถัดไป ลำดับนี้ทำให้มีการควบคุมสองระดับ: ผู้เลือกงาน และตัวควบคุมงานย่อย
รายการคงที่ เช่น “เดินหน้า เลี้ยวซ้าย เดินหน้า” เป็น macro แบบ open-loop หากไม่ตรวจสถานะระหว่างทางก็ไม่ปรับตามสิ่งแวดล้อม Option มีนโยบายภายในตอบสนองต่อสถานะ พร้อมเงื่อนไขเริ่มและจบ
ความสามารถในการปิดวงจรเป็นคุณสมบัติของแบบจำลอง ไม่ใช่หลักประกันคุณภาพ: นโยบายภายในอาจไม่ดี หรือเริ่มและจบผิดจังหวะได้
เหตุใด MDP จึงกลายเป็น SMDP
ถ้าเลือก primitive action เวลาที่ผ่านไปคือหนึ่งก้าว แต่ option อาจใช้ k ก้าวก่อนจบ และระยะอาจต่างกันในแต่ละครั้ง มุมมองที่ดูเฉพาะจังหวะเลือก option ใหม่คือ SMDP
FACT — เมื่อมีเซต options คงที่เหนือ MDP และดำเนินแต่ละ option จนจบ การเลือก option และผลลัพธ์ ณ เวลาจบกำหนด SMDP แบบฝังอยู่ใน MDP เดิม primitive action เป็นกรณีพิเศษที่ใช้เวลาหนึ่งก้าวและจบหลังการเปลี่ยนสถานะหนึ่งครั้ง SMDP จึงไม่ได้ลบการเปลี่ยนแปลงย่อยทิ้ง แต่รวบเวลาจริงและผลตอบแทนที่สะสมไว้ระหว่างเริ่มกับจบ
สำหรับ option ที่ใช้ (k) ก้าว รางวัลลดค่าที่สะสมระหว่างทางคือ
R(t:k) = Σ[j=0..k-1] γ^j × r(t+j+1)ส่วน continuation ที่สถานะปลายทาง s(t+k) เข้ามาด้วยตัวประกอบ γ^k:
Q(s,o) = E[Σ[j=0..k-1] γ^j × r(t+j+1) + γ^k × V(s(t+k))]ในสมการ γ∈[0,1] คือส่วนลดต่อก้าว, r(t+j+1) คือรางวัลหลัง transition ที่ j+1, k คือระยะจริง และ V(s(t+k)) คือค่าที่ปลายทาง สำหรับ duration หรือปลายทางสุ่ม ให้หาค่าเฉลี่ยเหนือผลลัพธ์เหล่านั้น
เมื่อมีหลายเส้นทางสุ่ม อย่านำค่าเฉลี่ยของ duration ไปยกกำลังแล้วใช้กับค่าเฉลี่ยของปลายทางโดยอัตโนมัติ แต่ละผลลัพธ์อาจมีระยะ รางวัลสะสม และสถานะปลายทางสัมพันธ์กัน จึงควรคิด return และ continuation แยกตามกรณีก่อนหาค่าเฉลี่ยร่วม สมการคาดหมายแสดงหลักการนี้ ส่วนการประมาณจากข้อมูลจริงต้องเก็บ trajectory และ duration ให้ตรงกับ transition ที่เกิดขึ้น
FACT — SMDP Q-learning ในงานปี 1999 อัปเดตเมื่อ option จบ โดยใช้ผลตอบแทนสะสมและ γ^k กับค่าถัดไป จึงต้องบันทึกจำนวนก้าวจริง สมการต้นฉบับ
ขั้นตอนปฏิบัติและโครงสร้างของระบบ
โมดูลและข้อมูลที่แลกเปลี่ยนกัน
ระบบทั่วไปอาจแยกโมดูลดังนี้ ตัวอย่างจำลองท้ายบทใช้เพียงสถานะและกฎที่กำหนด ไม่ได้ฝึกโมเดล
- ตัวแทนสถานะ (state representation): รับการสังเกตจากสิ่งแวดล้อม เช่น พิกัด ประจุแบตเตอรี่ และธงเหตุขัดข้อง แล้วส่งสถานะที่ตัดสินใจได้ (s) ต่อไป หากข้อมูลไม่ครบ สถานะควรมีความจำที่จำเป็น เช่น เวลาที่ใช้ใน option
- ทะเบียน option: เก็บ tuple (I, π, β) และบอกว่า option ใดเริ่มได้ใน state ปัจจุบัน
- นโยบายระดับบน μ(o|s): รับ state และรายการ option ที่เริ่มได้ แล้วส่งตัวเลือกที่ใช้ได้ให้ตัวควบคุม
- ตัวควบคุมภายใน π(a|s): รับ state และ option ปัจจุบัน แล้วส่ง primitive action ถัดไป; option แบบ history ใช้ประวัติที่กำหนด
- ตัวตรวจจบ β: ตรวจ state หลัง transition แล้วแจ้งว่าทำต่อหรือจบ พร้อมส่ง end state และ duration ให้ระดับบน
- ตัวบันทึกผลตอบแทน/เวลา: เก็บ reward ตามลำดับ, duration k, state ต้น/ปลาย, discounted return และ trace ให้ตัวประเมินหรือผู้เรียน
บันทึกหนึ่งครั้งอาจมี start_state, option_id, primitive_trace, discounted_reward, duration, end_state และ terminated โดยนับ transition พื้นฐานจริง รางวัลรวมที่ไม่มีระยะเวลาไม่พอสำหรับส่วนลดต่อก้าว
ลำดับการทำงาน
- สร้างรายการ O(s)={o: s∈Iₒ}; นโยบายระดับบนเลือก option ที่เริ่มได้
- นโยบายระดับบนเลือก option ที่เริ่มได้ และเริ่มนับ duration k กับ return
- π เลือก primitive action จาก state ปัจจุบันแล้วส่งไปยังสิ่งแวดล้อม
- รับ reward/state ใหม่ เพิ่ม k หนึ่งก้าว แล้วตรวจ β หลัง transition
- ทำซ้ำจนจบ แล้วส่ง discounted return, duration, end state และ trace ให้ระดับบน/ผู้เรียน
ลำดับนี้เรียกว่า call-and-return เมื่อดำเนินต่อจนจบ ไม่ได้หมายความว่าระดับบนห้ามหยุด option กลางทางในทุกอัลกอริทึม เพียงแต่การขัดจังหวะต้องระบุเป็นกติกาเพิ่มเติมและประเมินผลแยกต่างหาก

เปรียบเทียบสิ่งที่มักเรียกรวมกันว่า “งานหลายก้าว”
| วิธี | สิ่งที่เลือก | การตอบสนองต่อสถานะระหว่างทาง | จุดที่คืนการควบคุมระดับบน | เงื่อนไขสำคัญ |
|---|---|---|---|---|
| Primitive action | แอ็กชันพื้นฐานหนึ่งครั้ง | ตัวแทนหลักตัดสินใจใหม่ในก้าวถัดไป | หลังหนึ่งก้าว | ระยะเวลาหนึ่งก้าว |
| Open-loop macro | ลำดับแอ็กชันที่กำหนดไว้ | โดยทั่วไปไม่เปลี่ยนตามสถานะที่พบ | เมื่อจบลำดับหรือเกิดกติกาหยุดภายนอก | ลำดับและความยาวตายตัว |
| Option แบบ call-and-return | (I, π, β) | นโยบายภายในเลือกตาม state/ประวัติ | เมื่อเงื่อนไขจบทำงาน | เริ่มที่ไหน ทำอย่างไร จบเมื่อใด |
| Option-Critic | ตัวเลือกที่องค์ประกอบภายในกำลังเรียนรู้ | นโยบายและเงื่อนไขจบพารามิเตอร์เรียนรู้ได้ | ตามการดำเนิน option และ termination ที่เรียนรู้ | เป็นวิธีฝึก options ไม่ใช่นิยาม option เอง |
Macro ที่ตรวจ state และปรับพฤติกรรมอาจเป็น option เมื่อระบุ (I, π, β) ชัด ความต่างอยู่ที่สัญญาพฤติกรรม
FACT — Option-Critic ของ Bacon, Harb และ Precup (2017) ใช้ policy gradients เรียนนโยบายภายใน/termination ควบคู่กับนโยบายเลือกระหว่าง options และรายงานผลในสภาพแวดล้อมไม่ต่อเนื่อง/ต่อเนื่อง ฉบับทางการ AAAI เป็นวิธีเรียนรู้ต่อยอด ไม่ใช่นิยาม (I, π, β) หรือผลของ toy นี้

สามแนวคิดที่ต้องแยก: call-and-return, interruption และ learning
FACT — call-and-return คือกติกาเลือก option แล้วทำจน termination ก่อนเลือกรอบใหม่ เป็นรูปแบบการดำเนินงานมาตรฐานที่อธิบายง่ายและมีเวลาของ option ชัดเจน
REPORTED CLAIM — interruption เพิ่มกฎยุติ option ก่อนปกติเมื่อการกลับไปเลือกจากนโยบายระดับบนมีค่าดีกว่าทำต่อ งานปี 1999 พิสูจน์การปรับปรุงภายใต้สมมติฐานของตน ไม่ใช่ทุกกรณี ตัวอย่าง landmark รายงาน 600 ก้าวสำหรับ SMDP options, 474 เมื่อใช้ interruption และ 425 สำหรับ primitive-action optimum; ตัวเลขเหล่านี้ไม่ใช่การทดลองซ้ำของเรา
การเปรียบเทียบดังกล่าวยังเตือนเรื่องขอบเขตของชุด option: หากชุดตัวเลือกไม่มีเส้นทางที่เข้าถึงเป้าหมาย นโยบายที่ดีที่สุดภายในชุดนั้นก็ไปไม่ถึงเป้าหมายได้ และค่าที่ดีที่สุดใน SMDP อาจต่ำกว่าค่าที่ทำได้ด้วย primitive actions ทั้งหมด ผู้เขียนยังระบุว่าการวางแผนด้วย options ไม่ได้ลดต้นทุนรวมทุกกรณี การกระโดดผ่านหลายสถานะอาจช่วยวางแผนหรือสำรวจในบางปัญหา แต่ไม่ใช่คำรับประกันความเร็วหรือความเหมาะสมทั่วไป
REPORTED CLAIM — intra-option learning ใช้ transition ย่อยระหว่าง option ทำงานเพื่อเรียนรู้ค่าของ options ที่มี action สอดคล้องกัน โดยไม่ต้องรอให้ option ทุกตัวจบ
อย่าสับสนกับ between-options SMDP Q-learning ที่อัปเดตเมื่อ option จบและใช้ γ^k กับ one-step intra-option learning ซึ่งอัปเดตจาก transition ภายใน งานปี 1999 ให้ทฤษฎีลู่เข้าสำหรับกรณี deterministic Markov options และเงื่อนไข action coverage; stochastic options ยังเป็นงานต่อยอด

ตัวอย่างจำลอง: QUICK เทียบ LONG
SIMULATION — ระบบจำกัดสถานะนี้คำนวณตรงตามสัญญาตัวอย่าง ไม่มีการสุ่ม ไม่มีการฝึก และไม่ใช่การทำซ้ำ benchmark สถานะคือ S, H, T และทางเดิน B1…B(k−1)
- QUICK: เริ่มที่ S; ใช้หนึ่ง step S→H ได้รางวัล q แล้วจบ
- LONG: เริ่มที่ S หรือ Bᵢ; เลือก BEGIN_LONG ที่ S และ ADVANCE ที่ Bᵢ จนถึง H ใช้ k∈{2,3,4,5,6} ก้าว; ได้ l เฉพาะ transition สุดท้าย แล้วจบที่ H
- FINISH: เริ่มที่ H; ใช้หนึ่ง step H→T ได้ f แล้วจบตอน
ตัวอย่างนี้ตั้งใจให้เส้นทางกลางของ LONG ถูกบังคับเพื่อให้เห็นผลของระยะเวลาโดยไม่ต้องคำนวณการเลือกอื่น ค่าที่ (H) เท่ากับ (f) เพราะมี FINISH หนึ่งก้าวที่ให้รางวัล (f) แล้วจบตอน การเปรียบเทียบที่ (S) จึงเป็น QUICK แล้ว FINISH เทียบกับ LONG แล้ว FINISH
ตั้ง γ=0.9, q=1, l=2, k=2 และ f=10:
Q_QUICK = q + γ × f = 1 + 0.9 × 10 = 10Q_LONG = γ^(k−1) × l + γ^k × f
= 0.9 × 2 + 0.9^2 × 10 = 9.9รางวัล l อยู่ที่ transition ลำดับ k จึงคิดเป็น γ^(k−1)×l; รางวัล f เกิดหลัง LONG ใช้ k ก้าว จึงคิดเป็น γ^k×f
สมการที่ผิดซึ่งช่วยชี้ตำแหน่งผิดพลาดคือ
Q_LONG_wrong = γ^(k−1) × l + γ × f
             = 0.9 × 2 + 0.9 × 10 = 10.8
บรรทัดนี้คงส่วนลดของรางวัลระหว่างทางไว้ถูกต้อง แล้วเปลี่ยนเฉพาะเลขชี้กำลังของ continuation ให้เหลือหนึ่ง จึงแยกข้อผิดพลาดเรื่อง “คิดเวลา option จบ” ออกจากความผิดพลาดอื่นได้ มันทำให้ LONG ดูดีกว่า QUICK ทั้งที่คำนวณตามเวลาจริงแล้วกลับกัน
ลองเปลี่ยนอินพุตทีละอย่างตามรอบเกม:
| รอบ | อินพุตเปลี่ยนจากค่าตั้งต้น | ผลจำลองที่ถูกต้อง |
|---|---|---|
| 1 | ไม่มี: q=1, l=2, k=2, f=10, γ=.9 | QUICK=10, LONG=9.9 |
| 2 | เปลี่ยน (l=4) เท่านั้น | QUICK (=10), LONG (=.9(4)+.9^2(10)=11.7) |
| 3 | คืน (l=2) แล้วเปลี่ยน (k=4) เท่านั้น | QUICK (=10), LONG (=.9^3(2)+.9^4(10)=8.019) |
การเปลี่ยน l ทำให้ LONG ชนะในรอบ 2; การเพิ่ม k ทำให้ค่า continuation ไกลออกไปและ LONG แพ้ในรอบ 3 รางวัล l เกิดที่ transition ลำดับ k จึงลดค่าด้วย gamma^(k-1); ส่วน f เกิดหลัง LONG จบแล้วหนึ่งก้าว จึงใช้ gamma^k
ตัวเลือกที่ดีที่สุดเป็นเช่นนั้นเฉพาะในชุดจำกัดนี้: ที่ S มี QUICK/LONG, LONG บังคับเส้นทาง และที่ H มี FINISH หนึ่งแบบ ตัวอย่างไม่จำลอง interruption หรือ learning เมื่อ γ=0 บางค่าจะเสมอกัน จึงต้องเก็บตัวเลือกที่เสมอไว้
สำรวจ Options และเวลาหลายก้าว (SIMULATION)
โมเดลนี้เป็น MDP แบบกำหนดแน่นอนและคำนวณตรงทุกกรณี: เลือก QUICK หรือ LONG จาก S แล้วระบบบังคับ FINISH ที่ H ไม่มีการสุ่ม การเรียนรู้ หรือการตัด option กลางทาง
ปรับโจทย์
ค่าที่ S · เปรียบเทียบ option
Qquick = q + γf · Qlong = γk−1l + γkf
Option เป็นชุดควบคุม 〈I, π, β〉
| Option | I · จุดเริ่ม | π · ตัวควบคุม | β · หยุดเมื่อ | ระยะเวลา |
|---|
เลื่อนตารางแนวนอนเพื่อดูข้อมูลครบ
LONG เริ่มได้ที่ S และสถานะ B ระหว่างทาง; ในโจทย์นี้เริ่มเทียบจาก S และทำงานต่อเนื่องจนถึง H
รอยทาง primitive · ค่าที่เกิดจริงทุกก้าว
เวลาที่ผ่านไปนับเป็นก้าว primitive; FINISH เป็น transition สุดท้ายเพื่อถึง T และผลตอบแทนเต็มตอนจบคิดส่วนลดตามเวลาจริง
| Option | จาก | การกระทำ | รางวัล · POINTS | ไปยัง | ก้าวที่ |
|---|
เลื่อนตารางแนวนอนเพื่อดูข้อมูลครบ
เลือก option แล้วเดินทีละก้าว
เลือก QUICK หรือ LONG เพื่อเริ่มจาก S
ผลตอบแทนสะสมแบบลดค่า: 0/1 POINTS
ใช้แนวคิดนี้กับระบบ agent อย่างระมัดระวัง
HYPOTHESIS — สำหรับผู้ออกแบบ agent options เป็นแนวทางคิดที่มีประโยชน์เมื่อมีงานหลายก้าวซึ่งสามารถนิยามสถานะเริ่ม ตัวควบคุมภายใน กติกาจบ และวัตถุประสงค์ได้ชัด ตัวอย่างเช่น หุ่นยนต์ส่งของอาจมีตัวควบคุม “ไปยังจุดรับพัสดุ” ซึ่งรับตำแหน่งและสิ่งกีดขวาง ส่งคำสั่งเคลื่อนที่ครั้งต่อไป และจบเมื่อไปถึงหรือพบอุปสรรคที่กำหนด หากจะประเมินผลตอบแทนแบบลดค่า ต้องบันทึกเวลาที่ใช้จริงด้วย
นี่เป็นการเปรียบเทียบเชิงออกแบบเท่านั้น Prompt, tool call, ContextWindow, RetrievedContext หรือ ExternalMemory ไม่ใช่ option โดยตัวมันเอง ระบบ LLM ที่ระบุ state, policy และ termination ชัดอาจสร้าง controller คล้าย option ได้ ส่วน WeightUpdates คือการเปลี่ยนพารามิเตอร์โมเดล เป็นอีกกระบวนการหนึ่ง
คำบรรยายเหตุผลไม่ใช่หลักฐานของการเรียนรู้ option หรือเปลี่ยนน้ำหนัก ควรวัด state, initiation, action, termination, duration, reward และผลเมื่อสิ่งแวดล้อมเปลี่ยน กรอบนี้ไม่ได้พิสูจน์เรื่องจิตสำนึก
ข้อจำกัดที่ควรทดสอบคือ option ถูกใช้ผิด state, option library ไม่ครอบคลุมเป้าหมาย, ความผิดพลาดสะสมก่อนคืนอำนาจ และต้นทุนสลับสูงเกินประโยชน์ หากสังเกต state ไม่ครบ ให้เก็บประวัติที่จำเป็นให้ตรงแบบจำลอง
ก่อนนำ option เข้าใช้งาน ควรตรวจสัญญาด้วยกรณีเริ่มที่อนุญาตและไม่อนุญาต การจบที่เป้าหมาย การจบจากเหตุผิดปกติ และเส้นทางที่สั้นหรือยาวกว่าคาด บันทึก action ทุกก้าวแล้วเช็กว่า reward ใช้ exponent ตามเวลาที่ได้รับ ระดับบนควรเลือกจาก options ที่เริ่มได้ และกำหนดการตอบสนองเมื่อไม่มีตัวเลือกใช้ได้ การตรวจนี้ไม่พิสูจน์คุณภาพทุกสถานการณ์ แต่ช่วยพบความไม่ตรงกันระหว่างสัญญาและโค้ดก่อนวางแผน
อ่านเพิ่ม: finite-state controller และ policy memory และ Successor Features/GPI ซึ่งศึกษา reward transfer คนละประเด็นกับ duration ของ options
เกมเลือกทักษะโดยนับเวลาให้ถูก (SIMULATION)
เลือก option ที่มีค่า Q สูงสุดในตัวเลือก QUICK/LONG ของแต่ละโจทย์ แล้วล็อกคำตอบให้คะแนนหนึ่งครั้งต่อรอบ ค่า γ ใช้กับทุกก้าวที่ผ่านจริง
—
คะแนน 0 / 3รอบ 1 / 3 ·
แนวทางพัฒนาต่อ
HYPOTHESIS — งานต่อยอดควรทดสอบความทนทานของ termination เมื่อสภาพแวดล้อมเปลี่ยน เปรียบเทียบผลของ call-and-return กับ interruption พร้อมนับต้นทุนการสลับ และประเมิน option library ที่เรียนรู้ได้เมื่อมี state/action ต่อเนื่อง ผลควรรายงานจำนวนก้าวจริง ความล้มเหลว และต้นทุนรวม ไม่ใช่ผลตอบแทนอย่างเดียว ส่วนตัวอย่างนี้ไม่ใช่หลักฐานว่าทิศทางใดจะชนะ
ANALYSIS — การประเมินที่เทียบกันได้ควรคง MDP, reward และข้อมูลเริ่มต้นเหมือนกัน แล้วเปลี่ยนเฉพาะ option library หรือกติกาจบ ระบุทั้งเวลาที่ใช้ระดับล่างและจำนวนครั้งที่ระดับบนต้องตัดสินใจ รวมทั้งรายงานกรณีที่ option ไม่ครอบคลุมเป้าหมาย หากเปลี่ยนหลายส่วนพร้อมกัน จะบอกได้ยากว่าผลมาจาก temporal abstraction หรือจากนโยบายภายในที่ดีขึ้น
ANALYSIS — การเทียบที่ยุติธรรมควรรายงานวิธีสร้าง options, state/action ที่ครอบคลุม, ระยะเวลา, baseline primitive policy และความแปรปรวนระหว่างการทดลอง หากข้อมูลนี้ขาดไป จะแยกผลของ controller ภายในออกจากผลของ temporal abstraction ได้ยาก
นำไปใช้จริง: เช็กลิสต์สั้น
- กำหนด state ที่ option ใช้ได้และ initiation set ก่อนปล่อยให้ระดับบนเลือก
- ระบุ action ภายในและ termination ที่ตรวจหลัง transition; เพิ่มเวลา/ประวัติเมื่อจำเป็น
- บันทึก reward ตามลำดับกับ duration k เพื่อให้ continuation ใช้ γ^k
- ทดสอบกรณี option พลาดเป้าหมาย ค่า switching สูง และทางเลือกใน library ไม่ครอบคลุมเป้าหมาย
คำถามที่พบบ่อย
Option ต่างจาก macro อย่างไร?
Macro ทั่วไปเป็นลำดับ primitive actions แบบ open-loop; option ระบุ I, π และ β เพื่อปรับตาม state และจบอย่างชัดเจน
ทำไม continuation ใช้ γ^k?
ค่า continuation เกิดหลัง k transitions จึงใช้ส่วนลด γ^k; หาก duration หรือปลายทางสุ่ม ให้เฉลี่ยผลลัพธ์โดยใช้ระยะจริงของแต่ละกรณี
Option ทุกตัวต้องทำงานหลายก้าวไหม?
ไม่จำเป็น Primitive action เป็น option กรณีพิเศษที่เลือกแอ็กชันเดียว จบหลังหนึ่งก้าว และเริ่มได้เมื่อแอ็กชันนั้นใช้ได้ กรอบเดียวกันจึงครอบคลุมทั้ง primitive actions และการกระทำแบบหลายก้าว
Interruption กับ call-and-return เหมือนกันไหม?
ไม่เหมือนกัน Call-and-return รอให้ option จบตาม termination ปกติ ส่วน interruption เพิ่มกฎยุติก่อนกำหนดตามเงื่อนไขการเปรียบเทียบค่า ผลดีในงานต้นฉบับผูกกับสมมติฐานของทฤษฎีและตัวอย่างที่รายงาน ไม่ควรสรุปว่าการขัดจังหวะมีประโยชน์เสมอ และตัวอย่าง QUICK/LONG ในบทความนี้ไม่ได้จำลองมัน
Option-Critic คืออะไร?
วิธีปี 2017 ที่เรียนรู้นโยบายภายในและ termination ควบคู่กับนโยบายเลือก options; ไม่ใช่นิยามของ option และไม่ได้ใช้ในตัวอย่างนี้
มีโค้ดต้นฉบับหรือไม่?
หน้าคลัง jeanharb/option_critic ระบุว่าเป็น implementation ของ Option-Critic สำหรับ Atari/ALE และ README ชี้ไปยังงานของผู้เขียน พร้อมบอก dependency ในเอกสาร เช่น Theano, Lasagne และ Arcade Learning Environment การตรวจนี้ยืนยันว่าคลังสาธารณะเปิดได้เท่านั้น ไม่ได้ติดตั้ง ตรวจ dependency ใน runtime หรือรันโค้ด ดังนั้นความเข้ากันได้ปัจจุบันและการทำซ้ำผลยังไม่ทราบ
แหล่งอ้างอิงและขอบเขตหลักฐาน
- Richard S. Sutton, Doina Precup และ Satinder P. Singh, “Between MDPs and Semi-MDPs: A Framework for Temporal Abstraction in Reinforcement Learning,” Artificial Intelligence 112(1–2), 181–211, 1999. PDF ฉบับเต็ม 31 หน้า ใช้รองรับนิยาม options ความต่าง Markov/semi-Markov, SMDP backup, ตัวอย่างห้อง, interruption และขอบเขต intra-option learning
- Pierre-Luc Bacon, Jean Harb และ Doina Precup, “The Option-Critic Architecture,” Proceedings of the Thirty-First AAAI Conference on Artificial Intelligence, 1726–1734, 2017. PDF ทางการ AAAI ใช้รองรับการอธิบาย Option-Critic ในฐานะวิธีเรียนรู้ options ต่อมา
- คลัง jeanharb/option_critic ใช้ยืนยันการมีอยู่และคำอธิบายคลังสำหรับ Atari/ALE เท่านั้น ไม่ได้ติดตั้งหรือรัน
อ่านฉบับเต็มปี 1999 และงาน AAAI 2017; ไม่มีการทำซ้ำการทดลอง ตัวเลข QUICK/LONG เป็น SIMULATION และตัวเลข interruption เป็น REPORTED CLAIM
ใส่ความเห็น