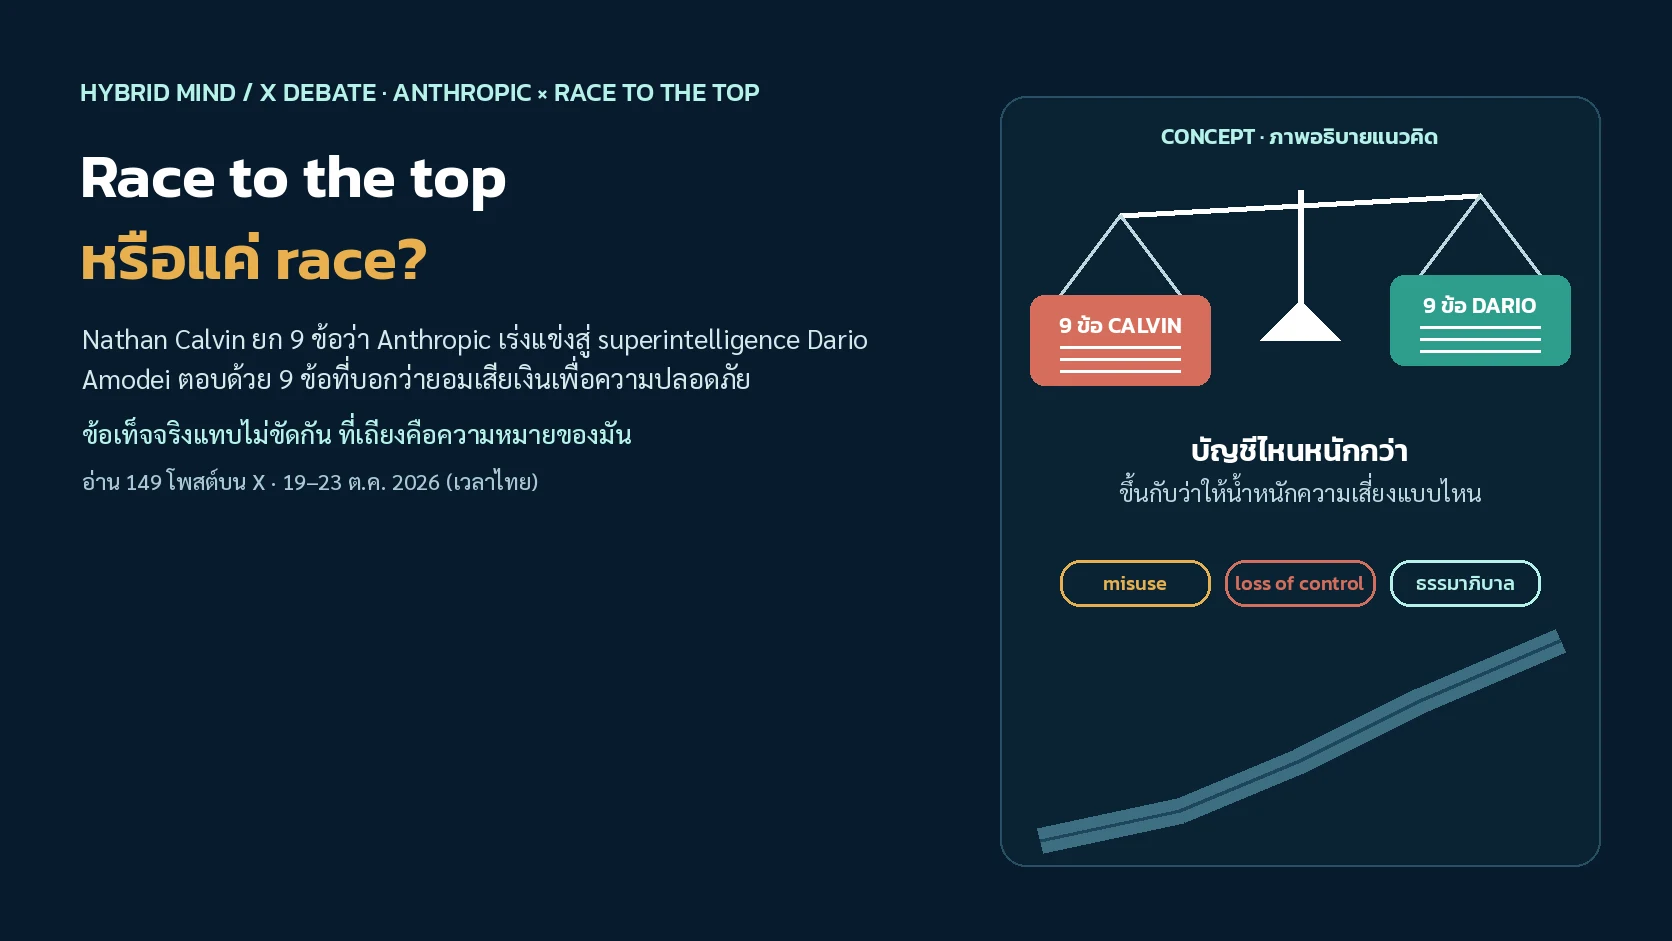
Nathan Calvin จาก Encode AI โพสต์บน X ว่าการกระทำของ Anthropic ในปีที่ผ่านมา “สอดคล้องที่สุด” กับภาพบริษัทที่พยายามชนะการแข่งสร้าง superintelligence โดยมีความปลอดภัยเป็นเรื่องรอง Dario Amodei ซีอีโอของ Anthropic ตอบกลับยาวราว 2,000 คำเมื่อ 21 ต.ค. 2026 (เวลาไทย) พร้อมรายการ 9 ข้อที่เขาบอกว่าทำเพื่อความปลอดภัยแม้เสียเงิน และยืนยันกลยุทธ์ “race to the top”
ข้อเท็จจริงส่วนใหญ่ทั้งสองฝั่งไม่ได้เถียงกัน ที่เถียงกันคือข้อเท็จจริงเหล่านั้นแปลว่าอะไร ฝั่งหนึ่งมองว่าการเสียสละมีจริงและการตอบในที่สาธารณะเป็นเรื่องดี อีกหลายฝั่งบอกว่า Dario ตอบเป็นรายเหตุการณ์ ไม่ได้ตอบปัญหาเชิงระบบ บางคนชี้ว่าการเสียสละเกิดในเรื่องที่ผู้นำเชื่ออยู่แล้ว เช่น bio และจีน ส่วนบางคนเรียกร้องให้หยุดฝ่ายเดียว บทความนี้สรุปจากโพสต์ที่อ่าน 149 โพสต์ และตรวจข้ออ้างหลักกับเอกสารต้นทาง

จากร่างกฎหมายที่หลุดออกมา สู่คำถามว่า “Anthropic คืออะไร”
เรื่องนี้ต่อจากข่าวที่ Hybrid Mind เคยสรุปไว้ คือร่างกฎหมายความปลอดภัย AI ระดับรัฐบาลกลางที่ Anthropic ส่งให้สภาคองเกรส ซึ่งต่อมาถูกเรียกในโพสต์ว่า AEGIS Act หลังจากผู้ดูแลงานนโยบายของ Anthropic ตอบคำวิจารณ์เรื่องร่างนั้น Nathan Calvin ซึ่ง Business Insider ระบุว่าเป็น Chief Strategy Officer ขององค์กร AI safety ชื่อ Encode AI โพสต์ยาวเมื่อ 20 ต.ค. 04:29 น. (เวลาไทย) เขาไม่ได้พูดแค่เรื่องร่างกฎหมาย แต่ถามว่า Anthropic เป็นบริษัทเทคโนโลยีที่ทำเงิน เป็นองค์กรความปลอดภัย AI หรือเป็นองค์กรที่ต้องการสร้างความสามารถระดับเหนือมนุษย์ก่อนคนอื่น
Calvin ยกการกระทำ 9 ข้อของ Anthropic ในปีที่ผ่านมา และสรุปว่าหลักฐาน “seems most consistent to me with the view that Anthropic is primarily trying to win the race to super intelligence” เขาบอกเองว่านี่เป็น “deliberately one sided list” และยอมรับว่า Anthropic ทำงานวิจัยความปลอดภัยที่สำคัญด้วย
วันต่อมา Dario Amodei ตอบกลับเมื่อ 21 ต.ค. 09:26 น. (เวลาไทย) เขาขอบคุณ Calvin บอกว่าบางตัวอย่างเป็นความผิดพลาดจริง แต่ “I disagree with the thrust of your post” แล้วยกรายการของตัวเอง 9 ข้อ Business Insider รายงานเรื่องนี้ในวันเดียวกัน หลังจากนั้นนักข่าว นักวิจัยความปลอดภัย และนักลงทุนก็เข้ามาถกกันต่อ
ตัวเลขทั้งหมดอ่านจาก X API ราว 23 ต.ค. 2026 เวลา 03:55 น. (เวลาไทย) ค่าเปลี่ยนได้ตลอด โพสต์แรกของ Calvin มี 1,453 ไลก์และยอดเห็นราว 581,600 ครั้ง ส่วนโพสต์ตอบรอบสองของเขามี 530 ไลก์
- Politico รายงานร่างกฎหมายที่ Anthropic ส่งให้สภาคองเกรส (สรุปไว้ในบทความก่อนหน้า)
- Anthropic ประกาศ Public Benefit Fund ผูกหุ้น 5% (รอผู้ถือหุ้นอนุมัติ)
- Calvin โพสต์รายการ 9 ข้อ ถามว่า “what is Anthropic?”
- Dario ตอบด้วยรายการ 9 ข้อของตัวเอง ยอมรับว่าบางข้อ “could have handled better”
- Kelsey Piper และ Sigal Samuel (นักข่าว AI ของ Vox) โพสต์ความเห็นที่ถูกแชร์ต่อมาก
- Calvin ตอบรอบสอง ยอมรับว่า Anthropic ไม่ใช่บริษัทที่มุ่งกำไรอย่างเดียว แต่สรุปข้อโต้แย้งใหม่เป็น 4 ข้อ

สองบัญชี 9 ข้อ ที่ข้อเท็จจริงแทบไม่ขัดกัน
จุดที่น่าสนใจคือ Dario ไม่ได้ปฏิเสธข้อเท็จจริงส่วนใหญ่ในรายการของ Calvin เขาจัดกลุ่มคำตอบไว้ชัดเจน ข้อ 1–4 เขาบอกว่าเป็น “simply examples of what it means to compete at the frontier” ข้อ 5 เรื่องการเปลี่ยน Responsible Scaling Policy (RSP) เขาบอกว่าเป็น “the most substantive item” ข้อ 6 เขาสัญญาว่าจะดูเพิ่ม และข้อ 7–9 เขายอมรับว่า “could have handled … better”
| # | รายการของ Calvin (สิ่งที่เขามองว่าเป็นการเร่งแข่ง) | รายการของ Dario (สิ่งที่เขาบอกว่าเสียเงินเพื่อความปลอดภัย) |
|---|---|---|
| 1 | ตั้งทีมทำชิปเองเพื่อเร่งความเร็ว inference | มีบทบาทหลักผลักดัน SB 53 ของแคลิฟอร์เนีย และบอกว่าเคยเสนอให้เข้มกว่าฉบับที่ผ่าน |
| 2 | ทำสัญญา compute มากกว่า 500,000 ล้านดอลลาร์ (อ้าง The Information) | safeguard ด้านชีวภาพที่เข้มจนนักชีววิทยาบ่น และคู่แข่งใช้เป็นจุดขาย |
| 3 | สัดส่วนงานพัฒนา AI ที่ Claude “นำ” เพิ่มจาก 0% (มี.ค.) เป็น 26% (ส.ค.) | มีโมเดลระดับ Mythos ตั้งแต่ ก.พ. แต่ไม่เปิดทั่วไปจนถึง มิ.ย. ให้เฉพาะพาร์ตเนอร์ด้าน cyber defense |
| 4 | ใช้ compute จำนวนมากกับงาน R&D ภายใน ด้วยโมเดลที่ดีกว่าที่เปิดให้สาธารณะ | เรียกร้องให้รัฐมีอำนาจหยุดการปล่อยโมเดลในเรียงความ “Policy on the AI Exponential” |
| 5 | เปลี่ยนเป็น RSP v3 ที่ตัดคำมั่นฝ่ายเดียวว่าจะชะลอหรือหยุด | ท่าทีสาธารณะช่วงเหตุการณ์ ก.พ. 2026 ที่เขาบอกว่าอาจทำร้ายอนาคตบริษัท (ไม่ได้ลงรายละเอียด) |
| 6 | สร้าง Frontier Compliance Framework (FCF) ที่ไม่มีข้อผูกมัดเรื่องการใช้โมเดลภายใน | สนับสนุนการควบคุมส่งออกชิปไปจีน แม้ขัดกับพาร์ตเนอร์ในอุตสาหกรรม |
| 7 | จดหมายถึงสภาคองเกรส (ถอนภายหลัง) ที่อธิบายเหตุ Claude แฮ็กคนอื่นว่าเกิดจาก misconfiguration | จำกัดการขายให้บริษัทที่จีนควบคุม รวมถึงที่ดำเนินงานผ่านประเทศที่สาม และปราบปราม distillation |
| 8 | คำพูด “you can’t do safety from second place” หลังข้อตกลง SI Accords ของทำเนียบขาว | รายงาน model card และงานสื่อสารความเสี่ยงที่ละเอียดเกินกว่าบริษัทที่มุ่งกำไรอย่างเดียวจะทำ |
| 9 | ร่างกฎหมายที่ลบล้างกฎหมายรัฐบางส่วนและตั้งเกณฑ์หยุดโมเดลไว้สูง | ผูกหุ้น 5% (อาจมากขึ้น) เข้า Public Benefit Fund |
สรุปความจากโพสต์ต้นทางของทั้งสองคน ไม่ใช่การแปลคำต่อคำ บางข้อเป็นข้ออ้างที่ Hybrid Mind ยังตรวจกับเอกสารต้นทางไม่ได้ ดูตารางในหัวข้อหลักฐาน

Dario ตอบรายการของ Calvin อย่างไร
Dario ยังเขียนไว้ด้วยว่า หากมองว่าความเสี่ยงสูญเสียการควบคุม (loss of control) สำคัญกว่าการนำไปใช้ผิด (misuse) มาก ผลการชั่งน้ำหนักก็อาจเปลี่ยน “But this is not Anthropic’s view — we view both as serious issues.” ประโยคนี้กลายเป็นหัวใจของการถกต่อในหลายฝั่ง

ทดลอง 01 — ชั่งสองบัญชีด้วยน้ำหนักของคุณเอง
การจำลองเชิงการศึกษา: เราแท็กแต่ละข้อในสองรายการไว้ตามประเภทความเสี่ยงที่ข้อนั้นเกี่ยวข้องมากที่สุด (การแท็กเป็นการตีความของ Hybrid Mind) แล้วให้คุณกำหนดว่าความเสี่ยงแต่ละแบบสำคัญแค่ไหน ผลลัพธ์ไม่ใช่คะแนนความปลอดภัยจริงของบริษัทใด แต่ใช้ดูว่าข้อสรุปเปลี่ยนไปตามน้ำหนักที่เราให้อย่างไร
การนำไปใช้ผิด เช่น อาวุธชีวภาพ cyber จีน
การสูญเสียการควบคุม และการเร่ง AI ที่พัฒนาตัวเอง (RSI)
ธรรมาภิบาล กฎหมายที่ผูกมือบริษัทได้ และความโปร่งใส
มุมมองต่อข้อ 1–4 ของ Calvin
ผลจะบอกว่าบัญชีไหนหนักกว่าภายใต้น้ำหนักที่คุณเลือก
วิธีคิด: แต่ละข้อมีน้ำหนักฐานเท่ากัน แล้วคูณด้วยน้ำหนักของประเภทความเสี่ยงที่ข้อนั้นแท็กไว้ ข้อที่ไม่ชัดว่าเกี่ยวกับความเสี่ยงแบบไหน เช่น ข้อ 5 ของ Dario ที่เขาไม่ได้ลงรายละเอียด จะนับเป็นครึ่งหนึ่ง
6 ฝั่งความเห็นบน X
เราจัดกลุ่มจากโพสต์ที่อ่าน โพสต์บน X เป็นความเห็น ไม่ใช่ข้อเท็จจริง และกลุ่มตัวอย่างนี้ไม่ได้แทนความเห็นของทุกคน คนในวง AI safety และนักข่าวสายนี้มีเสียงดังกว่าคนทั่วไปมากในการถกเรื่องนี้ บัญชีเล็กที่เป็นบุคคลทั่วไปเราสรุปความโดยไม่ระบุชื่อ
01“การเสียสละมีจริง และการตอบในที่สาธารณะคือเรื่องดี”ให้เครดิต
ฝั่งนี้ให้น้ำหนักกับรายการของ Dario ว่าเป็นการตัดสินใจที่เสียรายได้จริง เช่น safeguard ด้านชีวภาพที่ Dario ยอมรับว่ามี false positive สูงจน “biologists joke about how restrictive our classifiers are” และการจำกัดการเข้าถึงโมเดลระดับ Mythos
- แม้แต่ Calvin เองก็เขียนในรอบสองว่า “I agree that Anthropic isn’t best modeled as a profit-maximizer” และขอบคุณที่ Dario ตอบในที่สาธารณะแทนที่จะคุยใน Slack ของบริษัท
- Spenser Skates ซีอีโอของ Amplitude เขียนว่าเขาไม่สงสัยว่าความเชื่อเรื่องความปลอดภัยของ Dario เป็นของจริง (“I don’t doubt it!”) แม้จะมองว่าคำตอบไม่ได้แตะคำถามหลัก
- @So8res ซึ่งเห็นด้วยกับ Calvin มากกว่า ก็ยังเขียนว่า “I’m glad Dario engaged openly and at length!”
- บัญชีสายข่าว AI หลายบัญชีมองว่าการที่ซีอีโอแล็บใหญ่มาเถียงเรื่องความปลอดภัยในที่แจ้งเป็นสิ่งที่ควรมีมากขึ้น
02“ตอบเป็นรายเหตุการณ์ ไม่ได้ตอบปัญหาเชิงระบบ”สาย safety
ฝั่งนี้มองว่าทั้งสองรายการพูดกันคนละเรื่อง Calvin ถามว่าทำไมความผิดพลาดจึงเอียงไปทางที่เป็นประโยชน์กับ Anthropic เสมอ (“why do the mistakes systematically tend to guard and favor Anthropic’s interests?”) แต่ Dario ตอบด้วยรายการสิ่งที่ทำดี
- Martin Casado จาก a16z สรุปว่า “Nathan’s comment was systemic. And Dario’s was anecdotal.”
- Josh Morrison ผู้ก่อตั้ง 1Day Sooner เขียนว่าโพสต์ของ Dario “conflates ‘race’ with ‘race to the top’” เขาเห็นว่า Anthropic เป็นต้นแบบแนวปฏิบัติที่ดีจริง แต่สิ่งใหม่ที่น่ากังวลคือความรู้สึกว่าบริษัทกำลังเร่งความเร็วของทั้งอุตสาหกรรม
- บัญชีเล็กหลายบัญชีชี้ว่ากลยุทธ์นี้พิสูจน์ผิดได้ยาก ถ้าชะลอก็เรียกว่าเสียสละ ถ้าเร่งก็เรียกว่าจำเป็นต้องอยู่แนวหน้า (ลองทดสอบความคิดนี้ในทดลอง 02)
03“เสียสละในเรื่องที่ผู้นำเชื่ออยู่แล้ว แต่ไม่ใช่เรื่อง loss of control”สาย safety
โพสต์ที่ถูกพูดถึงมากที่สุดในกลุ่มนักวิจารณ์มาจาก Kelsey Piper (873 ไลก์) เธอเปิดด้วยการยอมรับว่า “Anthropic has made a lot of costly sacrifices out of conviction” แต่บอกว่าในปีที่ผ่านมา มุมมองแบบเสียดสี (cynical) ทำนายพฤติกรรมของบริษัทได้แม่นกว่ามุมมองแบบมองโลกในแง่ดี
- เธอชี้ว่าการเสียสละส่วนใหญ่อยู่ในเรื่องที่ Dario สนใจเป็นการส่วนตัว คือจีนและ biosecurity แต่ยังไม่ชัดว่ามีการเสียสละเพื่อ “humanity not losing control to AI” แค่ไหน
- เธอมองว่าข้อผูกมัดแบบตายตัวที่ Anthropic เคยตั้งไว้ ถูกแทนด้วยสิ่งที่พึ่งดุลยพินิจของบริษัทมากขึ้น แต่ยกให้ผู้ประเมินที่ฝังตัวภายนอก (embedded evaluators) เป็นข้อยกเว้นที่ดี
- เธอยังกังวลว่าช่องว่างระหว่างโมเดลที่ใช้ภายในกับที่เปิดสาธารณะกำลังกว้างขึ้น และการรายงานเหตุการณ์ยังทำตามดุลยพินิจ
ข้อนี้ตรงกับประโยคที่ Dario เขียนเองว่า ถ้าใครให้น้ำหนัก loss of control มากกว่า misuse ผลการชั่งอาจเปลี่ยน
04“ถ้าจะเร่งสู่ RSI ต้องสนับสนุนกฎหมายที่ผูกมือตัวเองได้”สาย safety
นี่คือแกนของโพสต์รอบสองของ Calvin เขาบอกว่าการเร่งสร้าง AI ที่พัฒนาตัวเองได้ (recursive self-improvement หรือ RSI) มีภาระพิสูจน์สูงมาก และจะพอรับได้ก็ต่อเมื่อความพยายามสร้างธรรมาภิบาลที่แข็งแรงกำลังล้มเหลว แต่เขามองว่า Anthropic มักผลักให้กฎหมายอ่อนลง เช่นใน AEGIS, SB 1047 ฉบับแรก และ RAISE Act ของนิวยอร์ก
- @So8res เขียนว่า “I agree with Nathan over Dario here.” (219 ไลก์)
- @JayShooster มองว่าคำตอบของ Dario ไม่ได้ให้น้ำหนักกับการล็อบบี้มากพอ เพราะนี่เป็นข้อเสนอทางกฎหมายใหญ่ข้อเดียวของบริษัทชั้นนำต่อสภาคองเกรส
- @ohabryka โต้ว่ากลยุทธ์ race to the top ไม่ใช่สิ่งที่ Anthropic ตั้งต้นไว้ตอนก่อตั้ง (ข้อนี้เป็นการตีความประวัติบริษัทของเขา เรายังไม่ได้ตรวจเทียบเอกสารยุคก่อตั้งทั้งหมด)
05“หยุดฝ่ายเดียวก็ได้ นี่ไม่ใช่หมากรุก แต่เป็นรัสเซียนรูเล็ต”สาย safety
Sigal Samuel ถาม Dario ตรง ๆ ว่ามีหลักฐานอะไรว่ากลยุทธ์ race to the top ได้ผลจริง และมองว่าจากภายนอก “Anthropic has done more on net to drive a race to the bottom” วันต่อมาเธอเขียนอีกโพสต์ (295 ไลก์) ว่าแหล่งข่าวของเธอเริ่มพูดออกมาว่า Anthropic และ OpenAI “could just stop unilaterally” และเรียกสถานการณ์ว่า “Russian Roulette”
- Gary Marcus เห็นด้วยกับการเปรียบเทียบนี้
- @GroundhogStrat ผู้บริหารของ PauseAI US ใช้ภาพหมาป่าในคราบแกะเพื่อบอกว่าเชื่อได้ยากขึ้นเรื่อย ๆ ว่า Anthropic เป็นฝ่ายดี
- Malo Bourgon ซีอีโอของ MIRI ชี้ว่าการพูดถึงการเสียสละมักเทียบกับบริษัท AI อื่น แต่ถ้าบริษัทยอมรับเองว่าสิ่งที่สร้างมีโอกาสทำให้มนุษย์สูญพันธุ์ การเทียบแบบนั้นอาจไม่ใช่มาตรวัดที่ถูก
06“ฝั่งตรงข้าม: misuse ถูกพูดเกินจริง และ safeguard ทำร้ายผู้ใช้”มุมอื่น
ไม่ใช่ทุกเสียงวิจารณ์ที่บอกว่า Anthropic ระวังน้อยไป บางคนบอกว่ารายการของ Dario เองคือปัญหา
- บัญชีสาย AI safety และเศรษฐศาสตร์รายหนึ่ง (โพสต์) มองว่า Anthropic ประเมินความเสี่ยง misuse จากโมเดลของตัวเองสูงเกินไป โดยเฉพาะเรื่อง bioweapon uplift เมื่อเทียบกับประโยชน์ของการกระจายการเข้าถึงโมเดลแนวหน้า แต่เขาก็ยังกังวลเรื่องการเร่ง RSI
- ผู้ใช้บางรายบ่นว่าการกรองเรื่องชีวภาพเข้มเกินไป และคำตอบของ Dario ยืนยันว่าจะทำต่อ
- อีกกลุ่มมองว่าการผลักดันกฎหมายคือการสร้างคูเมืองกันคู่แข่ง (regulatory moat) มากกว่าการเสียสละ ซึ่งเป็นข้อกล่าวหาที่ตรงข้ามกับฝั่ง safety ที่บอกว่ากฎหมายที่เสนออ่อนเกินไป

แก่นจริงของการถก: ภาระพิสูจน์อยู่ที่ใคร
เมื่อตัดรายละเอียดออก ทั้งสองฝั่งเห็นตรงกันว่า AI ที่ Anthropic กำลังสร้างมีความเสี่ยงร้ายแรง ทั้งสองฝั่งยังเห็นตรงกันว่า Anthropic ทำบางอย่างที่เสียเงินเพื่อความปลอดภัย จุดที่ไม่ตรงกันคือคำถามว่า การอยู่แนวหน้าของการแข่งขันจะชอบธรรมได้ภายใต้เงื่อนไขอะไร
- Anthropic ดูเหมือนกำลังเร่งสร้าง RSI ซึ่งตามความเห็นของบริษัทเองอาจทำลายโลกได้
- การเสี่ยงระดับนั้นต้องมีเหตุผลรองรับสูงมาก และพอรับได้ก็ต่อเมื่อความพยายามสร้างธรรมาภิบาลที่แข็งแรงกำลังล้มเหลว
- แต่ในเวลาสำคัญ Anthropic มักกันไม่ให้รัฐผูกมือตัวเอง
- ถ้า AEGIS เป็นแค่ความเข้าใจผิด นั่นก็แปลว่าบริษัทยังไม่ให้น้ำหนักกับเรื่องนี้มากพอ
- race to the top ได้ผลมากขึ้นเมื่อบริษัทที่ทำอยู่แนวหน้า ข้อ 1–4 จึงเป็นผลตามปกติของกลยุทธ์ที่ใช้มาหลายปี
- รายการสิ่งที่ทำเพื่อความปลอดภัยแม้เสียเงินหนักกว่ารายการของ Calvin และ “I don’t think it’s a close call”
- ทั้ง misuse และ loss of control เป็นเรื่องร้ายแรง
- บริษัทกำลังเข้าใกล้จุดที่การเร่งเร็วจนความปลอดภัยตามไม่ทัน และนั่นคือเหตุผลที่คิดเรื่อง “pacing”
ข้อสังเกตของ Hybrid Mind: ประโยค “We are nearing that point” ของ Dario เป็นการยอมรับตรง ๆ ว่าความเร็วของ AI อาจแซงหน้าความปลอดภัยเร็ว ๆ นี้ เขาบอกว่าจะ “have more to say soon” แต่ ณ เวลาที่ตรวจ เรายังไม่พบแผน pacing ที่เป็นรูปธรรมเผยแพร่ออกมา

ทดลอง 02 — เหตุการณ์แบบไหนจะบอกได้ว่า race to the top ได้ผลหรือไม่
การจำลองเชิงการศึกษาแบบกำหนดผลล่วงหน้า: เลือกเหตุการณ์สมมติในอนาคต แล้วดูว่าฝั่งที่เชื่อในกลยุทธ์กับฝั่งวิจารณ์จะตีความอย่างไร เหตุการณ์ที่ทั้งสองฝั่งอธิบายได้พอ ๆ กัน ช่วยตัดสินอะไรไม่ได้ ส่วนเหตุการณ์ที่ทำให้ฝั่งหนึ่งอธิบายยาก จึงจะใช้เป็นหลักฐานได้ ทั้งหมดเป็นสถานการณ์สมมติ ไม่ใช่การทำนาย
ผลจะแสดงการตีความของสองฝั่ง และบอกว่าเหตุการณ์นั้นแยกสองสมมติฐานออกจากกันได้หรือไม่
ทดลอง 03 — แบบจำลองของเล่น: แข่งเต็มกำลัง ชะลอ หรือหยุดฝ่ายเดียว
แบบจำลองเชิงการศึกษาที่ Hybrid Mind เขียนสูตรขึ้นเองให้เรียบง่ายที่สุด ไม่ได้มาจากงานวิจัยและไม่ใช่การพยากรณ์ ใช้เพื่อดูว่าเงื่อนไขภายนอกแบบไหนทำให้แต่ละฝั่งดูมีเหตุผลกว่า ค่าที่แสดงเป็นดัชนีสมมติ 0–100 ไม่มีหน่วยจริง
ความแข็งแรงของกฎหมายที่บังคับทุกแล็บ
แล็บอื่นระมัดระวังเองแค่ไหน
แล็บแนวหน้าที่ระวังมีอิทธิพลต่อมาตรฐานอุตสาหกรรมแค่ไหน (สมมติฐานของ race to the top)
การแข่งของแล็บแนวหน้าเร่งคนอื่นให้เร็วขึ้นแค่ไหน (สมมติฐานของฝั่งวิจารณ์)
สูตรสมมติ: ความเร็วอุตสาหกรรม = (0.35 × ความเร็วของแล็บนี้ + 0.65 × ความเร็วแล็บอื่น) × (1 − 0.5 × กฎหมาย) โดยความเร็วแล็บอื่นเพิ่มตามแถบ “การแข่งเร่งคนอื่น” เมื่อแล็บนี้แข่ง · มาตรฐานความปลอดภัย = 20 + 45 × กฎหมาย + 20 × ความระวังของแล็บอื่น + 35 × อิทธิพล × การอยู่แนวหน้า · ช่องว่างความเสี่ยง = ความเร็ว − มาตรฐาน ถ้าติดลบให้เป็น 0
หลักฐานสนับสนุนอะไร และอะไรยังพิสูจน์ไม่ได้
เราตรวจข้ออ้างหลักในทั้งสองรายการกับเอกสารของ Anthropic และสื่อที่เชื่อถือได้ ข้อที่ไม่มีเอกสารสาธารณะให้ตรวจ เราระบุว่ายังไม่ยืนยัน ซึ่งไม่ได้แปลว่าข้อนั้นเป็นเท็จ
| ข้ออ้าง | สถานะ | สิ่งที่พบ |
|---|---|---|
| RSP v3 ตัดคำมั่นว่าจะหยุดหากคุมความเสี่ยงไม่ได้ (Calvin ข้อ 5) | ยืนยัน | RSP v3.0 (24 ก.พ. 2026) แยกแผนของบริษัทออกจาก “industry-wide recommendations” ที่บริษัทบอกว่าทำฝ่ายเดียวไม่ได้ GovAI สรุปว่าไม่มีถ้อยคำที่สื่อว่าจะหยุดแล้ว และ v3.1 ระบุเพิ่มว่ายังหยุดได้ตามดุลยพินิจ |
| ผูกหุ้น 5% เข้า Public Benefit Fund (Dario ข้อ 9) | ยืนยัน | ประกาศ 18 ต.ค. 2026 ต้องรอผู้ถือหุ้นอนุมัติ เป็น LLC ไม่ใช่มูลนิธิ ส่วนโครงสร้างธรรมาภิบาลและเกณฑ์มูลค่าจะประกาศภายหลัง |
| จำกัดการขายให้บริษัทที่จีนควบคุม รวมบริษัทลูกในประเทศอื่น (Dario ข้อ 7) | ยืนยัน | นโยบายเมื่อ 4 ก.ย. 2025 ห้ามบริษัทที่ถือหุ้นเกิน 50% โดยบริษัทจากภูมิภาคที่ไม่รองรับ คำว่า “first, and still only” เรายังตรวจเทียบกับทุกบริษัทไม่ได้ |
| สนับสนุน SB 53 (Dario ข้อ 1) | ยืนยันบางส่วน | Anthropic ประกาศสนับสนุน SB 53 ในปี 2025 และร่างนี้ผ่านเป็นกฎหมาย แต่ข้ออ้างว่าบริษัทเคยเสนอฉบับที่เข้มกว่า เรายังไม่พบเอกสารสาธารณะยืนยัน |
| มีโมเดลระดับ Mythos ตั้งแต่ ก.พ. แต่รอถึง มิ.ย. (Dario ข้อ 3) | ยืนยันบางส่วน | เอกสารนักพัฒนาระบุว่า Claude Mythos 5 ออกเมื่อ 9 มิ.ย. 2026 และยังต้องยืนยันตัวตนองค์กรก่อนใช้ แต่ Reuters รายงานว่ารัฐบาลสหรัฐฯ มีบทบาทในการระงับและคืนสิทธิ์การเข้าถึงด้วย การรอจึงไม่ได้เป็นการตัดสินใจของบริษัทฝ่ายเดียวทั้งหมด |
| สัญญา compute เกิน 500,000 ล้านดอลลาร์ (Calvin ข้อ 2) | ยังไม่ยืนยัน | Calvin อ้าง The Information ซึ่งเราเข้าถึงต้นฉบับไม่ได้ |
| งานพัฒนา AI ที่ Claude “นำ” เพิ่มเป็น 26% (Calvin ข้อ 3) | ยังไม่ยืนยัน | เราไม่ได้ตรวจเอกสารต้นทางของตัวเลขนี้ |
| race to the top ยกมาตรฐานทั้งอุตสาหกรรมได้จริง | ยังพิสูจน์ไม่ได้ | เป็นคำถามของ Sigal Samuel ที่ยังไม่มีใครตอบด้วยข้อมูล ทั้งสองฝั่งยกตัวอย่างได้ แต่ยังไม่มีการวัดผลอย่างเป็นระบบ |
| มีแผน pacing ชะลอเมื่อความปลอดภัยตามไม่ทัน | ยังไม่เผยแพร่ | Dario บอกว่า “We are nearing that point” และจะพูดเพิ่ม “soon” ณ เวลาที่ตรวจยังไม่พบเอกสาร |
สิ่งที่หลักฐานสนับสนุน
- Anthropic ทำหลายอย่างที่ยอมเสียรายได้ระยะสั้นจริง เช่น นโยบายจีนและการจำกัดการเข้าถึง ซึ่ง Calvin ก็ยอมรับในรอบสอง
- RSP เปลี่ยนจากคำมั่นฝ่ายเดียวไปเป็นคำแนะนำระดับอุตสาหกรรมจริง Dario ไม่ได้ปฏิเสธ แต่ให้เหตุผลว่าฉบับเดิมแข็งเกินไป
- Dario ยอมรับเองว่าข้อ 7–9 จัดการได้ไม่ดี และกำลังเข้าใกล้จุดที่ความปลอดภัยตามไม่ทัน
สิ่งที่ยังพิสูจน์ไม่ได้
- ว่าแรงจูงใจจริงของบริษัทคืออะไร ทั้งสองฝั่งใช้ข้อเท็จจริงชุดเดียวกันอ่านแรงจูงใจต่างกัน
- ว่าการอยู่แนวหน้าช่วยยกมาตรฐานอุตสาหกรรมมากกว่าที่เร่งการแข่งขันหรือไม่
- ว่าการหยุดฝ่ายเดียวจะชะลอทั้งอุตสาหกรรมได้จริง หรือแค่ส่งแนวหน้าให้แล็บที่ระวังน้อยกว่า

เอาไปใช้อย่างไร แยกตามผู้อ่าน
ผู้อ่านทั่วไป
- อ่านรายการ “สิ่งที่ทำดี” กับ “สิ่งที่ทำพลาด” ของบริษัทใดก็ตาม โดยถามเสมอว่าแต่ละข้อเกี่ยวกับความเสี่ยงแบบไหน misuse, loss of control หรือธรรมาภิบาล
- แยกข้อเท็จจริงออกจากการตีความ ข้อเท็จจริงในเรื่องนี้แทบไม่ถูกโต้แย้ง สิ่งที่ต่างกันคือการอ่านแรงจูงใจ
นักพัฒนาและทีมที่ใช้ Claude
- ผลที่เห็นได้ทันทีคือ safeguard ด้านชีวภาพและ cyber จะยังเข้มต่อไป Dario ยืนยันเอง ถ้างานของคุณเกี่ยวกับสายนี้ ให้ดูโปรแกรมยืนยันตัวตน เช่น Life Sciences Verification Program หรือ Cyber Verification Program
- เผื่อแผนสำรองเมื่อคำขอถูกปฏิเสธแบบ false positive และอย่าออกแบบระบบที่พังทันทีเมื่อโมเดลไม่ตอบ
องค์กรที่ซื้อบริการ AI
- ขอดู Risk Report, model card และนโยบายการเข้าถึงของผู้ให้บริการแต่ละราย อย่าตัดสินจากชื่อเสียงว่า “ปลอดภัยกว่า” อย่างเดียว
- ติดตามว่าคำมั่นข้อไหนเป็นข้อผูกมัดจริง ข้อไหนเป็นแค่เป้าหมายหรือคำแนะนำ เช่นที่ RSP v3 แยกไว้
คนทำนโยบาย สื่อ และนักวิจัย
- คำถามของ Sigal Samuel ยังเปิดอยู่ ใครวัดได้ว่า race to the top ยกมาตรฐานจริงหรือไม่ จะเป็นหลักฐานที่ทั้งสองฝั่งยังขาด
- ดูว่าข้อเสนอกฎหมายจากบริษัทใดก็ตาม ให้อำนาจรัฐหยุดก่อนเกิดความเสียหายแค่ไหน และลบล้างกฎหมายรัฐแค่ไหน
เช็กลิสต์สั้นสำหรับอ่านคำแถลงด้านความปลอดภัยของบริษัท AI
1. ข้อนี้เกี่ยวกับความเสี่ยงแบบไหน: misuse / loss of control / ธรรมาภิบาล
2. เป็นข้อผูกมัดที่ตรวจได้ หรือเป็นเป้าหมายตามดุลยพินิจ
3. ใครตรวจได้บ้าง: บริษัทเอง / ผู้ประเมินภายนอก / หน่วยงานรัฐ
4. ถ้าบริษัทไม่ทำตาม จะมีผลอะไร
5. เหตุการณ์แบบไหนจะพิสูจน์ได้ว่าคำแถลงนี้ผิด
อ่านต่อบน Hybrid Mind
- Anthropic Draft AI Safety Bill: X ถกเบรกที่ดึงยาก เกณฑ์ $1B หรือ 50 คน และการปิดทางกฎหมายรัฐ (ต้นเรื่องของการโต้ตอบครั้งนี้)
- Anthropic × METR: X ถกสิทธิ์แบบพนักงาน — ความโปร่งใสจริง หรือแค่จับตาจากในบ้าน?
- roon “Alignment Has Not Been Solved”: X ถกควรชะลอ AI ที่พัฒนาตัวเอง หรือเป็นเบรกที่ไม่มีใครเหยียบ
- Anthropic Q3 $16.8B: X ถก IPO $2T — รายได้โตจริง แต่โตช้าลงและกำไรยังเป็นแบบ Adjusted
- Anthropic “9 เดือน” vs Altman “ผิดเรื่องความเร็ว”: X ถกนาฬิกา AI สองเรือน
คำถามที่พบบ่อย
1. “race to the top” ของ Anthropic คืออะไร?
เป็นกลยุทธ์ที่ Dario Amodei อธิบายว่า ถ้าบริษัทแสดงให้เห็นว่าสร้าง AI อย่างรับผิดชอบได้ ก็จะยกมาตรฐานของทั้งอุตสาหกรรม และแรงกดดันนี้ได้ผลกว่าเมื่อบริษัทอยู่แนวหน้า ฝั่งวิจารณ์ถามว่ามีหลักฐานว่ามันได้ผลหรือไม่ ซึ่งยังไม่มีการวัดผลอย่างเป็นระบบ
2. Dario ยอมรับว่า Anthropic ทำผิดหรือไม่?
ยอมรับบางส่วน เขาบอกว่าข้อ 7, 8 และ 9 ในรายการของ Calvin (จดหมายถึงสภาคองเกรส คำพูดเรื่อง “second place” และร่างกฎหมาย) “could have handled better” และรับผิดชอบในฐานะซีอีโอ แต่ยืนยันว่าข้อ 1–4 เป็นการแข่งขันปกติ และปกป้องการเปลี่ยน RSP
3. Calvin ถอนคำวิจารณ์หลังได้คำตอบหรือไม่?
ไม่ได้ถอน เขายอมรับว่า Anthropic ไม่ใช่บริษัทที่มุ่งกำไรอย่างเดียว แต่สรุปข้อโต้แย้งใหม่ว่า การเร่งสร้าง RSI จะชอบธรรมได้ก็ต่อเมื่อบริษัทสนับสนุนธรรมาภิบาลที่ผูกมือตัวเองได้ และเขามองว่าประวัติด้านนโยบายของบริษัทชี้ไปทางตรงข้าม
4. RSP v3 ตัดคำมั่นว่าจะหยุดพัฒนาจริงหรือ?
จริงตามเอกสาร RSP v3.0 แยกแผนที่บริษัททำเองออกจากคำแนะนำระดับอุตสาหกรรมที่บริษัทบอกว่าทำฝ่ายเดียวไม่ได้ และ GovAI สรุปว่าไม่มีถ้อยคำที่สื่อว่าจะหยุดแล้ว ต่อมา v3.1 ระบุว่ายังหยุดได้ตามดุลยพินิจ Dario ให้เหตุผลว่าฉบับเดิมแข็งเกินไป
5. ถ้าใช้ Claude อยู่ เรื่องนี้กระทบอะไรบ้าง?
ผลระยะสั้นที่ชัดที่สุดคือ safeguard ด้านชีวภาพและ cyber จะยังเข้มอยู่ เพราะ Dario ยืนยันว่าจะทำต่อ ส่วนคำถามใหญ่เรื่องความเร็วของการแข่งขันและกฎหมาย ยังไม่มีผลต่อการใช้งานทันที แต่ควรติดตามว่า Anthropic จะประกาศแผน pacing อย่างไร
เอกสารอ้างอิงและขอบเขตการตรวจ
- โพสต์ต้นทาง: Nathan Calvin (20 ต.ค. 04:29 น. เวลาไทย) · Dario Amodei (21 ต.ค. 09:26 น.) · Nathan Calvin รอบสอง (22 ต.ค. 21:18 น.)
- ความเห็นที่อ้างถึง: @KelseyTuoc · @SigalSamuel (1) · @SigalSamuel (2) · @spenserskates · @martin_casado · @joshcmorrison · @So8res · @JayShooster · @ohabryka · @GaryMarcus · @GroundhogStrat · @m_bourgon
- Business Insider: Dario Amodei spent 2,000 words laying out to a critic on X why Anthropic must persist in the AI ‘race to the top’ (21 ต.ค. 2026)
- Anthropic: Responsible Scaling Policy Version 3.0 · RSP Updates · GovAI: Anthropic’s RSP v3.0 — How it Works, What’s Changed
- Anthropic: Investing in the public benefit (18 ต.ค. 2026)
- Anthropic: Updating restrictions of sales to unsupported regions (4 ก.ย. 2025)
- Anthropic: Anthropic is endorsing SB 53
- Claude Docs: Claude Mythos 5 overview · Reuters: US allows Anthropic to release Mythos AI to ‘trusted’ US organizations (26 มิ.ย. 2026)
- Anthropic: Core Views on AI Safety (2023) ซึ่ง Calvin ยกข้อความเรื่อง “sound the alarm” มาอ้าง
ขอบเขตการตรวจ: Hybrid Mind อ่านโพสต์บน X ที่ไม่ซ้ำกัน 149 โพสต์ (เป็นรีโพสต์ 17 โพสต์) ผ่านเครื่องมือค้นหาและอ่านโพสต์สาธารณะของ X ในช่วง 19 ต.ค. 07:00 น. ถึง 23 ต.ค. 03:55 น. (เวลาไทย) รวมโพสต์ต้นทาง คำตอบ โพสต์อ้างอิง และโพสต์จากบัญชีที่มีบทบาทในการถก โพสต์ที่มีคำว่า Dario/Amodei/Anthropic ร่วมกับ Calvin หรือ “race to the top” นับได้ 304 โพสต์ (รวมรีโพสต์) ชั่วโมงที่มากที่สุดคือ 21 ต.ค. 11:00–12:00 น. ที่ 27 โพสต์ ตัวเลขนี้ต่ำกว่าการพูดถึงจริง เพราะคำตอบส่วนใหญ่ไม่มีคำค้นเหล่านี้ เช่น โพสต์ของ Dario มีคำตอบ 761 รายการ
เราไม่ได้อ่านคำตอบทั้งหมด ไม่ได้วัดสัดส่วนความเห็นของแต่ละฝั่ง และไม่ได้เข้าถึงบทความของ The Information การแท็กประเภทความเสี่ยงในทดลอง 01 และสูตรในทดลอง 03 เป็นการตีความและแบบจำลองของ Hybrid Mind เอง ไม่ใช่ข้อมูลของ Anthropic หรือผู้วิจารณ์
ใส่ความเห็น