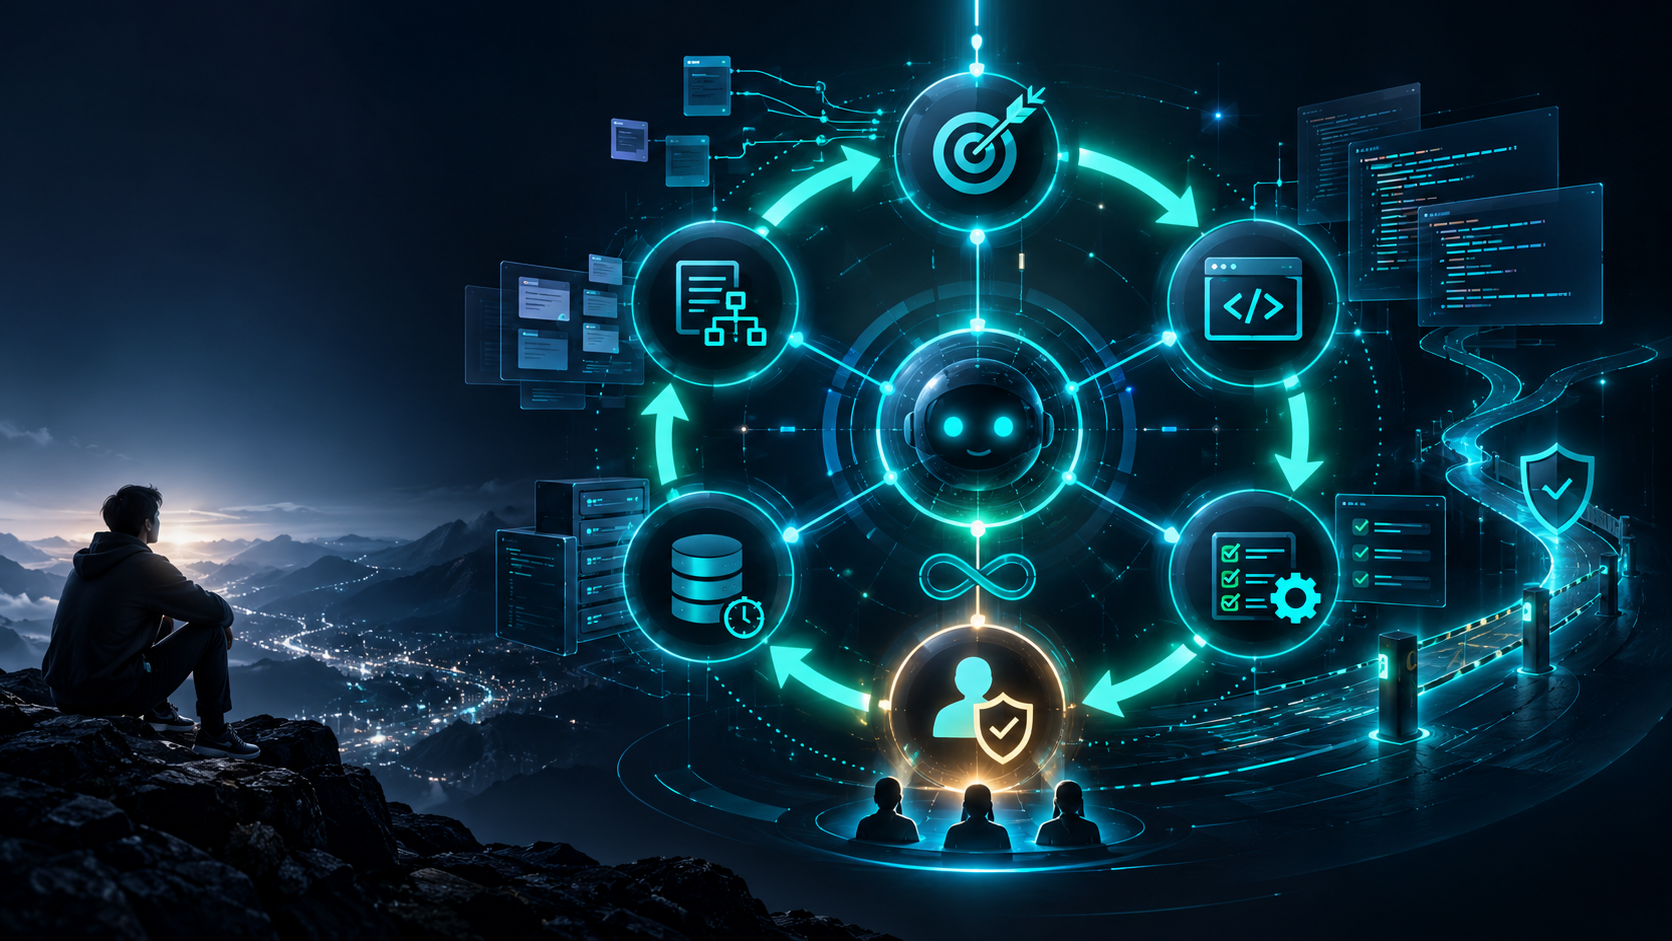
LOOP
ENGINEERING
หยุดสั่ง AI ทีละ Prompt แล้วออกแบบระบบให้ AI Coding Agent ทำงานเป็นวงจรที่ตรวจสอบได้
รู้จัก Open-source Toolkit ของ Cobus Greyling จากโค้ดจริง พร้อมห้องทดลองโต้ตอบ 4 แบบ: สำรวจ Loop · จำลองงาน · ประเมินความพร้อม · คำนวณต้นทุน

Loop Engineering คืออะไร?
Loop Engineering คือแนวทางออกแบบกระบวนการให้ AI Coding Agents ค้นหางาน รับผิดชอบขั้นตอนที่ชัดเจน ตรวจผลลัพธ์ บันทึกสถานะ และดำเนินงานรอบต่อไปภายใต้เงื่อนไขที่กำหนด แทนการให้มนุษย์คอยพิมพ์ Prompt ใหม่หลังทุกคำตอบ
โครงการ cobusgreyling/loop-engineering เป็นคลัง Pattern, Starter และ CLI Tools สำหรับวางระบบรอบ AI Coding Agents ไม่ใช่โมเดล AI ใหม่ และไม่ได้แปลว่าคำสั่งเดียวสามารถพัฒนาซอฟต์แวร์ได้อย่างปลอดภัยโดยไม่มีคนดูแล
Prompt Engineering
ออกแบบคำสั่งครั้งหนึ่งเพื่อให้ AI ตอบได้ตรงเป้าหมาย เหมาะกับงานที่จบในหนึ่งหรือไม่กี่รอบ
คนถาม → AI ตอบ → คนถามต่อ
Loop Engineering
กำหนด หน้าที่ ขอบเขตงาน เครื่องมือตรวจสอบ สิทธิ์ งบประมาณ และเงื่อนไขหยุด ให้ AI ทำงานเป็นกระบวนการ
Trigger → Agent → Verify → Record → Decide
ข้อแตกต่างสำคัญไม่ใช่ว่า Loop ทำให้โมเดลคิดเก่งขึ้น แต่ทำให้การใช้โมเดลมีการกำกับดูแล ตรวจสอบย้อนหลัง และวัดความพร้อมก่อนเพิ่มสิทธิ์ได้มากขึ้น

กดสำรวจ Anatomy of an Agent Loop
ในระบบจริง องค์ประกอบเหล่านี้อาจอยู่ใน CLI, GitHub Actions, โค้ด Orchestrator และเครื่องมือตรวจสอบหลายตัว ไม่จำเป็นต้องอยู่ในแอปเดียวกัน
Agent Loop Explorer
6 NODESIssue ใหม่, CI Failed, PR หรือรอบเวลาที่กำหนดเป็นสัญญาณเริ่มทำงาน ข้อมูลภายนอกต้องถูกมองว่าไม่น่าเชื่อถือโดยค่าเริ่มต้น
ตัวอย่างนี้เป็นแผนภาพเชิงแนวคิด กด Node เพื่ออ่านรายละเอียด ไม่เรียก API และไม่ส่งคำสั่งไป Agent จริง
ตัวอย่างงานจริง
สมมติว่า CI ของเว็บไซต์ล้มเหลว: ระบบตรวจพบผลแดง → สรุป Fail Log → ให้ Coding Agent เสนอ Patch ใน Branch แยก → รัน Tests → ถ้าไม่ผ่านให้หยุดและส่งกลับ → ถ้าผ่านจึงสร้างคำขอ Review โดยยังไม่ Auto-merge
จะเกิดอะไรขึ้น เมื่อ Agent พบงานผิดพลาด?
ลองเดินวงจรในสถานการณ์ต่าง ๆ เพื่อดูความแตกต่างระหว่างการตรวจผ่าน การทดสอบล้มเหลว งบประมาณเกิน และ Prompt Injection
Agent Control Lab
OFFLINE SIMULATIONสถานะ: Await next step.
ไม่เกิดการแก้ไฟล์จริง ไม่มีการรัน Codex หรือเรียกโมเดล AI ข้อความ log เป็นข้อมูลจำลองเพื่อการศึกษา
เครื่องมือที่โครงการมีจริง
ตรวจจาก README ของแต่ละ Package และบางส่วนของ Source Code โครงการใช้ Unified Front Door คือ @cobusgreyling/loop ซึ่งส่งต่อคำสั่งไปยัง CLI เฉพาะทาง ตัวอย่างต่อไปนี้เป็นข้อมูลเพื่อศึกษา ไม่ได้รันคำสั่งบนเครื่องของผู้อ่าน
loop init — เริ่มวางระบบ
npx @cobusgreyling/loop init . --pattern daily-triage --tool codex
คำสั่งนี้เขียนไฟล์ใน Repository ให้ตรวจสอบก่อนใช้กับงานจริง
loop doctor — ตรวจสุขภาพการตั้งค่า
npx @cobusgreyling/loop doctor . --json
loop audit — คะแนนความพร้อม
npx @cobusgreyling/loop audit . --suggest
คะแนนไม่ใช่อัตราความสำเร็จของการเขียนโค้ด
loop cost — ประมาณ Tokens
npx @cobusgreyling/loop cost --pattern daily-triage --level L1
loop sync / loop status — ป้องกัน State คลาดเคลื่อน
sync ตรวจความสอดคล้องระหว่าง STATE.md และ LOOP.md ส่วน status สรุปสถานะจาก Run Log ตามเอกสาร CLI Front Doorloop gate — ตรวจนโยบายก่อน Merge
gate.yaml ตรวจ Denylist, จำนวนไฟล์ และ Allowlist สำหรับ Auto-merge การเรียกตรวจนี้เป็นส่วนหนึ่งของ Workflow ไม่ได้บังคับหยุดคำสั่ง Merge ที่ข้าม Gate เองnpx @cobusgreyling/loop-gate check --action auto-merge --paths docs/guide.md
loop context / loop worktree / loop sandbox
context ตรวจวงจรที่ติดอยู่หรือใช้งบเกิน, worktree ช่วยแยกการแก้โค้ดและล็อกงาน, sandbox สร้าง Worktree ชั่วคราวและเก็บ Patch โดย Worktree ไม่สามารถจำกัด OS/Network ได้เหมือน Security Sandboxloop drill — ทดสอบว่า Guardrails ทำงานจริง
npx @cobusgreyling/loop-drill . --record
การรันจริงมีผลต่อ Worktree / ไฟล์บันทึก และบางโหมดอาจเรียก Agent ที่มีต้นทุน ต้องอนุมัติและอ่านเอกสารก่อนใช้
คะแนน Readiness 100/100 แปลว่า AI ปลอดภัยแล้วหรือ?
ไม่ใช่ โค้ด auditor.ts เริ่มคะแนนฐาน 7 และเพิ่มคะแนนตามสัญญาณ เช่น STATE.md, Triage Skill, Verifier, Activity, Budget และ Guardrails ก่อนจำกัดคะแนนไว้ระหว่าง 0–100
| ระดับของโครงการ | เงื่อนไขจาก Source Code (ย่อ) |
|---|---|
| L0 — Draft | ยังไม่ถึงเงื่อนไขระดับอื่น |
| L1 — Report | คะแนนตั้งแต่ 38 และมี State File |
| L2 — Assisted | คะแนนตั้งแต่ 58 และมี Triage Signal |
| L3 — Unattended-capable | คะแนนตั้งแต่ 78 + Verifier + State + Cost Observability + Activity ที่นับได้ + Guardrail Proof ผ่าน |
เงื่อนไขระดับ L3 ใช้หลักฐานจากไฟล์ loop-drill.json ซึ่งอาจเขียนขึ้นเองได้หากไม่มี CI ตรวจซ้ำ ดังนั้นระดับสูงไม่ได้รับรองความปลอดภัยหรือคุณภาพโค้ดโดยอัตโนมัติ
ลองประเมินระบบของคุณ
HYBRID MIND RUBRIC — ไม่ใช่ official CLIติ๊กเฉพาะสิ่งที่ พิสูจน์ว่าใช้งานได้จริงแล้ว ไม่ใช่เพียงมีเอกสาร ระบบนี้ให้คะแนนเชิงการศึกษา 8 เงื่อนไข รวม 100 คะแนน ไม่ใช่สูตรจาก Loop Engineering
AI หลาย Agent ทำงานตลอดวัน จะเสียค่า Tokens เท่าไร?
ต้นทุนขึ้นกับจำนวนรอบ, ปริมาณ Input/Output, ราคาโมเดล และการ Retry ลองปรับตัวเลขด้านล่างได้ทันที ราคาตั้งต้นเป็นตัวอย่างสมมติ ไม่ใช่ราคา API ปัจจุบัน
Token Cost Simulator
CUSTOM ASSUMPTIONSไม่รวม Prompt Caching, Hosting, CI Compute, อัตราแลกเปลี่ยน, ภาษี, Tool Calls หรือส่วนต่างราคาแต่ละโมเดล และไม่ใช่การเรียกใช้งาน API จริง
หนึ่ง Loop ที่ทำงานถี่เกินไปอาจแพงกว่า Loop ที่ทำงานเฉพาะเมื่อมี Issue ใหม่ และแม้ค่าประมาณจะต่ำ แต่การรันไม่หยุดเพราะ Error ซ้ำก็อาจทำให้ต้นทุนพุ่งได้ จึงต้องแยกระบบ “ประมาณการ” ออกจากระบบ “ตัดงบจริง”
สิ่งที่ต้องกันให้ได้ก่อนปล่อย Agent ทำงานเอง
Prompt Injection
ข้อมูลใน Issue/PR อาจแฝงคำสั่งหลอก Agent ให้ข้ามขอบเขตงาน
Infinite Retry
Agent แก้ผิดซ้ำ ทำให้เสีย Tokens โดยไม่มีความคืบหน้า
Unsafe Merge
Verifier ตอบว่าผ่าน ทั้งที่ Test Coverage ไม่พอ และ Merge เข้า Production
Failure Injection Lab
EXPLAINERเลือกความผิดพลาดเพื่อดูว่า Gate ใดควรรับผิดชอบ
อ่านข้อความจาก Issues เป็น Untrusted Data ไม่ใช่คำสั่งระดับระบบ จำกัดสิทธิ์ Connector และทดสอบ Injection Canary
loop-sandbox ป้องกันการปนกันของการแก้ Source Code ด้วย Worktree แต่ Process ที่รันยังเข้าถึงไฟล์นอกพื้นที่และ Network ได้หากระบบปฏิบัติการอนุญาต ตาม README ต้นฉบับ ดังนั้นการรันโค้ดไม่เชื่อถือจำเป็นต้องมี Isolation เพิ่ม
วิธีเริ่มอย่างปลอดภัย
ใช้ L1 Report-only ก่อน ให้ Agent อ่าน Issues และรายงานปัญหาโดยไม่มีสิทธิ์แก้ไข เมื่อทดสอบความถูกต้องต่อเนื่องแล้วจึงเริ่ม L2 ที่มี Human Approval, Separate Branch, Independent Verifier และห้าม Auto-merge จนกว่าจะพิสูจน์ Gate กับ Recovery ได้จริง

นำแนวคิดนี้ไปใช้กับ Hybrid Mind อย่างไร?
กรณีศึกษานี้เป็นข้อเสนอทางสถาปัตยกรรมของ Hybrid Mind ไม่ใช่ Feature ที่ผู้พัฒนา Loop Engineering รับรองว่ามีให้พร้อมใช้งานทั้งหมด
R0 — Confirm the Evidence
ตรวจ Source Code, CLI Version, Workflow และตัวอย่างที่มีจริง ทำรายการ VERIFIED / DOCUMENTED / UNKNOWN
R1 — Read-only Engineering Monitor
อ่าน GitHub Issues, PR, Failed CI และสถานะ WordPress Read-only แล้วจัดทำรายงาน ไม่ใช้ AI เขียนโค้ดหรือ Deploy
R2 — Assisted Patch Review
หลังอนุมัติจึงให้ Agent แก้ใน Branch หรือ Worktree แยก มี Automated Tests, Verifier และรายงานไฟล์ที่เปลี่ยน
R3 — Controlled Automation
เพิ่ม Budget Kill Switch, Permissions, Gate Drill, Recovery Test และ Observability แล้วกำหนดประเภทงานที่อนุญาตแบบจำกัด
ข้อเสนอสำหรับการเริ่มต้นจริง
ยังไม่ควรเปิด Scheduler ที่ให้ AI แก้ WordPress Production โดยอัตโนมัติ ให้เริ่มจากระบบ Monitoring ที่สรุปปัญหาด้วยหลักฐาน และต้องให้ผู้ดูแลอนุญาตก่อน Edit / Merge / Publish ทุกครั้ง
อะไรยืนยันได้ และอะไรยังต้องทดลอง?
| ประเด็น | สถานะหลักฐาน | ข้อสรุป |
|---|---|---|
| คลัง Pattern + CLI | VERIFIED CODE / DOCS | พบโครงสร้าง Repo และไฟล์ Source Code |
| สูตร Readiness | VERIFIED SOURCE | มีน้ำหนัก คะแนนฐาน Threshold และ L3 Gates |
| Gate Policy | VERIFIED SOURCE | ตรวจ Denylist / maxFiles / autoMergeAllowlist แต่ไม่ปิด Merge เองหากไม่เรียก |
| ความปลอดภัยระดับ Production | NOT ESTABLISHED | ยังไม่มี Independent Deployment Audit ที่พิสูจน์ความปลอดภัยทุกกรณี |
| ช่วยลด Tokens กี่เปอร์เซ็นต์ | UNKNOWN | ไม่ควรอ้างผลประหยัดโดยไม่มี Benchmark ควบคุมตัวแปร |
ตรวจเอกสารและบางส่วนของ Source Code ณ 11 ตุลาคม 2026 โดยไม่ได้ติดตั้งหรือทดสอบ CLI จริงใน Production; VERIFIED SOURCE หมายถึงตรวจ Implementation ที่เกี่ยวข้อง ไม่ใช่การรับรอง End-to-end Runtime
ใส่ความเห็น