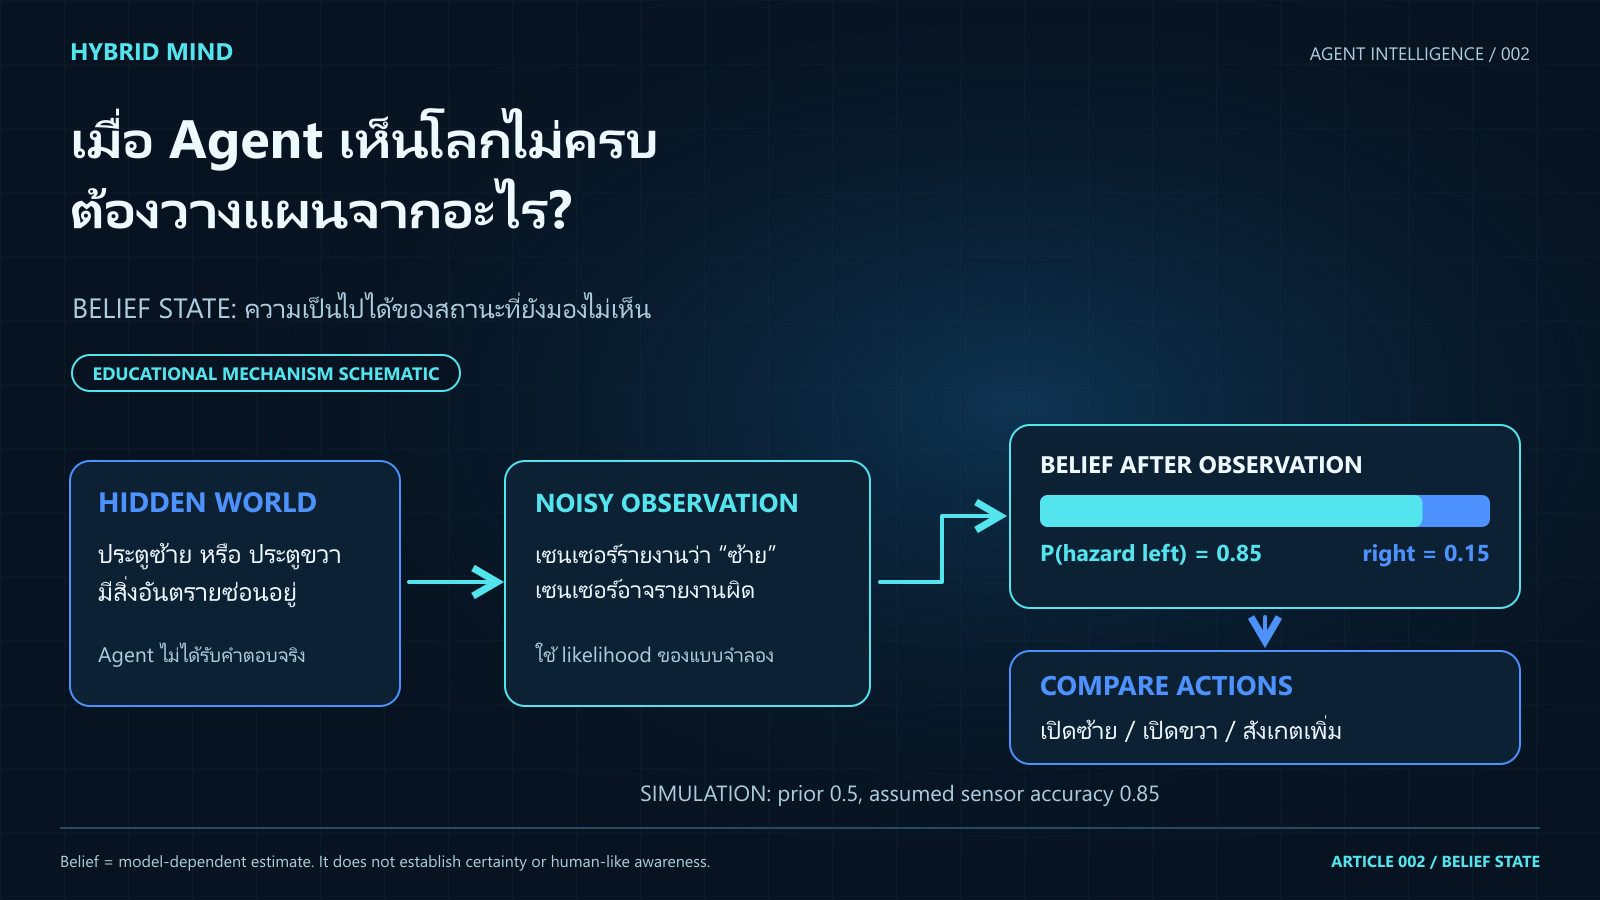
คำตอบโดยตรง: Belief State คือการแจกแจงความน่าจะเป็นของสถานะที่ Agent ยังมองไม่เห็นครบ ระบบใช้แบบจำลองการเปลี่ยนสถานะและความน่าเชื่อถือของข้อมูลสังเกตเพื่ออัปเดตการแจกแจงนี้ แล้วเลือกการกระทำโดยคำนึงถึงผลลัพธ์หลายแบบ รวมถึงการสังเกตเพิ่มก่อนตัดสินใจ ความน่าจะเป็นดังกล่าวมีความหมายภายใต้สมมติฐานของโมเดล ไม่ใช่หลักฐานว่า AI รู้ความจริงหรือมีความมั่นใจแบบมนุษย์

ทำไมการเห็นโลกไม่ครบจึงเปลี่ยนวิธีออกแบบ Agent
หุ่นยนต์เห็นทางเดินผ่านกล้องที่มีมุมอับ ผู้ช่วยงานเอกสารเห็นเพียงข้อความล่าสุด แต่ไม่รู้ว่ารายการในระบบภายนอกเปลี่ยนไปแล้วหรือยัง Agent ที่จองทรัพยากรเห็นผลเรียก API ซึ่งอาจล่าช้าหรือขัดกัน สิ่งที่ระบบได้รับคือ Observation — ข้อมูลสังเกต ไม่จำเป็นต้องเท่ากับ State — สถานะของโลก ที่มีผลต่อการตัดสินใจ
บทความก่อนหน้าเรื่อง World Model ของ AI Agent อธิบายว่าโมเดลช่วยคาดการณ์ผลการกระทำอย่างไร เรื่องนี้ลงลึกอีกขั้น: เมื่อไม่รู้ว่าสถานะปัจจุบันเป็นแบบใด Agent จะเก็บความเป็นไปได้ อัปเดตจากข้อมูลใหม่ และชั่งต้นทุนของการสังเกตเพิ่มอย่างไร
รากฐานทางวิทยาศาสตร์: จาก State ไปสู่ Belief
POMDP กำหนดสิ่งที่รู้และสิ่งที่ต้องประมาณ
Partially Observable Markov Decision Process หรือ POMDP เป็นกรอบทางคณิตศาสตร์สำหรับการตัดสินใจเมื่อสถานะมองเห็นไม่ครบ โดยระบุสถานะ การกระทำ ข้อมูลสังเกต กฎการเปลี่ยนสถานะ ความน่าจะเป็นของข้อมูลสังเกต และผลตอบแทน ภายใต้แบบจำลองที่กำหนดถูกต้อง Belief ทำหน้าที่เป็นสถิติที่เพียงพอสำหรับการตัดสินใจจากประวัติที่ผ่านมา ไม่ได้หมายความว่าประวัติของระบบจริงทุกชนิดย่อได้โดยไม่มีการสูญเสียสาระเสมอไป Kaelbling, Littman และ Cassandra, 1998
ตัวอย่างเล็กที่สุดคือมีประตูสองบาน และมีอันตรายซ่อนอยู่หลังบานหนึ่ง สถานะเป็นได้สองแบบ: อันตรายอยู่ซ้าย หรืออันตรายอยู่ขวา ถ้าไม่มีข้อมูลอื่นและตั้ง prior เท่ากัน Belief คือ [0.5, 0.5] หลังฟังเซนเซอร์ ระบบอาจเปลี่ยนเป็น [0.85, 0.15] มันยังเก็บทั้งสองกรณีไว้ แม้กรณีแรกมีน้ำหนักมากกว่า
นี่แตกต่างจาก Point Estimate ที่บันทึกเพียงสถานะเดียว เช่นเลือกสถานะที่มีความน่าจะเป็นสูงสุด หรือ Maximum A Posteriori (MAP) การประมาณค่าเดียวสะดวกและอาจเหมาะกับงานที่ความผิดพลาดไม่แพง แต่ซ่อนโอกาสที่สถานะอีกแบบจะจริง ความต่างนี้มีผลมากเมื่อความเสียหายสองทางไม่เท่ากัน
การอัปเดตมีสองขั้น: ทำนายก่อน แล้วปรับด้วยข้อมูล
สำหรับสถานะจำนวนจำกัด สมการอัปเดตที่ใช้กันทั่วไปเขียนได้ดังนี้
b_next(s') = eta × O(o | s', a) × Σ_s T(s' | s, a) × b(s)b(s) คือความน่าจะเป็นของสถานะเดิม s ส่วน s' คือสถานะถัดไป a คือการกระทำที่เพิ่งทำ และ o คือข้อมูลสังเกตใหม่ T ให้ความน่าจะเป็นที่การกระทำทำให้สถานะเปลี่ยน ส่วน O ให้ความน่าจะเป็นที่จะพบข้อมูลนี้เมื่อสถานะใหม่เป็นแบบนั้น eta เป็นตัวคูณเพื่อให้ผลรวมของความน่าจะเป็นกลับมาเป็นหนึ่ง
ขั้นทำนายใช้ T กระจายน้ำหนักไปยังสถานะถัดไป ขั้นปรับข้อมูลใช้ O เพิ่มน้ำหนักให้สถานะที่อธิบายสิ่งที่เพิ่งสังเกตได้ดี โครงสร้างนี้แยกความเปลี่ยนแปลงของโลกออกจากความคลาดเคลื่อนของการวัด หากโมเดลบอกว่าข้อมูลที่ได้รับเป็นไปไม่ได้ในทุกสถานะ ตัวหารจะเป็นศูนย์ ระบบควรรายงานว่าข้อมูลขัดกับโมเดลและหยุดการคำนวณ ไม่สร้าง posterior ปลอมขึ้นมา กรอบ state estimation ใน Kaelbling et al.
Interactive: ทดลองเปลี่ยนข้อมูลแล้วดู Belief
ส่วนสำรวจด้านล่างเป็น SIMULATION ของ Bayesian update สำหรับอันตรายหลังประตูสองบาน ปรับ prior และความแม่นยำของเซนเซอร์ที่โมเดลสมมติ เลือกผลสังเกต แล้วดู posterior กับผลตอบแทนคาดหมายของแต่ละประตู ไม่มีโมเดลภาษา ไม่มีการฝึกน้ำหนัก และไม่ใช่การวัดความสามารถของ AI ผลลัพธ์เป็นการคำนวณจากกฎที่แสดงไว้
เมื่อเซนเซอร์บอกว่า “ซ้าย” เราควรเชื่อแค่ไหน?
ปรับความเชื่อเดิมและความแม่นของเซนเซอร์ แล้วดูความเชื่อหลังรับข้อมูลหนึ่งครั้ง ตัวเลขนี้เป็นความน่าจะเป็นในแบบจำลองสองสถานะที่กำหนดกฎไว้ ไม่ใช่คะแนนความมั่นใจจากโมเดลภาษา
Input — สิ่งที่แบบจำลองรับ
State — อันตรายอยู่ด้านเดียว และไม่ย้ายตำแหน่งระหว่างการสังเกตนี้ ความแม่นเท่ากันทั้งสองด้าน
Output — ความเชื่อและผลคาดหมาย
รางวัลสมมติ: เปิดประตูปลอดภัย +10 และเปิดโดนอันตราย −100 ผลคาดหมายไม่รับประกันผลแต่ละรอบ ถ้าเปลี่ยน Input จะคำนวณจาก prior ที่เลือกใหม่เสมอ ไม่มีการสะสมการสังเกตและไม่มีการฝึกน้ำหนักโมเดล
เริ่มจาก prior 50% และ sensor accuracy 85% เมื่อเซนเซอร์รายงานว่าอันตรายอยู่ซ้าย posterior ฝั่งซ้ายจะเป็น 85% ถ้าได้รายงานซ้ายอีกครั้งจากการวัดใหม่ที่เป็นอิสระเมื่อกำหนดสถานะจริงแล้ว จะได้ประมาณ 96.98% ถ้าเริ่มใหม่แล้วได้รายงานซ้ายตามด้วยขวา น้ำหนักจะกลับเป็น 50% ภายใต้เซนเซอร์สมมาตรเดียวกัน ตัวเลขเหล่านี้เป็น ผลคำนวณของตัวอย่างจำลอง ไม่ใช่ benchmark
ข้อควรสังเกตคือการคัดลอกข้อความเดียวกันมาสองครั้งไม่ใช่การวัดอิสระสองครั้ง การนำผลที่สืบทอดจากต้นทางเดียวกันมาคูณ likelihood ซ้ำทำให้ระบบดูมั่นใจขึ้นโดยไม่มีหลักฐานใหม่ ในงานจริงจึงต้องบันทึกที่มาของข้อมูลและความสัมพันธ์ระหว่างการวัด

Memory, World Model และ Belief ทำหน้าที่ต่างกัน
World Model ระบุกฎว่าโลกเปลี่ยนอย่างไรและการสังเกตเกิดจากสถานะอย่างไร Belief เป็นประมาณการสถานะปัจจุบันภายใต้กฎเหล่านั้น ส่วน Memory เก็บเหตุการณ์ ข้อเท็จจริง หรือข้อมูลที่ใช้สร้างประมาณการ การเก็บประวัติช่วยตรวจย้อนหลังได้ แต่ไม่ทำให้ระบบมีความน่าจะเป็นที่ถูกต้องโดยอัตโนมัติ
Context Window คือข้อมูลที่โมเดลภาษาประมวลผลได้ในรอบหนึ่ง Retrieved Context คือส่วนข้อมูลที่ค้นคืนมาใส่ในรอบนั้น External Memory คือที่เก็บข้อมูลภายนอก เช่นฐานข้อมูลเหตุการณ์และผลเครื่องมือ ขณะที่ Model Weight Updates คือการเปลี่ยนพารามิเตอร์ผ่านกระบวนการฝึก การอัปเดตเวกเตอร์ [0.85, 0.15] ในโปรแกรมเป็นการอัปเดตสถานะภายนอก ไม่ใช่การฝึก neural network
งาน RAG ของ Lewis และคณะใช้ความน่าจะเป็นเหนือเอกสารที่ค้นคืนเพื่อสร้างคำตอบ การแจกแจงเหนือเอกสารไม่ได้เท่ากับการแจกแจงเหนือสถานะที่ซ่อนอยู่ของโลก การฝึก RAG ในงานต้นฉบับก็ต้องแยกจากการค้นคืนขณะใช้งาน ซึ่งไม่เปลี่ยนน้ำหนักเพียงเพราะค้นเอกสารใหม่ Lewis et al., NeurIPS 2020
หากใช้ LLM แปลงข้อความเป็น observation ควรเก็บข้อความต้นฉบับ เวลา และกฎการแปลงด้วย ค่า “มั่นใจ 90%” ที่โมเดลเขียนออกมาไม่ได้เป็น observation likelihood ที่ตรวจสอบแล้ว ต้องมีการประเมินความสอดคล้องกับความถี่จริงหรือวิธีประมาณที่เหมาะกับงานก่อนนำไปใช้ในตัวกรอง
Architecture ที่นำไปทำต้นแบบได้
ผังนี้เป็น Conceptual Architecture / HYPOTHESIS สำหรับการออกแบบระบบ ที่ดัดแปลงจากกรอบ belief estimation และการวางแผน มีตัวอย่างสองสถานะที่ทดสอบได้ใน Lab แต่ไม่ได้พิสูจน์ว่าทั้งผังช่วย Agent งานทั่วไป กำหนดขอบเขตสถานะและสิ่งที่จะสังเกตให้ชัดก่อนเพิ่มโมดูล

| โมดูล | Input → Output และโครงสร้างข้อมูล | จุดตรวจและ Failure Mode |
|---|---|---|
| Observation Adapter | ผลเครื่องมือหรือเซนเซอร์ → record ของ observation พร้อมเวลาและ source ID | เทียบกับต้นฉบับ; แปลงข้อความผิดหรือรับข้อมูลเก่า |
| Model Registry | เวอร์ชันกฎ → ตาราง T, O และ reward | ตรวจผลรวม probability; ใช้กฎคนละเวอร์ชันกับโลก |
| Belief Predictor | belief เดิมและ action → distribution ที่ทำนายผ่าน T | ตรวจน้ำหนักรวม; ลืมผลของ action หรือสถานะที่เป็นไปได้ |
| Evidence Updater | distribution ที่ทำนายกับ observation → posterior และ normalization status | ตรวจตัวหารและ provenance; นับข้อมูลซ้ำหรือได้เหตุการณ์ที่โมเดลไม่รองรับ |
| Trace Memory | observation, action, belief, model version → event log แบบ append | ตรวจ timestamp/ลำดับ; history ขาดหรือบันทึกภายหลังผิด |
| Decision Module | belief, reward, horizon, budget → action และคะแนนทางเลือก | คำนวณซ้ำได้; horizon สั้นหรือผลตอบแทนระบุผิด |
| Action Executor | action ที่เลือก → ผลเครื่องมือและสถานะการดำเนินการ | ตรวจว่า action สำเร็จจริง; โมเดลสมมติว่าสำเร็จแต่ API ล้มเหลว |
| Feedback Monitor | prediction และ observation จริง → ความขัดแย้งหรือสัญญาณให้ทบทวนโมเดล | ตรวจเหตุการณ์ผิดปกติ; ยืนยันโมเดลจากข้อมูลที่มองไม่ครบ |
Belief ควรผูกกับเวลาและเวอร์ชันของโมเดล หากเปลี่ยนความหมายของสถานะ ห้ามนำตัวเลขเดิมมาใช้ต่อโดยไม่มีวิธีแปลงที่นิยามไว้ การบันทึก event log ทำให้ replay ได้ แต่ replay ต้องใช้ลำดับเหตุการณ์และกฎเดียวกับตอนเกิดเหตุ
การแยก Action Executor ช่วยให้ “วางแผนว่าจะเปิดประตู” กับ “เปิดสำเร็จแล้ว” ไม่ปะปนกัน สำหรับ Agent ที่ทำงานผ่าน API การตอบกลับไม่ชัดควรนำไปสู่การตรวจสถานะจริงก่อนส่งคำสั่งซ้ำ สถานะการดำเนินการที่ตรวจไม่ได้ให้คง UNKNOWN; ปรับ belief ตาม transition และหลักฐานที่โมเดลระบุ แทนสมมติว่าสำเร็จ
จาก Belief สู่การตัดสินใจ: ข้อมูลเพิ่มมีราคา
รู้ posterior แล้วยังต้องกำหนดว่าอะไรเป็นผลดีและผลเสีย ในเกมนี้ตั้งคะแนนจำลองเป็นเปิดประตูปลอดภัย +10 เปิดเจออันตราย −100 และฟังเซนเซอร์หนึ่งครั้ง −1 ค่าเหล่านี้เป็นทางเลือกเพื่อการสอน ไม่ใช่ต้นทุนจริงของระบบใด
ถ้า p คือโอกาสที่อันตรายอยู่ซ้าย ผลตอบแทนคาดหมายของการเปิดขวาคือ 10p − 100(1−p) ที่ p=0.85 จะได้ −6.5 แม้ประตูขวามีโอกาสปลอดภัยถึง 85% จึงเห็นว่าประตูที่น่าจะปลอดภัยที่สุดยังให้คะแนนคาดหมายติดลบได้ เมื่อความเสียหายหนักกว่ารางวัลมาก
ต้องแยกสองคำถาม: ถ้าจำเป็นต้องเปิดเดี๋ยวนี้ จะเปิดบานไหน กับถ้ามีสิทธิ์ฟังเพิ่ม ควรฟังหรือเปิด ในเกมสมมาตรนี้ MAP และการเลือกประตูที่มี expected reward สูงสุดจะเลือกบานเดียวกัน ความต่างอยู่ที่ MAP ไม่เก็บขนาดความเสี่ยงหรือเปรียบเทียบแผนฟังต่อ ไม่ควรสร้างตัวอย่างให้ดูเหมือนว่าทั้งสองวิธีต้องเลือกคนละประตูเสมอ
การวางแผนต้องพิจารณาว่าผลสังเกตแต่ละแบบจะเปลี่ยนการตัดสินใจถัดไปอย่างไร ไม่ใช่ลดความไม่แน่นอนให้มากที่สุดอย่างเดียว ข้อมูลที่ชัดขึ้นแต่ไม่เปลี่ยน action อาจมีค่าน้อยกว่าค่าที่ต้องจ่าย และข้อมูลราคาถูกก็อาจไม่ช่วยเมื่อโมเดลเซนเซอร์ผิด งานสำรวจ online POMDP planning อธิบายการสร้างแผนจาก belief ปัจจุบันภายใต้งบเวลาและคำนวณใหม่หลังได้รับข้อมูล Ross et al., JAIR 2008
เกมจำลอง: เปิดประตู หรือฟังเพิ่ม
เกมด้านล่างเป็น SIMULATION ให้ผู้เล่นพยายามเปิดประตูที่ปลอดภัย โดยไม่เห็นอันตรายจริงก่อนเลือก ระบบแสดง belief ประวัติ observation คะแนน และคำแนะนำจากการค้นต้นไม้ belief ขนาดเล็ก มีต้นทุนการฟังและขีดจำกัดจำนวนครั้ง รีเซ็ตเพื่อเริ่มรอบใหม่ได้
เห็นไม่ครบ จะเปิดประตูหรือฟังเพิ่ม?
เป้าหมาย: เลือกประตูที่ปลอดภัย อันตรายซ่อนอยู่หลังประตูเดียวและไม่ย้ายระหว่างรอบ ฟังเซนเซอร์ได้ไม่เกิน 5 ครั้ง ลองดูว่าความเชื่อและต้นทุนข้อมูลเปลี่ยนการตัดสินใจอย่างไร
Input — ตั้งค่าก่อนกระทำครั้งแรก ปุ่ม Reset ใช้ค่าที่เลือกและ seed เดิมเพื่อเล่นซ้ำ ส่วน “รอบใหม่” เปลี่ยน seed โดยคง prior/เซนเซอร์ไว้ ความแม่นในตัวจำลองตรงกับความแม่นที่ผู้วางแผนใช้ และการฟังแต่ละครั้งเป็นอิสระเมื่อกำหนดตำแหน่งอันตราย
สนามทดลองและ State
P(อันตรายซ้าย) = 50.00%
Output — เปรียบเทียบวิธีตัดสินใจ
ตรวจการคำนวณของทางเลือก “ฟัง”
ร่องรอยการสังเกตและการกระทำ
- เริ่มด้วย prior 50%
MAP กับการเปิดโดยดูผลคาดหมายจะเลือกด้านเดียวกันในเกมรางวัลสมมาตรนี้ แต่ MAP ไม่เก็บขนาดความเสี่ยงไว้ในจุดประมาณเดียว การค้นแผนเพิ่มทางเลือกซื้อข้อมูลแล้วค่อยตัดสินใจ
กฎรางวัลสมมติ: ปลอดภัย +10, โดนอันตราย −100, ฟังครั้งละ −1 เปิดประตูแล้วจบรอบ ผู้วางแผนใช้เฉพาะ belief กับกฎที่กำหนด ไม่เห็นตำแหน่งจริง แม้กดเฉลยคำแนะนำก็ไม่เปลี่ยน
ขอบเขต: นี่คือการค้นต้นไม้การตัดสินใจอย่างตรงไปตรงมาในเกมเล็ก ไม่ใช่ POMCP, ไม่ใช่ระบบ LLM และไม่ใช่ benchmark AI แต่ละขั้นวางแผนล่วงหน้าไม่เกิน 4 การกระทำหรือจนงบฟังหมด แล้ววางแผนใหม่เมื่อได้รับข้อมูล ผลคาดหมายคำนวณเฉพาะรางวัลในอนาคต ไม่รวมต้นทุนที่จ่ายแล้ว และไม่รับประกันชัยชนะในรอบเดียว ไม่มีการเปลี่ยนน้ำหนักโมเดล
การค้นในเกมเป็นการแจกแจงทางเลือกแบบจำกัด horizon สำหรับกฎสองสถานะที่ทราบแน่นอน ไม่ใช่ POMCP และไม่ใช่ LLM Agent Horizon หนึ่งขั้นพิจารณาเปิดประตูเท่านั้น เมื่อมีมากกว่าหนึ่งขั้น การฟังได้ค่าเท่ากับต้นทุนฟังบวกคะแนนคาดหมายของทางเลือกที่ดีที่สุดหลัง observation แต่ละแบบ Horizon สั้นและงบฟังจำกัดอาจทำให้คำแนะนำต่างจากแผนระยะยาว
ลองเล่นสามแบบ: เปิดทันทีเมื่อ prior เท่ากัน ฟังหนึ่งครั้งแล้วเปิด และฟังต่อเมื่อผลขัดกัน เปรียบเทียบ trace และคะแนนของรอบนั้นโดยไม่สรุปจากการชนะรอบเดียวว่า policy ดีกว่า หากเปรียบเทียบอย่างเป็นระบบ ต้องใช้หลาย seed กฎเดียวกัน งบเท่ากัน และสรุปการกระจายผลลัพธ์ บทความนี้ไม่ได้รายงาน benchmark เปรียบเทียบดังกล่าว
คำแนะนำใช้ belief และโมเดลที่ระบุไว้ การเปิดเผยสถานะจริงมีไว้ตรวจกลไกสำหรับผู้เล่น ไม่ใช่ input ของตัววางแผน เมื่อเปิดประตูแล้วรอบจบ การฟังเพิ่มหลังรู้ผลจะไม่ถูกนำมาเพิ่มคะแนนย้อนหลัง
เปรียบเทียบสามแนวทางให้ตรงกลไก

| แนวทาง | สิ่งที่เก็บและวิธีเลือก | เหมาะเมื่อ | ข้อจำกัด |
|---|---|---|---|
| Point Estimate / MAP | เก็บสถานะที่น่าจะเป็นมากที่สุด แล้วใช้กฎกับค่านั้น | ต้นแบบง่าย ข้อผิดพลาดไม่แพง ความไม่แน่นอนน้อย | ทิ้งทางเลือกและขนาดความเสี่ยง |
| Bayesian Filter + Belief Policy | เก็บ distribution แล้วใช้ policy หรือคะแนนที่นิยามบน belief | สถานะและ observation model กำหนดได้ และมี policy ที่เหมาะสม | filter ไม่ได้สร้างแผนระยะยาวด้วยตัวมันเอง |
| Online Belief Planning | ค้นแผนจาก belief ปัจจุบัน และอัปเดตแผนหลัง observation | ข้อมูลใหม่มีผลต่อทางเลือก และคำนวณทันเวลาที่ต้องตัดสินใจ | ต้องมีโมเดลหรือ simulator พร้อมงบค้นหา |
policy ที่คำนวณไว้ล่วงหน้าไม่ได้แปลว่าทำ action เดิมเสมอ มันรับ belief ที่เปลี่ยนแล้วให้ action ต่างกันได้ ในทางกลับกัน online planning หมายถึงสร้างหรือปรับแผนขณะตัดสินใจ ไม่ได้หมายถึง online learning ที่ฝึกน้ำหนักหรือปรับโมเดลจากข้อมูลใหม่
POMCP ของ Silver และ Veness ใช้การค้นแบบ Monte Carlo ร่วมกับอนุภาคเพื่อแทน belief และต้องเข้าถึง generative simulator ที่สุ่มสถานะถัดไป observation และ reward ได้ จึงเหมาะกับบางปัญหาที่เขียนตารางเต็มยาก งานปี 2010 มีผลทดลองในสภาพแวดล้อมที่ระบุ แต่ finite particles อาจสูญเสียสถานะสำคัญ และคุณสมบัติทางทฤษฎีไม่ได้รับประกันผลของทุกการตั้งค่าที่จำกัดเวลา Silver & Veness, NeurIPS 2010
มีแนวทางคำนวณ policy แบบ exact สำหรับปัญหาเล็กด้วย ผลคลาสสิกของ Smallwood และ Sondik กล่าวถึงโครงสร้างค่าผลตอบแทนแบบ piecewise linear และ convex ภายใต้กรณีจำกัดที่ศึกษา ไม่ควรนำไปกล่าวว่าระบบต่อเนื่องหรือ Agent ภาษาใด ๆ แก้ได้อย่างง่ายดาย เราตรวจ metadata และ abstract ของบทความนี้ ยังไม่ได้ตรวจ full text Smallwood & Sondik, Operations Research 1973
มีระบบที่ใช้งานจริงหรือยัง
งาน Intention-Aware Online POMDP Planning for Autonomous Driving in a Crowd ของ Bai, Cai, Ye, Hsu และ Lee ปี 2015 รายงานระบบรถกอล์ฟที่พิจารณาความไม่แน่นอนของเจตนาคนเดินถนน โครงสร้างแยกการวางเส้นทางกับการเลือกความเร็ว โดยใช้ DESPOT ในส่วน POMDP ไม่ใช่ POMCP หน้ารวมงานของผู้วิจัย, ต้นฉบับ ICRA 2015
สถานะหลักฐานส่วนนี้เป็น REPORTED CLAIM จากผู้วิจัย: มีรายงานระบบรถจริง แต่การเปรียบเทียบหลายส่วนใช้การจำลองจากเส้นทางคนเดินถนนที่บันทึกไว้ คนใน replay ไม่ได้ตอบสนองต่อรถเหมือนในโลกจริง เราไม่ได้ทำซ้ำการทดลอง และการดึง PDF ฉบับเต็มในรอบนี้ไม่สำเร็จครบ จึงไม่ยกตัวเลขประสิทธิภาพหรือกล่าวว่ารถปลอดภัยทั่วไป
สำหรับการทดลองปัญหาขนาดเล็ก pomdp-solve มีเครื่องมือและเอกสารรูปแบบโมเดล POMDP รวมทั้งตัวอย่างที่ตรวจอ่านกติกาได้ หน้าโครงการระบุรุ่น 5.5 เดือนกุมภาพันธ์ 2024 แต่บทความนี้ไม่ได้ติดตั้งหรือรัน solver นั้น เกมของเราเขียนคำนวณโดยตรงสำหรับโจทย์สองสถานะ เอกสารโครงการ, รูปแบบไฟล์โมเดล
การนำแนวคิดไปใช้กับผู้ช่วยงานเอกสารหรือ API ใน Architecture ด้านบนเป็นข้อเสนอออกแบบ HYPOTHESIS ต้องกำหนดสถานะที่ตรวจได้ เช่น pending, completed, failed พร้อม likelihood จากข้อมูลจริง ก่อนอ้างว่าเพิ่มความสำเร็จของ Agent การวางกรอบ POMDP ให้ปัญหาไม่ได้เป็นหลักฐานประสิทธิภาพด้วยตัวมันเอง
Failure Modes: Belief ดูเป็นตัวเลขก็ยังผิดได้
โมเดลผิด: หากเซนเซอร์จริงมี bias แต่โมเดลสมมติสมมาตร posterior จะคำนวณถูกตามสมการและยังผิดเกี่ยวกับโลกได้ ควรแยกการทดสอบความถูกต้องของโค้ดออกจากการประเมินว่า T และ O ตรงข้อมูลจริงเพียงใด
สถานะตกหล่น: การแจกแจงรวมเป็นหนึ่งเพราะบังคับให้โลกอยู่ในรายการที่สร้างไว้ หากมีเหตุการณ์นอกขอบเขต เช่นอันตรายอยู่ทั้งสองประตู ตัวเลขสองสถานะจะไม่อธิบายโลกนั้น ต้องมีการตรวจ model mismatch หรือแก้ state space ที่ได้รับอนุญาต
ข้อมูลเก่าและข้อมูลสัมพันธ์กัน: การเรียงเวลาผิดทำให้ belief ย้อนเหตุการณ์ไม่ได้ การนับรายงานซ้ำเสมือน independent evidence ทำให้มั่นใจเกินจริง ลำดับเวลาและ source lineage จึงเป็นส่วนหนึ่งของกลไก ไม่ใช่รายละเอียดตกแต่ง
งบค้นหาและ reward ผิด: แผนที่ดีตามคะแนนอาจไม่ตรงเป้าหมายของผู้ใช้ การใช้ค่าคาดหมายไม่ได้บังคับข้อจำกัดความเสี่ยงทุกแบบ หากงานต้องห้ามผลลัพธ์บางชนิด ต้องออกแบบข้อจำกัดและทดสอบแยก ไม่อนุมานการรับประกันจาก posterior สูง
ร่องรอยเหตุผลไม่ครบ: ข้อความอธิบายจาก LLM อาจบอกว่าตนคำนึงถึงความเสี่ยง แต่สิ่งที่ตรวจได้ในต้นแบบนี้คือ likelihood ที่ใช้ posterior คะแนนของทางเลือกและ action จริง เก็บร่องรอยคำนวณเหล่านี้แยกจากคำบรรยาย เพื่อดูได้ว่าการตัดสินใจใช้ข้อมูลใด
จะทดสอบและต่อยอดอย่างไร
เริ่มจากตรวจ posterior ด้วยมือในกรณีที่คำนวณง่าย ทดสอบข้อมูลขัดกันและเหตุการณ์ที่มี probability ศูนย์ จากนั้นตรวจว่า planner ใช้ belief ที่อัปเดตแล้ว ไม่เข้าถึง hidden state ตรวจกรณีงบฟังหมด รอบจบ และ reset ก่อนเปรียบเทียบ policy
การประเมินระบบจริงควรแยกสามระดับ: ความถูกต้องของการคำนวณ ความสอดคล้องของแบบจำลองกับข้อมูล และคุณภาพการตัดสินใจภายใต้ต้นทุนเดียวกัน ตัวชี้วัดอาจรวมผลสำเร็จ ผลตอบแทน ความผิดพลาดร้ายแรง ค่าใช้จ่ายข้อมูล และเวลาตัดสินใจ ต้องกำหนดก่อนทดลองและรายงานเงื่อนไข ไม่เลือกเฉพาะ seed ที่สำเร็จ
ทิศทางวิจัยที่น่าสนใจคือการตรวจข้อมูลซ้ำ การติดตาม model drift และการเชื่อม LLM Observation Adapter กับ likelihood ที่ประเมินได้ อีกทางคือความเสี่ยงที่ไม่ได้แทนด้วย expected return เพียงค่าเดียว ทุกแนวทางต้องแสดงว่าดีกว่า baseline ที่เรียบง่ายเพียงใด ภายใต้งบและข้อมูลที่เทียบกัน
Practical Takeaways: ออกแบบให้ตรวจได้ก่อนขยาย

- ระบุ hidden state ที่มีผลต่อ action และ observation ที่ระบบอ่านได้จริง
- แยกประวัติใน Memory กฎใน World Model และประมาณการปัจจุบันใน Belief
- ใช้ T และ O ที่มีที่มา พร้อมเวอร์ชันและวิธีรับมือข้อมูลที่โมเดลไม่รองรับ
- คำนวณผลเสียด้วย อย่าใช้สถานะที่น่าจะจริงที่สุดเป็นคำรับประกัน
- ชั่งการสังเกตเพิ่มกับต้นทุนและเวลาที่เหลือ แล้วบันทึกทางเลือกที่พิจารณา
- ทดสอบกลไกก่อนวัดผลระบบ และติดป้าย SIMULATION ให้ผลจำลองทุกครั้ง
FAQ
Belief State คือความเชื่อของ AI แบบมนุษย์หรือไม่
เป็นคำทางเทคนิคสำหรับการแจกแจงความน่าจะเป็นของสถานะที่ซ่อนอยู่ภายใต้โมเดล ไม่ได้ยืนยันจิตสำนึก ความรู้สึก หรือการรับรู้แบบมนุษย์
Agent ทุกตัวต้องใช้ POMDP หรือไม่
ไม่จำเป็น หากสถานะสำคัญตรวจเห็นได้ดีหรือกฎเรียบง่าย วิธีที่เบากว่าอาจเพียงพอ ควรใช้เมื่อความไม่แน่นอนมีผลต่อทางเลือก และมีโมเดลกับงบคำนวณที่เหมาะสม
Belief สูง 99% หมายถึงปลอดภัยหรือไม่
ไม่ได้รับประกัน ความน่าจะเป็นขึ้นกับขอบเขตสถานะและความถูกต้องของโมเดล ความเสียหายที่เหลืออาจยังยอมรับไม่ได้ และเหตุการณ์นอกโมเดลอาจไม่รวมอยู่ในตัวเลข
RAG และการเขียน Reflection ทำให้เกิด Belief State แล้วหรือยัง
ยังสรุปเช่นนั้นไม่ได้ ต้องระบุว่าสถานะใดได้รับน้ำหนักอย่างไรและอัปเดตด้วยกฎใด การค้นข้อความหรือบันทึกประสบการณ์เพียงอย่างเดียวไม่ใช่ Bayesian filtering
อัปเดต Belief ถือเป็นการเรียนรู้หรือฝึกโมเดลหรือไม่
ในตัวอย่างนี้เป็นการประมาณสถานะด้วยโมเดลคงที่ ไม่เปลี่ยน T, O หรือน้ำหนัก neural network หากระบบอื่นปรับโมเดลจากข้อมูล ต้องระบุกลไกและหลักฐานแยกต่างหาก
เกมนี้พิสูจน์ว่า Online Planning ดีกว่า MAP หรือไม่
ไม่ เกมสาธิตกลไกของทางเลือกภายใต้กฎและคะแนนที่กำหนด การพิสูจน์ข้อได้เปรียบต้องมีการทดลองเทียบหลายรอบและต้นทุนที่เท่ากัน ซึ่งบทความนี้ไม่ได้ทำ
การฟังหลายครั้งทำให้ดีขึ้นเสมอหรือไม่
ไม่เสมอ การฟังมีต้นทุน อาจได้ข้อมูลขัดกัน และอาจไม่เป็นอิสระหรือมีโมเดลผิด ต้องดูผลต่อการตัดสินใจร่วมกับต้นทุนและเวลา
References: ต้นทางและขอบเขตการตรวจ
- Kaelbling, Littman & Cassandra (1998), Planning and Acting in Partially Observable Stochastic Domains — วารสาร Artificial Intelligence; อ่านต้นฉบับเต็มผ่าน สำเนาเพื่อการศึกษา
- Ross, Pineau, Paquet & Chaib-draa (2008), Online Planning Algorithms for POMDPs — JAIR 32:663–704; อ่านต้นฉบับ ไม่ใช่งานใหม่ปี 2014 ตามวันอัปโหลด arXiv
- Silver & Veness (2010), Monte-Carlo Planning in Large POMDPs — NIPS/NeurIPS 23; อ่าน paper; สถานะ repository ต้นฉบับที่เปิดได้ยัง UNKNOWN
- Smallwood & Sondik (1973), The Optimal Control of Partially Observable Markov Processes over a Finite Horizon — Operations Research 21(5):1071–1088; ตรวจ metadata/abstract; full text UNKNOWN
- Bai, Cai, Ye, Hsu & Lee (2015), Intention-Aware Online POMDP Planning for Autonomous Driving in a Crowd — ICRA; ตรวจ รายการผู้วิจัย และข้อความต้นฉบับที่ค้นคืนได้; การเปิด PDF ครบทั้งฉบับยัง UNKNOWN
- Lewis et al. (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — NeurIPS 33; อ่านต้นฉบับเพื่อแยก document retrieval ออกจาก world-state belief
- pomdp-solve: โครงการและเอกสารทางการ และ POMDP File Format — ตรวจเอกสาร; ไม่ได้รัน solver หรือ benchmark ต้นฉบับในรอบนี้
สถานะหลักฐาน: หลักการและการมีอยู่ของเอกสารเป็น FACT ผลระบบรถจากผู้วิจัยเป็น REPORTED CLAIM ความเหมาะสมของแนวทางเป็น ANALYSIS ผังต่อยอดเป็น HYPOTHESIS และตัวเลขกับเกมเป็น SIMULATION การทำซ้ำ benchmark โดย HYBRID MIND ยังเป็น UNKNOWN
ใส่ความเห็น