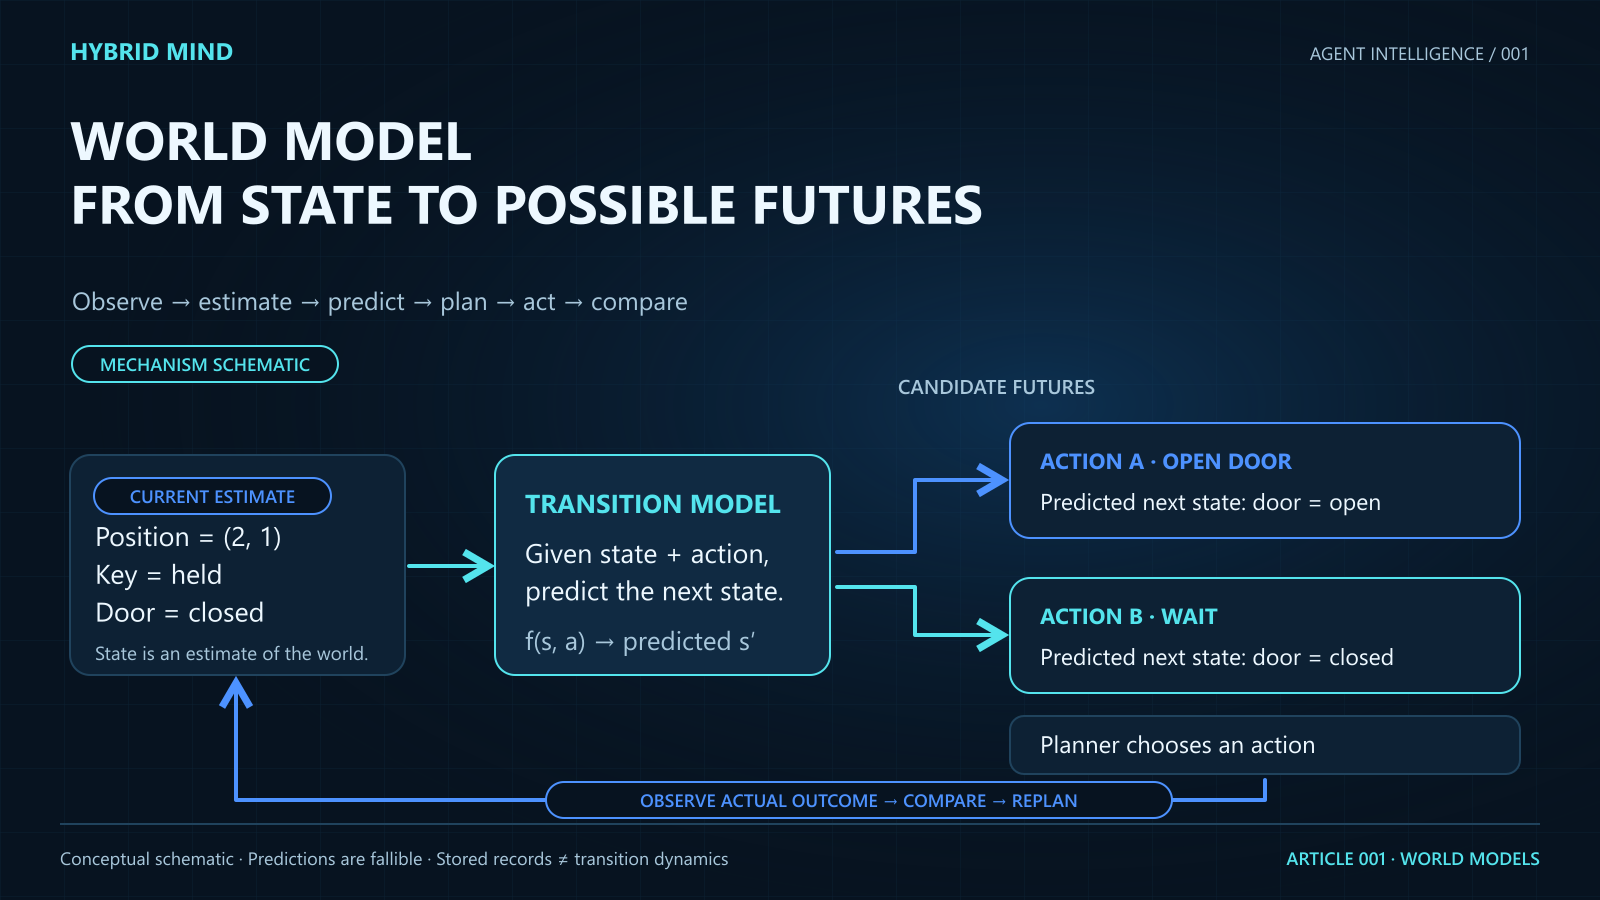
World Model หรือแบบจำลองโลก ใช้แทนสิ่งสำคัญในสภาพแวดล้อมและคาดการณ์ว่าสถานะจะเปลี่ยนอย่างไรเมื่อ Agent กระทำบางอย่าง อาจเป็นกฎที่เขียนไว้หรือโครงข่ายประสาทที่เรียนรู้จากข้อมูล ความจำเก็บสิ่งที่เคยพบ แบบจำลองช่วยคำนวณผลที่อาจเกิด ส่วน Planner หรือนโยบายเลือกการกระทำ แล้วใช้ผลจริงตรวจการคาดการณ์
บทความใช้ความหมายเชิงปฏิบัติที่เน้นการเปลี่ยนสถานะตามการกระทำ ขอบเขตคำนี้ต่างกันในแต่ละงานวิจัย และไม่ได้เป็นหลักฐานว่า AI มีจิตสำนึกหรือประสบการณ์แบบมนุษย์

ทำไม Agent ต้องรู้มากกว่าคำตอบในแชต
Agent ส่งพัสดุอาจจำว่า “เมื่อวานทางเดินนี้เปิด” ทั้งที่วันนี้ถูกปิด การมีสถานะปัจจุบัน กฎการเคลื่อนที่ และวิธีทดลองเส้นทางช่วยตรวจผลก่อนลงมือ
ในงานซอฟต์แวร์ อาจติดตามไฟล์ที่แก้ ผลการตรวจ และผลข้างเคียงของเครื่องมือ ความละเอียดของแบบจำลองขึ้นกับส่วนของโลกที่เกี่ยวข้องกับเป้าหมาย
การอ้างว่า Agent จำลองโลกเพื่อวางแผนควรตรวจตัวแทนสถานะ การทำนายตาม action และการใช้ผลทำนายเลือกจริง ชื่อโมดูลหรือคำบรรยายแผนอย่างเดียวไม่ยืนยันกลไก ขณะเดียวกันการไม่มีโมดูลแยกก็ไม่ได้พิสูจน์ว่าโมเดลไม่มีความรู้เกี่ยวกับโลกโดยนัย
งาน Dyna ของ Richard Sutton ใน ICML 1990 เชื่อม learning, planning และ acting โดยสลับใช้โลกจริงกับโมเดลที่เรียนรู้ รอบนี้ตรวจได้เฉพาะระเบียนและ abstract จึงไม่อ้างรายละเอียดผลทดลอง ICML 1990
รากฐาน: สิ่งที่เห็น สถานะที่เชื่อ และผลที่คาดไว้
Observation ไม่เท่ากับ State
Observation คือข้อมูลที่ได้รับ เช่น ภาพหรือผล API ส่วน State คือสภาวะที่มีผลต่ออนาคต ภาพเดียวอาจไม่บอกความเร็ว และข้อความ “คำขอสำเร็จ” อาจไม่ยืนยันว่าฐานข้อมูลเปลี่ยนครบ
เมื่อเห็นโลกไม่ครบ ระบบใช้ประวัติสร้าง State Estimate หรือตัวประมาณสถานะ อาจใช้ Belief State แทนความน่าจะเป็นของสถานะที่เป็นไปได้ แต่การบีบประวัติเป็นเวกเตอร์ไม่ได้รับรองว่า belief หรือความมั่นใจแม่นยำ
Transition Model ทำนายอะไร
ตัวอย่างแบบกำหนดผลแน่นอนเขียนได้ว่า ŝ[t+1] = f(s[t], a[t]) โดย s[t] คือสถานะที่ใช้ ณ เวลา t, a[t] คือการกระทำ, f คือกฎหรือฟังก์ชันการเปลี่ยนสถานะ และ ŝ[t+1] คือสถานะถัดไปที่คาดไว้ เครื่องหมายหมวกหมายถึงค่าทำนาย ไม่ใช่ผลที่ยืนยันว่าเกิดขึ้นแล้ว
ถ้าโลกมีความสุ่ม อาจทำนาย p(s[t+1] | s[t], a[t]) หรือโอกาสของสถานะถัดไปตามสถานะและ action ภาพอนาคตที่สวยงามยังไม่เพียงพอหากละเลยการชนหรือผลของ action
บางระบบทำนาย Reward การสิ้นสุดตอน หรือ Observation เพิ่มเติม เป้าหมายอาจเป็นข้อจำกัด เช่น “ถึงปลายทางโดยไม่เข้าพื้นที่ห้าม” โดยไม่ใช้รางวัลตัวเลข
Planning ใช้โมเดลอย่างไร
Planner ทดลองลำดับ action เปรียบเทียบต้นทุนและข้อจำกัด ส่วน Policy เลือก action โดยตรง นโยบายที่ฝึกจากเส้นทางจำลองได้ประโยชน์จาก World Model โดยไม่ค้นอนาคตทุกครั้ง ความต่างนี้สำคัญสำหรับ PlaNet, Dreamer และ MuZero
จากกฎ Symbolic สู่ Latent World Model
Symbolic World Model: สถานะและกติกาที่ตรวจอ่านได้
ระบบเชิงสัญลักษณ์แทนวัตถุและความสัมพันธ์ เช่น at(robot, A), connected(A, B) และ blocked(B) การกระทำ move(A, B) มี preconditions และ effects; ถ้า B ปิดก็ไม่ผ่านเงื่อนไข
PDDL เป็นภาษาสำหรับระบุปัญหาการวางแผน โดยแยก domain ที่บอกการกระทำออกจาก problem ที่บอกสถานะเริ่มต้นและเป้าหมาย เอกสาร PDDL รุ่น 1.2 เดือนตุลาคม 1998 เป็นข้อกำหนดภาษาและ Technical Report ไม่ใช่ผลทดลองว่าระบบเข้าใจโลกทั่วไป เอกสารต้นฉบับ PDDL
ตรวจข้อเท็จจริง เงื่อนไข และแผนได้ แต่ข้อมูลหรือกฎไม่ครบทำให้แผนล้มเหลวในโลกจริง Symbolic ไม่ได้มีเพียงค่าจริง/เท็จ เช่น PDDL2.1 เพิ่มเวลาและทรัพยากรเชิงตัวเลข แต่ยังแทน deterministic domains ไม่ใช่ความสุ่มทั่วไป JAIR (2003)
Latent World Model: เรียนรู้ตัวแทนที่ไม่จำเป็นต้องอ่านเป็นคำ
Latent State คือตัวแทนที่เรียนรู้ เช่น เวกเตอร์จากภาพและประวัติ Transition Network ทำนาย latent ถัดไป Decoder อาจสร้างภาพกลับเพื่อฝึกหรือดูผล แต่ตัวแทนที่ใช้ควบคุมไม่จำเป็นต้องรักษาทุกพิกเซล
Ha และ Schmidhuber เผยแพร่ preprint “World Models” วันที่ 27 มีนาคม 2018 ศึกษาการบีบภาพ การทำนายลำดับ และ controller ขนาดเล็ก ฉบับคู่กัน “Recurrent World Models Facilitate Policy Evolution” ผ่าน peer review ใน NeurIPS 2018 แต่ผลยังจำกัดตามสภาพแวดล้อมทดลอง preprint, NeurIPS
ข้อดีคือรองรับอินพุตมิติสูงโดยไม่ต้องตั้งชื่อทุกสิ่ง แต่ความหมายภายในตรวจยากและความผิดพลาดสะสมหลายก้าว ภาพที่ดูถูกต้องอาจละเลยกติกาที่สำคัญต่อการควบคุม
แนวทางผสม: ให้ตัวแทนแต่ละแบบทำหน้าที่ที่เหมาะสม
ตัวอย่างคือโมเดลภาพประมาณตำแหน่งวัตถุ แล้วแปลงเป็น structured state ให้ Planner ใช้กับกฎข้อจำกัด ค่าที่ไม่แน่ชัดควรเก็บว่า “ไม่ทราบ”
นี่เป็น HYPOTHESIS / ข้อเสนอให้ทดสอบ ยังไม่ได้วัดกับหุ่นยนต์จริง การเชื่อม latent กับสัญลักษณ์อาจเพิ่มข้อผิดพลาด; การเพิ่ม Knowledge Graph ไม่รับรองความฉลาดหรือความปลอดภัย
Memory, RAG และ Reasoning เกี่ยวข้องกับ World Model อย่างไร
Memory เก็บข้อมูล World Model คาดผลของ action ส่วน Reasoning และ Planning ใช้ทั้งสองเพื่อหาข้อสรุปหรือการกระทำ หน้าที่เหล่านี้อาจอยู่ในโมดูลเดียวกัน จึงควรแยกตามกลไก
| กลไก | สิ่งที่เกิดขึ้น | สิ่งที่ยังสรุปไม่ได้ |
|---|---|---|
| Context Window | โมเดลประมวลผลข้อมูลที่อยู่ในบริบทของคำขอ | ไม่ยืนยันว่าข้อมูลคงอยู่ข้ามงาน |
| Retrieved Context | ระบบเลือกข้อมูลมาเพิ่มในบริบท เช่น ค้นเอกสารจากดัชนี | ไม่รับรองว่าข้อมูลใหม่ ถูกต้อง หรือเกี่ยวข้องกับสถานะตอนนี้ |
| External Memory | เก็บบันทึก แผนที่ ประวัติ หรือข้อเท็จจริงในที่เก็บภายนอก | ไม่เท่ากับการเปลี่ยนน้ำหนักโมเดล |
| Model Weight Updates | ขั้นตอนฝึกปรับพารามิเตอร์ตามวัตถุประสงค์การเรียนรู้ | ไม่รับรองว่าประสิทธิภาพดีขึ้นทุกงาน |
| Transition Model | คาดการณ์ผลที่ขึ้นกับสถานะและการกระทำ | ไม่รับรองว่าโลกจริงจะเป็นไปตามค่าทำนาย |
RAG ของ Lewis และคณะใน NeurIPS 2020 ผสานการค้นเอกสารกับโมเดลสร้างภาษา โดยแยก parametric และ non-parametric memory การค้นข้อมูลประกอบคำตอบไม่ได้ทำให้ Retrieval เป็น Transition Model งาน RAG ต้นฉบับ
“เคยผ่าน B เมื่อวาน” เป็น Episodic Memory; “B ปิด ตรวจเมื่อ 09:00” เป็นสถานะที่มีเวลา; “เข้าช่องปิดแล้วตำแหน่งไม่เปลี่ยน” เป็น transition rule การอยู่ในฐานข้อมูลเดียวกันไม่ได้ทำให้บทบาทเท่ากัน
การบันทึกข้อผิดพลาดหรือปรับ Prompt อาจเปลี่ยนพฤติกรรม แต่ไม่ยืนยันการฝึก Transition Network หรือ Policy ต้องระบุว่าเปลี่ยน record, กฎ, บริบท หรือน้ำหนัก
Trace ที่ตรวจได้คือสถานะที่ค้น เส้นทางที่ตัด และผลตรวจเงื่อนไข คำอธิบายจากโมเดลไม่ควรแทน log เพราะงานทดลองพบว่า CoT ไม่กล่าวถึงอิทธิพลของ input บางอย่างเสมอ Turpin และคณะ, NeurIPS 2023
อ่านต่อ Talorys: ความจำปัจจุบันกับประวัติ และ ResonanceDB: การค้นคืนความจำ เพื่อเสริมด้าน Memory โดยไม่ถือเป็นหลักฐานของ Transition Model
Architecture ที่นำไปทดลองสร้างได้
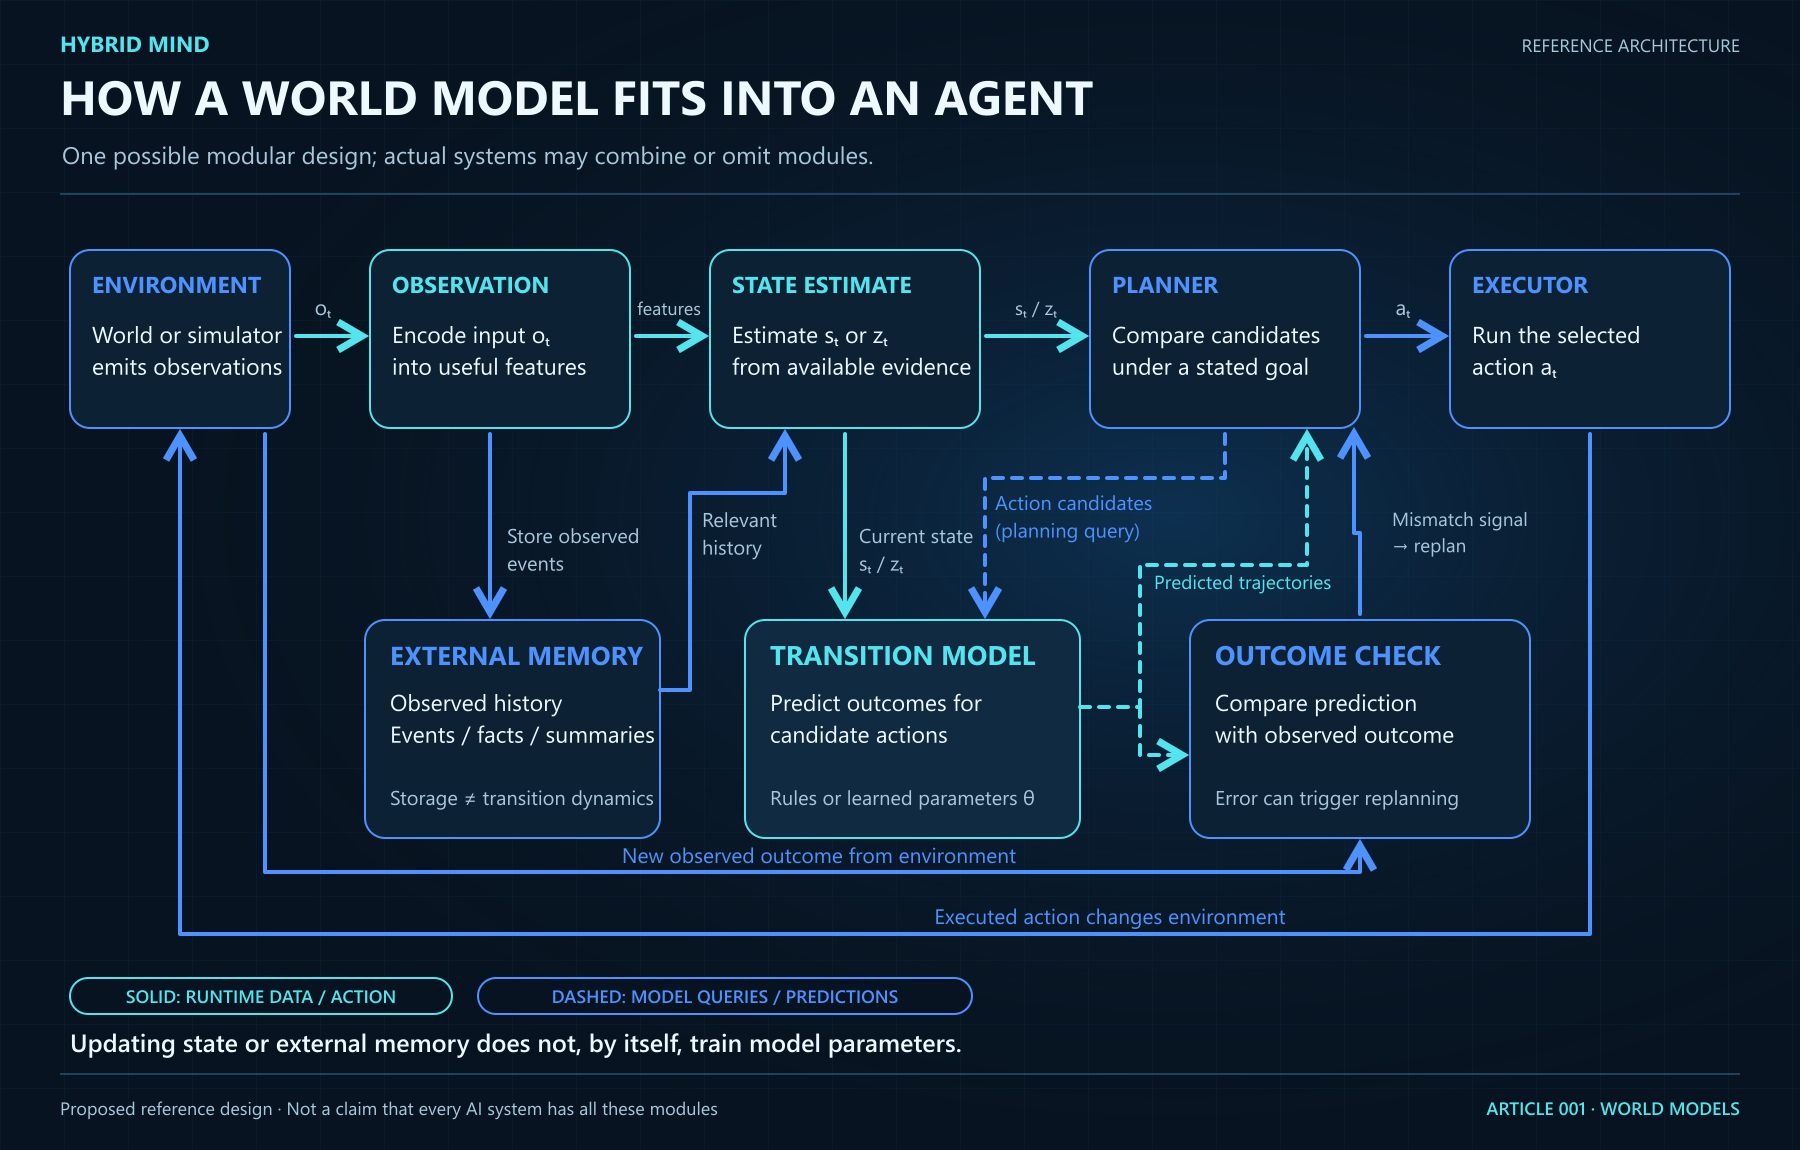
นี่เป็น reference architecture ที่ผู้เขียนเสนอ สำหรับโลกขนาดเล็ก แต่ละระบบอาจมีโมดูลต่างกัน ผังนี้ไม่ได้แทน Dreamer หรือ MuZero

HYBRID MIND · ARCHITECTURE EXPLORER INTERACTIVE
คลิกสำรวจ Agent ที่ใช้ World Model
CONCEPTUAL ARCHITECTURE — แผนผังอ้างอิงที่เสนอ
นี่คือเครื่องมืออธิบายองค์ประกอบ ไม่ใช่หลักฐานประสิทธิภาพของระบบจริง และไม่แสดงความเทียบเท่ากับสมองมนุษย์ ระบบจริงอาจรวม หรือตัดบางโมดูลออก
ลูกศรในแถวหลักแสดงข้อมูลระหว่างทำงาน ส่วนข้อความใต้โมดูลสนับสนุนบอกปลายทางของข้อมูล ไม่ใช่ลำดับที่ทุกระบบต้องทำครบ
รับข้อมูลสังเกต (Observation / Encoding)
รับข้อมูลจากสภาพแวดล้อมหรือเครื่องมือ แล้วแปลงเป็นคุณลักษณะที่ส่วนประมาณสถานะใช้ต่อได้ ข้อมูลสังเกตไม่จำเป็นต้องเผยสถานะจริงครบทั้งหมด
- INPUT · ข้อมูลเข้า
- ภาพ ข้อความ ค่าจากเซนเซอร์ หรือผลตอบกลับของเครื่องมือ พร้อมเวลาและแหล่งที่มา
- OUTPUT · ข้อมูลออก
- คุณลักษณะหรือเหตุการณ์ที่เข้ารหัสแล้ว พร้อมข้อมูลคุณภาพและสิ่งที่ยังไม่แน่ใจ
- DATA STRUCTURE · รูปแบบข้อมูล
- ตัวอย่าง: observation record {time, source, payload} หรือเวกเตอร์คุณลักษณะ ไม่จำเป็นต้องใช้ทั้งสองแบบ
- CHECK · สิ่งที่ตรวจสอบได้
- ข้อมูลมาจากแหล่งใด เวลาใด แปลงหน่วยถูกหรือไม่ และคุณลักษณะตรงกับ Input หรือไม่
- FAILURE MODE · จุดที่อาจผิดพลาด
- เซนเซอร์ขาดข้อมูล ข้อความกำกวม หน่วยไม่ตรง หรือ Encoder ตีความผิดก่อนส่งต่อ
ดูความสัมพันธ์กับโมดูลอื่นและขอบเขตข้ออ้าง
ส่งข้อมูลให้ State Estimate และอาจบันทึกเหตุการณ์ลง External Memory การรับข้อมูลไม่เท่ากับการมีการรับรู้แบบมนุษย์
การเปลี่ยนโมดูลที่เลือกเป็นการสำรวจข้อมูลของแผนผัง ไม่ได้ฝึกโมเดล การอัปเดตสถานะหรือความจำภายนอกก็ไม่ทำให้พารามิเตอร์โมเดลเปลี่ยนโดยอัตโนมัติ
| Module / หน้าที่ | Input → Output และโครงสร้างข้อมูล | ตัวอย่าง / สิ่งที่ตรวจได้ / Failure Mode |
|---|---|---|
| Observation Adapter | ข้อมูลภายนอก → observation พร้อมเวลาและแหล่งที่มา; record หรือ event | อ่านช่องปิดจากแผนที่; ตรวจ payload ต้นทาง; ข้อมูลล่าช้าหรือ parser ผิด |
| State Estimator | observation + ประวัติ → state estimate; grid, object map หรือ belief | อัปเดตช่องที่รู้ว่าปิด; ตรวจเวอร์ชันสถานะ; สับสนค่าที่ไม่รู้กับช่องว่าง |
| Memory Store | observations และผลกระทำ → ประวัติที่ค้นคืนได้; event log + state snapshot | เก็บว่าชนตรงไหน; ตรวจ timestamp; ดึงเหตุการณ์เก่ามาใช้เป็นปัจจุบัน |
| Transition Model | state + action → predicted next state; rules หรือ learned dynamics | ทำนายตำแหน่งหลังเดิน; เทียบกับผลจริง; กฎไม่ตรงสภาพแวดล้อม |
| Goal / Cost Evaluator | เป้าหมาย + สถานะที่ทำนาย → cost, constraint หรือ reward | ถึงปลายทางโดยไม่ผ่านช่องปิด; ตรวจเงื่อนไข; optimize proxy ผิด |
| Planner / Policy | state + model + objective → แผนหรือ action; search frontier หรือ policy output | ค้นเส้นทางด้วย BFS ใน Lab; ตรวจเส้นทางและเหตุผลที่ไม่มีทาง; ค้นนานหรือใช้สถานะเก่า |
| Action Executor | action ที่เลือก → คำสั่งและผลตอบรับ; command/result record | ส่งคำสั่งเดินหนึ่งช่อง; ตรวจตำแหน่งหลังทำ; timeout แล้วทำซ้ำเกิดผลซ้ำ |
| Feedback Evaluator | prediction + ผลที่สังเกต → error และเหตุให้ปรับสถานะหรือโมเดล | พบว่าตำแหน่งต่างกัน; ตรวจคู่ predicted/actual; metric ไม่เห็นข้อผิดพลาดสำคัญ |
ในผังนี้ Memory ส่งประวัติให้ State Estimator, Model ส่งค่าคาดให้ Planner และ Feedback ส่งผลจริงกลับไปปรับข้อมูล การเปลี่ยนกฎหรือฝึกโมเดลต้องเป็นอีกขั้นตอน
เก็บเหตุการณ์ให้ตรวจย้อนหลังได้
Record เชิงแนวคิดอาจมี observation_id, observed_at, source, state_version, action, predicted_state, actual_state และ error พร้อมแยกค่าที่สังเกตจากค่าที่อนุมาน
บันทึกเวอร์ชันสถานะและข้อจำกัดที่ใช้วางแผน ตรวจเงื่อนไขใหม่เมื่อข้อมูลเปลี่ยน และตรวจ Executor แยก เพราะ model ที่ดีไม่แก้ปัญหาคำสั่งซ้ำหรือผลตอบรับไม่ครบ
Operational Flow: จากคาดการณ์สู่ผลจริง
กำหนดสถานการณ์ SIMULATION ที่ Agent อยู่ (0,5) และปลายทางอยู่ (6,0) ในตาราง 7 คอลัมน์ × 6 แถว เดินได้ทีละช่องในสี่ทิศ ต้นทุนทุกก้าวเท่ากัน ช่องปิดเดินเข้าไม่ได้ และการพยายามเดินเข้าช่องปิดทำให้ตำแหน่งคงเดิม กติกานี้ผู้เขียนกำหนด ไม่ได้เรียนรู้จากข้อมูลหุ่นยนต์
- รับข้อมูล: อ่านตำแหน่งและช่องปิด แล้วบันทึกเป็นสถานะภายใน
- วางแผน: ใช้ Breadth-First Search หรือ BFS ค้นเส้นทางที่ใช้จำนวนก้าวน้อยที่สุดตามแผนที่ที่มี ภายใต้กติกาต้นทุนเท่ากันนี้ การสั่งเดินตามแผนแต่ละครั้งค้นใหม่จากตำแหน่งล่าสุด แต่ยังใช้ข้อมูลช่องปิดเดิมจนกดสังเกตโลก
- คาดการณ์: ใช้ Transition Model คำนวณว่าก้าวถัดไปจะไปอยู่ช่องใด
- โลกเปลี่ยน: ผู้อ่านปิดช่องบนเส้นทางในโลกจริงของแบบจำลอง โดยยังไม่อัปเดตแผนที่ภายใน
- ลงมือและตรวจ: Agent พยายามเดินตามข้อมูลเก่า แล้วเปรียบเทียบตำแหน่งที่คาดกับตำแหน่งจริง Feedback แก้ตำแหน่งภายในทันทีทุกก้าว แต่ยังไม่แก้รายการช่องปิดอัตโนมัติ
- สังเกตใหม่: รับแผนที่ล่าสุด อัปเดตสถานะ และค้นเส้นทางใหม่ หากไม่มีเส้นทางให้แสดงว่าไปไม่ถึง
Prediction Error คือระยะ Manhattan: error = |x̂ − x| + |ŷ − y| โดย (x,y) เป็นตำแหน่งจริงและ (x̂,ŷ) เป็นค่าคาด หน่วยเป็นช่อง ไม่ใช่คะแนนความฉลาด ค่าอาจเป็นศูนย์แม้แผนที่ส่วนที่ไม่ได้เดินผ่านล้าสมัย


Pseudocode เชิงแนวคิด — ไม่ใช่โค้ดพร้อมใช้งานทุกระบบ:
observe environment
update external state estimate
plan using transition rules and goal
if no legal plan: report unreachable and stop
predict next state for the selected action
execute one action
observe resulting position
compare prediction with observation
record the pair and the error
refresh observations and replan when needed
วงจรนี้ปรับสถานะและแผน ไม่ได้ปรับน้ำหนักหรือกฎ หากโลกเปลี่ยนกติกา เช่น พื้นลื่น ต้องแก้หรือเรียนรู้ Transition Model แล้วทดสอบเพิ่ม
เปรียบเทียบแนวทางและหลักฐานจากระบบจริง
Symbolic, Latent และ Hybrid เหมาะกับโจทย์ต่างกัน
| ประเด็น | Symbolic | Latent | Hybrid ที่เสนอในบทความ |
|---|---|---|---|
| ตัวแทน | ข้อเท็จจริง วัตถุ กฎ หรือโครงสร้างสถานะ | ตัวแปรภายในที่เรียนรู้จากข้อมูล | ตัวแทนที่เรียนรู้เชื่อมกับสถานะ/ข้อจำกัดที่อ่านได้ |
| ข้อมูลที่ต้องใช้ | คำจำกัดความและกฎที่เพียงพอ; อาจเรียนรู้บางส่วนได้ | ประสบการณ์และวัตถุประสงค์การฝึก | ต้องมีทั้งข้อมูลฝึกและวิธีเชื่อมตัวแทน |
| จุดตรวจ | กฎ เงื่อนไข และเส้นทางการค้น | loss, rollout, ผลควบคุม และการทดสอบย้ายบริบท | ตรวจทั้งสองส่วนและความผิดพลาดที่จุดเชื่อม |
| งานที่น่าลอง | workflow หรือโลกที่กฎและสถานะระบุได้ชัด | การควบคุมจากภาพ/เซนเซอร์ที่แทนด้วยมือยาก | งานที่รับข้อมูลซับซ้อนแต่มีข้อจำกัดชัด |
| ข้อจำกัด | ข้อมูลและกฎไม่ครบทำให้แผนผิด | ทำนายไกลผิดสะสมและตีความยาก | เพิ่มต้นทุนและความคลาดเคลื่อนจากการแปลง |
| สถานะหลักฐาน | มีภาษาวางแผนและระบบวิจัยมายาวนาน | มีผลทดลองหลายระบบที่ระบุขอบเขตได้ | แผนภาพของเรายังไม่ผ่านผลทดลองจริง |

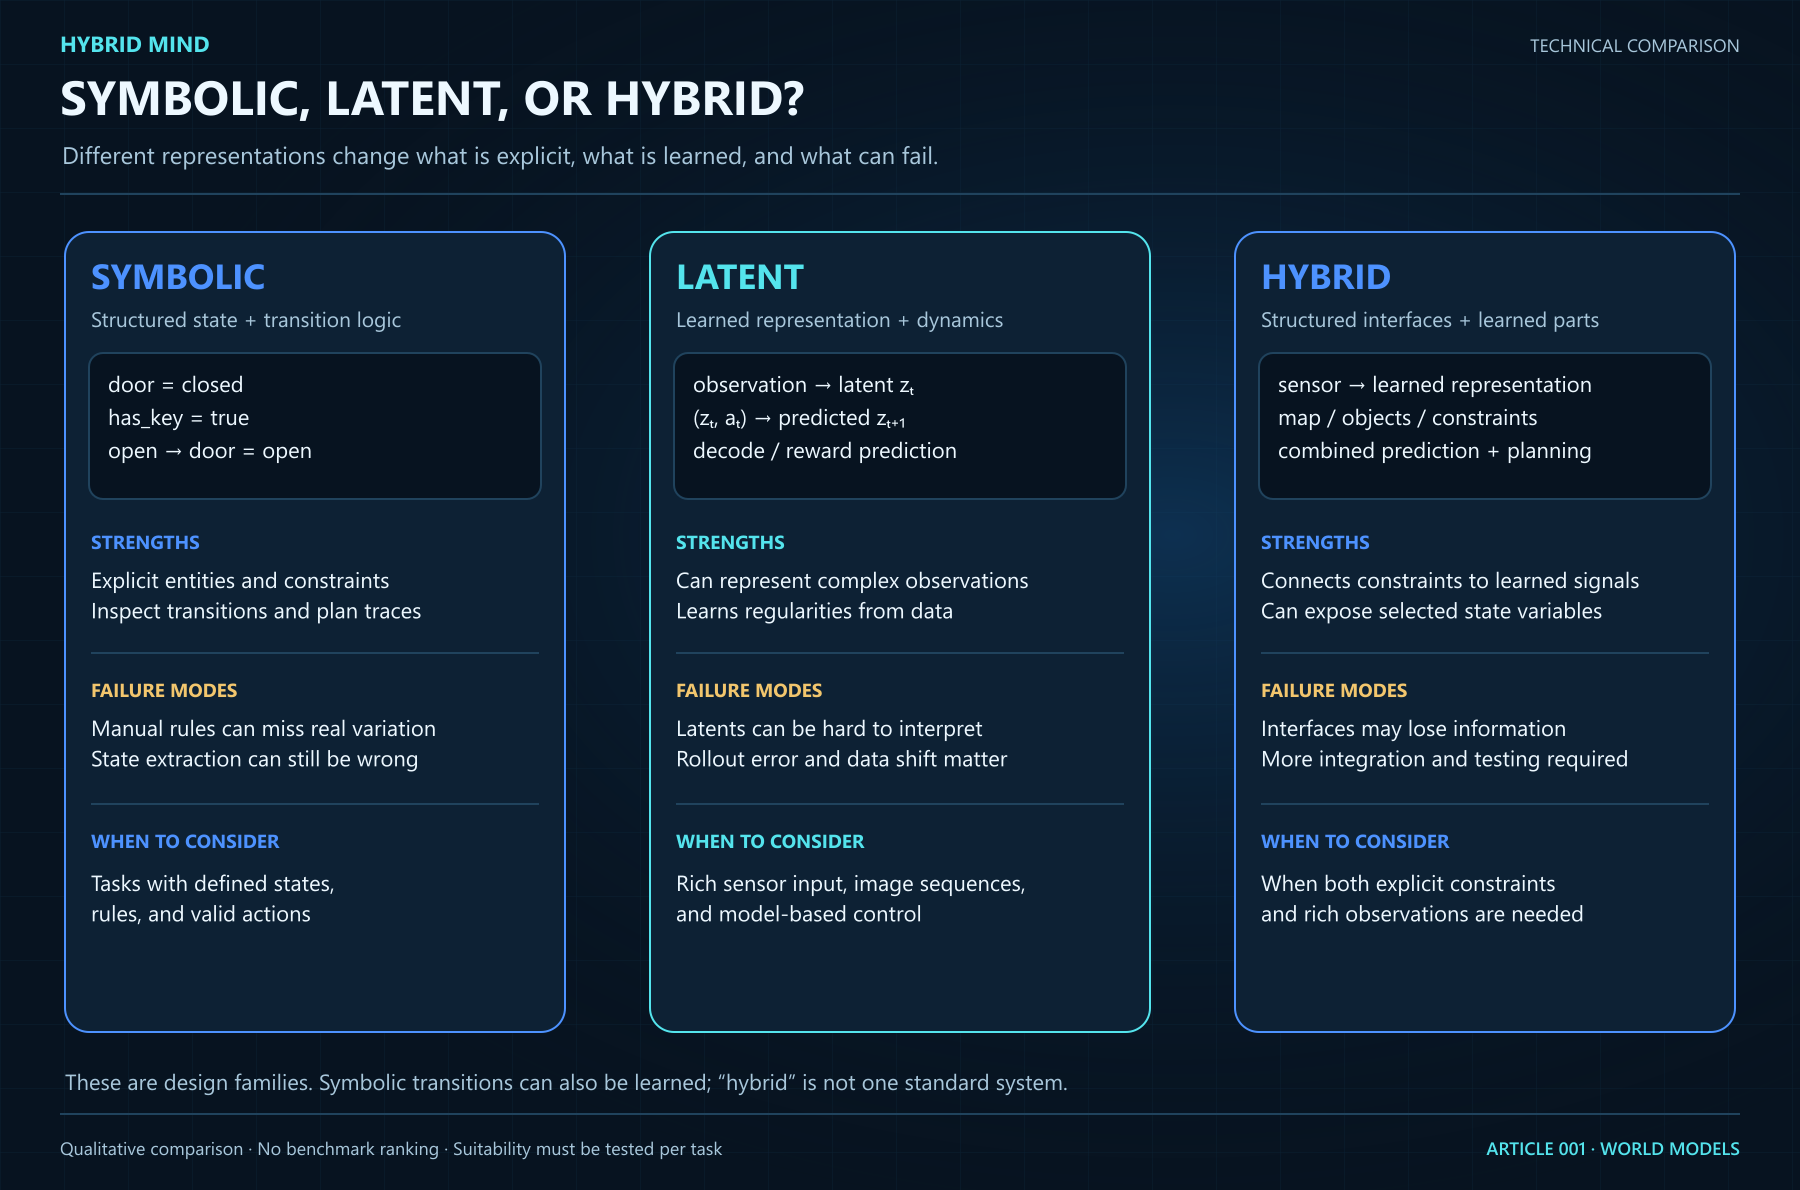
ตารางเป็น ANALYSIS จากกลไก ไม่มี Benchmark ที่พิสูจน์ผู้ชนะทุกงาน ต้องพิจารณาความถูกต้องของสถานะ ผลตัดสินใจ และต้นทุนร่วมกัน
PlaNet: ค้นอนาคตตอนเลือกการกระทำ
PlaNet ใน ICML 2019 เรียนรู้พลวัต latent จากภาพ ใช้ Model Predictive Control ทดลองลำดับ action เลือกก้าวแรก แล้วรับข้อมูลเพื่อวางแผนใหม่ ผลมาจากงานควบคุมจำลอง จึงยังไม่รับรองโลกจริงทุกแบบ บทความ ICML / PMLR
DreamerV3: จินตนาการเพื่อฝึก แล้วใช้ Policy ลงมือ
DreamerV3 มี preprint มกราคม 2023 และฉบับ Nature วันที่ 2 เมษายน 2025 ระบบเรียนรู้ World Model และฝึก Actor–Critic จากเส้นทางจำลองใน latent แต่ใช้ Actor เลือก action ตอนลงมือโดยไม่มี lookahead search
การใช้ hyperparameters ชุดเดียวหลายงานหมายถึงฝึกในแต่ละงานด้วยค่าตั้งเดียวกัน ไม่ใช่โมเดลที่ฝึกครั้งเดียวแก้ทุกโดเมน ผลขึ้นกับสภาพแวดล้อม รางวัล และการฝึก บทความ Nature, โค้ดโครงการ
MuZero: โมเดลเพื่อการค้นหาที่ไม่ต้องสร้างภาพโลกครบ
MuZero ใน Nature วันที่ 23 ธันวาคม 2020 มี Representation, Dynamics และ Prediction Function ทำนาย hidden state, reward, value และ policy เพื่อใช้กับ Monte Carlo Tree Search (MCTS) โดยไม่บังคับสร้าง observation กลับครบ
ระบบไม่ได้รับ true transition dynamics สำหรับค้นหา แต่ยังมี observation/action interface ประสบการณ์ และการกรอง legal actions ที่ root ผล Go, chess, shogi และ Atari ไม่รับรองงานเปิดกว้างทั้งหมด เอกสารเผย pseudocode และรายละเอียด โดยไม่ได้ระบุว่าเผยแพร่โค้ดการฝึกต้นฉบับครบทั้งระบบ บทความ Nature
DayDreamer: เรียนรู้กับหุ่นยนต์จริงพร้อมข้อจำกัดจริง
DayDreamer ใน CoRL 2022 / PMLR 2023 ทดลองหุ่นยนต์จริงหลายแพลตฟอร์ม ใช้ Replay Buffer ฝึก World Model และ Actor–Critic มี weight updates จริง ต่างจาก Lab ที่แก้แผนที่
มี reward engineering, action filtering และการแทรกแซง เช่น ย้ายหุ่นที่ขอบพื้นที่ทดลอง จึงรองรับ research prototype ในงานที่กำหนด ไม่ใช่การรับรองระบบทั่วไปที่ไร้ผู้ดูแล บทความ DayDreamer
การทำซ้ำโดย HYBRID MIND: UNKNOWN รอบนี้ไม่ได้ฝึกระบบข้างต้น โค้ดและผลที่ผู้วิจัยรายงานช่วยตรวจวิธีการ แต่ไม่แทน independent reproduction
ข้อจำกัดและ Failure Modes ที่ควรทดสอบ
สถานะเก่า: แบบจำลองอาจใช้แผนที่เมื่อวานหรือผล API ที่หมดอายุแล้ว ทดสอบโดยเปลี่ยนโลกหลังสร้างแผน แล้วดูว่าระบบตรวจพบและเปลี่ยนแผนเมื่อใด
เห็นโลกไม่ครบ: เก็บสิ่งที่ไม่ทราบเป็น UNKNOWN ตามโครงสร้างที่ใช้ การถือว่าช่องที่ไม่เห็นว่างอาจผิด Lab อ่านแผนที่ครบเมื่อสั่งสังเกต จึงไม่ได้ทดสอบ partial observability
ความผิดพลาดสะสม: ทำนายหนึ่งก้าวดีอาจไม่พอสำหรับหลายก้าว วัดตาม horizon และการเปลี่ยนโลก; error ใน latent ต่างชนิดอาจเทียบตรง ๆ ไม่ได้
Planner ใช้ช่องโหว่ของโมเดล: แผนที่ model ประเมินดีอาจล้มเหลวจริง การเพิ่มรอบค้นไม่รับรองว่าดีขึ้น ต้องวัดผลจริงคู่กับค่าคาด
เป้าหมายวัดผิด: Reward หรือ Cost ที่ไม่สะท้อนงานทำให้ Agent สำเร็จตามตัวเลขแต่ผิดเจตนา การถึงปลายทางในเวลาน้อยไม่ชดเชยการละเมิดข้อจำกัดที่งานกำหนดไว้
อธิบายได้แต่ตรวจไม่ได้: ภาษาที่เล่าแผนอย่างราบรื่นอาจไม่สัมพันธ์กับการคำนวณจริง เก็บ log การค้น ผลเครื่องมือ และตัวตรวจเงื่อนไขควบคู่กัน อ่านต่อ Loop Engineering: วงจรและจุดตรวจ Agent
Interactive World Model Lab — ทดลองความต่างระหว่างโลกกับแบบจำลอง
SIMULATION: ตัวอย่างเชิงสัญลักษณ์ที่ใช้กฎเขียนด้วยมือ ไม่ใช่โมเดลประสาทที่ผ่านการฝึก และไม่ใช่ Benchmark ของ AI Agent จริง
Lab ให้แก้ช่องปิด ดูสถานะภายใน คาดการณ์ ลงมือ เทียบผล และสังเกตใหม่เพื่อวางแผน มี Reset คืนจุดเริ่มต้น ค่าที่แสดงจำกัดตามกติกาตาราง
โลกเปลี่ยน แต่ Agent รู้หรือยัง?
ทดลอง World Model แบบสัญลักษณ์: เปลี่ยนโลกจริง ดูสิ่งที่ Agent คาดว่าจะเกิดขึ้น แล้วอัปเดตแผนที่เพื่อวางแผนใหม่
แบบจำลองเพื่อการศึกษา · กฎเดินบนตารางที่กำหนดไว้ · ค้นหาเส้นทางด้วย BFS · ไม่มี LLM หรือการฝึกน้ำหนักโมเดล
เกมจำลอง World Model
ภารกิจ: พา Agent A ไปให้ถึงเป้าหมาย G หลังโลกเปลี่ยน เลือกเดินเองด้วย W/A/S/D หรือเดินตามแผนทีละก้าว หากชนสิ่งกีดขวาง ให้สังเกตโลกและหาเส้นทางใหม่จนสำเร็จ
1 เพิ่มสิ่งกีดขวาง → 2 สั่งเดินตามแผน → 3 สังเกตโลกและวางแผนใหม่
โลกจริงในแบบจำลอง
คลิกช่องว่างหรือกำแพงเพื่อเปลี่ยนสิ่งกีดขวาง ปุ่มลูกศรย้ายโฟกัสภายในตาราง; Enter หรือ Space เปลี่ยนช่อง
แผนที่ใน World Model
Agent ใช้แผนที่นี้คาดการณ์และค้นหาเส้นทาง เส้นสีฟ้าคือแผนตามข้อมูลนี้ เส้นประสีเหลืองแสดงส่วนต่างให้ผู้อ่านเห็น โดย Agent ไม่ได้นำส่วนต่างนี้ไปใช้
ผลของการกระทำล่าสุด
ดูบันทึกที่ตรวจสอบได้
| ครั้ง | การกระทำ | คาด | จริง | Error |
|---|
ลองสั่งการเอง
ปุ่มด้านขวาหรือ W / A / S / D ขณะโฟกัสอยู่ใน Lab สั่งการหนึ่งครั้ง แม้แผนที่เดิมจะบอกว่าช่องนั้นผ่านไม่ได้
ใช้แผนเริ่มต้นที่ Lab สร้างไว้ ปิดช่องก้าวถัดไปโดยยังไม่สังเกตใหม่ แล้วสั่งเดิน: predicted กับ actual position จะต่างกัน เมื่อสังเกตใหม่เส้นทางอาจเปลี่ยน หากปิดทุกทางต้องแสดงว่าไม่พบเส้นทาง
ทดลอง state tracking, prediction, feedback และ replanning ได้ แต่ไม่ได้ทดสอบ latent learning, calibrated uncertainty, RL หรือประสิทธิภาพโลกจริง
ทิศทางวิจัย: จะรู้ได้อย่างไรว่าแบบจำลองช่วยตัดสินใจ
ควรถามว่า “การทำนายช่วยเลือก action ที่ได้ผลจริงหรือไม่” วัด one-step prediction, multi-step rollout, task success, constraint violations และต้นทุน
เทียบ reactive กับ planning Agent โดยคุมข้อมูล เป้าหมาย และงบ หากฝ่ายหนึ่งเห็นแผนที่ครบแต่อีกฝ่ายเห็นเฉพาะจุด ก็ยังแยกประโยชน์ของ model จากข้อมูลไม่ได้
ทดสอบการย้ายบริบทโดยเปลี่ยนกฎหรือรูปลักษณ์ ตรวจว่าต้องปรับสถานะ กฎ หรือฝึกใหม่ สำหรับ Hybrid ให้นับ error จากการแปลง latent เป็นสัญลักษณ์ด้วย
Shared World State สำหรับหลาย Agent ต้องจัดการเวลา เวอร์ชัน และความขัดแย้ง เทียบกับ Single Agent ด้วยงบและข้อมูลที่เหมาะสม ประเด็นนี้ยังเป็นคำถามวิจัย
Practical Takeaways: เริ่มออกแบบจากสิ่งที่ตรวจได้


- กำหนดโลกที่เกี่ยวกับงาน: ระบุ state, observation, action และเป้าหมายให้ตรวจได้ แทนการพยายามจำลองทุกอย่าง
- แยกอดีต ปัจจุบัน และค่าคาด: ใส่เวลา แหล่งที่มา และเวอร์ชันให้ข้อมูลที่ใช้ตัดสินใจ
- เริ่มจากกฎที่ทดสอบง่ายเมื่อโจทย์รองรับ: สร้าง baseline ก่อนเพิ่มโมเดลที่เรียนรู้ ความซับซ้อนต้องมีประโยชน์ที่วัดได้
- เก็บ prediction ก่อนลงมือ: เทียบผลจริงด้วย metric ที่ตรงกับความล้มเหลวที่สนใจ และตรวจทั้งระยะใกล้กับระยะไกล
- รายงานระดับการปรับระบบ: อัปเดตแผนที่ เปลี่ยน Prompt เปลี่ยนกฎ และฝึกน้ำหนักเป็นคนละสิ่ง พร้อมระบุสิ่งที่ยัง UNKNOWN
FAQ
World Model ต่างจาก Memory อย่างไร
Memory เก็บข้อมูลหรือประสบการณ์ World Model คาดการเปลี่ยนสถานะตาม action ทั้งสองอาจใช้ที่เก็บเดียวกัน แต่การเก็บข้อมูลไม่ยืนยันกลไกทำนาย
RAG ถือเป็น World Model หรือไม่
RAG ค้นข้อมูลประกอบคำตอบ อาจเป็นแหล่งความรู้ให้ World Model แต่ Retrieval ไม่ได้ทำนายสถานะถัดไปตาม action โดยอัตโนมัติ
World Model ต้องใช้โครงข่ายประสาทหรือสร้างวิดีโอหรือไม่
ไม่จำเป็น กฎ symbolic จำลองผล action ได้ ส่วน latent บางระบบทำนาย reward/value โดยไม่สร้างภาพครบทุกส่วน
Dreamer วางแผนค้นอนาคตทุกครั้งที่ลงมือหรือไม่
DreamerV3 ฝึก Actor–Critic จากเส้นทางจำลอง แล้วใช้ Actor ลงมือโดยไม่มี lookahead ต่างจาก MPC ของ PlaNet และ MCTS ของ MuZero
Agent เปลี่ยนแผนหลังชน แปลว่าเรียนรู้โมเดลแล้วหรือไม่
ยังสรุปไม่ได้ อาจแก้แผนที่และค้นด้วยกฎเดิม ต้องตรวจว่าเปลี่ยน External State, Prompt, กฎ, Policy หรือน้ำหนัก
Symbolic หรือ Latent ดีกว่ากัน
ขึ้นกับข้อมูล กฎ และต้นทุน Symbolic ใช้เงื่อนไขที่ระบุชัด ส่วน Latent รองรับอินพุตซับซ้อนแต่ต้องฝึก ไม่มีผู้ชนะทุกงานจากหลักฐานนี้
Prediction Error เป็นศูนย์หมายถึงเข้าใจโลกถูกทั้งหมดหรือไม่
ไม่ใช่ ค่าตรงเฉพาะ metric และตัวอย่างที่วัด อาจยังผิดในส่วนที่ไม่สังเกตหรือ metric ไม่ครอบคลุม
References: ต้นทางและสถานะหลักฐาน
- Sutton (1990), Integrated Architectures for Learning, Planning, and Reacting Based on Approximating Dynamic Programming. ICML 1990, หน้า 216–224; ตรวจได้เฉพาะระเบียน/บทคัดย่อ. ระเบียน, DOI
- McDermott และ AIPS-98 Planning Competition Committee (1998), PDDL—The Planning Domain Definition Language, version 1.2. Technical Report เดือนตุลาคม 1998. PDF ต้นฉบับ
- Fox & Long (2003), PDDL2.1: An Extension to PDDL for Expressing Temporal Planning Domains. JAIR 20:61–124, peer-reviewed. ระเบียนและ accepted manuscript
- Ha & Schmidhuber (2018), World Models. arXiv preprint; แยกจากบทความ peer-reviewed คู่กัน. arXiv, Recurrent World Models Facilitate Policy Evolution, NeurIPS 2018
- Hafner และคณะ (2019), Learning Latent Dynamics for Planning from Pixels (PlaNet). ICML / PMLR 97, peer-reviewed. บทความและ PDF
- Hafner และคณะ (2025), Mastering diverse control tasks through world models. Nature; เวอร์ชันวารสารของ DreamerV3 ซึ่งมี preprint ตั้งแต่ 2023. Nature, preprint, โค้ด
- Schrittwieser และคณะ (2020), Mastering Atari, Go, chess and shogi by planning with a learned model. Nature, peer-reviewed; MuZero. Nature, preprint / วิธีการ
- Lewis และคณะ (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS, peer-reviewed. บทความ
- Wu และคณะ (CoRL 2022; proceedings 2023), DayDreamer: World Models for Physical Robot Learning. PMLR 205, peer-reviewed; ผลจากหุ่นยนต์จริงภายใต้การตั้งค่าที่รายงาน. บทความและ PDF
- Turpin และคณะ (2023), Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. NeurIPS, peer-reviewed; ความไม่ตรงกันของ explanation กับอิทธิพล input ในการทดลองที่ศึกษา. บทความ
ขอบเขตหลักฐาน: FACT ใช้กับวิธีและรายละเอียดที่ตรวจจากต้นทางได้ ผลประสิทธิภาพที่ไม่ได้ทำซ้ำในรอบนี้อ้างว่าเป็นผลที่ผู้วิจัยรายงาน การเปรียบเทียบเพื่อเลือกงานเป็น ANALYSIS แผนสถาปัตยกรรมผสมเป็น HYPOTHESIS และผล Lab เป็น SIMULATION ไม่มีการสร้างตัวเลข Benchmark ของระบบจริงขึ้นใหม่
ใส่ความเห็น