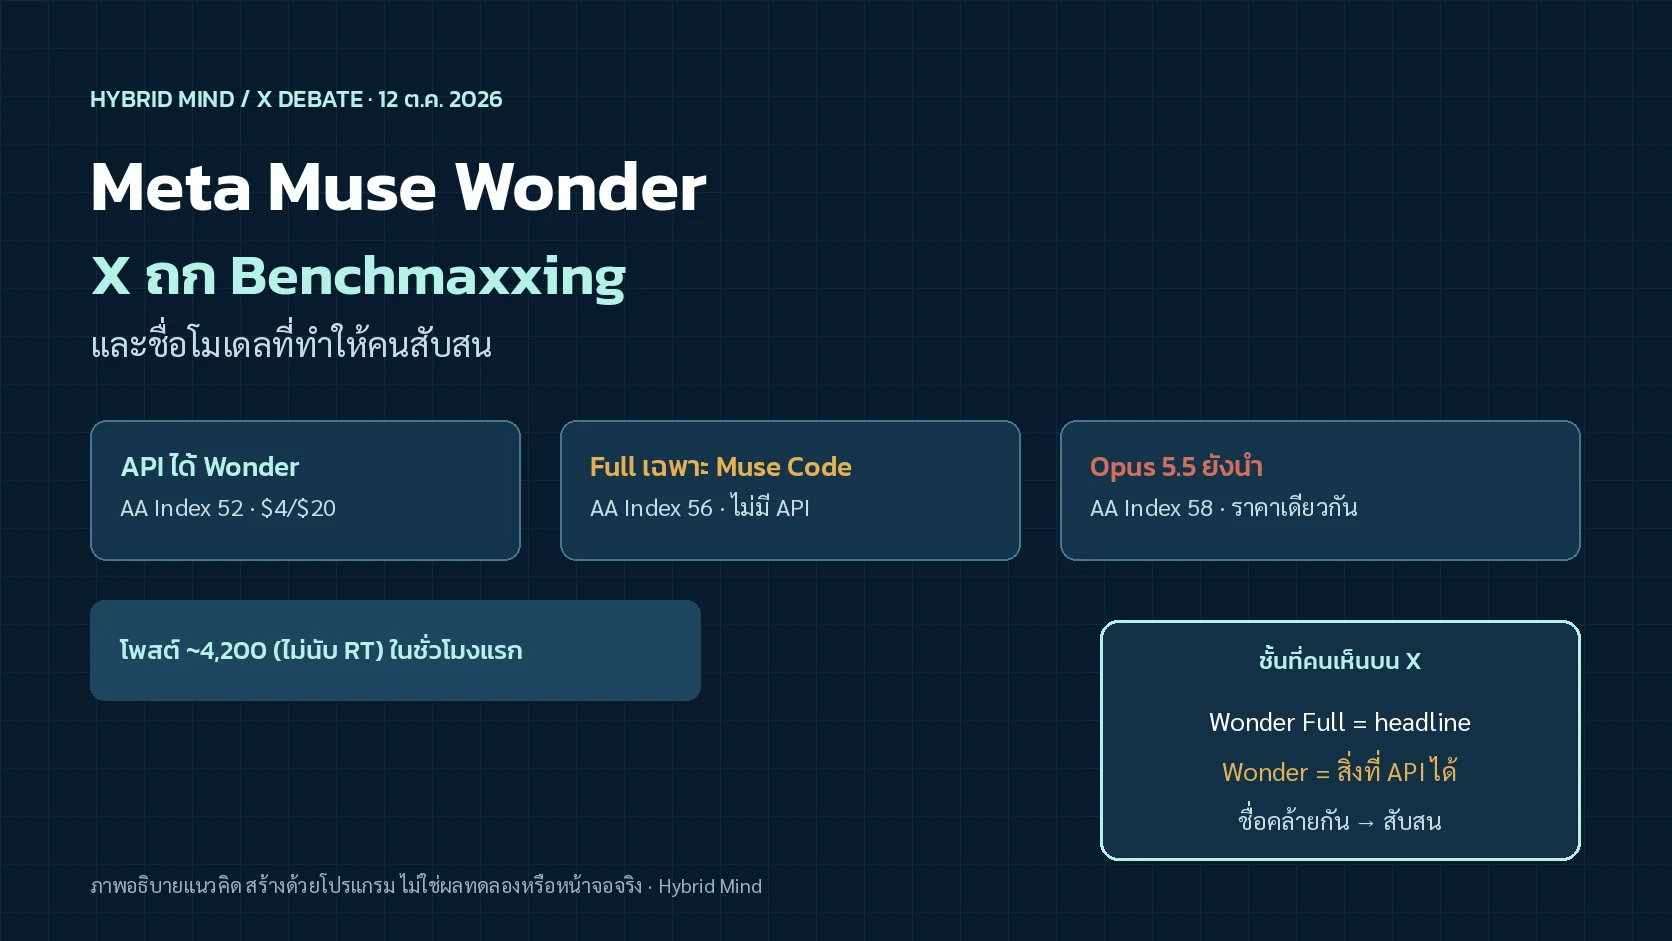
Meta Muse Wonder: กลับสู่ frontier จริง หรือแค่ Benchmaxxing?
วันที่ 12 ต.ค. 2026 Meta เปิดตัว Muse Wonder และ Muse Wonder Full ซึ่ง Artificial Analysis ให้คะแนน Intelligence Index (max) ที่ 52 และ 56 ตามลำดับ เทียบกับ Muse Spark 1.3 ที่ 48 เมื่อหกสัปดาห์ก่อน และใกล้ Claude Opus 5.5 ที่ 58 — แต่สิ่งที่คนบน X ถกหนักไม่ใช่แค่ตัวเลข
ประเด็นหลักมีสามชั้น: (1) Wonder Full ไม่มีใน Meta Model API เปิดเฉพาะผู้สมัคร Muse Code ในขณะที่ API ได้แค่ Wonder (2) ชื่อโมเดลคล้ายกัน ทำให้ผลทดสอบของ Wonder สะท้อนกลับไปที่ Full (3) ราคา Wonder API เท่า Opus 5.5 ($4/$20 ต่อ 1M โทเคน) แต่คะแนนดัชนีต่ำกว่า — Hybrid Mind ยังไม่ได้ทดลองใช้งานจริง บทความนี้อ่านจากต้นฉบับ Meta, Artificial Analysis และโพสต์บน X

ไม่ใช่แค่ “โมเดลใหม่ออก” แต่ถามว่าได้อะไรจริง
เย็นวันที่ 12 ต.ค. 2026 ตามเวลาไทย บัญชี @AIatMeta ประกาศ Muse Wonder series (ตอนที่อ่าน มียอดแสดงผลราว 1.14 แสน ไลก์ราว 1,495) ตามด้วยโพสต์ของ Shengjia Zhao จากทีม Meta และพอดแคสต์ Cheeky Pint ของ John Collison ที่เชิญ Mark Zuckerberg กับ Alexandr Wang (ยอดแสดงผลราว 3.45 แสน)
ข่าวเดียวกันถูกอ่านคนละมุมทันที ฝั่งหนึ่งยก Artificial Analysis ว่า Full ได้ 56 ห่าง Opus แค่ 2 จุด และ SOTA บน DeepSWE อีกฝั่งชี้ว่า รุ่นที่แรงที่สุดเรียกผ่าน API ไม่ได้ และชื่อ “Wonder” กับ “Wonder Full” ทำให้คนทดสอบรุ่นอ่อนแล้วโทษทั้งตระกูล
ได้โมเดลไหนจริง?
เลขบนกราฟเป็น Full หรือ Wonder? เรียกผ่าน API ได้วันนี้ไหม
Benchmaxxing หรือไม่?
โชว์เลขรุ่นที่เข้าถึงยาก แล้วขายรุ่นที่อ่อนกว่าในราคาเดียวกับคู่แข่ง
ชื่อทำให้สับสนไหม?
ผล Wonder ไม่ดีจะทำให้คนมอง Full แย่ตามไปด้วยหรือไม่
คนบน X พูดเรื่องนี้มากแค่ไหน
เรานับด้วย X Counts API จากคำค้น ("Muse Wonder" OR "MuseWonder") ไม่นับรีโพสต์ ได้ราว 4,214 โพสต์ในช่วง spike หลังเปิดตัว และเมื่อนับรวมรีโพสต์ตั้งแต่ 16:00 UTC วันที่ 12 ต.ค. ได้ราว 9,492 โพสต์ ชั่วโมง 17:00–18:00 UTC มีราว 3,530 โพสต์ (รวม RT)
* ชั่วโมง 21 UTC นับไม่ครบ (ถึงราว 21:04 UTC) · รวม ~9,492 โพสต์รวมรีโพสต์ · คำค้น (“Muse Wonder” OR “MuseWonder”) · ไม่นับรีโพสต์แยกได้ ~4,214 ในหน้าต่างที่วัด · ตัวเลขไม่บอกสัดส่วนเห็นด้วย/ไม่เห็นด้วย

สิ่งที่ยืนยันได้จากต้นฉบับ (ไม่ใช่จากโพสต์ไวรัล)
สองรุ่น คนละช่องทาง
ตาม Meta Newsroom และ research blog: Muse Wonder ใช้ได้วันนี้ผ่าน Meta Model API และ Muse Code ส่วน Muse Wonder Full ใช้ได้วันนี้สำหรับผู้สมัคร Muse Code
คะแนน Artificial Analysis
ตาม บทวิเคราะห์ Artificial Analysis: Wonder Full (max) = 56, Wonder (max) = 52, Spark 1.3 (max) = 48 · Full ติดท็อป 3 ใน 6 จาก 10 การวัดของดัชนี · ราคา Wonder = $4 / $0.20 cached / $20 ต่อ 1M โทเคน · context 1M
จุดแข็งที่ Meta โฆษณา
Active Memory (จำสิ่งสำคัญข้ามบทสนทนา) และ Active Focus (ทำงานยาวหลายขั้น กู้จาก error) · เน้นงาน agent ส่วนตัวและอาชีพ รวมกฎหมาย การเงิน สุขภาพ และ coding
DeepSWE / Coding Agents
หลายโพสต์ (รวม @testingcatalog) อ้าง Full ได้ DeepSWE 79 และ Coding Agents Index 68 ตาม AA · Hybrid Mind ตรวจกับบทความ AA แล้วว่า Coding Agents Full = 68, Wonder = 63, Spark = 54 · ค่า DeepSWE 79 ปรากฏในโพสต์และตารางที่ผู้ใช้แชร์ ควรเทียบกับตาราง Meta / AA โดยตรงก่อนสรุป


ทดลอง 01 — เลือกโมเดลตามงานและสิทธิ์เข้าถึง
การจำลองเชิงการศึกษาแบบกำหนดผลล่วงหน้า ไม่ใช่ผล latency หรือคุณภาพจริงของ Meta/Anthropic · คะแนนในแล็บเป็นค่าดัชนีสาธารณะที่อ้างอิง ไม่ใช่คะแนนงานของคุณ
งานที่คุณจะส่งให้ Agent
ช่องทางที่คุณมีวันนี้
—
กติกาจำลอง: ถ้ามีแค่ API จะเลือก Wonder ไม่ใช่ Full · ถางาน knowledge และเลือกได้อิสระ แล็บจะเตือนว่า Muse ยังอ่อนกว่าคู่แข่งบน AA-Omniscience ตาม AA · ไม่ใช่คำแนะนำซื้อขาย
ห้าค่ายความเห็น และโพสต์ตัวอย่าง
เราอ่านประกาศ คำตอบ โควต และบทสรุปที่เกี่ยวข้องราว 40+ โพสต์หลัก (จากคลื่นหลายพันโพสต์) แล้วจัดกลุ่มตามข้อโต้แย้ง ไม่ได้นับว่าค่ายไหนใหญ่กว่า บัญชีเล็กที่เป็นบุคคลทั่วไปเราไม่เอ่ยชื่อถ้าไม่จำเป็น แต่ใส่ลิงก์ให้ตรวจได้
A“Meta กลับสู่ frontier แล้ว”เชียร์
@testingcatalog (ยอดแสดงผลราว 1.5 หมื่น ไลก์ 327) สรุปว่า Full ได้ที่ 2 บน AA Index ห่าง Opus 2 จุด และ SOTA บน DeepSWE 79 · @ArtificialAnlys โพสต์อย่างเป็นทางการว่า 52 และ 56 เป็น “material gain” จาก 48 ภายใน 6 สัปดาห์ (ยอดแสดงผลราว 1.8 แสน) · บัญชีอย่าง @henkidama เขียนตรง ๆ ว่า “Meta is back at the frontier”
ตรวจแล้ว: ค่า 52/56/48 ตรงกับบทความ Artificial Analysis · ค่า “ห่าง Opus 2 จุด” สอดคล้องกับหลายสรุปที่อ้าง Opus = 58 · Hybrid Mind ไม่ได้ยืนยันทุกแถวในตาราง Meta เอง
B“Benchmaxxing: โชว์ Full แต่ API ได้ Wonder”วิจารณ์
@dummerspast39 เขียนว่า “Muse Wonder benchmaxxing scandal slowly cooking” — Meta โพสต์เลข Full ทุกที่ แต่ API ได้แค่ Wonder และ Wonder “dead last on the AA index in metas OWN chart” (ยอดแสดงผลราว 3.8 พัน) · @Joshua_WD สรุปในบทความว่า “The Stronger One Isn't in the API” และอ่าน model card แล้วพบว่ารุ่น API ชนะ 4 จาก 14 แถวและแพ้ท้ายสุด 4 แถวในตารางที่เขาอ้าง
ตรวจแล้ว: Meta Newsroom ยืนยันว่า Full อยู่เฉพาะ Muse Code · ข้อ “dead last ในตาราง Meta” เป็นการอ่านตารางจากผู้โพสต์ — เราไม่ได้เปิดไฟล์ตารางต้นฉบับทุกแถวในรอบนี้ จึงติดป้าย REPORTED
C“ชื่อ Terrible — Wonder กับ Full ปนกัน”ชื่อ
Adam Holter (@AdamHoltererer) แท็ก Alexandr Wang ว่า “Terrible naming” — Full ดูดี แต่ Wonder ไม่ดีในการทดสอบของเขา “everybody is getting bad results from Muse Wonder, and it reflects badly on Muse Wonder Full because they have the same name” (ยอดแสดงผลราว 5.5 พัน ไลก์ 44)
ตรวจแล้ว: เป็นความเห็นจากผู้ทดสอบ ไม่ใช่ผลสำรวจ · แต่ตรงกับความสับสนที่พบบ่อยในโพสต์สรุปที่พูดว่า “Muse Wonder” โดยไม่แยกรุ่น
D“ราคาเท่า Opus แต่คะแนน API ไม่เท่า”ราคา
หลายบัญชี (เช่น @aGim_asf, @trywavecode, @aipulseda1ly) เน้นว่า Wonder ตั้งราคา $4/$20 เท่า Opus 5.5 · Artificial Analysis ระบุเพิ่มว่า cost per Intelligence Index task ของ Wonder (max) ราว $4.52 สูงกว่า Spark เดิมหลายเท่า เพราะทั้งราคาต่อโทเคนและปริมาณ input สูงขึ้น · ฝั่งวิจารณ์สรุปว่า “จ่ายราคา frontier ได้รุ่นที่อยู่อันดับกลาง ๆ ของกระดาน”
ตรวจแล้ว: ราคา $4/$20 ตรงกับ AA · ค่า $4.52/task ตรงกับบทความ AA · การเทียบ “คุ้มหรือไม่” เป็นความเห็น
E“ชนะบาง bench แพ้บางตัว — ต้องลองงานจริง”นักปฏิบัติ
@PhyByte สรุปตารางที่แชร์กันว่า Full นำบน long-horizon coding และ memory / legal agent แต่ Opus ยังนำบน Terminal-Bench, OSWorld และ from-scratch programming · ฝั่ง AA เองก็บอกว่า knowledge ยังเป็นจุดอ่อนสัมพัทธ์ แม้ hallucination rate จะต่ำลง
ตรวจแล้ว: โครง “ชนะบางตัว แพ้บางตัว” สอดคล้องกับบทความ AA (Full ท็อป 3 ใน 6/10 แต่ไม่ใช่ทุกหมวด) · รายแถวจากตาราง Meta ที่ผู้ใช้แชร์ควรตรวจซ้ำกับต้นฉบับ

ทดลอง 02 — Benchmaxxing detector (จำลอง)
เครื่องมือฝึกคิด ไม่ใช่ข้อกล่าวหาว่า Meta โกง benchmark · ให้ติ๊กสิ่งที่คุณเห็นในโพสต์/ข่าว แล้วดูว่า “ความเสี่ยงที่เลขกับของที่ได้จริงไม่ตรงกัน” สูงแค่ไหน
—
ชื่อคล้ายกัน + ช่องว่าง API = คนคุยคนละของ
จุดที่ทำให้เธรดบน X ยาวผิดปกติไม่ใช่แค่คะแนน แต่คือคนละคนกำลังพูดถึงคนละผลิตภัณฑ์ โดยใช้คำเดียวกันว่า “Muse Wonder”


ทดลอง 03 — โพสต์นี้พูดถึงรุ่นไหน?
แบบฝึกอ่านโพสต์สมมติ เลือกคำตอบแล้วดูคำใบ้ · ไม่ใช่แบบทดสอบผลิตภัณฑ์จริง
ข้อความสมมติบน X
—

สิ่งที่หลักฐานสนับสนุน กับสิ่งที่ยังพิสูจน์ไม่ได้
| ข้อความที่วนบน X | สถานะ | หลักฐาน |
|---|---|---|
| Meta เปิด Muse Wonder + Muse Wonder Full วันที่ 12 ต.ค. 2026 | CONFIRMED | Meta Newsroom / research blog |
| Wonder ใช้ได้บน Meta Model API และ Muse Code; Full เฉพาะ Muse Code | CONFIRMED | Meta Newsroom takeaways |
| AA Index max: Full 56, Wonder 52, Spark 1.3 = 48 | CONFIRMED | artificialanalysis.ai/articles/muse-wonder |
| ราคา Wonder $4 / $20 ต่อ 1M โทเคน (cached $0.20) | CONFIRMED | Artificial Analysis |
| Full ห่าง Opus 5.5 แค่ 2 จุด (58 vs 56) | REPORTED | หลายโพสต์อ้าง AA รวม Artificial Analysis account — Hybrid Mind ไม่ได้ดึง scorecard Opus แยกในรอบนี้ |
| “Benchmaxxing / dead last บนตาราง Meta ของรุ่น API” | REPORTED | ความเห็นผู้ใช้ที่อ่านตาราง Meta — ช่องว่าง API ยืนยันได้ แต่คำว่า scandal เป็นการตีความ |
| ชื่อโมเดลทำให้ผล Wonder สะท้อน Full | ความเห็น | Adam Holter และรูปแบบการสรุปบน X — ไม่มีแบบสำรวจ |
| Active Memory / Active Focus ทำงานตามโฆษณาในงานจริง | NOT TESTED | Hybrid Mind ยังไม่ได้ทดลอง Muse Code หรือ API |
สิ่งที่หลักฐานสนับสนุน
- มีการเปิดตัวสองรุ่นจริง และช่องทางเข้าถึงไม่เท่ากัน
- คะแนนดัชนีสาธารณะกระโดดจาก Spark ภายใน ~6 สัปดาห์
- ราคา Wonder API อยู่ในระดับเดียวกับ Opus 5.5 ตาม AA
- บน X มีทั้งค่ายเชียร์และค่ายตั้งคำถามเรื่อง access gap / ชื่อ ชัดเจน
สิ่งที่ยังพิสูจน์ไม่ได้
- ว่า Full “ดีกว่า Opus ในงานของคุณ” หรือไม่
- สัดส่วนโพสต์ที่เข้าใจผิดรุ่น (ไม่มีแบบสำรวจ)
- คุณภาพจริงของ Active Memory ในผลิตภัณฑ์
- ว่าตารางทุกแถวของ Meta ถูกอ้างครบหรือถูกตัดมาเฉพาะจุดแข็ง
นำไปใช้อย่างไร แยกตามบทบาท
นักพัฒนาที่ใช้ API
สมมติว่าได้แค่ Muse Wonder ไม่ใช่ Full จนกว่า Meta จะเปิด API · เทียบกับคู่แข่งด้วย workload จริง ไม่ใช่ด้วยโพสต์ที่โชว์เลข Full · ใส่ A/B ที่วัด latency, tool-call success และต้นทุนต่องาน
ทีมที่สมัคร Muse Code ได้
ถ้าจะประเมิน “Meta กลับมาแข่ง frontier หรือยัง” ให้ทดสอบ Full เป็นหลัก และบันทึกชัดว่าใช้รุ่นไหน · อย่าสรุปร่วมกับผลจาก API
ผู้สรุปข่าว / คนโพสต์บน X
ขึ้นต้นด้วย “Wonder Full (Muse Code เท่านั้น)” หรือ “Wonder บน API” ทุกครั้ง · ลดโอกาสที่คนอื่นจะเอาเลขคนละรุ่นไปปนกัน
ผู้ซื้อระดับองค์กร
ถาม vendor ว่า SLA และราคาผูกกับรุ่นไหน · ถ้าราคาเท่า Opus ให้ขอหลักฐานบนงานของคุณไม่ใช่บน DeepSWE อย่างเดียว
แบบฝึก: เปิดทดลอง 02 แล้วติ๊กตามโพสต์ล่าสุดที่คุณเพิ่งอ่าน หากคะแนนความเสี่ยงสูง ให้กลับไปเปิด Meta Newsroom หนึ่งย่อหน้าเรื่อง availability ก่อนแชร์ต่อ
อ่านต่อบน Hybrid Mind
คำถามที่พบบ่อย
1. Muse Wonder กับ Muse Wonder Full ต่างกันอย่างไร?
ทั้งคู่เป็นโมเดลตระกูลเดียวกันที่ Meta เปิดตัววันเดียวกัน แต่ Full เป็นรุ่นที่แรงกว่าตามดัชนีสาธารณะ และตอนเปิดตัวใช้ได้เฉพาะผู้สมัคร Muse Code ส่วน Wonder ใช้ได้ทั้ง Meta Model API และ Muse Code
2. Meta กลับมาแข่ง frontier แล้วจริงไหม?
ยังสรุปไม่ได้จากตัวเลขเดียว Artificial Analysis แสดงว่า Full ใกล้ Opus 5.5 บนดัชนีรวม และแข็งในบางงาน agent แต่ knowledge ยังเป็นจุดอ่อนสัมพัทธ์ และรุ่นที่นักพัฒนาเรียกผ่าน API ได้คะแนนต่ำกว่า Full
3. Benchmaxxing หมายความว่าอะไรในเธรดนี้?
ในบริบทนี้ผู้ใช้หมายถึงการโชว์คะแนนของรุ่นที่เข้าถึงยาก (Full) เป็นภาพลักษณ์หลัก ในขณะที่สินค้าที่ซื้อ/เรียกผ่าน API ได้คือรุ่นที่อ่อนกว่า ไม่ได้แปลว่าคะแนนปลอม แต่แปลว่าเลขกับของที่ได้จริงอาจไม่ตรงกัน
4. ราคาเท่า Opus แปลว่าคุณภาพเท่ากันไหม?
ไม่ใช่ ราคา Wonder API ตาม AA คือ $4/$20 เท่า Opus 5.5 แต่คะแนนดัชนีของ Wonder (52) ต่ำกว่าค่าที่ผู้ใช้อ้างสำหรับ Opus (58) การคุ้มค่าต้องวัดบนงานจริง
5. Hybrid Mind ทดลอง Muse เองหรือยัง?
ยังไม่ได้ บทความนี้อ่านจาก Meta Newsroom, research blog, Artificial Analysis และโพสต์บน X ไม่ได้รัน API หรือ Muse Code
6. ควรเชื่อโพสต์ DeepSWE 79% ไหม?
ให้ดูว่าอ้างรุ่นไหน (Full หรือ Wonder) และอ้างตาราง Meta หรือ AA ถ้าเป็น Full ให้จำว่าคุณอาจยังเรียกผ่าน API ไม่ได้ในวันเปิดตัว
เอกสารอ้างอิงและขอบเขตการตรวจ
- Meta Newsroom — Introducing Muse Wonder and Muse Wonder Full (12 ต.ค. 2026)
- Meta AI Research — Muse Wonder blog
- Artificial Analysis — Muse Wonder and Muse Wonder Full article
- @AIatMeta — ประกาศเปิดตัว
- @ArtificialAnlys — สรุปคะแนน 52 / 56
- @collision — Cheeky Pint กับ Zuckerberg / Wang
- @dummerspast39 — ข้อวิจารณ์ benchmaxxing / API gap
- @AdamHoltererer — Terrible naming
- @shengjia_zhao — โพสต์จากทีม Meta
- @testingcatalog — สรุปฝั่งเชียร์ frontier
- @Joshua_WD — “The Stronger One Isn't in the API”
- VentureBeat — weaker model via API (รายงานข่าว)
ขอบเขตการตรวจ: Hybrid Mind วัดปริมาณโพสต์ด้วย X Counts API คำค้น (“Muse Wonder” OR “MuseWonder”) ช่วง 11–12 ต.ค. 2026 UTC และอ่านโพสต์หลักพร้อม public metrics ในช่วงเย็นวันที่ 12 ต.ค. ตามเวลาไทย (ราว 00:00–04:00 น. วันที่ 13) รวมประกาศทางการ บทวิเคราะห์ Artificial Analysis และตัวอย่างจากห้าค่าย ตัวอย่างเลือกตามความเกี่ยวข้องและยอดเข้าถึง ไม่ได้สุ่ม จึงไม่ได้แทนความเห็นของผู้ใช้ X ทั้งหมด และเราไม่ได้คำนวณสัดส่วนค่าย
เรายังไม่ได้ทดลอง Muse Code หรือ Meta Model API ไม่ได้รัน DeepSWE / Terminal-Bench เอง และไม่ได้เปิดทุกเซลล์ในตารางเปรียบเทียบของ Meta Lab ทั้งสามเป็นการจำลองเชิงการศึกษา บทความนี้ใช้เครื่องมือ AI ช่วยค้นคว้าและเรียบเรียง
ใส่ความเห็น