คำตอบโดยตรง: Evidence Sufficiency คือการตรวจว่าข้อมูลที่ Agent ได้รับมีข้อเท็จจริงและข้อเชื่อมเพียงพอสำหรับคำถามนั้นหรือยัง จำนวนเอกสาร ความคล้าย หรือคำตอบที่ฟังมั่นใจยังไม่รับรองความพอ ต้องระบุสิ่งที่คำถามต้องการ ตรวจว่ามีชุดหลักฐานที่เชื่อมกันครบอย่างน้อยหนึ่งทาง และระบุข้อที่ขาดเพื่อค้นต่อหรือหยุดตอบ ทั้งนี้ หลักฐานพอในบริบทไม่รับประกันว่าแหล่งข้อมูลจริงหรือโมเดลจะใช้ข้อมูลถูก
บทความมีแผนสถาปัตยกรรม Conceptual Architecture / HYPOTHESIS พร้อม Interactive สำรวจข้อเชื่อม และเกม SIMULATION ที่มีเป้าหมาย งบการค้น และ Reset ตัวจำลองใช้ข้อมูลสมมติและกฎที่กำหนดไว้ ไม่เรียก LLM หรือสร้างผล benchmark ของ AI

ทำไมค้นเจอหลายชิ้นแล้ว Agent ยังควรงดตอบ
ลองให้ Agent ช่วยผู้เข้าชมนิทรรศการตอบว่า “บัตรสีน้ำเงินไปห้องใด” เอกสารหนึ่งระบุว่าบัตรนี้ใช้เส้นทางสุริยะ อีกชิ้นบอกว่าอาคารวงโคจรนำไปห้อง A3 ทั้งสองมีคำใกล้หัวข้อ แต่ยังไม่มีข้อความเชื่อมเส้นทางสุริยะกับห้อง A3 การนำสองชิ้นมาวางติดกันไม่ได้สร้างความสัมพันธ์ที่หายไป
เอกสารเรื่องดอกไม้สีน้ำเงินหรือบัตรสีแดงและข้อความซ้ำอาจเพิ่มยอด แต่ไม่เพิ่ม premise หรือข้อเท็จจริงตั้งต้นที่จำเป็น ผู้สร้าง Agent จึงควรเปลี่ยน “ค้นเพิ่ม” เป็น “ค้นข้อเชื่อมนี้” พร้อมแจ้งข้อที่ขาดเมื่อหาไม่พบภายใต้งบ
เรื่องนี้ต่อจาก Retrieval Evaluation ซึ่งแยกผลค้น บริบท และคำตอบ แต่คำถามในบทความนี้เจาะอีกระดับ: ข้อความที่อยู่ในบริบทต่อกันเป็นเหตุผลพอสำหรับงานที่ผู้ใช้ถามหรือยัง
แยกความพอ ความจริง และความสามารถของโมเดล
ความพอในบริบทขึ้นกับคำถาม
ให้ Q เป็นคำถาม และ C เป็นบริบทที่ได้รับ การตรวจ sufficiency ถามว่ามีข้อมูลให้สร้างคำตอบตามขอบเขต Q จาก C หรือไม่ ต้องดูคู่คำถามกับบริบทเสมอ ข้อความที่พอสำหรับ “ไปห้องไหน” อาจไม่พอสำหรับ “ผ่านเส้นทางอะไรแล้วไปห้องไหน” เพราะคำถามหลังต้องการผลลัพธ์เพิ่ม
งาน Sufficient Context ตีพิมพ์ที่ ICLR 2025 นิยามความพอโดยไม่ต้องทราบคำตอบอ้างอิงล่วงหน้า และอนุญาตให้บริบทมีข้อมูลที่ผิดได้ จึงแยกการมีข้อมูลพอออกจากความจริงภายนอก ผู้วิจัยใช้ autorater และศึกษาการคัดเลือกตอบด้วยสัญญาณความพอร่วมกับความมั่นใจของโมเดล Sufficient Context
แหล่งข้อมูลจริงเป็นอีกจุดตรวจ
แผนผังชัดเจนอาจเป็นฉบับเก่าหรืออยู่นอกขอบเขต ต้องตรวจผู้รับผิดชอบ เวอร์ชัน วันที่มีผล และต้นฉบับแยกจากความครบ การผ่านกฎรับเอกสารไม่พิสูจน์ความจริงทุกด้าน ในตัวจำลอง สถานะ APPROVED/CURRENT เป็นเงื่อนไขที่ผู้เขียนกำหนดให้โจทย์ ไม่ใช่การตรวจแหล่งจริง
บริบทพอก็ยังใช้ข้อมูลผิดได้
แม้ข้อเชื่อมอยู่ครบ โมเดลอาจสลับบุคคล คำนวณผิด หรือให้เหตุผลเกินข้อความที่มี จึงต้องตรวจคำตอบหลังสร้างอีกครั้ง ผล “เพียงพอ” เป็นสิทธิ์ให้พิจารณาตอบตามนโยบาย ไม่ใช่ใบรับรองคำตอบที่ยังไม่เกิดขึ้น การอธิบายเหตุผลของโมเดลก็ไม่ยืนยันว่าโมเดลใช้ข้อมูลตามคำอธิบายจริง
คำตอบถูกที่ไม่มีหลักฐานค้นมารองรับอาจมาจากความรู้ในน้ำหนักหรือการเลือกถูก งานบังคับตรวจที่มายังต้องแสดงข้อจำกัดนี้
Scientific Foundations: หลักฐานหลายขั้นต้องเชื่อมอย่างไร
FACT เกี่ยวกับงานวิจัย: HotpotQA เป็นชุดงาน multi-hop QA ที่เก็บ supporting facts ระดับประโยค พร้อมโจทย์เชื่อมข้อมูลและเปรียบเทียบ มีการประเมินคำตอบและหลักฐานแยกกันและร่วมกัน จึงทำให้เห็นว่าคำตอบตรงเพียงอย่างเดียวยังไม่ครอบคลุมเป้าหมายด้านหลักฐาน HotpotQA, EMNLP 2018
MuSiQue สร้างคำถามหลายขั้นจากคำถามขั้นเดียว โดยมุ่งให้คำตอบของขั้นก่อนจำเป็นต่อขั้นถัดไป และมีบริบทคู่ที่ตัดข้อมูลจำเป็นออกเพื่อทดสอบการตอบไม่ได้ งานนี้ช่วยเตือนว่าต้องตรวจ dependency จริง ไม่สมมติว่าทุกโจทย์ที่เรียกว่า multi-hop บังคับโมเดลใช้ทุกขั้น MuSiQue, TACL 2022
FEVER แยก SUPPORTED, REFUTED และ NOT ENOUGH INFO ในการตรวจข้อกล่าวอ้างกับหลักฐาน Wikipedia การประเมินแบบ strict ต้องมีชุดหลักฐานที่ครบ โดยยอมรับหนึ่งชุดจากหลายทางเลือกที่ระบุไว้ NOT ENOUGH INFO จึงเป็นการขาดข้อมูลรองรับ ไม่ใช่คำตัดสินว่าเรื่องนั้นเท็จ FEVER, NAACL 2018
ANALYSIS: งานเหล่านี้มีเกณฑ์เฉพาะ บทความนำแนวคิด dependency และชุดหลักฐานมาสร้างตัวอย่างการศึกษา ไม่ใช่การรันหรือทำซ้ำ benchmark ต้นฉบับ
AND ภายในชุด OR ระหว่างทางเลือก
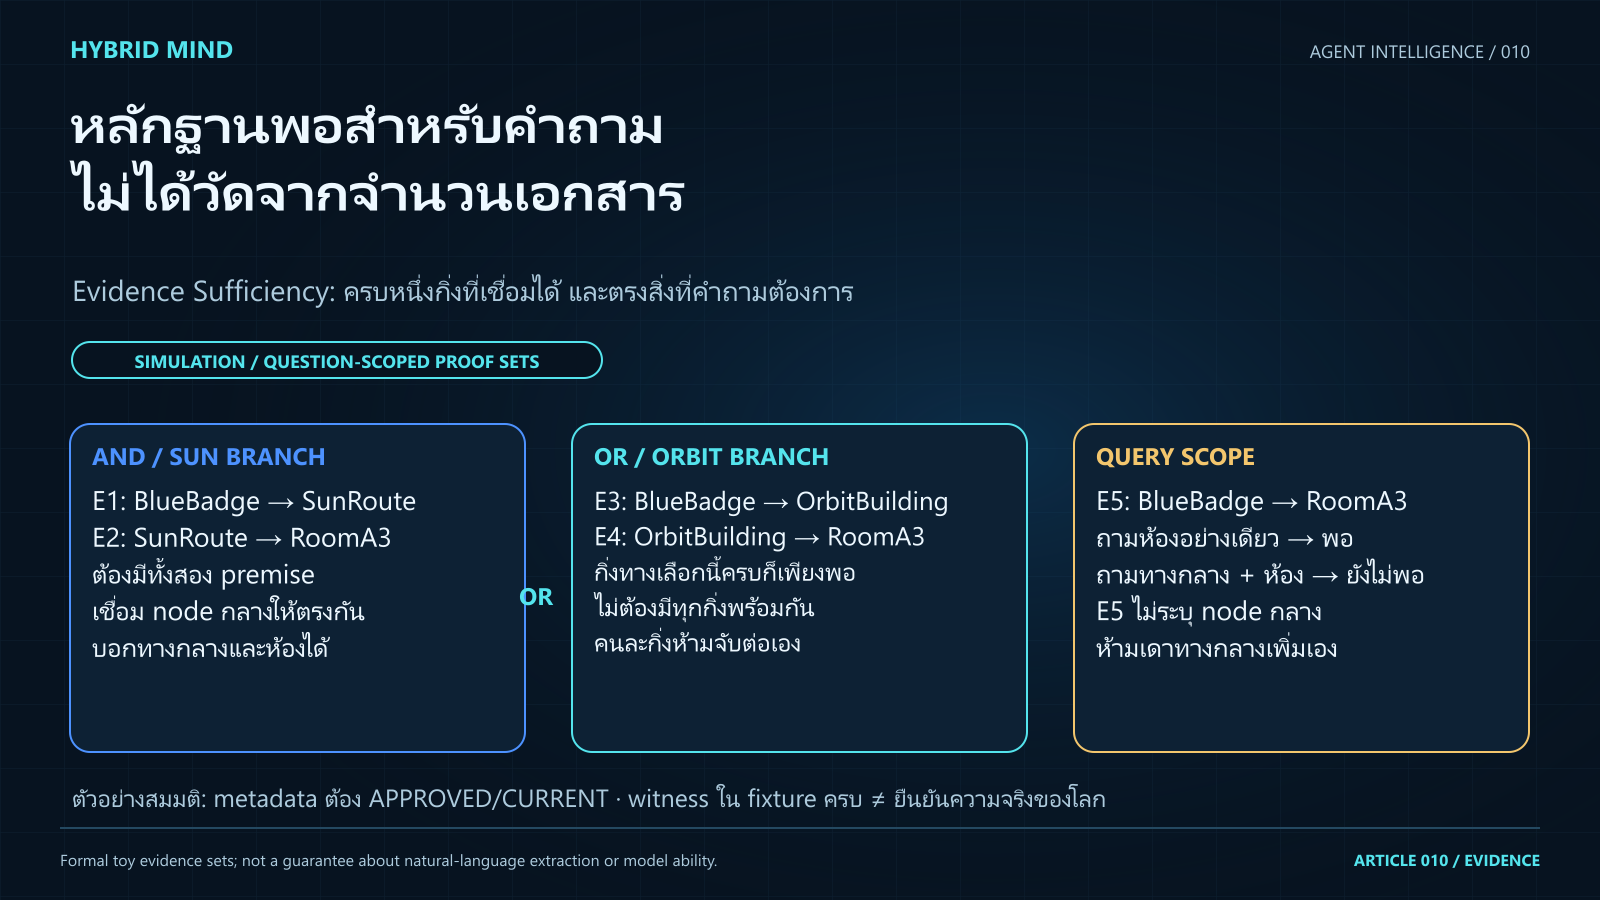
ในศูนย์นิทรรศการออโรราซึ่งเป็นข้อมูลสมมติ E1 ระบุว่าบัตรสีน้ำเงินใช้เส้นทางสุริยะ และ E2 ระบุว่าเส้นทางสุริยะนำไปห้อง A3 ต้องมี E1 และ E2 พร้อมตรวจว่าชื่อเส้นทางตรงกัน จึงเชื่อมถึงห้องได้ การมีเพียงต้นทางหรือปลายทางยังไม่ครบกิ่งนี้
อีกทางคือ E3 ระบุว่าบัตรสีน้ำเงินใช้ทางผ่านอาคารวงโคจร และ E4 ระบุว่าอาคารนั้นนำไปห้อง A3 ทางเลือกนี้ครบได้โดยไม่ต้องค้น E1 และ E2 ด้วย ส่วน E5 เป็นแผนผังที่อนุมัติซึ่งระบุตรงว่าบัตรสีน้ำเงินไปห้อง A3 แต่ไม่ได้บอกทางผ่าน
สำหรับคำถามที่ต้องการเพียงห้อง เราเขียนแบบจำลองชุดหลักฐานได้ดังนี้
P(Qห้อง) = { {E5}, {E1,E2}, {E3,E4} }
SufficientToy(Q,C) = มีชุด S ใน P(Q) ที่ทุกข้ออยู่ใน C
                    และผ่านกฎขอบเขตกับการเชื่อมที่กำหนด
Q คือคำถาม C คือ ID ของหลักฐานที่เลือก P(Q) คือรายการชุดที่ตอบโจทย์ตามกฎสมมติ S คือหนึ่งชุดในรายการ เครื่องหมาย AND อยู่ภายใน S และ OR อยู่ระหว่างชุด การมีชุดที่ครบหนึ่งชุดพอสำหรับเกณฑ์นี้ ไม่ต้องมีทุกทางพร้อมกัน
สมการนี้เป็น HYPOTHESIS / formal toy verifier สำหรับหลักฐานที่เขียนและจัดความสัมพันธ์ไว้แล้ว ไม่ใช่นิยามสมบูรณ์ของ sufficiency ในภาษาธรรมชาติ หาก mapper ไม่ทราบว่าข้อความรองรับ premise ใด หรือไม่ทราบว่ารายการชุดครบหรือไม่ ควรส่ง UNKNOWN แทนสรุปจากช่องที่ว่างว่าไม่มีทางตอบ
เมื่อเปลี่ยนคำถามเป็น “ผ่านเส้นทางหรืออาคารกลางใด และไปห้องใด” ชุด {E5} ใช้ไม่ได้ เพราะไม่มี intermediate หรือจุดกลาง เหลือ {E1,E2} และ {E3,E4} เป็นทางที่ครบ ผล sufficiency จึงเปลี่ยนได้แม้ C ไม่เปลี่ยน การเพิ่มข้อกำหนดของคำถามต้องสร้างหรือตรวจชุดหลักฐานใหม่ด้วย
Interactive: สำรวจหลักฐานที่มีและข้อเชื่อมที่ขาด
เลือก E1–E8 และเปลี่ยนโหมดคำถามเพื่อดูผลในบริบทเดียวกัน จุดเริ่มต้นมี E1 ซึ่งยังขาด E2 ให้ลองเพิ่ม E4 แทน E2: จำนวนชิ้นเพิ่ม แต่ปลาย E1 คือเส้นทางสุริยะ ส่วนต้น E4 คืออาคารวงโคจร จึงต่อกันไม่ได้ การเพิ่ม E2 หรือเพิ่ม E3 จึงเป็นคนละวิธีเติมกิ่งให้ครบ
ลอง E5 เพียงชิ้นเดียวแล้วเปลี่ยนจากถามห้องเป็นถามทางผ่านพร้อมห้อง ความพอจะหาย ปุ่มคัดลอก E1 เพิ่มรายการดิบ แต่ตัวตรวจใช้ ID ไม่ซ้ำ การคัดลอกจึงไม่เติม premise ที่ขาด
E6 พูดถึงบัตรสีแดง E7 พูดถึงดอกไม้สีน้ำเงิน และ E8 เป็นร่างผังเก่าที่ไม่ผ่าน APPROVED/CURRENT โหมดสาธิตการละเลย metadata จะแสดง candidate ที่ไม่ปลอดภัยให้เห็น แต่ไม่ยกระดับ E8 เป็นหลักฐานผ่านกฎจริงของโจทย์
ทดลอง: หลายชิ้นยังไม่เท่ากับproofที่ครบ
ศูนย์นิทรรศการออโรราเป็นข้อมูลสมมติ เลือกsourceแล้วดูว่าเชื่อมจากบัตรสีน้ำเงินไปห้องได้ครบหรือยัง ANDต้องมีpremiseทั้งกิ่ง ORยอมรับทางเลือกที่ครบเพียงหนึ่งกิ่ง
Input: เลือกformal factsและsource IDs
State: Selected records / Premises / Witnesses
กิ่งที่พิจารณาและpremiseที่ขาด
Complete applicable witnesses
กฎที่ตรวจได้และขอบเขตการสาธิต
เริ่มจากBlueBadgeด้วยassignedTo ถ้าปลายทางเป็นห้องใช้direct edgeได้เมื่อถามห้อง ถ้าผ่านroute/building ต้องjoin objectของedgeแรกกับsubjectของleadsToถัดไปให้ตรง และจบที่room ข้อเท็จจริงที่ใช้ต้องAPPROVEDและCURRENT
E1+E4ไม่ต่อกัน: SunRouteไม่ใช่OrbitBuilding สำเนาE1ไม่เติมE2 E5ไม่บอกintermediate E8เป็นDRAFT/PREVIOUS_LAYOUTจึงไม่ผ่านpolicy การเปิดignore-demoแสดงcandidateที่ผิดกติกาเท่านั้น ไม่ยกระดับร่างเป็นหลักฐานที่ใช้ตอบได้
ไม่มีwitnessในselectedcontext = INSUFFICIENT_IN_THIS_SELECTED_CONTEXT ไม่ใช่ข้ออ้างเท็จหรือค้นจากทั้งโลกไม่ได้ Source-world truthและความสามารถโมเดลจริงยังUNKNOWN แม้proofจำลองครบ
กฎนี้ตรวจgraphที่เขียนไว้ ไม่ตีความข้อความเปิดด้วยNLI ไม่จำลองretrieval/semanticentailmentทั่วไป ไม่มีmodelweightupdateหรือpersistence
อ่านผลอย่างไร: complete witness คือชุดที่ครบภายใต้กฎที่กำหนด missing premise คือข้อที่ยังขาดในแต่ละกิ่ง ส่วน rejected fact อธิบายเหตุที่ใช้ไม่ได้ ถ้าไม่มี witness ผลหมายถึง “ข้อมูลที่เลือกนี้ยังไม่พอ” ความจริงในโลกและการตอบได้จากข้อมูลนอกชุดยังเป็น UNKNOWN กด Reset เพื่อกลับสู่จุดเริ่มต้นได้
System Architecture: ออกแบบ Gate ที่ตรวจได้
แผนต่อไปนี้เป็น Conceptual Architecture / HYPOTHESIS สำหรับ application ที่มีความจำภายนอกและงานถามตอบหลายขั้น ต้องทดสอบ extraction และนโยบายของงานจริงก่อนใช้กับการตัดสินใจ ไม่มีงานต้นฉบับใดในบทความยืนยันว่าสถาปัตยกรรมรวมนี้พร้อมใช้งานทุกโดเมน

| Module | Input → Output และ State | จุดตรวจและตัวอย่าง Failure |
|---|---|---|
| TaskSpec | คำถาม ขอบเขต เวลา → required outputs, entity IDs, policy version | ถ้าผู้ใช้เพิ่มทางผ่าน แต่ยังใช้ spec ถามห้อง จะรับหลักฐานไม่ครบ |
| EvidenceStore | เอกสารหรือ memory records → source spans, ID, version, applicability | การตัดประโยคเงื่อนไขหรือใช้ร่างเก่าทำให้ record ดูครบเกินต้นฉบับ |
| PremiseMapper | TaskSpec กับ spans → relations, candidate proof sets, mapping status | ชื่อคล้ายกันไม่ได้หมายถึง entity เดียว ต้องเก็บ UNKNOWN เมื่อเชื่อมไม่ได้ |
| SufficiencyGate | proof sets กับบริบทจริง → witnesses, branch-specific gaps, rejected facts | ห้ามหยิบต้นทางจากกิ่งหนึ่งไปต่อปลายอีกกิ่งโดยไม่มี relation รองรับ |
| GapSearch | ข้อที่ขาดและแหล่งอนุญาต → targeted query, candidate records | ค้นเรื่องเดิมซ้ำโดยไม่ได้ premise ที่ขาดทำให้งบหมดโดยไม่คืบหน้า |
| BudgetController | ค่าใช้จ่ายจริง deadline และประวัติ → continue, clarify หรือ stop | จำนวนรอบต่ำไม่ได้รับรองครบ ต้องหยุดพร้อมแสดงข้อจำกัดที่เหลือ |
| Answer + Trace | witness หรือเหตุหยุด → scoped answer, source IDs, audit record | คำตอบที่เสริมข้อมูลใหม่หลัง Gate ต้องตรวจใหม่ แม้ส่วนแรกผ่านแล้ว |
ผังรวม GapSearch กับ BudgetController เป็นกลุ่มควบคุมการค้น ตารางแยกหน้าที่ ส่วน State ควรเก็บ snapshot ของคำถาม กฎ บริบท และ source mapping รอบนั้น
EvidenceStore เป็น External Memory ข้อมูลที่คัดออกมาเป็น Retrieved Context และส่วนที่ส่งให้โมเดลอยู่ภายใน Context Window การเขียน record หรือปรับ prompt ไม่ได้เปลี่ยน Model Weights ถ้าฝึก classifier หรือ fine-tune โมเดล ต้องระบุ dataset เป้าหมาย loss และการประเมินแยกจากการอัปเดตความจำ
Operational Flow: ค้นเพื่อเติมช่อง ไม่ค้นเพื่อเพิ่มยอด
ขั้นแรก ทำ TaskSpec ให้เห็น output ที่ต้องส่ง และขอให้ผู้ใช้ชี้แจงเมื่อชื่อ ขอบเขต หรือคำถามกำกวม ถ้าถามทั้งทางผ่านและห้อง ให้เก็บทั้งสองข้อ อย่าทำ specification ให้แคบลงเพียงเพื่อให้หลักฐานเดิมผ่าน
ขั้นสอง อ่านเอกสารตามสิทธิ์และ snapshot เก็บข้อความกับ metadata และตรวจบริบทหลังตัดทอน การมี document ID ใน memory ไม่รับรองว่าประโยคจำเป็นมาถึงตัวตรวจ
ขั้นสาม map premise และ entity พร้อม source spans แยกบัตรไปทางใดจากทางนำไปห้องใด คำว่า A3 เหมือนกันไม่รับรองว่า record กล่าวถึงบัตรเดียวกัน
ขั้นสี่ ตรวจ witness แต่ละทางภายใต้นโยบายของ TaskSpec ถ้ามีทางที่ครบ ให้เก็บ IDs ที่รองรับทางนั้น ถ้ามีแต่ข้อกระจัดกระจาย ให้ส่ง gaps ของแต่ละกิ่ง การคำนวณนี้ต้องไม่สร้าง relation ใหม่จากความคล้ายของคำ
ขั้นห้า เลือกช่องค้นต่อ เช่นมี E1 แล้วจึงหาปลายของเส้นทางสุริยะ ปฏิเสธข้อมูลซ้ำ เกินสิทธิ์ หรืออยู่นอกผัง พร้อมบันทึกเหตุ
ขั้นสุดท้าย หยุดตามงบหรือ deadline เมื่อยังไม่มี witness และแจ้งข้อที่ขาด ถ้ามี witness ให้สร้างคำตอบจำกัดตามข้อที่รองรับแล้วตรวจ claim/source หลังสร้าง Trace คือรายการหลักฐาน คำสั่ง และผลเครื่องมือที่เกิดขึ้น ไม่ใช่การรับรองร่องรอยความคิดภายในโมเดล

# CONCEPTUAL pseudocode — ไม่ใช่โค้ด production ที่รันทดสอบแล้ว
spec = parse_or_clarify(question, task_policy)
while budget_remaining:
    mapped = map_premises(spec, effective_context)
    if mapped.status == UNKNOWN:
        return clarify_or_escalate_with_limits(mapped)
    result = check_applicable_complete_witnesses(spec, mapped)
    if result.has_witness:
        answer = compose_scoped_answer(result.witness)
        return audit_answer_against_sources(answer, result.witness)
    if no_permitted_search_target(result.gaps):
        break
    effective_context += search_missing_premise(result.gaps)
    debit_actual_budget_and_record_trace()
return abstain_with_missing_premises_and_search_scope()
budget คือทรัพยากรที่กำหนด effective_context คือข้อมูลใช้ตรวจ mapped.status บอกความแน่ชัดของ premise mapping และ witness คือชุดที่ครบตาม spec การค้นเพิ่มเป็นข้อเสนอของบทความ ไม่ใช่ผลทดลองต้นฉบับ
Technical Comparison: ใช้อะไรตัดสินว่าพอ
| วิธี | สิ่งที่ตรวจได้ | ต้นทุนและข้อจำกัด |
|---|---|---|
| จำนวนชิ้น / Similarity heuristic | ปริมาณและความใกล้หัวข้อ ใช้กรอง candidate เบื้องต้น | ทำง่าย แต่ข้อความซ้ำ คนละ entity และกิ่งที่ขาดข้อเชื่อมยังมีคะแนนสูงได้ |
| Formal Toy Verifier | relation และชุดทางเลือกที่กำหนดชัด ตรวจ join และ metadata ซ้ำได้ | รับรองเฉพาะกฎ/fixture; การแปลงภาษาธรรมชาติและความครบของ proof sets ต้องตรวจแยก |
| Sufficiency LLM Judge + policy งดตอบ | ประเมิน Q กับ C เชิงภาษาและใช้สัญญาณคัดเลือกตอบ | มีค่า model calls และความผิดพลาดของผู้ตรวจ ต้องปรับเกณฑ์ด้วยงานจริง ไม่รับรองโลกภายนอก |

ตารางเป็น ANALYSIS ไม่ใช่ benchmark จัดอันดับของเรา Verifier ตรวจถูกตามกฎได้แต่ premise อาจ map ผิด ส่วน label ของ LLM judge เป็นผลประเมิน ไม่ใช่ข้อพิสูจน์ที่ตรวจครบ
วิธี selective RAG ใน Sufficient Context ฝึกตัวคัดเลือกภายนอกแบบ logistic regression จากสัญญาณ autorater กับ self-rated confidence จึงต้องมีข้อมูลตรวจและเกณฑ์ของโดเมน ไม่ควรสรุปว่าให้โมเดลตอบ “มั่นใจหรือไม่” ครั้งเดียวแล้วได้ความสามารถแบบงานนั้น วิธี selective RAG §5.1
เกมจำลอง: ใช้งบเพื่อสร้างชุดหลักฐานที่ตอบได้
เกมใช้ข้อมูลออโรราชุดเดียวกับ Interactive มีสามโจทย์: เริ่มจาก E1 ที่ขาดข้อเชื่อม เริ่มจาก E1+E4 ที่มาจากคนละกิ่ง และเริ่มจาก E5 เมื่อคำถามเปลี่ยนเป็นต้องการทางผ่านกับห้อง ข้อมูลตั้งต้นให้ฟรี แต่การค้นใหม่ใช้หน่วย action ตามที่กำหนด
คุณมีงบ 6 หน่วย ค้น E1–E4 และ E6–E8 ใช้ชิ้นละ 1 หน่วย ค้น E5 ใช้ 3 หน่วย ส่วนการคัดลอก E1 ใช้ 1 หน่วย ตัวเลขนี้เป็นต้นทุนสมมติของเกม ไม่ใช่ tokens เวลา ราคา API หรือสัดส่วนค่าใช้จ่ายจริง
เกม: เติมกิ่งให้ครบ แล้วตอบด้วยwitnessเดียวกัน
งบ6หน่วยสำหรับfetchหรือสำเนา เลือกหลักฐานที่ขาดให้ต่อกันจริง จากนั้นเลือกproofsetและคำตอบ เป้าหมายไม่ใช่สะสมrecordให้มาก แต่ให้proofตรงคำถามและmetadata
FetchE1–E4/E6–E8ครั้งละ1หน่วย E5ครั้งละ3หน่วย สำเนาE1ครั้งละ1หน่วย Seedเริ่มต้นให้ฟรี ทั้งหมดเป็นต้นทุนสมมติ ไม่ใช่tokenเงินจริงหรือlatency
Input: Fetchหลักฐานที่ต้องการ
State: สิ่งที่มี / สิ่งที่ขาด
Missing premises
Applicable witnesses
Output: เลือกproofและคำตอบ
กติกาและร่องรอยการกระทำ
ชนะเมื่อsourceIDsของproofที่เลือกยังอยู่ครบในcontext ต่อedgeตรงกัน ผ่านAPPROVED/CURRENT ใช้ได้กับคำถาม และค่าห้อง/intermediateตรงกับwitnessเดียวกัน E8ไม่ได้ถูกเลื่อนเป็นหลักฐานที่รับรองได้แม้fetchมา E1+E4ไม่ต่อกัน สำเนาไม่เพิ่มpremise และE5ไม่บอกintermediate
เกมตรวจformalfixture ไม่พิสูจน์ความจริงนอกข้อมูลหรือความสามารถLLMจริง ไม่มีwitnessในcontextไม่ได้หมายความว่าคำตอบทั่วโลกไม่มี Stateอยู่เฉพาะหน้าเว็บและไม่ฝึกน้ำหนัก
เป้าหมาย: เลือก proof set ที่ใช้ได้และตอบห้อง A3 ภายในงบ ถ้าโจทย์ถามจุดกลางด้วย ต้องตอบเส้นทางสุริยะหรืออาคารวงโคจรให้ตรงกับ witness เดียวกัน การเดาห้องถูก เลือก E1+E4 หรืออ้างร่าง E8 ยังไม่ชนะ กดตรวจคำตอบเพื่อจบรอบ แล้ว Reset เพื่อเริ่มใหม่ เมื่องบหมดจะค้นเพิ่มไม่ได้ แต่ยังส่งคำตอบและรีเซ็ตได้
ตัวอย่างกลยุทธ์สำหรับโจทย์แรกคือค้น E2 เพื่อเติมกิ่งสุริยะ สำหรับโจทย์กิ่งปะปน ให้เติม E2 หรือ E3 ให้ครบกิ่งใดกิ่งหนึ่ง ส่วนโจทย์ที่เพิ่มทางผ่านต้องค้นกิ่งสองขั้น ไม่อาศัย E5 เพียงชิ้นเดียว ผลชนะยืนยันเฉพาะกฎสมมติ ไม่วัดว่า LLM จริงคิดหรือค้นได้ดีขึ้น
Applications และการประเมินที่ใช้กับงานจริง
ฐานความรู้ภายในอาจใช้ premise map แยกสถานที่กับวิธีเข้าถึง งานตรวจข้อกล่าวอ้างใช้ evidence groups ตามแนว FEVER และงานหลายขั้นทดสอบตัดข้อเชื่อมแบบ MuSiQue นี่เป็นการประยุกต์ที่เสนอ ไม่อ้างผลิตภัณฑ์ติดตั้งแล้ว
เมื่อนำไปเชื่อมความจำ Agent ให้เก็บข้อมูลต้นทางไว้ การย่อ record อาจเก็บปลายทางแต่ทำข้อเชื่อมหาย ควรตรวจข้อกำหนดคำถามกับ summary อีกครั้ง ดู Memory Consolidation เพื่อแยกการย่อความจำออกจากการฝึกน้ำหนัก
ต้องแยกหลักฐานพอให้ตอบจากข้อจำกัดที่อนุญาตให้ทำ การรู้เส้นทางไม่อนุญาตทุก action ดูจุดตรวจแผนใน Constraint-aware Planning
ชุดทดสอบ sufficiency ควรมีทั้งกิ่งครบ กิ่งขาดหนึ่งข้อ ทางเลือกที่ครบคนละชุด ข้อมูลซ้ำ ชื่อคล้าย relation ผิด และกรณีเปลี่ยนคำถามโดยคง C เดิม ให้ผู้ตรวจระบุว่าขาดข้อใด ไม่วัดแค่จำนวนครั้งที่ตอบ “พอ” เพราะตัวตรวจที่ยอมทุกครั้งหรือปฏิเสธทุกครั้งอาจดูดีบนข้อมูลด้านเดียว
การงดตอบต้องดูผลควบคู่กับสัดส่วนคำถามที่ระบบตอบ งาน Selective Question Answering under Domain Shift แยกการตอบไม่ได้จากบริบทออกจากการคัดเลือกงดตอบเมื่อโมเดลอาจผิด และศึกษาข้อจำกัดของ confidence เมื่อโดเมนเปลี่ยน Selective QA, ACL 2020
รายงานความถูกต้องเฉพาะที่ตอบควบคู่จำนวนที่ตอบและทั้งหมด ถ้าไม่ตอบเลยให้เป็น N/A ไม่ใช่เต็มคะแนน เก็บทั้งการงดตอบเมื่อหลักฐานครบและการตอบเมื่อยังขาด เลือกเกณฑ์ตามผลเสียของงาน
Limitations และ Failure Modes
Premise ที่ตกหล่น: mapper อาจไม่เก็บคำว่า “เฉพาะวันเสาร์” หรือ “เมื่อได้รับอนุมัติ” ทำให้ proof set ดูครบโดยเงื่อนไขไม่ครบ ต้องรักษา source spans และให้ตรวจ mapping ย้อนกลับได้
Entity ที่รวมผิด: ชื่อคล้ายไม่ยืนยัน entity เดียว ต้องมี ID หรือหลักฐานเชื่อม มิฉะนั้นคงความกำกวม
หลักฐานขัดกัน: fixture นี้มีร่างเก่าที่ตัดด้วยกฎชัด จึงไม่ได้จำลองเอกสารอนุมัติสองฉบับที่ขัดกัน ระบบจริงต้องแสดง conflict และตรวจอำนาจ/ขอบเขต ไม่เลือกข้อความใดเพียงเพราะอยู่ท้าย prompt
ชุดทางเลือกไม่ครบ: รายการ P(Q) อาจพลาดหลักฐานที่ใช้ได้จริง ผู้ตรวจไม่พบ witness จึงไม่พิสูจน์ว่าไม่มีหลักฐานอยู่ที่อื่น รวมถึง annotation ของ benchmark ที่อาจไม่ระบุทุกชุด
งบหมด: การหยุดค้นในขอบเขตไม่พิสูจน์ความไม่มีทั่วโลก ให้บอกแหล่งที่อ่านและข้อที่ขาด
ความมั่นใจที่ย้ายโดเมนไม่ได้: threshold ที่พัฒนากับข้อความสั้นอาจใช้ไม่ได้กับข้อกำหนดยาวหรือข้อมูลอีกภาษา ต้องตรวจข้อมูลใหม่ แยก label ของผู้ตรวจออกจากความจริงที่ผ่านการยืนยันแล้ว
Future Directions และ Practical Takeaways
แนวทางที่ยังต้องทดสอบคือให้ mapper คืน premise พร้อม uncertainty และ source spans แล้วใช้ผู้ตรวจอิสระตรวจ relation ก่อนสร้าง witness รวมถึงค้นกิ่งทางเลือกตามต้นทุนจริงและทบทวนเมื่อ TaskSpec เปลี่ยน นี่เป็น HYPOTHESIS ไม่ใช่ architecture ที่พิสูจน์ว่าเหนือกว่าระบบอื่นแล้ว

เริ่มจากงานที่ขอบเขตชัดและตรวจด้วยมนุษย์ได้ เก็บ TaskSpec, บริบทที่ใช้จริง และ witness อย่างน้อยหนึ่งทาง ทำกรณีทดสอบตัดข้อเชื่อมแล้วดูว่า Gate แจ้งส่วนที่ขาดถูกหรือไม่ เมื่อเอากลับต้องผ่านได้โดยไม่บังคับให้ค้นทุกทางเลือก
หลักใช้งานคือ AND ให้ครบภายในกิ่ง OR ให้มีทางเลือกที่ครบอย่างน้อยหนึ่งกิ่ง และขอบเขตให้ตรงคำถาม การตอบเพียงบางส่วนทำได้เมื่อระบุส่วนที่ยืนยันกับส่วนที่ยัง UNKNOWN ชัดเจน ถ้าไม่มีหลักฐานครบ ให้หยุดพร้อมเหตุผลที่ตรวจได้แทนเติม relation เอง
FAQ
Evidence Sufficiency คืออะไร?
คือการตรวจว่าบริบทมีข้อมูลและข้อเชื่อมพอสำหรับคำถามที่กำหนด ไม่ใช้จำนวนเอกสารหรือความคล้ายแทนความครบ
มีหลักฐานพอแปลว่าคำตอบจริงแน่นอนหรือไม่?
ไม่ ต้องตรวจความจริงของแหล่งและคำตอบแยก บริบทอาจมีข้อมูลผิด และโมเดลอาจใช้ข้อมูลครบแต่ผิดได้
ต้องค้นทุกชุดหลักฐานทางเลือกหรือไม่?
ในเกณฑ์ตัวอย่าง มีหนึ่งชุดที่ครบและใช้ได้ก็พอสำหรับคำถามนั้น แต่ทุกข้อภายในชุดต้องต่อกันและผ่านขอบเขต
ไม่มี witness แปลว่าข้อกล่าวอ้างเท็จหรือไม่?
ไม่ หมายถึงยังไม่พบชุดที่ครบในบริบทและกฎที่ตรวจ อาจมีหลักฐานอยู่นอกชุด NOT ENOUGH INFO ไม่ใช่ REFUTED
LLM Judge แทน Formal Verifier ได้ทันทีหรือไม่?
เป็นผู้ประเมินข้อความเชิงภาษา ส่วน verifier ตรวจกฎที่ map ไว้ ทั้งสองมีข้อผิดพลาดคนละแบบ ต้องตรวจ mapping และเกณฑ์กับงานจริง
Interactive กับเกมฝึก AI หรือรัน benchmark หรือไม่?
เป็น JavaScript SIMULATION ของ fixture ออโรรา ไม่เรียก LLM ไม่อัปเดตน้ำหนัก และไม่รัน benchmark ต้นฉบับ ผลชนะใช้เฉพาะกฎเกม
References และขอบเขตหลักฐาน
- Sufficient Context, ICLR 2025 — อ่านนิยาม autorater selective generation และข้อจำกัด พร้อม arXiv v3, 23 เมษายน 2025 และ repo ผู้วิจัย
- HotpotQA, EMNLP 2018 — อ่านการสร้างโจทย์ supporting facts และเกณฑ์ประเมิน; มี ข้อมูลและโค้ดทางการ
- MuSiQue, TACL 2022 — อ่าน connected reasoning และคู่ answerable/unanswerable; repo ผู้วิจัย
- FEVER, NAACL 2018 — อ่าน labels และ complete evidence groups พร้อม scorer source
- Selective Question Answering under Domain Shift, ACL 2020 — อ่านความต่าง answerability/selective prediction วิธี calibrator และ risk/coverage
สถานะหลักฐาน: FACT ระบุวิธีและเกณฑ์ที่ต้นฉบับบันทึก REPORTED CLAIM จำกัดผลทดลองไว้กับโมเดล/ข้อมูลที่ผู้วิจัยศึกษา ANALYSIS คือการตีความเพื่อออกแบบงาน HYPOTHESIS คือแผน application และ verifier ที่เสนอ SIMULATION คือ Interactive/เกมข้อมูลสมมติ ไม่มีผลทำซ้ำ benchmark หรือผลทดสอบ LLM อิสระของ HYBRID MIND ในบทความนี้
โค้ดและรุ่น: มี repo/prompts ของ Sufficient Context, baseline/evaluator ของ HotpotQA, MuSiQue และ FEVER scorer แต่ไม่ได้ติดตั้งหรือรันทำซ้ำ MuSiQue ระบุชุด dependency ยุคงาน เช่น AllenNLP 2.1.0/Transformers 4.7.0 ซึ่งไม่เท่ากับแพ็กเกจปัจจุบัน ส่วน repo ผู้วิจัยของ Selective QA ยัง UNKNOWN ในการตรวจนี้
ใส่ความเห็น