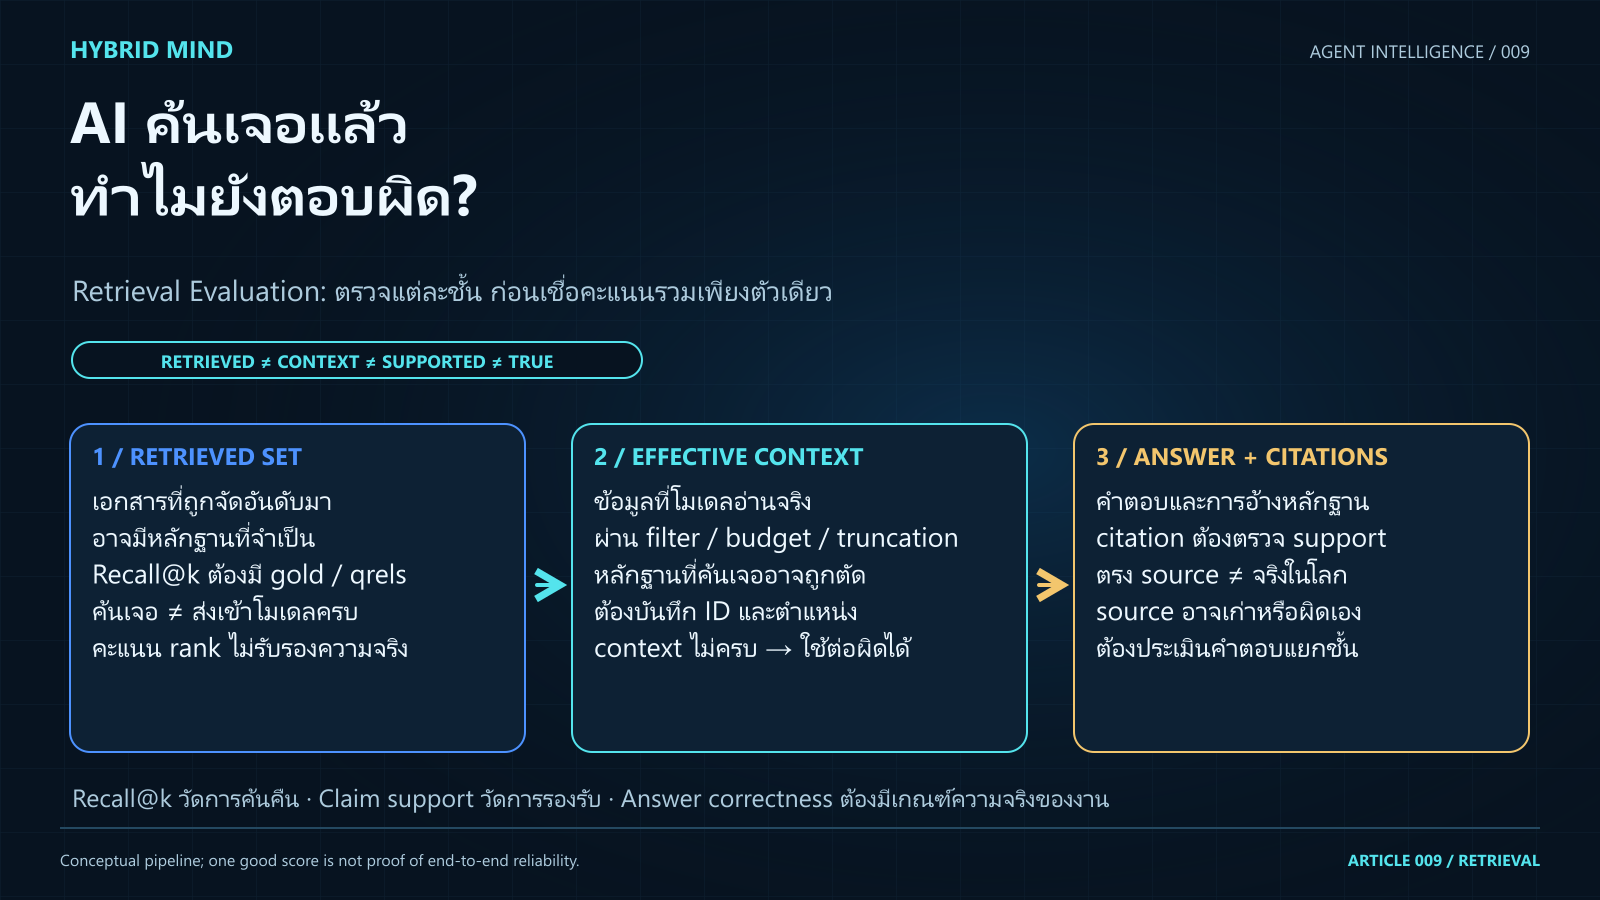
คำตอบโดยตรง: การค้นพบเอกสารที่เกี่ยวข้องยังไม่รับรองว่า AI Agent จะได้รับข้อความสำคัญครบ ใช้ข้อความนั้นถูก หรือตอบพร้อมหลักฐานที่รองรับ ต้องประเมินแยกอย่างน้อยสามจุด: ชุดที่ retriever ค้นได้ บริบทที่ส่งให้โมเดลจริง และข้อกล่าวอ้างในคำตอบ จากนั้นแยกความถูกต้องตามคำตอบอ้างอิงออกจากความสอดคล้องกับหลักฐาน คะแนนเหล่านี้ช่วยระบุตำแหน่งที่ควรตรวจ แต่ไม่พิสูจน์สาเหตุของความผิดพลาดทั้งหมดด้วยตัวเอง
บทความเปรียบเทียบ gold labels, reference-free judge และผู้ตรวจที่ฝึกพร้อมข้อมูลมนุษย์ มี Interactive และเกม SIMULATION แสดง Input, State และ Output แต่ไม่เรียก LLM หรือสร้างผล benchmark ของ AI

ทำไมคำตอบผิดไม่บอกทันทีว่าต้องเปลี่ยน Retriever
เมื่อ Agent ตอบผิด ข้อมูลอาจค้นได้แล้วแต่ถูกตัดตอนจัดบริบท หรืออยู่ครบแต่คำตอบดึงตัวเลขจากคนละหัวข้อและอ้างผิดแหล่ง การเพิ่มเอกสารหรือเปลี่ยน embedding จึงอาจไม่แก้ปัญหาในขั้นใช้ข้อมูล
คำตอบที่ถูกอาจมาจากความรู้เดิมหรือการเดาโดยไม่มีหลักฐานที่ค้นมารองรับ หากงานต้องตรวจที่มา คำตอบนั้นยังไม่ผ่าน การดูผลลัพธ์สุดท้ายอย่างเดียวจึงซ่อนข้อผิดพลาดของกระบวนการ
ความจำภายนอกของ Agent อาจมีเหตุการณ์เก่า ข้อเสนอและเงื่อนไขหลายแหล่ง ต้องบันทึกว่ารอบตัดสินใจอ่านอะไร และแต่ละข้อกล่าวอ้างสัมพันธ์กับหลักฐานใด ไม่ใช้เพียงคำบรรยายว่า “ค้นความจำแล้ว”
แยกชุดข้อมูลสามชั้นก่อนนับคะแนน
Corpus และ Gold Labels: อะไรควรค้นพบตามเกณฑ์ของงาน
Corpus คือชุดเอกสารที่ให้ค้น ส่วน gold relevance labels หรือ qrels ระบุความเกี่ยวข้องระหว่างคำถามกับเอกสาร ต้องกำหนด snapshot, query/document ID และเกณฑ์ relevance; ชื่อไฟล์ที่ดูเกี่ยวข้องไม่รับรองเนื้อหา
Gold labels ยังมีขอบเขต ผู้ประเมินอาจไม่เคยอ่านเอกสารที่ retriever ใหม่ค้นพบ เอกสารที่ไม่มี label จึงไม่ควรถูกอธิบายว่า “ไม่เกี่ยวข้องแน่นอน” งาน BEIR ศึกษา retrieval หลายโดเมนและวิเคราะห์ผลของ annotation selection bias รวมถึงรายการที่ยังไม่ถูกตัดสิน ข้อนี้ทำให้ต้องแยก known non-relevant ออกจาก unjudged BEIR
Retrieved Set: อะไรอยู่ในรายการผลค้น
Retrieved set คือ document IDs เรียงอันดับพร้อมคะแนน/เวอร์ชัน index ให้เก็บก่อนตัดทอนเป็น prompt เพื่อตรวจว่าเอกสารสำคัญมาถึงหรือยัง คะแนนความคล้ายไม่ใช่โอกาสที่ข้อกล่าวอ้างจริง หรือคะแนนที่เทียบข้ามโมเดลได้ทันที
Effective Context: โมเดลได้รับข้อความใดจริง
หลังค้นอาจกรองสิทธิ์ ลบซ้ำ rerank หรือตัด chunk ให้พอดีงบ จึงต้องเก็บ effective context ที่ส่งจริง การมี ID ในผลค้นไม่รับรองว่าประโยคสำคัญยังอยู่; บันทึก span/source mapping ของช่วงที่ใช้ด้วย
การที่ข้อมูลอยู่ในบริบทก็ยังไม่รับรองการใช้ข้อมูลถูก งาน Lost in the Middle ใน TACL 2024 พบความไวต่อตำแหน่งข้อมูลในการทดลอง QA และ key–value ภายใต้โมเดลที่ศึกษา จึงเป็นเหตุผลให้ตรวจขั้นใช้ข้อมูลต่อจากขั้นค้น ไม่ใช่ข้อสรุปว่าทุกโมเดลปัจจุบันผิดแบบเดียวกัน Lost in the Middle
Retrieval Recall กับคุณภาพคำตอบเป็นคนละคำถาม
หากมี gold relevant set ที่กำหนดครบ สามารถนิยาม Recall@k เป็นสัดส่วนเอกสารเกี่ยวข้องที่ปรากฏในผลค้นอันดับแรก k รายการ ให้ G เป็นชุดเอกสารเกี่ยวข้อง และ Rk เป็นชุด ID ที่ไม่ซ้ำของผลค้นเหล่านั้น
Recall@k = จำนวน ID ใน Rk ที่อยู่ใน G / จำนวน ID ทั้งหมดใน G
Precision@k = จำนวน ID ที่เกี่ยวข้องในผลอันดับแรก k / k
Recall วัดว่าค้นของที่ควรเจอครบเพียงใด ส่วน precision วัดสัดส่วนผลเกี่ยวข้อง ต้องระบุการนับเมื่อได้ผลน้อยกว่า k และวิธีเฉลี่ยต่อ query ไม่ใช้ similarity เป็น label หรือรวม ID ซ้ำให้เพิ่มคะแนน
เมื่อ G ว่างให้ recall เป็น NA ไม่บังคับเป็นศูนย์หรือหนึ่ง หาก labels ไม่ครบต้องรายงานข้อจำกัดหรือ UNKNOWN; precision ก็ต้องบอกวิธีจัดการเอกสาร unjudged
Recall@k ไม่รับรองหลักฐานเพียงพอตอบ บางเอกสารใช้แทนกันได้ บางงานต้องมีหลายข้อความร่วมกัน จึงนิยาม evidence sufficiency แยกจากความครอบคลุมของเอกสาร ไม่เปลี่ยน recall เป็นคะแนน reasoning
แยก Correctness, Faithfulness และ Citation Support
Answer Correctness ตรวจคำตอบกับ reference answer หรือเกณฑ์ตัดสินงานที่เตรียมแยกไว้ ความถูกต้องขึ้นกับคุณภาพของ reference เช่น เวลาที่ถาม ขอบเขตผู้ใช้ และข้อยกเว้น การตรงกับข้อความเก่าใน corpus ไม่ได้ทำให้ตรงกับคำตอบปัจจุบันเสมอ
Answer Faithfulness ตรวจว่าข้อกล่าวอ้างอนุมานได้จาก effective context หรือไม่ จึงเป็นความสอดคล้องกับข้อมูลที่ให้ ไม่ใช่การตรวจความจริงภายนอกทั้งหมด หากบริบทมีข้อมูลผิด คำตอบที่ตามบริบทอาจ faithful แต่ไม่ถูกตาม reference อีกด้านหนึ่งคำตอบอาจตรง reference แต่เพิ่มข้อกล่าวอ้างที่ไม่มีหลักฐาน
Citation Support ตรวจว่าประโยคที่ผูกกับ citation ได้รับการรองรับจากแหล่งที่อ้างจริงหรือไม่ ไม่ใช่ตรวจว่ามีวงเล็บลิงก์ครบเท่านั้น การมีข้อมูลถูกอยู่ที่อื่นใน context ไม่ช่วยให้ citation ที่ชี้ผิดแหล่งกลายเป็นถูก ต้องแยกความถูกของคำตอบกับความถูกของการอ้างหลักฐาน
งาน ALCE ที่ EMNLP 2023 แยก correctness และ citation quality โดยใช้ NLI ประเมินการรองรับข้อความพร้อมเปรียบเทียบกับการตัดสินของมนุษย์ citation recall วัดสัดส่วนข้อความคำตอบที่มี citations รองรับตามเกณฑ์ของงาน ข้อความที่ไม่มี citation อาจไม่ผ่าน ไม่ใช่ document Recall@k ของ retriever ผู้ตรวจ NLI ยังผิดได้และมีข้อจำกัดเรื่อง partial support ALCE
ดู Answer Coverage ควบคู่: ตอบกี่ข้อจากงานที่ต้องตอบ การงดตอบเมื่อหลักฐานไม่พอมีประโยชน์ แต่ไม่ควรได้เต็มเมื่อไม่ตอบทุกข้อ หากไม่มีคำตอบ/claims ให้คะแนนที่ต้องใช้คำตอบเป็น NA และแสดง coverage ศูนย์
งานวิจัยเสนอผู้ตรวจอัตโนมัติแบบใด
RAGAS — แยกมิติด้วยผู้ตรวจแบบ reference-free: งาน EACL 2024 System Demonstrations ประเมิน faithfulness, answer relevance และ context relevance โดยใช้โมเดลช่วยตรวจ ตัวอย่าง faithfulness แยกคำตอบเป็น statements แล้วตรวจการอนุมานจากบริบท ส่วน answer relevance ไม่ใช่การวัด factual correctness โดยตรง แนวทางนี้ช่วยเริ่มประเมินเมื่อไม่มี reference answer ครบ แต่ไม่ได้ทำให้ judge ปราศจากความผิดพลาด RAGAS
ARES — ฝึก Judge และใช้ข้อมูลมนุษย์ช่วยประเมินระดับระบบ: งาน NAACL 2024 ใช้ synthetic query–passage–answer triples ฝึกผู้ตรวจ แล้วใช้ human-annotated validation set ร่วมกับ prediction-powered inference หรือ PPI เพื่อประมาณคะแนนและช่วงความเชื่อมั่น ข้อมูลมนุษย์เป็นส่วนของวิธี ไม่ใช่ระบบที่ตัด human labels ออกทั้งหมด ผลบนโดเมนที่ทดลองไม่รับรองความแม่นยำในภาษาไทยหรือโจทย์ใหม่โดยอัตโนมัติ ARES
ต้องแยกการฝึกน้ำหนักของ evaluator ใน ARES ออกจากการเขียนความจำของ Agent ที่ถูกประเมิน การรัน evaluation หรือบันทึกข้อผิดพลาดไม่ได้หมายความว่า Agent ฝึกตัวเอง หากนำ feedback ไปปรับ prompt, index, memory หรือ model weights ต้องรายงานการเปลี่ยนแต่ละชั้นพร้อมกลไกและการทดสอบแยก
สถาปัตยกรรมสำหรับตรวจร่องรอยของ Agent
สถาปัตยกรรมต่อไปเป็น Conceptual Architecture / HYPOTHESIS สำหรับประกอบเครื่องมือประเมิน ไม่ใช่ผังถอดจาก RAGAS, ARES หรือทุกระบบ RAG ภาพรวมจัด Retrieval Evaluator กับ Trace Reporter ไว้ในกล่อง Evaluator + Trace ส่วนตารางแยกเป็นหน้าที่เพื่อให้ตรวจแต่ละจุดได้

| Module | Input → Output และหน้าที่ | State/จุดตรวจ | Failure Mode |
|---|---|---|---|
| Dataset & Reference Manager | corpus กับ queries → snapshot และ labels/reference | query_id, doc_id, version, judged/unjudged; ตรวจสิทธิ์และนิยาม gold | gold ไม่ครบ reference เก่า หรือ test รั่วไปชุดปรับระบบ |
| Retriever | query กับ index → ranked IDs/scores | index_version, filters, rank; อ่านผลดิบก่อน packing | ค้นคนละหัวข้อ กรองหลักฐานออก หรือ index ไม่มีข้อมูล |
| Context Assembler | ranked results กับ budget → effective text/spans | retained_ids, dropped_ids, spans, order; ตรวจข้อความที่ส่งจริง | ผลค้นมีข้อมูลแต่ context ตัดประโยคสำคัญ |
| Answer Generator | query กับ effective context → answer/citations | model/prompt version, output, cited_ids | ตอบคนละ field เพิ่มข้อความไม่มีหลักฐาน หรืออ้างผิดแหล่ง |
| Retrieval Evaluator | results กับ relevance labels → coverage/rank metrics | metric definition, G, k, unjudged; ตรวจตัวหารและหน่วยประเมิน | ให้ label ไม่ทราบเป็นไม่เกี่ยวข้อง หรือปน document/claim recall |
| Answer Evaluator | answer/context/reference → correctness/support/coverage | claims, source spans, verdict, judge version; ตรวจมนุษย์ในตัวอย่างสำคัญ | judge เชื่อ source ผิด ให้คะแนนการงดตอบเต็ม หรือไม่เห็น qualifier |
| Trace Reporter | metrics และ run metadata → รายงานแยกขั้น | run_id, configs, flags, uncertainty; อ่านซ้ำได้ | รวมทุกคะแนนจนซ่อน tradeoff หรืออ้างสาเหตุเกิน trace |
แยก retrieved, retained และ cited IDs; Agent หลายรอบเก็บ parent run/tool calls ด้วย นี่คือร่องรอยการดำเนินการที่ตรวจได้ ไม่ใช่คำบรรยาย reasoning ที่โมเดลสร้างเอง
Operational Flow: ตรวจแต่ละจุดก่อนสรุปว่าพลาดตรงไหน
- กำหนด queries, corpus snapshot, gold relevance และ answer criteria แยกจากข้อมูลที่ใช้ปรับระบบ
- รัน retriever และเก็บผลเรียงอันดับพร้อม ID/เวอร์ชัน โดยยังไม่เขียนทับด้วยผลหลังกรอง
- จัดบริบทแล้วบันทึกข้อความจริง ส่วนที่ตัดออก และ source mapping ของข้อความที่ยังอยู่
- สร้างคำตอบและเก็บ citations หรือการงดตอบตามสัญญาที่ระบบกำหนด
- ประเมิน retrieval/context coverage และประเมินคำตอบตาม correctness, support และ coverage แยกกัน
- ตรวจตัวอย่างที่ไม่ผ่าน พร้อมรายงาน unknowns และ flags หลายประเภทได้ ไม่บังคับทุกกรณีให้เหลือสาเหตุเดียว
- หากแก้ระบบ ให้เปลี่ยนสิ่งที่ระบุได้แล้วทดลองซ้ำบนชุดทดสอบที่ไม่ใช้ปรับ โดยเก็บเงื่อนไขเปรียบเทียบให้เท่ากัน

ตัวอย่างต่อไปเป็น pseudocode เชิงแนวคิด ไม่ใช่โค้ด production ที่ทดสอบแล้ว โค้ดของ Interactive เป็น simulator แยกอีกชุดหนึ่ง
ranked = retrieve(query, corpus_snapshot, config)
context = assemble(ranked, policy, budget)
output = generate(query, context.text, prompt_version)
retrieval_report = evaluate_relevance(ranked, context, judged_labels)
answer_report = evaluate_answer(output, context, independent_reference)
save_trace(ranked, context, output, retrieval_report, answer_report)
Retrieval miss กับ unsupported generation เกิดร่วมกันได้ การเพิ่ม oracle evidence เพื่อทดสอบใหม่ยังต้องควบคุมบริบท token ลำดับข้อมูล prompt และความสุ่ม คะแนนเดียวไม่รับรอง causal attribution ของ LLM
เปรียบเทียบสามแนวทางประเมินอย่างเป็นธรรม

| แนวทาง | จุดแข็ง | สิ่งที่ต้องเตรียม/ข้อจำกัด | สิ่งที่ยังไม่รับรอง |
|---|---|---|---|
| Manual Gold & Human Review | เห็น qualifier และข้อผิดพลาดเฉพาะโดเมน; มีเกณฑ์อ้างอิงชัด | ใช้แรงงาน มี disagreement และ annotation bias; ต้องจัดการ unjudged | มนุษย์ถูกทุกกรณีหรือ gold ครบทั้ง corpus |
| Reference-free Judge เช่น RAGAS ในงานปี 2024 | เริ่มแยกคุณภาพ context/answer ได้เมื่อไม่มี reference answers ครบ | ต้องตรวจ suitability และความผิดพลาดของ judge; prompt/model รุ่นต่างกันให้ผลต่าง | คะแนนสูงเท่ากับข้อเท็จจริงภายนอกหรือ answer completeness |
| Trained Judge + PPI Estimates เช่น ARES | ฝึก judge และใช้ human validation/PPI ประมาณคะแนนระดับระบบ | ต้องมีข้อมูล/การฝึกและ sample มนุษย์; domain/language shift ต้องทดสอบ | ช่วงความเชื่อมั่นรับรองคำตอบรายข้อหรือใช้ได้กับทุกภาษา |
ไม่มีวิธีชนะทุกงาน เปรียบเทียบภายใต้ query/corpus/label policy รุ่นโมเดล วิธีเฉลี่ยและต้นทุนที่เปิดเผย ไม่จัดอันดับจาก judge หรือ gold คนละชุดโดยไม่บอกเงื่อนไข
อธิบาย paper รุ่นที่อ้าง ไม่รับรองแพ็กเกจปัจจุบัน และไม่ได้ทำซ้ำ benchmark หรือสร้างตัวเลขประสิทธิภาพใหม่
Interactive: ผลค้นครบ แต่ข้อความอาจยังมาไม่ครบ
Lab เป็น SIMULATION ของ “พิพิธภัณฑ์โคจร” ที่ผู้เขียนกำหนดขึ้น D1 ระบุว่านิทรรศการเปิดวันเสาร์ 10:00 น. D2 ระบุราคานักเรียน 50 บาทเมื่อแสดงบัตรนักเรียน D3 เป็นเวลาเปิดสำนักงาน 09:00 น. D4 เป็นราคาผู้ใหญ่ 100 บาท และ D5 เป็นสีดอกไม้ ข้อมูลสำนักงานและผู้ใหญ่ไม่ใช่คำตอบของสองคำถามที่เตรียมไว้
Explorer ใช้ candidate pool ร่วมสำหรับสองคำถาม โดยกำหนด G={D1,D2} ไม่ใช่ macro-average recall ของการค้นแยกทีละ query ผู้ใช้เปลี่ยนลำดับผลค้น k ความจุบริบท และ answer policy แล้วดู ranked results, effective context และคำตอบ/แหล่งที่มา โค้ดใช้ลำดับที่ผู้เขียนตั้ง ไม่ได้รัน embedding หรือ reranker จริง
ทดลอง: ค้นเจอ แต่เข้าถึงบริบทและตอบถูกหรือยัง?
สองคำถาม: นิทรรศการวันเสาร์เปิดกี่โมง และนักเรียนที่แสดงบัตรเสียค่าเข้าชมเท่าไร? ตัวอย่างนี้ใช้ candidate pool ร่วมกันหนึ่งชุด ไม่ใช่ค่าเฉลี่ย Recall รายคำถาม
Input: corpus และคำตอบอ้างอิงที่ตรวจได้
Gold ของโจทย์คู่นี้ G = {D1,D2} คำตอบ:10:00/D1 และ50บาทเมื่อแสดงบัตรนักเรียน/D2 ปิดช่อง gold ครบแล้ว หมายถึงความครบของ relevant documents ยัง UNKNOWN ไม่ใช่ recall0%
State: Ranked set → Effective context
Retrieved top-k
Effective context
แต่ละ record ใช้1หน่วยบริบทสมมติ เก็บ prefix ตามลำดับเดิม ความจุไม่ใช่ token ของโมเดล และการที่ document อยู่ในบริบทไม่รับรองว่าโมเดลจริงจะใช้ข้อมูลนั้น
Output: คำตอบ / Citation / Support
สูตรและ denominator ของแต่ละตัวชี้วัด
Recall@k = gold ที่อยู่ใน retrieved / gold2รายการ เมื่อ labels ครบ • Precision@k = gold ที่พบ / จำนวน retrievedจริง • Context coverage = gold ที่เก็บใน effective context / gold2รายการ
Answer accuracy = ค่าถูก / จำนวนข้อที่ตอบจริง พร้อมแสดง answer coverage = ข้อที่ตอบ /2 แยกกัน • Claim support = ข้อที่ค่าตรงและ cite source ที่รองรับซึ่งอยู่ใน context / จำนวนข้อที่ตอบจริง งดตอบทุกข้อมี denominator0 จึงเป็น NA ไม่ใช่100% ป้ายความเกี่ยวข้องไม่ครบเป็น UNKNOWN; คำตอบอ้างอิง10:00/50บาทยังทราบในโจทย์สมมติ ผลจำลองนี้ไม่วัด citation recall ของระบบจริง
นโยบาย miscitation ใช้ค่าที่กำหนดไว้ล่วงหน้าเพื่อแยกความถูกต้องกับหลักฐาน ไม่ใช่คำตอบจาก AI คะแนนไม่ยืนยันความจริงนอกข้อมูลสมมติ และไม่ใช่ causal proof ของระบบจริง
เมื่อลำดับเริ่มด้วย D3,D4 และเลือก k=2 เอกสารสำคัญยังไม่อยู่ในผลค้น แต่เมื่อลำดับเริ่มด้วย D1,D2, k=2 และ context capacity=1 ผลค้นครอบคลุม G แล้ว ในบริบทกลับเหลือเพียง D1 ภายใต้ evidence policy จึงตอบเวลาได้แต่ต้องงดตอบราคา คะแนนความถูกต้องเฉพาะคำถามที่ตอบอาจเต็ม จึงต้องอ่าน answer coverage ที่ยังไม่ครบควบคู่กัน
โหมด miscite ให้ค่าถูก 10:00 และ 50 แต่ผูกกับ D3/D4 เพื่อเห็นว่า correct value ไม่เท่ากับ cited support โหมด wrong เลือกค่าจากคนละ field ส่วน abstain ไม่สร้างข้อกล่าวอ้าง คะแนน accuracy/support เมื่อไม่มีคำตอบเป็น NA ไม่ใช่เต็ม
Support ใน Lab เป็น กฎ citation-grounded ของ fixture: ค่าต้องตรงแหล่งอ้างอิง D1/D2 ที่กำหนด และแหล่งนั้นยังอยู่ใน effective context ไม่ใช่การรัน NLI หรือการวัด RAGAS faithfulness แบบใช้บริบททั้งหมด กฎนี้ใช้แทนความหมายได้เฉพาะข้อมูลที่กำหนด และไม่พิสูจน์ความจริงของพิพิธภัณฑ์ภายนอก
การปิดสถานะ gold completeness จำลองว่า document relevance labels ไม่ครบ จึงให้ retrieval metrics ที่ต้องใช้ชุดครบเป็น UNKNOWN ไม่ได้หมายความว่าผู้เขียนลืมคำตอบอ้างอิงของ Q1/Q2 หน่วย context เป็นหนึ่ง record ต่อหนึ่งหน่วยสมมติ ไม่ใช่ token จริง
ประยุกต์กับความจำและงานของ Agent
หาก qualifier หายตั้งแต่สรุปความจำก่อนสร้าง index การเปลี่ยน retriever อาจไม่คืนข้อมูลที่ถูกลบ ต้องตรวจ corpus ด้วย ศึกษาขั้นก่อนค้นใน Memory Consolidation ของ AI Agent
คำถามต่างเวลาต้องมี reference ตรงเวลา/ขอบเขต คำตอบตาม record เก่าอาจผิดสำหรับปัจจุบัน ใช้นโยบาย temporal/authority ที่ชัด ดู Bitemporal Memory ไม่ใช้ timestamp ใหม่ที่สุดแทนผู้มีอำนาจ
Semantic representation เป็นหนึ่งส่วนของ pipeline คะแนน retrieval ไม่รับรองคำตอบทั้งระบบ การศึกษาเทคโนโลยีอย่าง ResonanceDB จึงต้องตามด้วยการประเมิน corpus/query/metric/ข้อจำกัด ไม่ใช้ความใหม่เป็นหลักฐานว่าคำตอบเชื่อถือได้
Failure Modes และข้อจำกัดที่ต้องเก็บในรายงาน
- Corpus Gap: ข้อมูลที่จำเป็นไม่มีอยู่ในชุดค้น ควรแยกจากการจัดอันดับไม่พบข้อมูลที่มีอยู่
- Relevance Label Gap: ผลค้นมีเอกสารที่ยังไม่ถูกตัดสิน คะแนนจึงมีข้อจำกัด ไม่ใช้ unjudged เป็นหลักฐานว่าไม่เกี่ยวข้องแน่นอน
- Context Loss: เอกสารถูกค้นได้แต่ข้อความสำคัญถูกตัด กรอง หรือไม่ได้ส่งเข้าบริบทจริง
- Unsupported Claim: คำตอบเพิ่มหรือเปลี่ยนรายละเอียดที่บริบทไม่รองรับ แม้ส่วนอื่นอาจถูก
- Citation Mismatch: ลิงก์มีจริงแต่ชี้คนละ field ไม่รองรับประโยค หรืออ้างแหล่งที่ไม่ได้เปิดให้ใช้ตามสัญญา
- Abstention Blind Spot: ดู accuracy เฉพาะข้อที่ตอบแล้วโดยไม่ดู coverage ทำให้ระบบที่แทบไม่ตอบดูดี
- Judge Error & Drift: ผู้ตรวจอาจตีความผิดหรือเปลี่ยนตาม prompt/model/API ต้องเก็บรุ่นและตรวจมนุษย์ในตัวอย่างที่เหมาะสม
คะแนนและ flags ช่วยเลือกจุดตรวจ แต่ไม่ใช่การพิสูจน์เหตุทั้งหมด หากยังไม่มี labels หรือ reference ที่พอใช้ให้รายงาน UNKNOWN การใช้โมเดลตรวจคำตอบของตัวเองอีกครั้งไม่ถือว่าเพิ่มหลักฐานอิสระโดยอัตโนมัติ
เกมจำลอง: วินิจฉัยร่องรอยเดิม แล้วแก้ Pipeline
เกมมีสองคำถามและ challenge สามแบบ ให้เลือก diagnosis ของร่องรอยเดิม แล้วใช้ action budget แก้การจัดอันดับ k ความจุ context หรือ evidence policy เป้าหมายสุดท้ายคือ pipeline ที่แก้แล้วให้คำตอบถูก มีแหล่งอ้างที่เก็บอยู่ และผู้เล่นเลือกค่า/ที่มาได้ครบภายในงบ การงดตอบไม่ถือว่าชนะเต็ม
เกม: ซ่อมสองคำถามให้ตอบพร้อมหลักฐาน
อ่าน original trace เพื่อวินิจฉัย stage ที่พลาด แล้วเลือกวิธีแก้ในงบ6หน่วย เป้าหมายคือคำตอบทั้งสองถูกและ citeหลักฐานที่ยังอยู่ใน context พร้อมวินิจฉัยกรณีเริ่มต้นให้ตรงร่องรอย
Rerank2หน่วย • เพิ่มk1หน่วย • เพิ่มcontext1หน่วย • เปลี่ยนเป็นevidence-only1หน่วย เป็นงบการกระทำสมมติ ไม่ใช่เงิน token หรือ latency
Input corpus / กติกา / Trace
retrieval miss = sourceที่ต้องการไม่อยู่ใน retrieved; context loss = พบsourceแล้วแต่ไม่อยู่ในeffective context; answer issue = มีclaimแต่ค่าผิดหรือcitationไม่รองรับ ถ้ามีมากกว่าหนึ่งflagเลือกหลายstage นี่คือกติกาวินิจฉัยร่องรอยจำลอง ไม่ใช่การพิสูจน์สาเหตุของ LLM
ชนะเมื่อทั้งสองคำตอบที่ pipeline สร้างหลังซ่อมถูกและรองรับด้วยหลักฐาน คุณเลือกค่าถูกและsourceตรงที่ยังอยู่ใน context วินิจฉัยoriginal traceถูก และไม่เกินงบ ABSTAINไม่ถือว่าทำสำเร็จ Stateอยู่เฉพาะหน้าเว็บ ไม่เปลี่ยนน้ำหนักโมเดล
Challenge เริ่มต้นแยกให้เห็นเวลาเป็น retrieval miss และราคาเป็น context loss: ขั้นค้นของคำถามราคามี D2 แต่ packing ทำให้หลุดออก ทดลองแก้ที่ขั้นจริงตาม trace แทนเพิ่ม k ทุกกรณี ส่วน challenge อื่นแสดงคำตอบหรือ citation ที่ไม่รองรับ และกรณีที่มี flags มากกว่าหนึ่งชนิด
งบเริ่มต้นหกหน่วยเป็น ต้นทุน action ที่ผู้เขียนตั้ง: rerank สองหน่วย เพิ่ม k หนึ่ง เพิ่ม context capacity หนึ่ง และเปลี่ยนเป็น evidence policy หนึ่ง ไม่ใช่ราคา API, token หรือเวลา inference ค่าต้นทุนใช้ทำให้เห็นการเลือกแก้ระบบภายใต้ทรัพยากรจำกัดเท่านั้น
Diagnosis ในเกมตรวจ ID/ผลลัพธ์ตามกฎ deterministic; หลาย flags ใช้หมวด both ไม่ได้ทดสอบ causal reasoning ของ LLM ผู้เล่นควรอ่าน original trace กับ current state แยกกัน กด Reset เพื่อเริ่มใหม่และเปรียบเทียบผลโดยไม่เปลี่ยนความจำหรือ weights ของโมเดลใด
งานวิจัยต่อไปและสิ่งที่เริ่มตรวจได้ทันที
งานต่อไปคือ evidence sets ที่มีหลายทางตอบ, relevance judgments ครอบคลุม retrievers ต่างชนิด และ judge บนภาษา/โดเมนผู้ใช้ ตรวจข้อผิดพลาดรายกลุ่มและ source spans ของ claims ร่วมกับคะแนนรวม
สำหรับผู้พัฒนา เริ่มจาก query set เล็กที่นิยาม gold/reference ได้ เก็บ ranked IDs กับ effective text แยกกัน แล้วสร้างรายงาน correctness, cited support และ answer coverage แยกช่อง ตรวจ raw examples ของแต่ละ failure flag ก่อนปรับระบบ เก็บ held-out queries ไม่ให้รั่วไปขั้นปรับ prompt หรือฝึก judge

เมื่อทดลองวิธีใหม่ให้ตรึง corpus snapshot, query set, budget และ generation settings เท่าที่ทำได้ รายงานสิ่งที่เปลี่ยนและค่าใช้จ่ายที่วัดจริง การเปลี่ยน rank, context, prompt หรือ external memory ไม่เท่ากับการฝึกน้ำหนัก และผลของ simulator นี้ไม่ใช่คำรับรองประสิทธิภาพของ Agent production
FAQ
Recall@k สูงแล้วรับรองว่าคำตอบถูกหรือไม่
ไม่รับรอง ยังต้องตรวจ effective context การใช้ข้อมูล คำตอบอ้างอิงและแหล่งที่ผูกกับ claims เอกสารเกี่ยวข้องหลายชิ้นอาจยังไม่พอสำหรับเงื่อนไขทั้งหมดของคำถาม
Faithfulness เหมือน Factual Correctness หรือไม่
ต่างกัน Faithfulness ตรวจความสอดคล้องกับบริบท ส่วน correctness ตรวจตาม reference/เกณฑ์งาน คำตอบที่ตามเอกสารผิดอาจ faithful แต่ไม่ถูกตามสิ่งที่ต้องตอบ
Reference-free Evaluation ไม่ต้องใช้มนุษย์เลยหรือไม่
หมายถึงบาง metric ไม่ต้องมี reference answer สำหรับทุกตัวอย่าง ไม่ได้ทำให้ judge ถูกเสมอ ยังต้องตรวจความเหมาะสมและประเมินข้อผิดพลาดของผู้ตรวจ ส่วน ARES มีข้อมูลมนุษย์เป็นส่วนของการประเมินด้วย
ข้อมูล unjudged นับเป็นไม่เกี่ยวข้องได้ทันทีหรือไม่
ไม่ควรอ้างว่าไม่เกี่ยวข้องแน่นอน ต้องรายงาน label coverage และ convention ที่ใช้คำนวณคะแนน หากข้อมูลไม่พอหาตัวหารตามนิยาม ให้ใช้ UNKNOWN หรือ NA พร้อมเหตุผล
งดตอบทุกข้อทำให้ Support เต็มหรือไม่
ไม่ควรให้คะแนนเต็มโดยไม่มี claims ให้ตรวจ Lab ให้ accuracy/support เป็น NA เมื่อไม่ตอบ และแสดง answer coverage ศูนย์ เป้าหมายเกมยังต้องตอบพร้อมหลักฐานครบ
เกมนี้ทดสอบ RAGAS, ARES หรือโมเดลจริงหรือไม่
ไม่ได้ เป็น corpus/อันดับ/กฎคำตอบที่ผู้เขียนกำหนด ไม่มี LLM, embedding, NLI หรือการฝึก evaluator เป็นการสำรวจความต่างของขั้นค้น ขั้นจัดบริบท และขั้นตอบตาม fixture นี้
References
- BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021 Datasets and Benchmarks; peer-reviewed, retrieval/qrels และ annotation bias
- RAGAS: Automated Evaluation of Retrieval Augmented Generation, EACL 2024 System Demonstrations, มีนาคม 2024; peer-reviewed, reference-free dimensions และ judge limitations
- ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024 Long Papers, มิถุนายน 2024; peer-reviewed, trained judges/human validation/PPI
- Enabling Large Language Models to Generate Text with Citations — ALCE, EMNLP 2023, ธันวาคม 2023; peer-reviewed, correctness กับ citation quality/NLI limitations
- Lost in the Middle: How Language Models Use Long Contexts, TACL 2024; peer-reviewed, information position/use ภายใต้โมเดลและงานทดลองที่ระบุ
ใส่ความเห็น