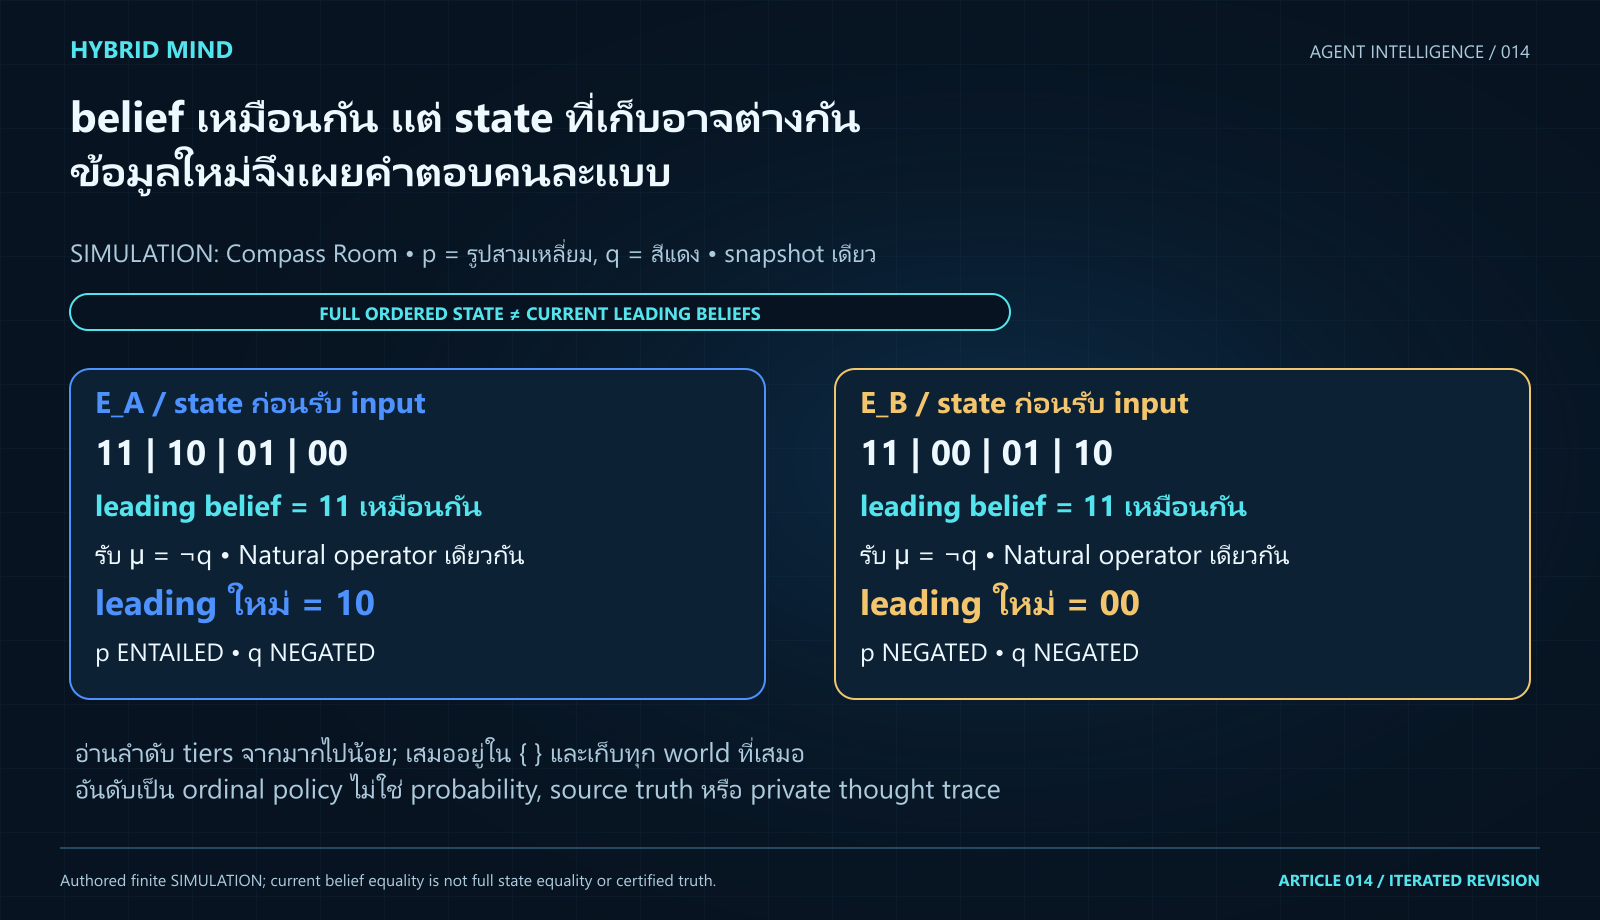
AI Agent สองตัวอาจให้คำตอบปัจจุบันเหมือนกัน แต่เปลี่ยนข้อสรุปต่างกันเมื่อรับข้อมูลใหม่ เพราะคำตอบล่าสุดไม่ได้บอกว่าระบบจัดลำดับทางเลือกที่ยังไม่เชื่อไว้อย่างไร Iterated Belief Revision จึงพิจารณาทั้งความเชื่อที่ยอมรับอยู่และ Epistemic State ซึ่งกำหนดวิธีรับข้อมูลในรอบถัดไป การเก็บเพียงข้อสรุปอาจทำให้ข้อมูลส่วนนี้หายไป
คำตอบสำหรับผู้สร้าง Agent คือ ระบุรูปแบบ state นโยบาย revision และเวอร์ชันของทั้งสองอย่างก่อนใช้คำว่า “จำได้” บทความนี้เปรียบเทียบ Natural Revision กับ Lexicographic Revision ผ่าน ordered partitions ของโลกจำลองสี่โลก โดยไม่ถือว่าลำดับดังกล่าวเป็นความน่าจะเป็น ความน่าเชื่อถือของแหล่งข้อมูล หรือความจริงของโลกภายนอก สถาปัตยกรรมผสาน Agent เป็น HYPOTHESIS ส่วน Interactive และเกมเป็น SIMULATION ของนิยามที่กำหนด

Executive Answer: คำตอบเหมือนกันอาจซ่อน state คนละแบบ
- Current Beliefs บอกสิ่งที่เชื่ออยู่ ส่วน Epistemic State บอกด้วยว่าจะจัดการความเป็นไปได้อื่นเมื่อเงื่อนไขเปลี่ยนอย่างไร
- Natural Revision ย้ายทุกโลกที่มีอันดับดีที่สุดภายในกลุ่มที่รองรับ input ขึ้นหน้า โดยรักษาลำดับของโลกอื่น ส่วน Lexicographic Revision ย้ายโลกทั้งหมดที่รองรับ input ขึ้นหน้ากลุ่มที่ไม่รองรับ
- สองนโยบายอาจให้ข้อสรุปรอบหนึ่งเหมือนกัน แต่เก็บลำดับส่วนที่เหลือต่างกัน จึงต้องตรวจหลายรอบและรักษา ties
- ความสอดคล้องกับสูตรที่รับไม่ได้พิสูจน์ว่า input ถูกต้อง การตรวจแหล่งข้อมูลและการตัดสินใจรับ input ต้องมีขอบเขตของตัวเอง
Why It Matters: เก็บข้อสรุปแล้วอาจกู้กติกาของรอบต่อไปไม่ได้
ระบบสองตัวอาจรายงานสถานะหนึ่งเหมือนกัน แต่จัดอันดับทางเลือกสำรองกลับกัน หากมีข้อมูลมาหักล้างสถานะที่เชื่ออยู่ ทั้งคู่ต้องเลือกจากทางเลือกที่เหลือ ข้อสรุปเดิมจึงไม่พอให้เราทำนายผลใหม่
ประเด็นนี้ต่างจาก Belief Revision แบบหนึ่งรอบ ที่ถามว่าจะเปลี่ยนสูตรหรือ models ตามเกณฑ์ใด เมื่อทำหลายรอบ เรายังต้องกำหนดว่าแต่ละครั้งเปลี่ยนลำดับสำหรับครั้งต่อไปอย่างไร ข้อเสนอคือเก็บทั้ง snapshot ของข้อสรุปและ state สำหรับ revision เพื่อเปิดเผยความต่างนั้น โดยไม่อ้างว่า LLM ทุกตัวใช้ลำดับโลกแบบนี้
Scientific Foundations: จาก Belief Set ไปสู่ Epistemic State
1. ความเชื่อปัจจุบันเป็นเพียงส่วนหนึ่งของ state
งาน Darwiche–Pearl แยก belief sets ที่เท่ากันออกจาก state เดียวกัน ทำให้ revision ขึ้นกับ epistemic state ได้ สอง state ที่เชื่อสูตรเหมือนกันจึงอาจมีพฤติกรรมถัดไปต่างกัน รายงานผู้เขียนลงวันที่6พฤศจิกายน1996; ตีพิมพ์ Artificial Intelligence ปี1997 เราอ่านวิธีต้นฉบับ ไม่ได้พิสูจน์ทฤษฎีใหม่ Darwiche–Pearl
ในแบบจำลองที่บทความใช้ ให้ W เป็นเซตโลกที่เป็นไปได้ทั้งหมด และ ≤Ψ เป็น total preorder ของ state Ψ สัญลักษณ์นี้หมายถึงลำดับที่สะท้อนความเป็นไปได้สัมพัทธ์ โดยโลกที่อยู่หน้ากว่าเป็นโลกที่ระบบให้ความสำคัญก่อน โลกหลายโลกผูกอันดับกันได้ เราแสดงเป็นกลุ่ม เช่น {โลกหนึ่ง, โลกสอง} แล้วต่อด้วยกลุ่มถัดไป
ความเชื่อปัจจุบันอ่านจากทุกโลกในกลุ่มต่ำสุด ไม่เลือกโลกเดียวตามอำเภอใจ:
Bel(Ψ) = {φ : ทุก w ใน min(W, ≤Ψ) ทำให้ φ เป็นจริง}
φ คือสูตรที่ถาม; w คือโลกหนึ่ง; min คือสมาชิกที่ต่ำสุดตาม preorder นี้; Bel(Ψ) คือสูตรที่ทุกโลกในกลุ่มนั้นรองรับ ถ้าโลกต่ำสุดสองโลกให้ค่า p ต่างกัน ระบบยังไม่ยอมรับ p และยังไม่ยอมรับ ¬p การแสดงว่า UNDETERMINED จึงรักษาข้อมูลส่วนนี้ได้ดีกว่าการหยิบโลกแรกมาเล่าเป็นข้อเท็จจริง
การเปลี่ยนชื่อระดับจาก 0, 1, 2 เป็น 10, 20, 30 โดยไม่เปลี่ยนลำดับและ ties ไม่ได้เปลี่ยนความหมายเชิงอันดับในตัวอย่างนี้ ระยะห่างของตัวเลขไม่ได้เป็นหลักฐานว่าระบบมั่นใจเพิ่มขึ้นกี่เปอร์เซ็นต์ และไม่เท่ากับ Belief State เชิงความน่าจะเป็นใน POMDP
2. รับ input แล้วต้องเปลี่ยน state สำหรับรอบต่อไปด้วย
ให้ μ เป็นสูตร input ใหม่ที่ยอมรับ และ Ψ ∘ μ เป็น state หลัง revision แบบจำลองเลือกโลกที่รองรับ μ ซึ่งมีอันดับดีที่สุดภายใต้ state เดิมเป็น models ของความเชื่อใหม่:
Mod(Bel(Ψ ∘ μ)) = min(Mod(μ), ≤Ψ)
Mod(μ) คือทุกโลกที่ทำให้ μ เป็นจริง สมการบอก minimum worlds ของผลใหม่ แต่ยังไม่ได้บอกลำดับของโลกที่เหลือทั้งหมด ความต่างส่วนนี้เป็นจุดที่ Natural กับ Lexicographic กำหนดเพิ่ม เมื่อจะรับ input รอบถัดไป ระบบจึงควรใช้ preorder ของ state ใหม่ ไม่ย้อนใช้อันดับเดิมอย่างเงียบ ๆ
กรอบ DP เสนอข้อกำหนด C1–C4 และความสัมพันธ์ระหว่าง preorders เพื่อกำกับการรักษาความเชื่อแบบมีเงื่อนไข กล่าวโดยย่อ มันรักษาลำดับภายในกลุ่มที่รองรับ input และภายในกลุ่มที่ไม่รองรับ พร้อมคุมการเปลี่ยนความสัมพันธ์ข้ามกลุ่มบางกรณี กรอบนี้ไม่ได้ระบุอัลกอริทึม transition เพียงหนึ่งเดียว และเงื่อนไขของ formal framework ไม่ใช่คำรับประกันคุณภาพของการแปลภาษาธรรมชาติ
“ถ้ารับ α แล้วจะเชื่อ β” ในบริบทนี้เป็นการทดสอบหลัง revision สมมติ ไม่ใช่เพียง material implication α→β ที่เก็บเป็นสูตรเดิม เราไม่อ้างว่าการแสดง conditional ผ่าน Lab เท่ากับความสามารถ reasoning ของ LLM หรือเป็นความสัมพันธ์เชิงสาเหตุของอุปกรณ์จริง
Mechanism: Natural และ Lexicographic เปลี่ยนอะไร
Natural หรือ MC Revision ของ Boutilier เลือกทุกโลกใน min(Mod(μ), ≤Ψ) ให้เป็นกลุ่มหน้าใหม่ แล้วรักษาลำดับสัมพัทธ์ของโลกอื่นไว้ นิยามอ่านจาก Definition2 ของสำเนา To appear1995 ซึ่งตีพิมพ์ JPL ปี1996 และตรวจ§3.2ของ IJCAI1993 precursor เพิ่มด้วย จึงแยกปีสำเนาจากปีตีพิมพ์ Boutilier: ต้นฉบับวิธี
Simple Lexicographic Revision ในงาน Nayak, Pagnucco และ Peppas รักษาลำดับภายในกลุ่ม μ และกลุ่ม ¬μ แล้ววางทุกโลกของ μ ไว้หน้าทุกโลกของ ¬μ เราอ่าน SimpLex1–3 ในสำเนา author-hosted uncorrected proof; บทความตีพิมพ์ Artificial Intelligence ปี 2003 นโยบายนี้เข้มกว่าการเลื่อนเฉพาะ minimum worlds และไม่ใช่ข้อพิสูจน์ว่าผลตรงโลกจริงมากกว่า Nayak และคณะ: ต้นฉบับวิธี
Natural เก็บความสัมพันธ์ของโลกที่ไม่ได้เลื่อน ส่วน Lexicographic ให้ input ล่าสุดจัดอันดับข้ามกลุ่มทั้งหมด โลกที่ตรง input ซึ่งเคยอยู่ท้ายจึงถูกย้ายผ่านโลกที่ไม่ตรง input ควรเลือกตามความหมายและอำนาจของ input ที่กำหนด ไม่เลือกจากคำว่า “minimal” หรือ “latest” เพียงคำเดียว
System Architecture: การผสาน Agent ที่เสนอ
ส่วนนี้คือ Conceptual Architecture / HYPOTHESIS สำหรับระบบที่มี state ภายนอกและอินพุตแบบมีโครงสร้าง ไม่ใช่แผนภาพของ LLM ทุกตัวหรือ implementation ที่ผู้วิจัยทั้งสามใช้จริง ภาพรวมจัด Commit กับ Replay เป็นกลุ่มเดียว ส่วนตารางแยกหน้าที่เพื่อให้เห็นจุดตรวจเจ็ดหน้าที่

| Module | Input / State | Output / จุดตรวจและ failure |
|---|---|---|
| Input / Scope Registry | input ดิบ, source reference, snapshot scope, vocabulary และเวอร์ชัน | ระบุโจทย์และช่วงความหมายของ p/q; ถ้าเปลี่ยน vocabulary ต้องจัดการการย้าย state ก่อน ห้ามเทียบอันดับคนละเซตโลก |
| Admission & Proposition Mapper | ข้อมูลใหม่, นโยบายรับข้อมูล, schema ของสูตร | คืน μ พร้อม accepted/quarantined และ mapping provenance; สูตรที่ตรงไวยากรณ์ยังอาจแปลผิดหรือมาจากแหล่งไม่น่าเชื่อถือ |
| Epistemic State Store | ordered partition, state version, operator/policy version | คืน snapshot ที่ไม่แก้ย้อนและสำเนาสำหรับคำนวณ; เก็บเพียง minimum worlds อาจทำให้ลำดับทางเลือกหาย |
| Revision Operator | state เดิม, μ ที่รับ, natural/lex policy | คืน candidate partition กับชุด worlds ที่เลื่อน; ต้องรักษาสมาชิกครบและ ties ภายในเงื่อนไขที่กำหนด ไม่เปลี่ยนเป็นผลลัพธ์ที่เลือกโลกเดียว |
| Belief & Trace Evaluator | candidate partition, query และ transition record | คืน minimum worlds, literal status และผลต่างของ preorder; ตรวจว่า input ที่รับถูกสะท้อนใน current beliefs โดยไม่ยก trace เป็นหลักฐานความจริงภายนอก |
| Versioned Commit | candidate, admission result, expected state/policy versions | บันทึก state ใหม่แบบมีเงื่อนไขเมื่อเวอร์ชันตรง; ถ้าเงื่อนไขไม่ผ่านให้รักษา snapshot เดิม ไม่เขียนทับด้วย candidate จาก state เก่า |
| Replay & Audit Reporter | state/input/policy history ที่เก็บจริง | replay transition ตามเวอร์ชันเดิมและรายงานผล; input หรือ policy ที่ตกหล่นทำให้ replay ไม่สมบูรณ์ ต้องระบุ UNKNOWN |
ข้อมูลแหล่งที่มาและ admission ไม่ได้อยู่ใน preorder โดยอัตโนมัติ state version ก็ไม่ใช่ระดับความจริง ใน Agent ที่ใช้ LLM ต้องแยก Context Window ของคำขอหนึ่ง, Retrieved Context ที่เลือกกลับมา, External Memory ที่เก็บภายนอก และ Weight Updates การบันทึก preorder ไม่ได้ฝึกน้ำหนัก และ trace นี้ไม่พิสูจน์ reasoning ภายในของ LLM
Operational Flow: จาก input ถึง state ใหม่

- กำหนด scope เดียวกันและตรวจ vocabulary รวมถึงเซต worlds ที่ state ใช้
- ตรวจ admission แยกจากการแปลข้อความเป็น μ; บันทึกที่มาของ mapping และการตัดสินใจ
- อ่าน state/policy snapshot แล้วประเมินว่า μ มี models หรือไม่ ถ้าเป็นกรณีที่ระบบไม่รองรับให้หยุดตาม guard ที่ประกาศ
- คำนวณ candidate ด้วยนโยบายที่เลือก โดยรักษาทุก tie และบันทึกกลุ่มก่อน/หลัง
- อ่านความเชื่อจาก minimum worlds ทั้งกลุ่ม พร้อมรายงานว่าลำดับส่วนที่เหลือเปลี่ยนอย่างไร
- commit เมื่อเวอร์ชันและ guard ผ่าน แล้วใช้ state ใหม่เป็น input สำหรับ revision รอบถัดไป
- replay ประวัติที่บันทึกเพื่อแยกความต่างจาก input order, operator หรือ state เดิม
pseudocode ต่อไปนี้เป็น conceptual pseudocode ที่สรุปหน้าที่ ไม่ใช่การทดสอบระบบ NLP หรือการพิสูจน์ postulates ทั้งหมด:
revise_snapshot(state, input, operator_version):
  if input.admission != ACCEPTED:
    return DEFER_WITHOUT_MUTATION
  models = worlds_satisfying(input.formula, state.vocabulary)
  if models is empty:
    return DEFER_UNSUPPORTED_INPUT

  if operator == NATURAL:
    promoted = every_minimal_input_world(state.order, models)
    candidate = promoted_then_old_order_without_promoted(state.order)
  if operator == LEXICOGRAPHIC:
    candidate = input_suborder_then_complement_suborder(state.order)

  check_world_membership_and_ties(candidate)
  beliefs = formulas_true_in_every_minimum_world(candidate)
  record_transition(state.version, input, operator_version, candidate)
  return commit_if_expected_versions_match(candidate, beliefs)
DEFER เป็นนโยบายของการผสานที่เสนอ ไม่ใช่คำตอบของต้นฉบับทุกงาน สูตรที่ satisfiable ยังอาจแปลผิดหรือมาจากคนละ snapshot
Technical Comparison: รักษาข้อสรุปหรือรักษาโครงสร้างทางเลือก

| แนวทาง | สิ่งที่เก็บและเปลี่ยน | ข้อจำกัดที่ต้องเห็น |
|---|---|---|
| Natural / MC Revision | ย้ายทุก minimum μ-world ขึ้นหน้า; รักษาลำดับของโลกอื่น | การรักษา ordering มากอาจทำให้ observation ก่อนหน้าถูกถอนในบาง sequence; ต้องตรวจหลายรอบ ไม่ประเมินจากคำตอบครั้งเดียว |
| Simple Lexicographic Revision | ทุก μ-world อยู่หน้า ¬μ-world; รักษาลำดับภายในแต่ละกลุ่ม | อำนาจของ input ใหม่ต่ออันดับข้ามกลุ่มมากกว่า ถ้า admission ผิดก็อาจรักษาผลของ input ผิด; ไม่มี benchmark ในบทความนี้ที่จัดอันดับผู้ชนะ |
อีกกรณีคือ Current-belief-only storage — HYPOTHESIS: เก็บ minimum worlds แล้วทิ้งอันดับที่เหลือ เป็น baseline แบบสูญเสียข้อมูลที่เรากำหนด ไม่ใช่อัลกอริทึม AGM หนึ่งเดียว ประเด็นนี้เชื่อมกับ Memory Consolidation แต่เราศึกษา transition จาก state ที่เก็บจริง
การเทียบสอง operator ต้องใช้ vocabulary, state, input sequence และ admission เดียวกัน พร้อมรักษา ties อย่าเพิ่ม source reliability ให้เฉพาะฝ่ายหนึ่งแล้วสรุปว่าอีกฝ่าย reasoning แย่กว่า
Interactive Demonstration: สำรวจ state ที่คำตอบล่าสุดไม่แสดง
Lab ใช้ Compass Room ซึ่งเป็นชิ้นงานสมมติเดียวกัน ณ snapshot เดียวกัน: p คือ “เป็นรูปสามเหลี่ยม”; q คือ “สีแดง” โลก10จึงหมายถึงสามเหลี่ยมที่ไม่แดง ไม่ใช่หมายเลขการทดลอง เรารับสูตรจากรายการที่กำหนด ไม่แปลภาษาธรรมชาติและไม่เรียก LLM
เลือก E_A = {11} < {10} < {01} < {00} กับ E_B = {11} < {00} < {01} < {10} ทั้งคู่เริ่มเชื่อ p และ q เมื่อรับ ¬q ผล minimum เป็น10สำหรับ E_A แต่เป็น00สำหรับ E_B ตามทั้งสอง operator ในกรณีนี้ ความต่างมาจากอันดับเดิมที่คำตอบ “11” ไม่ได้แสดง หากยุบโลกที่เหลือให้เสมอกันแบบ baseline ที่กำหนดเอง ผล ¬q จะมี {00,10} และ p เป็น UNDETERMINED; ข้อสรุปเดิมไม่ได้บังคับให้สร้าง baseline แบบนี้เพียงแบบเดียว
ลองแยก operator ด้วย E_A แล้วรับ ¬p: Natural ได้ {01} < {11} < {10} < {00}; Lexicographic ได้ {01} < {00} < {11} < {10} คำตอบแรกเหมือนกันคือ01แต่อันดับที่เหลือต่างกัน เมื่อรับ ¬q ต่อ Natural ได้ minimum10ส่วน Lexicographic ได้00 นี่เป็นผลของนิยามใน fixture ไม่ใช่ benchmark ของ AI
สำหรับการสลับ input ใช้ E_0 = {10,11} < {00} < {01} ซึ่งเชื่อ p แต่ q ยัง UNDETERMINED Natural เมื่อรับ q แล้ว ¬p จบที่00; เมื่อรับ ¬p แล้ว q จบที่11 ข้อมูล q กับ ¬p รองรับร่วมกันได้ในโลก01แต่การที่ Natural ถอน q ใน sequence แรก ไม่ใช่หลักฐานว่าละเมิด DP ข้อกำหนดการรักษาอันดับกับการรักษาทุก observation ไม่ใช่เงื่อนไขเดียวกัน
Lexicographic สองลำดับนั้นจบด้วย minimum01เหมือนกัน แต่ full states เป็น {01} < {00} < {11} < {10} กับ {01} < {11} < {00} < {10} ตามลำดับ ลอง hypothetical query p↔q ซึ่งมี models00/11จะเห็นผล00เทียบกับ11 การ probe ไม่แก้ current partition, version หรือ commit history ส่วนการเลือก Commit จะบันทึก revision ของเกมจำลอง
เลือก E_TIE = {10,11} < {00,01} แล้วรับ ¬p ทั้งสอง operator ต้องเก็บ {00,01} เป็นกลุ่มหน้า p จึง NEGATED แต่ q ยัง UNDETERMINED การทิ้งหนึ่งโลกเพื่อให้ q ชัดจะเปลี่ยนความหมายของผล UI แสดงสถานะ literal p/q ไม่ได้แจกแจงทุกสูตรใน Bel(Ψ)
การโต้ตอบแยก Preview, Commit และ hypothetical query พร้อม full partition, literal status และประวัติก่อน/หลังแบบมี version Reset คืน initial state ที่เลือกและล้างประวัติ ไม่มี persistence ข้าม page sessions ผลข้างต้นตรวจด้วย finite core24 checks; browser/public interaction ต้องตรวจแยก ไม่ใช้ core PASS แทนการยืนยันหน้าจอ
ทดลอง: belief เดียวกัน แต่ revision ถัดไปต่างกัน
Compass Room มีชิ้นงานเดียวใน snapshot สมมติเดียว p=รูปสามเหลี่ยม, q=สีแดง ลำดับข้อมูลไม่ใช่ชิ้นงานเปลี่ยนจริง Leading tier คือ current belief; lower tiers มีผลต่อการรับข้อมูลถัดไป เก็บทุก world ที่เสมอกัน
Natural promote ทุก minimal μ เท่านั้น; Lex stable μ ทั้งหมดก่อน¬μ • Admission เป็น policy สมมติ ไม่ใช่ผลตรวจ source จริง • ordinal tiers ไม่ใช่ probabilities/reliability/confidence
State: complete CURRENT partition
Output: PREVIEW แยกจาก committed state
ทุก world ต้องอยู่หนึ่งครั้ง ไม่มี tier ว่าง • empty μ/QUARANTINED/invalid state/stale preview block commit • NO_CONSISTENT_MODELS ไม่ใช่ทุก literal จริง • version เป็น identity ไม่ใช่เวลาหรือระดับความจริง
Hypothetical query: ตรวจต่อโดยไม่แก้ state/history
Immutable COMMIT history: full before/after และ versions
Audit: commit และ blocked attempts
ลองE0 + q→¬p กับกลับลำดับ; Lex belief01เหมือนกันแต่ probe p↔q ต่าง00/11 • EA/EB belief11เหมือนกันแต่¬q ต่าง10/00 • ETIE+¬p ต้องเก็บ00/01ทั้งคู่ • finite illustration ไม่พิสูจน์full DP/AGM ไม่อ้างNaturalผิดDPหรือLexดีกว่าเสมอ • ไม่มี NLP/LLM/network/persistence/training/weights
เกมจำลอง: เลือกผลจาก state ที่ใช้จริง
เป้าหมายเกมคือทำ state และประวัติให้ตรงกติกา มีสี่ภารกิจ: ทำ Natural ของ E_A/¬p ให้ตรง full partition; ทำ Lexicographic สองขั้นของ E_0/q→¬p; DEFER เมื่อ input เป็น QUARANTINED; และ DEFER เมื่อ q∧¬q ไม่มี model
ภารกิจ Natural ปฏิเสธ Lexicographic ก่อนเขียน state แม้ minimum01ตรงกัน เพราะกำหนด operator และ full ordering ไม่ใช่ตรวจแค่คำตอบ ภารกิจสองขั้นต้อง commit แต่ละ input และรักษา immutable before/after history
QUARANTINED เป็นธงนโยบายสมมติ ไม่ใช่ผลตรวจแหล่งข้อมูล Preview อาจมี candidate สอดคล้องแต่ commit ต้องถูกบล็อก input ไม่มี models แสดง NO_CONSISTENT_MODELS ไม่สรุปว่าทุก literal จริงเพราะไม่มีโลกให้ตรวจ DEFER ที่ถูกต้องรักษา state/version/history เดิม การบล็อกอาจเพิ่มบันทึก audit ของความพยายามนั้นโดยไม่เปลี่ยน beliefs
เลือกภารกิจและ operator กด Preview แล้วเลือก COMMIT/DEFER เพื่อส่งขั้น อ่าน guard/result และใช้ Reset คืนภารกิจที่เลือก ไม่มีต้นทุน token หรือคะแนนความน่าเชื่อถือ การทดสอบ core ตรวจเงื่อนไขก่อน mutation และเส้นทางชนะจริง ไม่ได้พิสูจน์คุณภาพ Agent ภายนอก
เกม: รับข้อมูลเป็นลำดับ โดยเก็บทั้ง state และ history
อ่านโจทย์ เลือก operator, preview แล้วตัดสิน COMMIT/DEFER เป้าหมายคือ full partition และทุก tie ตรงกติกาที่ระบุ ไม่ใช่เลือก world เดียวที่ให้ belief ดูถูกต้อง Wrong task policy บล็อกก่อนเปลี่ยน state
State: CURRENT full partition และ version
Output: candidate PREVIEW ยังไม่ commit
Empty μ/QUARANTINED block commit; candidate ที่ไม่มี models ใช้ NO_CONSISTENT_MODELS • ทุก world/tie ต้องเก็บตาม operator • ranks/version ไม่ใช่ probability/ความจริง • source-world truth UNKNOWN
Hypothetical query (ไม่แก้ state/version/history)
Immutable COMMIT history: before/after ทุกขั้น
Audit: COMMIT/DEFER/blocked task policy
Fixed Compass Room snapshot p=สามเหลี่ยม q=สีแดง ไม่ใช่โลกเปลี่ยน • ไม่มี budgets/cost/reliability/LLM claims • finite illustration ไม่ใช่full DP/AGM validation • ไม่มี network/persistence/weight updates
Applications: ประโยชน์ต่อผู้สร้าง Agent และขอบเขตหลักฐาน
หลักฐานต้นฉบับเป็น formal belief revision ไม่ใช่ผล deploy Agent สมัยใหม่ แนวทางต่อไปนี้คือ ANALYSIS / HYPOTHESIS ที่ต้องทดสอบต่อ
Agent วางแผนอาจเก็บการจัดอันดับทางเลือกพร้อมข้อสรุปปัจจุบัน เพื่ออธิบายว่าข้อมูลใหม่ทำให้เลือกทางสำรองจาก state ใด Agent ที่ตอบเรื่องเดิมหลายรอบอาจเก็บ policy version เพื่อแยกว่าคำตอบเปลี่ยนจาก input หรือจากนโยบาย revision ทั้งสองกรณียังไม่มีผลทดลองในบทความที่พิสูจน์ว่าดีกว่าระบบอื่น
ใน multi-agent coordination อาจส่งต่อทั้ง current beliefs และ state reference เพื่อเปิดเผย assumptions ที่ต่างกัน ต้องตรวจ vocabulary, scope และเวอร์ชันของแต่ละฝ่าย การเห็นคำตอบเดียวกันไม่ทำให้ state เท่ากัน และการไม่เห็นด้วยไม่ใช่ข้อผิดพลาดเสมอ
Limitations / Failure Modes: สิ่งที่ตัวอย่างยังไม่พิสูจน์
Representation: n ตัวแปร Boolean มี 2^n worlds การแจกแจงทุกโลกใน Lab เล็กไม่พิสูจน์ว่าทำได้คุ้มค่ากับทุกโจทย์ ไม่มีผลวัดเวลาหรือหน่วยความจำสำหรับ capacity claim
Mapping/admission: ภาษาเต็มมีเวลา entity ข้อยกเว้นและคำกำกวม สูตรอาจผิดตั้งแต่แปลข้อมูล นโยบายที่คำนวณถูกตามสูตรไม่ได้แก้ mapping หรือแหล่งข้อมูลที่ไม่น่าเชื่อถือโดยตัวมันเอง ต้องประเมินสองส่วนนี้แยกจาก formal transition
Sequence: ผลต่างในบาง sequence ไม่แปลว่าทุก input pair สลับที่กันไม่ได้ บางรอบให้ current beliefs เหมือนกันแต่ retained orders ต่างกัน การทดสอบที่หยุดก่อน input ถัดไปจึงอาจมองไม่เห็นความต่าง
Evidence/interpretation: ไม่ได้รัน original implementation, benchmark, independent reproduction หรือ proof replay; original runnable code/version ยัง UNKNOWN ไม่มีหลักฐานว่า LLM ใช้ preorder นี้หรือมีประสิทธิภาพดีขึ้น ไม่ตีความ formal belief ว่าเป็นจิตสำนึก อันดับไม่ใช่ calibrated probability และการรับ input ไม่พิสูจน์ความจริงภายนอก
Future Directions: ทดสอบสิ่งที่เก็บข้ามรอบ
ควรสร้างชุด sequence ที่ความเชื่อรอบกลางเหมือนกันแต่ state ต่างกัน แล้วตรวจความครบของ replay และจุดเปลี่ยน ordering พร้อมผลคำตอบ ต้องรายงาน retained state ด้วย ไม่วัดเฉพาะ answer สุดท้าย
อีกโจทย์คือ admission ที่ผูกกับ provenance และการย้าย preorder เมื่อ vocabulary เปลี่ยน การเพิ่มตัวแปรไม่ใช่เพิ่มเพียงอีกแถว ต้องระบุกติกาฉายความรู้เดิมเข้าสู่ worlds ชุดใหม่ ทั้งสองเรื่องยังไม่ได้พิสูจน์ใน Lab นี้
Practical Takeaways: เก็บให้พอสำหรับรอบถัดไป

แยกสิ่งที่เชื่ออยู่, state ที่ใช้เลือกทางเลือก และ operator ที่เปลี่ยน state เก็บ scope/vocabulary/state version/policy version รวมถึง input ที่รับจริง ไม่ใช้สรุปสั้นแทนทุกอย่างโดยไม่ตรวจข้อมูลที่หาย
กำหนดอำนาจของ input ว่าเลื่อน minimum worlds หรือจัดกลุ่ม worlds ใหม่ทั้งหมด ตรวจหลายรอบและทุก tie รักษา UNDETERMINED เมื่อผลยังคลุมเครือ ก่อนใช้จริงทดสอบ mapping/admission/guard/commit แยกจากการคำนวณ formal และแยก SIMULATION/HYPOTHESIS จากผลจริงที่วัด
FAQ
1. Epistemic State คือความจำทั้งหมดของ Agent หรือไม่?
ไม่จำเป็น กรอบนี้ใช้ state เพื่อกำหนดความเชื่อและพฤติกรรม revision ตัวอย่างใช้ ordered partition ภายนอก Agent จริงอาจมีข้อมูลและ state แบบอื่น จึงไม่ควรเหมารวมว่า memory ทุกชนิดคือ preorder
2. ถ้า Current Beliefs เหมือนกัน state ต้องเหมือนกันไหม?
ไม่ต้อง minimum worlds อาจเหมือนกันแต่อันดับของโลกอื่นต่างกัน ข้อมูลรอบถัดไปที่ตัด minimum เดิมออกจึงอาจให้ข้อสรุปต่างกัน นี่คือเหตุผลที่คำตอบล่าสุดอาจไม่พอให้กู้ state
3. Natural กับ Lexicographic วิธีไหนดีกว่า?
ไม่มีผู้ชนะจากหลักฐานในบทความนี้ ทั้งสองเปลี่ยน ordering ด้วยเกณฑ์ต่างกัน ต้องกำหนดความหมายและอำนาจของ input ก่อน แล้วทดสอบ sequence และข้อจำกัดตามโจทย์ ไม่ใช้คำตอบหนึ่งรอบจัดอันดับทุกการใช้งาน
4. รับ input ล่าสุดแล้วเท่ากับเชื่อข้อมูลล่าสุดเสมอหรือไม่?
ใน formal operator ที่กำหนด input ถูกยอมรับแล้ว แต่ระบบ Agent ต้องตัดสินใจ admission แยกต่างหาก ข้อมูลล่าสุดยังอาจผิด ไม่ครบ หรืออยู่อีก scope หนึ่ง การยอมรับเชิงตรรกะไม่พิสูจน์ source reliability
5. การบันทึก state นี้เป็นการฝึกโมเดลหรือไม่?
ไม่ใช่โดยตัวมันเอง เป็นการเก็บข้อมูลภายนอกที่อาจเลือกกลับเข้า context ภายหลัง ต่างจาก Weight Updates การบันทึก Prompt, ordered partition หรือประวัติ revision ไม่เท่ากับการฝึกน้ำหนัก
6. Lab พิสูจน์ DP หรือแสดงผล reasoning ของ LLM หรือไม่?
ไม่ Lab เป็น SIMULATION ของโลก Boolean และนโยบายที่กำหนด ไม่มีการเรียก LLM ไม่มี original benchmark หรือ proof replay ของ postulates ทั้งหมด ผล formal ที่อ่านได้ไม่รับรองความจริงภายนอกหรือกลไกภายในโมเดล
References
- Darwiche, A.; Pearl, J. On the Logic of Iterated Belief Revision. Artificial Intelligence89(1–2),1–29,1997. Author report6Nov1996; publisher publication metadata. อ่านภาพต้นฉบับหน้าวิธี pp3–14 โดยเฉพาะ§3และ§5.2; ไม่ได้ตรวจ Appendix proofs หรือรัน reproduction.
- Boutilier, C. Revision Sequences and Nested Conditionals. IJCAI1993,519–525. Original proceedings. อ่าน§3.2หน้า522และบริบทลำดับ revision; ใช้ประกอบนิยาม Natural ไม่ใช่อีก operator หนึ่ง
- Boutilier, C. Iterated Revision and Minimal Change of Conditional Beliefs. Journal of Philosophical Logic25,263–305,1996. Author prepublication headed1995; author publication metadata. อ่าน§3.1–3.3 และ Definition2; ไม่ได้รัน original implementation.
- Nayak, A.C.; Pagnucco, M.; Peppas, P. Dynamic Belief Revision Operators. Artificial Intelligence146(2),193–228,2003. Author uncorrected proof; publisher publication metadata. อ่าน§4.2–4.3/SimpLex1–3 และการเปรียบเทียบ§5.1; ไม่ได้รัน original code หรือพิสูจน์ representation theorem ซ้ำ.
Code availability ของ original runnable packages ที่ตรวจในครั้งนี้ยัง UNKNOWN สำเนา papers และนิยามที่อ่านได้ไม่เท่ากับ software version ที่ทดสอบแล้ว สื่อและ Lab ในบทความสร้างเพื่อการศึกษาโดยไม่รายงานประสิทธิภาพ LLM หรือผล benchmark แทนงานต้นฉบับ
ใส่ความเห็น