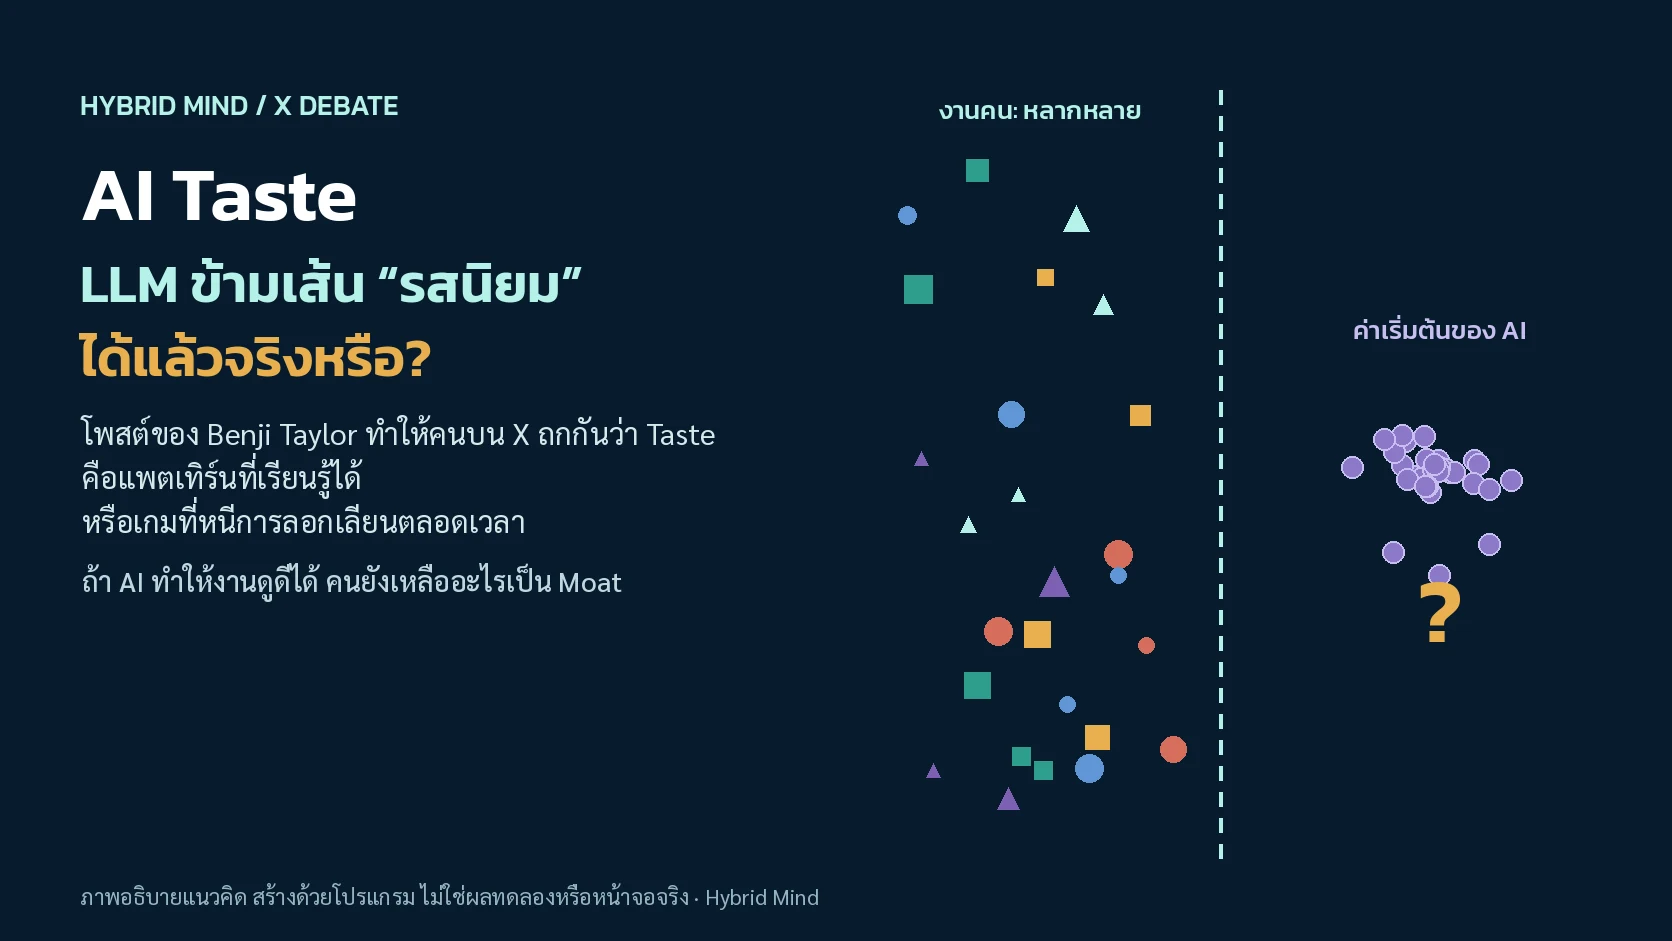
Quick Answer: LLM ข้ามเส้น “Taste” ได้แล้วจริงไหม
ยังตอบไม่ได้ เพราะคนบน X ใช้คำว่า Taste ในความหมายต่างกัน วันที่ 13 ต.ค. 2026 Benji Taylor หัวหน้าฝ่ายออกแบบของ X โพสต์ว่าเขา “ไม่เห็นเหตุผลอีกแล้ว” ที่จะเชื่อว่า Taste เป็นเส้นถาวรที่ LLM ข้ามไม่ได้ และบอกว่า “มันเกิดขึ้นแล้ว” โพสต์นี้ได้ราว 7.8K likes และ Elon Musk รีโพสต์ วงถกจึงขยายไปเร็ว
ถ้า Taste หมายถึงการจดจำว่างานแบบไหนดูดี หลายคนเห็นว่า AI ทำได้มากขึ้นเรื่อย ๆ แต่ถ้าหมายถึงการเป็นคนแรกที่เลือกสิ่งที่คนอื่นยังไม่ทำ งานวิจัยกลับพบว่าโมเดลมักตอบคล้ายกัน และงานที่ใช้ไอเดียจาก AI ก็คล้ายกันมากขึ้น ข้อเสนอที่ฟังมีน้ำหนักที่สุดในเธรดคือ Moat อาจย้ายจาก “ทำให้สวย” ไปเป็น “รู้ว่าควรทำอะไร เพื่อใคร และกล้ารับผลของการตัดสินใจนั้น”

เกิดอะไรขึ้น: ประโยคเดียวจากหัวหน้าฝ่ายออกแบบของ X
วันที่ 13 ต.ค. 2026 เวลา 23:08 น. ตามเวลาไทย Benji Taylor (@benjitaylor) ซึ่งระบุในโปรไฟล์ว่าเป็น head of design ของ X และ SpaceX SI และมีผู้ติดตามราว 226K โพสต์ข้อความสั้น ๆ สองประโยค
“I no longer see any compelling reason to believe that taste is some permanent boundary LLMs won’t cross. It’s already happening.” — @benjitaylor
โพสต์นี้ไม่ได้ยกตัวอย่างหรือหลักฐานประกอบ แต่ไปแตะความเชื่อที่คนในวงการออกแบบและสตาร์ตอัปพูดกันบ่อยในช่วงหลัง ว่าเมื่อ AI เขียนโค้ดและสร้างหน้าเว็บได้แล้ว สิ่งที่คนยังเหลือคือ “taste” หลังโพสต์ราว 5 ชั่วโมงครึ่ง Elon Musk รีโพสต์โดยไม่ได้เขียนอะไรเพิ่ม เราจึงสรุปไม่ได้ว่าเขาเห็นด้วยแค่ไหน
คำโต้แย้งที่ได้รับความสนใจมากที่สุดมาจาก Julian Lehr Creative Director ของ Linear (1,540 likes) ซึ่งบอกว่า Taste เป็น “เป้าเคลื่อนที่” วันต่อมา Hassan Rahim คนทำงานสายสร้างสรรค์ (848 likes) ถามกลับว่ากระแสถกเรื่อง Taste นี้มาจากไหนกันแน่ ทำให้วงถกขยายจากคนสาย AI และ Tech ไปถึงคนในวงการสร้างสรรค์

จำนวนโพสต์ต่อวัน (UTC) ตามคำค้นโฟกัส ไม่รวมรีโพสต์ ใช้คำว่า taste คู่กับ LLM, LLMs หรือ AI และคำอย่าง moat, boundary, good taste, have taste หรือการกล่าวถึง Benji Taylor และ Julian Lehr
* วันที่ 15 ต.ค. นับถึง 15:00 UTC (22:00 น. ไทย) เท่านั้น ถ้านับรีโพสต์ด้วย ยอดวันที่ 13 และ 14 ต.ค. จะเป็น 367 และ 284 โพสต์ ตัวเลขนี้เป็นปริมาณการพูดถึง ไม่ใช่สัดส่วนของคนที่เห็นด้วยหรือไม่เห็นด้วย และคำค้นกว้างกว่านี้ปนโพสต์เรื่องรสชาติอาหารจนใช้ไม่ได้
หัวข้อนี้มีมาก่อนโพสต์ของ Benji Taylor แล้ว คำค้นเดียวกันมีโพสต์ราว 45–73 โพสต์ต่อวันในช่วง 9–12 ต.ค. แต่หลังโพสต์ของเขา ยอดเพิ่มเป็นราวสองเท่า และถ้านับรีโพสต์ด้วยจะเพิ่มขึ้นราวสี่เท่า ส่วนตัวเธรดเองมีโพสต์ 519 โพสต์ในวันแรก (13 ต.ค. UTC ซึ่งมีแค่ราว 8 ชั่วโมงหลังโพสต์) 271 โพสต์ในวันที่ 14 และลดเหลือ 45 โพสต์ในวันที่ 15 จนถึง 22:00 น. ไทย
X ถกอะไร: Taste คือแพตเทิร์นที่เรียนรู้ได้ หรือเกมที่หนีการลอกเลียนตลอดเวลา
คนจำนวนไม่น้อยในเธรดยอมรับว่างานออกแบบจาก AI ดีขึ้นจริง สิ่งที่เถียงกันคือความดีขึ้นนั้นนับเป็น Taste หรือไม่ และถ้านับ คนทำงานสร้างสรรค์จะเหลืออะไรเป็นจุดแข็ง จากโพสต์ที่เราอ่าน เราจัดความเห็นได้ 5 ฝั่ง การจัดกลุ่มนี้เป็นของ Hybrid Mind เอง และจำนวนโพสต์ในแต่ละฝั่งไม่ได้บอกว่าคนส่วนใหญ่บน X คิดอย่างไร

“ข้ามเส้นแล้ว เพราะ Taste คือแพตเทิร์นที่เรียนรู้ได้”
ตัวอย่าง: Benji Taylor, นักออกแบบที่เชื่อว่าสอน Taste ได้, คนที่ใช้ Opus 5.5 ทำงานออกแบบ
- @aliszu เจ้าของสตูดิโอออกแบบผลิตภัณฑ์ ชี้ว่านักออกแบบและคนขายคอร์สออกแบบชอบพูดว่า Taste ฝึกได้ แล้วเขียนว่า “if it can be learned, it can be defined … so why do we assume AI can’t learn it?”
- บางคนไปไกลกว่านั้น ผู้ใช้รายหนึ่งแย้งว่า Taste ไม่ใช่เวทมนตร์ แต่เป็นกระบวนการทางความคิดที่ย่อลงเป็นการจดจำแพตเทิร์นได้ อีกบัญชีหนึ่งมองว่าการที่โมเดลยังไม่มี Taste เป็นปัญหาเรื่องข้อมูลมากกว่าความสามารถ
- มีผู้ใช้ที่ตอบใต้โพสต์ว่าทึ่งที่ Opus 5.5 ตัดสินใจเรื่องดีไซน์เองโดยไม่ได้สั่ง และออกมาดีกว่าที่เขานึกไว้ ข้อนี้เป็นประสบการณ์ส่วนตัว เราไม่ได้ตรวจงานชิ้นนั้น
- Ashni (@ashnichrist) เห็นด้วยว่า “taste is no longer a moat” เพราะ AI เป็น “virtual copy machine” และเสนอว่าแบรนด์ควรหันไปสร้างสิ่งที่ลอกยาก เช่น ประวัติและมุมมองของตัวเอง หรือกิจกรรมในโลกจริง
“Taste เป็นเป้าเคลื่อนที่ พอลอกได้ง่ายก็หมดความเป็น Taste”
ตัวอย่าง: Julian Lehr, คนที่ชี้ว่าเว็บจาก AI เริ่มหน้าตาเหมือนกัน, นักออกแบบที่มองเรื่องวัฒนธรรม
“Not only is taste subjective, it’s a moving target. As soon as [tasteful thing] becomes easily replicable, it stops being tasteful. Taste is a status game with a strong defensibility mechanism … Vagueness is the whole point. It’s meant to be hard to copy.” — Julian Lehr
- @LLMJunky ยกตัวอย่างว่าตอน Opus 4.5 ออกมา เว็บที่มันทำดูดีมาก แต่ตอนนี้ “all those websites look like absolute slop” เพราะ Taste ของคนเปลี่ยนไป และพอทุกคนใช้โมเดลเดียวกัน เราก็เห็นงานแบบเดิมจนเบื่อ ถึงอย่างนั้นเขาก็ยอมรับว่าโมเดลรุ่นใหม่เก่งมาก
- ผู้ใช้รายหนึ่งเขียนว่า AI เรียนจากสิ่งที่ถูกสร้างไปแล้ว จึง “always catching up” และยิ่งงาน AI ล้นโลกมากเท่าไร หน้าตาแบบนั้นก็ยิ่งหมดความเท่เร็วขึ้น อีกคนสรุปสั้นกว่าว่าคุณค่าของ Taste อยู่ที่ความหายาก
- มีคนยกตัวอย่างเว็บโทนม่วงที่เคยฮิต แล้วกลายเป็นสัญลักษณ์ของงาน AI แบบ slop เมื่อเว็บทั้งหมดเริ่มหน้าตาเหมือนกัน อีกคนเทียบกับฟอนต์ Times New Roman ที่เคยดูดีในงานพิมพ์ข่าว แต่พอเป็นค่าเริ่มต้นของ MS Word คนกลับมองว่าเป็นงานที่ไม่ได้ใส่ใจ
“Taste ต้องมีตัวตนและอยู่กับปัจจุบัน AI ทำได้แค่เลียนแบบ”
ตัวอย่าง: คนที่แยก “จดจำ” ออกจาก “สร้าง”, คนที่มองว่า Taste คือการอ่านวัฒนธรรมแบบเรียลไทม์
- ผู้ใช้รายหนึ่งตอบ Musk และ Benji Taylorว่า “Taste as recognition can be learned. Taste as CREATION cannot.” เพราะ LLM บอกได้ว่าอะไรเคยสวย แต่ไม่ได้รู้สึกกับความสวยนั้น
- อีกคนเขียนยาวว่า Taste ไม่ใช่สิ่งลึกลับในจิตวิญญาณ แต่เป็น “real-time filter” ที่ตัดสินว่าอะไรจะโดนใจคนที่ใช่ในเวลาที่ใช่ ขณะที่ความรู้ของ LLM มักช้ากว่าโลกจริงหลายสัปดาห์หรือหลายเดือน เขายังยอมรับว่า LLM อาจมี Taste ได้ แต่ต้องผ่านเกณฑ์ที่สูงมาก
- @LLMJunky ตอบต่อในเธรดว่าโมเดลเก่งเรื่องการประมาณ แต่สไตล์ที่ใช้วันนี้จะกลายเป็นของจืดในวันหน้า และการลอกงานตัวอย่างไม่ใช่ Taste
“ทำไมวงการ Tech ถึงอยากแก้โจทย์ Taste นัก”
ตัวอย่าง: คนทำงานสายสร้างสรรค์, นักออกแบบที่สงสัยว่าใครได้ประโยชน์จากวงถกนี้
- Hassan Rahim ถามว่า “what is the whole discourse around ‘taste’ right now?” เขาบอกว่าในวงการสร้างสรรค์ Taste เป็นพื้นฐานที่ไม่ค่อยมีใครพูดถึง เพราะถ้าไม่มีก็คงไม่ได้อยู่ในห้องนั้น แล้วถามต่อว่ากระแสนี้เกิดขึ้นเพราะ “engineers who are trying to ‘solve’ creativity” หรือเปล่า และถามด้วยว่า moat คืออะไร
- นักออกแบบอีกคนตอบใต้โพสต์นี้โดยเปรียบว่าเหมือนการพยายามถอดสูตรการจีบสาว คนไล่ตาม “สัญลักษณ์” ของ Taste เช่น ใส่เสื้อแบบหนึ่งหรือใช้ฟอนต์ที่กำลังฮิต โดยไม่เข้าใจว่าทำไมมันถึงเท่
- บางคำตอบหันไปตั้งคำถามกับผู้พูด ผู้ใช้รายหนึ่งมองว่าคนที่ได้ประโยชน์จากการให้คนใช้ LLM มากขึ้นเท่านั้นที่จะพูดแบบนี้ ข้อนี้เป็นการตั้งคำถามเรื่องผลประโยชน์ ไม่ใช่หลักฐานว่าข้อความของ Benji Taylor ผิด
“Moat ไม่ได้หายไป แค่ย้ายไปที่ Judgment, Context และความรับผิดชอบ”
ตัวอย่าง: นักพัฒนาที่ใช้ Agent ทุกวัน, คนที่มองว่าสิ่งที่ลอกยากคือบริบทของผู้ใช้
- ผู้ใช้รายหนึ่งเขียนว่า LLM ข้ามเส้น Taste ไปตั้งแต่วันที่เรานิยาม Taste ว่าเป็นความเนี้ยบ แต่เส้นจริงคือผลที่ตามมา เพราะ “an agent can have taste, but it can’t take the hit for bad taste.”
- อีกคนบอกว่าเคยรีวิวงานจาก AI ที่มี Taste ดีกว่าโค้ดของตัวเอง และ Moat ตอนนี้คือ “judgment about when to ship” อีกคนเขียนว่า “Taste was never the moat. Context is.” พร้อมยกตัวอย่างว่า AI ทำแดชบอร์ดให้สวยได้ แต่ไม่รู้จักเจ้าของร้านโชห่วยที่จะใช้งานจริง
- ผู้ใช้อีกรายอธิบายว่า LLM ให้คำตอบที่น่าจะเป็นที่สุด ถ้าธุรกิจสองเจ้าใช้โจทย์เดียวกันก็จะได้งานคล้ายกัน คนจึงต้องใช้ Judgment เพื่อแหกจากคำตอบที่ชัดเกินไป ฝั่งเครื่องมือก็มีบัญชีใหญ่โปรโมตชุด agent skills ที่อ้างว่าช่วยพา Claude Code, Codex และ Cursor ออกจากหน้า landing page แบบ AI ทั่วไป เราไม่ได้ตรวจตัวเลขดาวบน GitHub ที่โพสต์อ้าง
ทำไมเถียงกันไม่จบ: คนในเธรดใช้คำว่า Taste คนละความหมาย
ถ้าอ่านโพสต์ทั้งหมดอีกรอบ จะเห็นว่าหลายคนไม่ได้เถียงเรื่องเดียวกัน คนที่บอกว่า AI ข้ามเส้นแล้วมักหมายถึงความสามารถในการทำงานให้ “ดูดี” ส่วนคนที่ค้านมักหมายถึงความสามารถในการเลือกสิ่งที่ยังไม่มีใครทำ หรือสิ่งที่เหมาะกับคนกลุ่มหนึ่งในเวลาหนึ่ง เราสรุปนิยามที่พบบ่อยได้ 4 แบบ
รู้ว่าระยะห่าง ฟอนต์ และสีแบบไหนที่คนในวงการมองว่าดี นิยามนี้คือสิ่งที่ฝั่ง 01 หมายถึง และเป็นสิ่งที่โมเดลเรียนจากข้อมูลได้
สิ่งที่นับว่า “มีรสนิยม” คือสิ่งที่ยังหายาก นิยามนี้ตรงกับ Julian Lehr และแนวคิดเก่าทางสังคมวิทยา เช่น งานของ Bourdieu และ Simmel ที่มองว่ารสนิยมและแฟชั่นใช้แบ่งกลุ่มคน
การรู้สึกกับงานและตั้งใจสื่อสารกับคนดู นิยามนี้ทดสอบยากที่สุด เพราะต้องตอบคำถามเชิงปรัชญาว่า AI “รู้สึก” ได้หรือไม่
เลือกว่าจะทำอะไร ไม่ทำอะไร ส่งงานเมื่อไร และรับผิดชอบเมื่อเลือกผิด นิยามนี้คือที่มาของฝั่ง 05

เมื่อแยกนิยามแบบนี้ ข้อความของ Benji Taylor และของ Julian Lehr อาจถูกทั้งคู่ AI อาจทำงานที่คนส่วนใหญ่มองว่า “ดูดี” ได้แล้ว ขณะเดียวกัน พอทุกคนทำงานแบบนั้นได้ง่าย งานแบบนั้นก็อาจไม่ถูกนับว่ามีรสนิยมอีก ทดลอง 01 และ 02 ด้านล่างจำลองสองด้านนี้
ลองเอง: ความ “เหมือนกันหมด” เกิดขึ้นได้อย่างไร และสไตล์หนึ่งเท่อยู่ได้นานแค่ไหน
ข้อโต้แย้งของฝั่ง 02 มีสองส่วน ส่วนแรกคือถ้าคนจำนวนมากใช้โมเดลเดียวกันด้วยโจทย์คล้ายกัน งานจะออกมาคล้ายกัน ส่วนที่สองคือพอลอกได้เร็ว สไตล์ใหม่จะหมดความหายากเร็วขึ้น สองทดลองนี้ใช้สมมติฐานอย่างง่ายเพื่อให้เห็นกลไก ตัวเลขทั้งหมดเป็นค่าสมมติ
ทดลอง 01 — ถ้าทุกคนใช้ค่าเริ่มต้นของ AI แบบเดียวกัน ตลาดจะเหลือความหลากหลายเท่าไร
การจำลองเชิงการศึกษา ไม่ใช่ผลทดลองจริง · สมมติว่ามีแบรนด์ 60 แบรนด์ทำหน้าเว็บใหม่ แต่ละจุดในกราฟคือ “สไตล์” ของหนึ่งแบรนด์ แบรนด์ที่ใช้ค่าเริ่มต้นของ AI จะได้งานที่กระจุกอยู่ใกล้ “หน้าตามาตรฐานของโมเดล” ส่วนแบรนด์ที่ใส่ reference และข้อจำกัดของตัวเองจะกระจายออกไปมากกว่า
ปรับค่าด้านบนเพื่อดูผล
วิธีคำนวณ: แบรนด์ที่ใช้ค่าเริ่มต้นจะสุ่มตำแหน่งรอบจุดกลางด้วยการกระจายที่แคบ และกว้างขึ้นตามระดับ reference ส่วนแบรนด์อื่นสุ่มทั่วพื้นที่ ดัชนีความหลากหลายคือระยะห่างเฉลี่ยระหว่างทุกคู่ เทียบกับกรณีที่ทุกแบรนด์สุ่มทั่วพื้นที่ (100) “หน้าตาใกล้กัน” คือมีแบรนด์อื่นอยู่ห่างไม่ถึง 2% ของความกว้างกราฟ ส่วน “โดดออกจากกลุ่ม” คือแบรนด์ที่ใกล้ที่สุดอยู่ห่างเกิน 8% ตัวเลขนี้ใช้อธิบายกลไก ไม่ได้วัดตลาดจริง

ทดลอง 02 — สไตล์ใหม่หนึ่งแบบจะ “หายาก” อยู่ได้กี่เดือน ก่อนกลายเป็นของเกร่อ
การจำลองเชิงการศึกษา ไม่ใช่ผลทดลองจริง · สมมติว่านักออกแบบคนหนึ่งคิดสไตล์ใหม่ขึ้นมา ช่วงแรกมีแค่คนไม่กี่คนที่ทำได้ เมื่อเครื่องมือเลียนแบบได้ คนจะเริ่มใช้ตามแบบโค้ง S ทดลองนี้นับว่ากี่เดือนกว่าสไตล์นั้นจะถูกใช้ถึงระดับที่คนเริ่มมองว่า “เห็นจนเบื่อ” ตามแนวคิดของ Julian Lehr
ปรับค่าด้านบนเพื่อดูผล
วิธีคำนวณ: หลังเครื่องมือลอกได้ สัดส่วนผู้ใช้เริ่มที่ 1% แล้วเพิ่มตามสูตรโค้ง S (สัดส่วนใหม่ = สัดส่วนเดิม + อัตรา × สัดส่วนเดิม × ส่วนที่ยังไม่ใช้) จนถึงจุดที่คนเริ่มเบื่อ แถบเทียบใช้เวลาลอก 24 เดือนและอัตรา 10% ทุกค่าเป็นสมมติฐาน ไม่ได้มาจากข้อมูลจริงของสไตล์ใด
หลักฐานบอกอะไร: งานวิจัยวัดเรื่อง “ความเหมือน” ได้ แต่ยังวัด “Taste” ตรง ๆ ไม่ได้
ไม่มีงานวิจัยไหนตอบได้ตรง ๆ ว่า LLM “มี Taste” หรือไม่ เพราะยังไม่มีนิยามที่วัดได้ร่วมกัน แต่มีงานที่เกี่ยวข้องกับข้อโต้แย้งของฝั่ง 02 โดยตรง คืองานที่วัดว่าผลลัพธ์จาก AI คล้ายกันมากแค่ไหน และการใช้ AI ทำให้งานของคนคล้ายกันมากขึ้นหรือไม่
| ข้อกล่าวอ้าง | สถานะ | หลักฐาน |
|---|---|---|
| ไอเดียจาก AI ทำให้งานแต่ละชิ้นดีขึ้น แต่ทำให้งานโดยรวมคล้ายกันมากขึ้น | ยืนยันแล้ว (ในการทดลองหนึ่ง) | Doshi และ Hauser (2024) ใน Science Advances ให้นักเขียน 293 คนเขียนเรื่องสั้น และให้ผู้ประเมิน 600 คนให้คะแนน กลุ่มที่ได้ไอเดียจาก GPT-4 ห้าข้อได้คะแนนความแปลกใหม่สูงขึ้น 8.1% และคะแนนความมีประโยชน์ (usefulness) สูงขึ้น 9.0% แต่เรื่องที่ได้คล้ายกันมากกว่ากลุ่มที่เขียนเอง ผู้วิจัยเรียกว่าเป็นทางแยกระหว่างประโยชน์ของแต่ละคนกับความแปลกใหม่ของส่วนรวม |
| LLM ต่างยี่ห้อกันมักตอบโจทย์ปลายเปิดคล้ายกัน | ยืนยันแล้ว (preprint) | Jiang และคณะ “Artificial Hivemind” ทดสอบด้วยคำถามปลายเปิดจากชุด Infinity-Chat ที่มี 26K คำถาม พบว่าโมเดลเดียวกันตอบซ้ำจนค่าความคล้ายเฉลี่ยเกิน 0.8 ใน 79% ของกรณี และโมเดลต่างค่ายมีความคล้ายกัน 71–82% เมื่อให้เขียนอุปมาเรื่องเวลา คำตอบกระจุกอยู่แค่ “เวลาคือแม่น้ำ” กับ “เวลาคือช่างทอ” งานนี้ยังพบว่าโมเดลและตัวให้คะแนนอัตโนมัติประเมินได้แย่ลงในโจทย์ที่คนแต่ละคนชอบต่างกัน |
| การปรับโมเดลด้วย RLHF ลดความหลากหลายของคำตอบ | ยืนยันแล้ว (preprint) | Kirk และคณะ (2023) พบว่า RLHF ช่วยให้โมเดลรับมือกับโจทย์ใหม่ได้ดีกว่า SFT แต่ลดความหลากหลายของคำตอบลงอย่างชัดเจน |
| คนที่ใช้ ChatGPT ช่วยคิดไอเดียได้ไอเดียที่คล้ายกับคนอื่นมากขึ้น | ยืนยันแล้ว (กลุ่มตัวอย่างเล็ก) | Anderson, Shah และ Kreminski (C&C 2024) ทดลองกับผู้เข้าร่วม 36 คน กลุ่มที่ใช้ ChatGPT ได้ไอเดียที่ต่างกันน้อยกว่าเมื่อเทียบข้ามผู้ใช้ และรู้สึกเป็นเจ้าของไอเดียน้อยลง |
| Taste เป็นเครื่องมือแบ่งสถานะทางสังคม และเปลี่ยนเมื่อคนหมู่มากตามทัน | เป็นทฤษฎี ไม่ได้ทดสอบกับ AI | แนวคิดคลาสสิกของ Pierre Bourdieu ในหนังสือ Distinction (1979) และบทความเรื่องแฟชั่นของ Georg Simmel (1904) สนับสนุนกรอบคิดของ Julian Lehr แต่เป็นทฤษฎีทางสังคมวิทยา ไม่ใช่ผลวัดเรื่อง LLM |
| LLM “มี Taste แล้ว” หรือ “จะไม่มีวันมี” | ยังไม่พิสูจน์ | โพสต์ต้นเรื่องไม่ได้ให้หลักฐาน และฝั่งค้านก็ยังไม่มีหลักฐานว่าเป็นไปไม่ได้ ทั้งสองฝั่งขึ้นกับว่านิยาม Taste แบบไหน |
| Opus 5.5 หรือเครื่องมือออกแบบบางตัวมี Taste ดีกว่าคน | ยังไม่ยืนยัน | เป็นประสบการณ์รายคนในโพสต์ เราไม่ได้ทดสอบ และไม่ได้ตรวจยอดดาวบน GitHub ของชุด skills ที่ถูกโปรโมตในเธรด |

ข้อควรระวัง: งานวิจัยเหล่านี้วัดความคล้ายของข้อความและไอเดีย ไม่ได้วัดงานออกแบบภาพหรือหน้าเว็บ และงานส่วนใหญ่ทดสอบโมเดลรุ่นก่อนรุ่นที่คนในเธรดพูดถึง จึงใช้สนับสนุนกลไกว่า “ใช้เครื่องมือเดียวกันแล้วงานคล้ายกัน” ได้ แต่ใช้ตัดสินว่าโมเดลรุ่นล่าสุดมีหรือไม่มี Taste ไม่ได้
ถ้า AI ทำงานให้ “ดูดี” ได้ คนยังเหลืออะไร
ฝั่งที่เห็นต่างกันมากในเธรดกลับมีจุดร่วมอยู่ข้อหนึ่ง คือทั้งคนที่บอกว่า AI ข้ามเส้นแล้วและคนที่ค้าน ต่างยอมรับว่าการทำงานให้เนี้ยบตามมาตรฐานของยุคนี้กำลังกลายเป็นของที่ใครก็เข้าถึงได้ สิ่งที่ยังไม่มีใครบอกว่า AI ทำแทนได้ดี คือส่วนที่อยู่รอบ ๆ ตัวงาน

ข้อนี้สอดคล้องกับงานของ Doshi และ Hauser ที่พบว่า AI ช่วยคนที่เริ่มต้นจากความคิดสร้างสรรค์น้อยได้มากกว่า แต่ไม่ได้ช่วยดันงานที่ดีที่สุดให้ดีขึ้นอย่างชัดเจน ถ้าเป็นแบบนั้นจริง ระดับพื้นฐานของงานจะสูงขึ้น และความต่างจะไปอยู่ที่การเลือกว่าจะแหกจากพื้นฐานนั้นไปทางไหน ซึ่งเป็นสิ่งที่ฝั่ง 05 เรียกว่า Judgment หรือ Context แต่ข้อนี้ยังเป็นการตีความจากหลักฐานบางส่วน ยังไม่มีงานไหนพิสูจน์ในงานออกแบบจริง
ทดลอง 03 — เขียน Brief ที่บังคับให้ AI ออกจากหน้าตามาตรฐาน
การจำลองเชิงการศึกษา ไม่ใช่ผลทดลองจริง · เลือกสิ่งที่คุณจะใส่ใน brief ก่อนให้ AI ช่วยออกแบบ เครื่องมือนี้จะประกอบ brief ให้ และบอกว่าส่วนไหนยังเปิดช่องให้ AI กลับไปใช้ค่าเริ่มต้น คะแนนเป็นเพียงตัวช่วยคิด ไม่ได้รับประกันว่างานจะมี Taste
เลือกตัวเลือกด้านบนเพื่อดูผล
ใครควรทำอะไรหลังวงถกนี้
นักออกแบบและครีเอทีฟ
อย่าใช้ “ฉันมี Taste” เป็นจุดขายลอย ๆ ให้แสดงเหตุผลเบื้องหลังการเลือก เช่น ทำไมตัดแบบนี้ทิ้ง และทำไมแบบนี้เหมาะกับลูกค้าคนนี้ ถ้าหน้าตางานของเราเหมือนผลลัพธ์แรกที่ AI ให้ ลูกค้าก็มีเหตุผลน้อยลงที่จะจ้างเรา
นักพัฒนาที่ใช้ Agent ทำ UI
ค่าเริ่มต้นของโมเดลคือสิ่งที่ผู้ใช้หลายคนจะเห็นซ้ำในงานอื่น ใส่ design system ของตัวเอง ข้อห้าม และ reference ไว้ใน brief หรือไฟล์กฎของโปรเจกต์ แล้วให้คนที่เข้าใจผู้ใช้ตัดสินรอบสุดท้าย
ผู้ก่อตั้งและแบรนด์
ถ้าคู่แข่งใช้เครื่องมือเดียวกัน หน้าตาที่ “สวยมาตรฐาน” จะไม่ได้ทำให้ต่าง สิ่งที่ลอกยากกว่าคือข้อมูลลูกค้า เรื่องราวของแบรนด์ และการตัดสินใจที่สม่ำเสมอ ซึ่งตรงกับที่ Ashni และฝั่ง 05 เสนอ
ผู้อ่านทั่วไปและผู้บริโภค
เมื่อเห็นใครบอกว่า AI “มี Taste แล้ว” หรือ “ไม่มีวันมี” ให้ถามกลับว่าหมายถึง Taste แบบไหน และมีหลักฐานอะไร ข้อความบน X ส่วนใหญ่ในวงถกนี้เป็นความเห็นจากประสบการณ์ ไม่ใช่ผลการทดสอบ

อ่านต่อบน Hybrid Mind
- Knightama Little Mermaid AI Pencil Test: X ถก bias ตัดสินงาน หรือแค่พิสูจน์ว่าคนถูกหลอกได้? ว่าด้วยการที่คนตัดสินงานศิลปะต่างกันเมื่อรู้ว่าเป็นงาน AI
- Multi-Agent Voting: ทำไมเสียงข้างมากยังผิดได้ เมื่อ AI Agent ผิดแบบเดียวกัน อีกมุมของปัญหาเมื่อโมเดลคิดเหมือนกัน
- Lauren Tan “Writing Is Thinking”: X ถกควรเขียนเองทุกคำ หรือให้ AI ช่วยได้แค่ไหน เมื่อการให้ AI ทำแทนอาจกินความคิดของเราเอง
- Vibe Coding เกษียณ?: X ถกว่าควรเรียก Precision Engineering หรือแค่เปลี่ยนชื่อ วงถกเรื่องบทบาทของคนเมื่อ AI เขียนโค้ดได้
- Caine Prize AI Detector: X ถกธงจาก Pangram เป็นหลักฐานหรือการล่าแม่มด? เมื่อวงการสร้างสรรค์พยายามแยกงานคนออกจากงาน AI
คำถามที่พบบ่อย
1. Benji Taylor พูดว่าอะไร และเป็นใคร?
Benji Taylor ระบุในโปรไฟล์ X ว่าเป็น head of design ของ X และ SpaceX SI วันที่ 13 ต.ค. 2026 เขาโพสต์ว่าไม่เห็นเหตุผลที่น่าเชื่ออีกแล้วว่า Taste เป็นเส้นถาวรที่ LLM ข้ามไม่ได้ และบอกว่ามันเกิดขึ้นแล้ว โพสต์นี้ไม่ได้ยกตัวอย่างหรือหลักฐานประกอบ
2. Elon Musk เห็นด้วยกับโพสต์นี้ไหม?
เรายืนยันได้แค่ว่า Elon Musk รีโพสต์โพสต์นี้ในวันที่ 14 ต.ค. เวลาราว 04:39 น. ไทย โดยไม่ได้เขียนความเห็นเพิ่ม การรีโพสต์ไม่ได้แปลว่าเห็นด้วยทุกข้อเสมอไป จึงไม่ควรสรุปจุดยืนของเขาจากตรงนี้
3. มีงานวิจัยพิสูจน์ไหมว่า AI มีหรือไม่มี Taste?
ยังไม่มี เพราะยังไม่มีนิยาม Taste ที่วัดได้ร่วมกัน สิ่งที่มีหลักฐานคือ LLM มักตอบโจทย์ปลายเปิดคล้ายกัน และงานที่ใช้ไอเดียจาก AI มีแนวโน้มคล้ายกันมากขึ้น ข้อนี้สนับสนุนข้อโต้แย้งว่าความหายากของงานลดลง แต่ไม่ได้พิสูจน์ว่า AI ไม่มี Taste
4. “Taste เป็นเป้าเคลื่อนที่” หมายความว่าอะไร?
เป็นข้อโต้แย้งของ Julian Lehr ว่าเมื่อสิ่งที่ถูกมองว่ามีรสนิยมถูกลอกได้ง่าย มันจะหมดความเป็นรสนิยมไปเอง เพราะ Taste ทำหน้าที่แบ่งสถานะทางสังคมด้วย ตัวอย่างในเธรดคือเว็บโทนม่วงที่เคยฮิตแล้วกลายเป็นสัญลักษณ์ของงาน AI ทดลอง 02 จำลองกลไกนี้
5. นักออกแบบควรกังวลแค่ไหน?
ควรปรับตัวมากกว่ากังวล งานที่ทำตามมาตรฐานทั่วไปจะมีคู่แข่งเป็นเครื่องมือราคาถูกมากขึ้น แต่การเข้าใจผู้ใช้ การเลือกทิศทาง และการรับผิดชอบงาน ยังต้องใช้คน ความเห็นนี้มาจากวงถกและหลักฐานบางส่วน ไม่ใช่การคาดการณ์ตลาดแรงงาน
6. จะใช้ AI ช่วยออกแบบอย่างไรไม่ให้ได้งานหน้าตาเหมือนคนอื่น?
ใส่บริบทของผู้ใช้ reference ของตัวเอง ข้อห้าม และข้อจำกัดจริงลงใน brief ขอหลายแนวทางที่ต่างกัน แล้วให้คนตัดสินรอบสุดท้ายด้วยเกณฑ์ที่ชัด ลองประกอบ brief แบบนี้ได้ในทดลอง 03
เอกสารอ้างอิง
- โพสต์ต้นเรื่อง: @benjitaylor, 13 ต.ค. 2026 และการรีโพสต์ของ @elonmusk
- โพสต์ที่ถูกพูดถึงมาก: Julian Lehr, Hassan Rahim, @LLMJunky, Ashni, @aliszu
- Doshi, A. R., Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content, Science Advances 10, eadn5290
- Jiang, L. และคณะ (2025). Artificial Hivemind: The Open-Ended Homogeneity of Language Models (and Beyond), arXiv:2510.22954
- Kirk, R. และคณะ (2023). Understanding the Effects of RLHF on LLM Generalisation and Diversity, arXiv:2310.06452
- Anderson, B. R., Shah, J. H., Kreminski, M. (2024). Homogenization Effects of Large Language Models on Human Creative Ideation, Creativity and Cognition 2024
- Bourdieu, P. (1979). La Distinction: Critique sociale du jugement · Simmel, G. (1904). Fashion, International Quarterly (ใช้เป็นกรอบคิด ไม่ใช่หลักฐานเรื่อง AI)
ขอบเขตการตรวจ
Hybrid Mind อ่านโพสต์ไม่ซ้ำ 324 โพสต์ ผ่าน X API ซึ่งโพสต์ระหว่าง 13 ต.ค. 01:59 น. ถึง 15 ต.ค. 21:47 น. เวลาไทย ได้แก่คำตอบและ quote ของโพสต์ต้นเรื่อง คำตอบและ quote ของโพสต์ Julian Lehr และผลการค้นหาคำว่า taste คู่กับ LLM, AI, moat และ boundary ในจำนวนนี้มีรีโพสต์ 52 โพสต์ โพสต์ที่ไม่ใช่รีโพสต์ 272 โพสต์ และพูดถึงคำว่า taste ตรง ๆ 166 โพสต์ การจัดกลุ่ม 5 ฝั่งมาจากการอ่านของเรา ไม่ใช่สัดส่วนความเห็นของคนทั้งหมดบน X
ยอด likes, replies, quotes และ impressions เป็นค่าที่อ่านราว 22:00 น. วันที่ 15 ต.ค. 2026 เวลาไทย และยังเปลี่ยนได้ จำนวนโพสต์ต่อวันมาจาก X Recent Counts ที่เรานับเอง เราอ่านบทคัดย่อและหน้าเผยแพร่ของงานวิจัยทั้งสี่ชิ้น แต่ไม่ได้ทำซ้ำการทดลองหรือวิเคราะห์ข้อมูลดิบ เราไม่ได้ทดสอบ Opus 5.5 หรือชุด agent skills ที่มีคนโปรโมต ไม่ได้ตรวจยอดดาวบน GitHub ที่โพสต์อ้าง และไม่ได้ตรวจว่าการรีโพสต์ของ Elon Musk หมายถึงการเห็นด้วยหรือไม่ บัญชีขนาดเล็กเราเลือกสรุปความแทนการระบุชื่อ
ใส่ความเห็น