
Executive Answer — B ต้องเกิดจำกัดครั้งทั้งชุด
คำตอบสั้น: ภายใต้ fairness assumption A/B action ใน A จะถูกถือว่า fair ณ recurrent state เมื่อมี assumption อย่างน้อยหนึ่งคู่ที่ครอบคลุม action นั้น และ ทุก action ใน B ของคู่นั้นเกิดเพียงจำนวนจำกัดครั้งตลอด trajectory ถ้ามี action ใน B แม้เพียงตัวเดียวเกิดซ้ำไม่สิ้นสุด assumption คู่นั้นจะปิด แต่คู่อื่นที่ยังเปิดอาจทำให้ action เดิม fair ได้
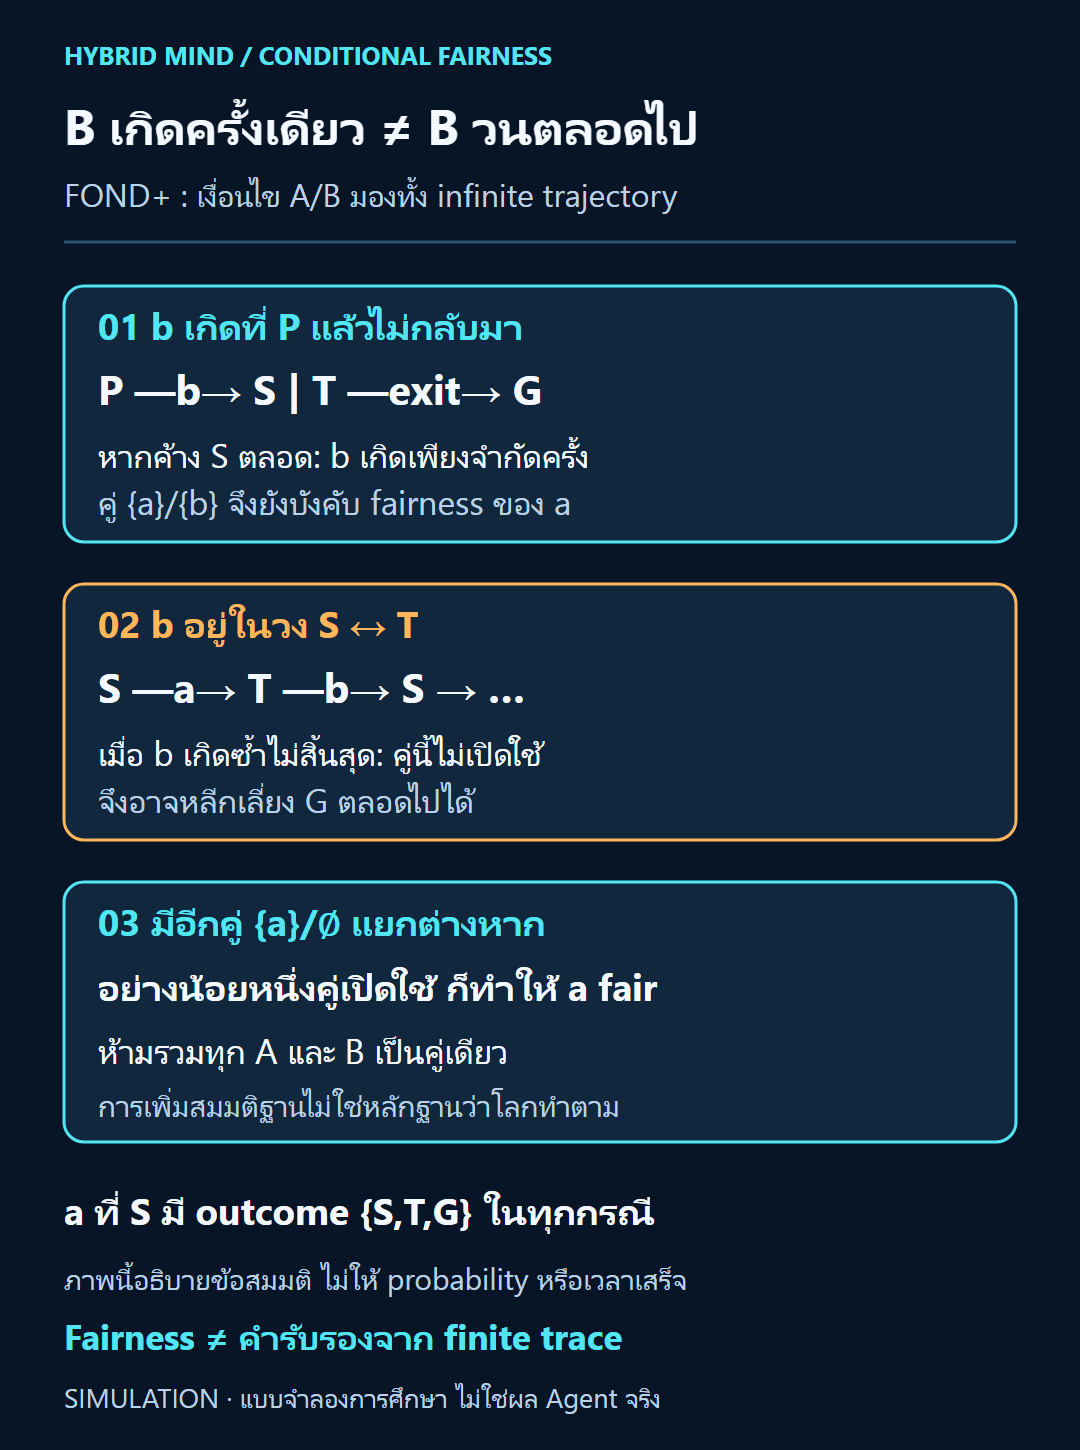
FACT: JAIR นิยาม conditional fairness แบบ trajectory-relative ไว้ใน Definitions 7–11 บทความฉบับตีพิมพ์ โมเดลตัวอย่างเริ่ม P:b แล้วไป S ซึ่งเลือก a และมีผลลัพธ์ S, T หรือ G ภายใต้ {a}/{b}, b ที่ P ซึ่งเกิดในช่วงต้นเพียงครั้งไม่ปิดคู่นี้ ถ้า S วนตัวเอง a ยัง fair และการข้าม T กับ G ตลอดทำให้ trace นั้นไม่ fair แต่ถ้า policy ที่ T เลือก b แล้ววงวน S→T→S ทำให้ b เกิดไม่สิ้นสุด คู่นี้ปิด และวงวนที่หลบ G อาจเป็น fair counterexample
บทความนี้อธิบาย semantics ที่ตีพิมพ์ด้วย checker ขนาดเล็กบนแบบจำลองคงที่ ไม่ได้เสนอ semantics หรือ planner ใหม่
Why It Matters — แยก trace ที่เห็นออกจาก assumption
action ที่ดูเหมือน retry อาจเกิดครั้งเดียวในช่วงต้นหรือกลับมาอยู่ในวงวนไม่สิ้นสุด สองกรณีนี้ดูคล้ายกันจาก log สั้น ๆ แต่มีผลต่างกันต่อ A/B เพราะ condition ดูการเกิดของ B บน trajectory อนันต์ ไม่ใช่ถามเพียงว่าเคยเห็น B หรือไม่
สำหรับ agent คำว่า memory ใช้กับคนละชั้นได้อย่างน้อยสี่แบบ: ข้อความใน context window ปัจจุบัน, context ที่ดึงกลับมาให้รอบนี้, external memory เช่นไฟล์หรือฐานข้อมูล และการเปลี่ยน weight จากการฝึก Trace และผลจาก tool เป็นข้อมูลสังเกตจากภายนอก อาจถูกเพิ่มเข้า context หรือเก็บเป็น external memory ได้ แต่ไม่ใช่ internal reasoning โดยตัวมันเองและไม่ใช่หลักฐานว่า weights เปลี่ยน
การเทียบ fairness กับ scheduler, API หรือ worker จึงเป็น HYPOTHESIS ที่ต้องผูกกับโมเดลและหลักฐานของระบบจริง การเห็น retry ใน trace ไม่พอพิสูจน์ว่า operation จะเกิดซ้ำหรือว่า B เกิดเพียงจำนวนจำกัด
ANALYSIS: บนระบบ finite state ที่มี policy คงที่ state จะ recurrent เมื่อปรากฏไม่สิ้นสุดครั้ง; action ที่เลือก ณ state นั้นก็เกิดซ้ำไม่สิ้นสุด การตรวจต้องดู recurrent behavior ไม่ใช่จำนวนครั้งในหน้าต่างสังเกตสั้น ๆ
Scientific Foundations — fairness เป็นเงื่อนไขของ trajectory
FACT: FOND คือ fully observable nondeterministic planning: model ระบุ state, initial state, goal, actions และ successor sets; policy เลือก action ในแต่ละ non-goal state โดยผลลัพธ์ยังอาจเลือกได้หลายแบบ Trajectory เดินตาม policy โดยเลือก successor ที่เป็นไปได้ในแต่ละก้าว
สำหรับ trajectory อนันต์ state ที่ปรากฏไม่สิ้นสุดครั้งเรียกว่า recurrent; state ที่ปรากฏเพียงจำนวนจำกัดครั้งบน trajectory นั้นเรียกว่า transient การอยู่ใน finite prefix ไม่ได้ทำให้ state transient โดยอัตโนมัติ เพราะ state เดิมอาจกลับมาเกิดซ้ำภายหลัง และ infinite fair run ไม่จำเป็นต้องเป็นวงวนซ้ำแบบ ultimately periodic ตัวอย่าง S,T ที่นี่เป็น lasso แบบ periodic เพื่อให้เห็นกลไกเท่านั้น
FOND+ เพิ่ม fairness assumptions Aᵢ/Bᵢ; Aᵢ เป็นชุด nondeterministic actions, Bᵢ เป็นชุด actions และสองชุดห้ามซ้ำกันภายในคู่เดียวกัน ที่ recurrent state s action π(s) fair เมื่อมีอย่างน้อยหนึ่งคู่ i ที่ π(s) อยู่ใน Aᵢ และ ทุก action ใน Bᵢ เกิดเพียงจำนวนจำกัดครั้งบน trajectory ทั้งเส้น
เมื่อ action ณ recurrent state fair แล้ว fair trajectory ต้องมี successor ทุกตัวที่ action นั้นทำได้ตามหลัง s ไม่สิ้นสุดครั้ง การข้าม outcome ใดตลอดทำให้ trace ไม่ fair ส่วน action ที่ไม่ fair ไม่มีข้อผูกมัดนี้และอาจเลือก outcome ที่วนต่อได้
condition B ไม่ได้จำกัดการเกิด action ที่ติดกันเป็นแถว และไม่ได้ต้องเป็นศูนย์ครั้ง: finite prefix อาจมี B จำนวนจำกัดครั้งได้ หาก action ใน B ตัวใดเกิดไม่สิ้นสุด คู่ Aᵢ/Bᵢ นั้นจะปิดสำหรับ trajectory นี้ แต่คู่ Aⱼ/Bⱼ อื่นยังเปิดอยู่ได้ จึงต้องตรวจแต่ละคู่แยกกัน และ action จะ fair หากมีคู่เปิดอย่างน้อยหนึ่งคู่ที่ครอบคลุมมัน
policy แก้ FOND+ เมื่อ maximal fair trajectories ทุกเส้นทางถึง goal; finite trajectory ที่จบ non-goal เพราะ dead end หรือไม่มี action ก็เป็นความล้มเหลว Fairness ไม่ได้ระบุความน่าจะเป็น retry count หรือ deadline
FACT: JAIR 2022 นำเสนอ SIEVE+ สำหรับ termination และเชื่อม FOND+ กับ QNP; Theorem 20 แสดง Dual FOND แบบ fixed action labels เป็น fragment ที่ B ว่าง Definitions 15–20 และ Theorems 16, 20 ตัวตรวจบทความนี้เป็น bounded recurrent-support checker สำหรับโมเดลคงที่ ไม่ได้อ้างว่าเป็น SIEVE+ หรือ FOND-ASP
Architecture — แยกโมเดลคงที่จาก input และผลตรวจ

กราฟประกอบมี state P, S, T และ goal G; initial คือ P action IDs เป็น global: b ที่ P และ b ที่ T เป็นชื่อ action เดียวกัน ส่วน a และ b เป็น globally nondeterministic จาก outcome ทั้งหมดใน model
| State | action | possible successors |
|---|---|---|
| P | b | S |
| P | start | S |
| S | a | S, T, G |
| S | seal | G |
| T | b | S, G |
| T | c | S |
| T | exit | G |
ตัว checker ใช้โมเดลอ่านอย่างเดียวนี้เป็นฐาน UI รับ input เพียง initial state, policy map และรายการ A/B constraints; ผู้ใช้เปลี่ยน graph, goal set หรือ action outcomes เองไม่ได้ สถานะและ outcomes มาจาก model module ไม่ได้เดาจาก trace ภายนอก
โครงสร้างการประมวลผลแบ่งเป็นห้าส่วน: (1) model module เก็บ states, goals, global action IDs และ transitions; (2) input รับ initial, mapping state→action และ array ของคู่ A/B; (3) validator ตรวจ state/action ที่รู้จัก, applicability, A มีเฉพาะ globally nondeterministic actions, B เป็น known actions และ A∩B ว่างในแต่ละคู่; (4) reachability walk คืน reachable states, policy edges และ missing choices แล้ว candidate scan คืน recurrent subsets, active pairs, fair nodes และ bad components; (5) verdict/render แสดง valid, closed, reachable, missing, badComponents และ guaranteed พร้อมเหตุผลต่อ candidate
Missing หรือ inapplicable choice ทำให้ตรวจพบปัญหาภายใน model นี้และไม่รับรอง guarantee แต่ checker ระบุไม่ได้ว่า model ละ outcome จริงไว้หรือไม่ ความครบถ้วนของ source model ต้องตรวจจากแหล่งภายนอก เช่น specification หรือผู้ดูแลระบบ
ในผัง π หมายถึง policy, π(c) คือ action ที่เลือก ณ state c, π(C) คือเซต actions ที่เลือกจาก states ใน C และ ∩ คือการหาสมาชิกที่อยู่ร่วมกันในสองเซต
สำหรับ candidate recurrent set C คู่ Aᵢ/Bᵢ เปิดเมื่อไม่มี action ที่ policy เลือกใน C อยู่ใน Bᵢ state ใน C fair เมื่อ action ที่เลือกอยู่ใน A ของคู่ที่เปิดอย่างน้อยหนึ่งคู่ state fair ต้องมี successor ทุกตัวใน C; state อื่นต้องมี successor อย่างน้อยหนึ่งตัวใน C และ C ต้อง strongly connected; singleton ต้องมี self-loop นี่เป็นเกณฑ์ของ bounded checker ที่แสดงเงื่อนไข trajectory ไม่ใช่การสังเคราะห์ policy
Operational Flow — เปลี่ยน B จาก prefix ให้เป็นวงวน

ใช้ policy P:b, S:a, T:exit และ assumption {a}/{b} เส้นทางเริ่มด้วย b ที่ P แล้วไป S หากเลือก S→S ซ้ำ recurrent support คือ {S}; ไม่มี b ใน support ทำให้ assumption ยังเปิด a จึง fair และต้องตามด้วย successor S, T และ G ไม่สิ้นสุด เส้นทางที่วน S→S โดยไม่ไป T หรือ G จึงไม่ใช่ fair counterexample
ถ้าเปลี่ยน policy ที่ T เป็น b วงวน S→T→S กลายเป็น candidate {S,T}: b เกิดซ้ำและปิด {a}/{b}; a ที่ S จึงไม่ fair ส่วน b ที่ T ไม่อยู่ใน A={a} และเลือกกลับ S ได้ วงวนนี้จึงเป็น fair infinite non-goal trajectory
ถ้า T เลือก c แทน b จะไม่มี b ใน support {S,T}; a ที่ S ยัง fair แต่มี successor G อยู่นอก support จึงไม่มีวงวนที่ทั้งหลบ goalและคง fair ไว้ ผลต่างมาจาก action ใน B อยู่ใน recurrent part หรือไม่
ก่อน enumerating support ตัวตรวจต้องยืนยันว่า policy เป็น stationary และ deterministic ตามอินพุต และ action ที่เลือกใช้ได้ใน state นั้น หากไม่ผ่านข้อกำหนดนี้ การนับ successor ตาม policy map จะไม่แทนความหมายของโจทย์เดิม ส่วน fairness pair ที่ A ว่างไม่ทำให้ action ใด fair; pair นั้นไม่มี action ที่จะเปิดใช้
สำหรับ frozen input นี้ A ต้องเลือกได้เฉพาะ global nondeterministic action a หรือ b; B เลือก action ID ที่รู้จักตัวใดก็ได้ และ A กับ B ห้ามซ้ำกันในคู่เดียวกัน นี่เป็น validation contract ของตัวอย่าง ไม่ใช่ข้อจำกัดจำนวน fairness pairs ของ FOND+ ทั้งหมด
Pseudocode (conceptual; simplified) — ตรวจ support ไม่ใช่จำนวน retry
Conceptual pseudocode only: ย่อขั้นตอนของ recurrent-support reasoning ให้เห็นหลักคิด; ละการตรวจ input และการจัดการ error บางส่วน ไม่ใช่ source code ของ planner หรือการอ้างว่า FOND-ASP/SIEVE+ ถูกทำซ้ำ
analyze(fixedModel, {initial, policy, constraints}):
    reachable, edges, missing = follow every selected outcome
    closed = missing is empty
    bad = []

    for each nonempty subset C of reachable non-goal states:
        require C strongly connected; singleton needs a self-loop
        selected = policy actions used in C
        active = pairs A/B where selected has no action in B
        fair[s] = policy[s] belongs to A of some active pair

        require every successor in C for each fair state
        require at least one successor in C for each other state
        if all requirements hold: add C to bad

    guaranteed = valid and closed and bad is empty
reachable ตาม outcome ทุกตัวของ action ที่ policy เลือก; C แทน recurrent support ของ trajectory อนันต์ active คำนวณจาก action ใน C ไม่ใช่ prefix fair[s] เป็นการจำแนกเฉพาะ candidate นั้น หากไม่ fair ต้องเหลือทางเลือกอย่างน้อยหนึ่งทางใน C เพื่อวนต่อ
SIMULATION: ตารางเปรียบเทียบห้า assumption/policy presets นี้แสดงผลตามนิยามบนกราฟที่กำหนด ไม่ใช่ผล benchmark ของ planner:
| Case | T | assumptions | ผลตามกราฟ |
|---|---|---|---|
| ไม่มี fairness | exit | ไม่มี | ไม่รับประกัน; S วนได้ |
| a/empty | exit | a fair เสมอ | รับประกัน |
| a/b | exit | a fair เมื่อ b เกิดจำกัดครั้ง | รับประกัน; b ที่ P เป็น prefix |
| a/b + a/empty | b | คู่หลังเปิดอยู่ | รับประกัน |
| a/b + b/a | b | mutual condition | ไม่รับประกัน; {S,T} |
ถ้ามี {a}/{b} และ {a}/empty พร้อมกัน เมื่อ b วนซ้ำคู่แรกปิดแต่คู่หลังยังเปิด จึงยังบังคับให้ a ปล่อยทุก outcome การรวม B ของทุกคู่เข้าด้วยกันจะทำลายความหมายแบบ “มีอย่างน้อยหนึ่งคู่”
เมื่อ fairness มีเงื่อนไข policy จะรับประกันการถึงเป้าหมายหรือไม่?
เลือก action คงที่ให้แต่ละ state แล้วตรวจชุด non-goal ที่เข้าถึงได้ซึ่งอาจรองรับ run อนันต์ โดยประเมิน fairness จาก actions ที่เลือกทั่วทั้งชุดนั้น
ตัวตรวจใช้โมเดลจำกัดที่กำหนดไว้ ไม่อนุมาน fairness อนันต์จาก trace สั้น และไม่ยืนยันพฤติกรรมของ environment จริง
1. โมเดลและ policy
เลือกกรณีตัวอย่างหรือปรับ policy และคู่ A/B
2. ส่วนของโมเดลที่เข้าถึงได้
ทุกเส้นคือ outcome ที่เป็นไปได้ G เป็น terminal goal ส่วน reachable state ที่ขาด action ทำให้ closure ไม่ครบ แยกจากการตรวจ recurrent set
กดตรวจ policy เพื่อดูผล
3. ตรวจ candidate recurrent sets
ตัวตรวจไล่ชุด non-goal ที่เข้าถึงได้ทุกชุดที่ไม่ว่าง Candidate ต้อง strongly connected ตาม outcomes ที่เป็นไปได้ การสมมติ recurrence มาจากการตรวจชุดนั้น ไม่ได้อนุมานจาก trace สั้น เลื่อนตารางแนวนอนเพื่อดูทุกคอลัมน์
| ชุด C | SC | actions ใน C | คู่ที่เปิดใช้ | states ที่ fair | outcomes นอก C | เป็น bad set? |
|---|
4. ลองเดิน trace ตัวอย่าง
เลือก successor ที่เป็นไปได้เพื่อบันทึกไม่เกิน 20 ก้าว การเดินนี้เป็นตัวอย่าง ไม่พิสูจน์เงื่อนไข fairness อนันต์
Comparison — assumption, label และ fairness outcome

| วิธีคิด | สิ่งที่สมมติ | คำถาม |
|---|---|---|
| Strong FOND | ทุก nondeterministic outcome adversarial | ทุกเส้นทางถึง goal หรือไม่ |
| Dual FOND | fair/adversarial เป็น label คงที่ | policy ผ่านตาม labels หรือไม่ |
| FOND+ A/B | fairness ขึ้นกับ B บน trajectory | ทุก maximal fair trajectory ถึง goal หรือไม่ |
| ตัวตรวจตัวอย่าง | โมเดลคงที่ พร้อม policy และ assumptions ที่ผู้ใช้ป้อน | มี recurrent support ที่หลบ goal แล้วยัง fair หรือไม่ |
Dual FOND เป็น fragment B-empty ตามทฤษฎีที่ตีพิมพ์ เมื่อ B ไม่ว่าง fairness ไม่ใช่ fixed action label เพราะ trajectory คนละเส้นอาจมี recurrent states และการเกิด B ต่างกัน ตัวตรวจนี้ไล่ candidate recurrent subsets; ไม่ใช่ FOND-ASP, SIEVE+ หรือ planner สังเคราะห์ policy และไม่ใช่ผลใหม่เชิงทฤษฎี
REPORTED CLAIM: README ของผู้พัฒนา FOND-ASP อธิบาย planner สำหรับ FOND+ ที่เขียนด้วย ASP และใช้ Clingo พร้อม mode เฉพาะ strong, strong-cyclic และ Dual FOND; บทความนี้ไม่ได้ build หรือ run repository นั้น
Applications — QNP เป็นข้อเท็จจริง ส่วนระบบงานจริงเป็นสมมติฐาน
FACT: งาน JAIR เชื่อม FOND+ กับ qualitative numerical planning (QNP) โดยแทนตัวแปรเชิงตัวเลขที่ไม่ติดลบซึ่งถามว่าเป็นศูนย์หรือมากกว่าศูนย์ เมื่อแปลงเป็น FOND ใช้ Boolean atom แทนเงื่อนไขศูนย์/มากกว่าศูนย์ ส่วน action decrement มี nondeterministic effect ที่แทนค่าที่อาจยังบวกหรือถึงศูนย์ และ assumption A/B ผูก action ลดกับ action เพิ่ม Theorem 14 ในบทความ JAIR เป็น formal connection ในงานตีพิมพ์ ไม่ใช่การอ้างว่าตัวแปรเชิงคุณภาพเป็นเพียง bit ในระบบจริง
HYPOTHESIS: ทีมอาจใช้ A/B อธิบายว่า fairness ของ operation หนึ่งถูกสมมติเมื่อทุก action ใน B ที่เกี่ยวข้องเกิดเพียงจำนวนจำกัดครั้งบน trajectory แต่ต้องนิยาม global action identity และตรวจ model กับผู้รับผิดชอบระบบก่อน การเห็น retry เพียงไม่กี่ครั้งไม่ยืนยันเงื่อนไขนี้
Game Lab — ทดลองเปลี่ยน policy กับ assumption
ตัวฝึกหัดใช้โมเดลอ่านอย่างเดียว P,S,T,G ผู้เล่นตั้ง initial, เลือก action ให้ P/S/T และกรอก A/B ได้ไม่เกินสองคู่ในหน้าจอ; นี่เป็นขอบเขตการแสดงผล ไม่ใช่ขีดจำกัดจำนวน assumptions ใน FOND+ คู่หนึ่งรับ A ได้เฉพาะ global nondeterministic actions; B รับ action ID ที่รู้จัก และสองชุดห้ามทับกัน
กดตรวจเพื่อดู valid/closed, reachable states, candidate recurrent supports, คู่ที่ active, fair nodes, bad components และ verdict ว่า policy guarantee goal ภายใต้โมเดลนี้หรือไม่ Reset คืนค่าเริ่มต้นและล้างคำตอบ เพื่อให้เปรียบเทียบกรณีใหม่
เป้าหมายเรียนรู้ห้าข้อเริ่มสถานะ unsolved: (1) เห็นว่า b ที่ P เป็น prefix ในกรณี T:exit; (2) หา witness {S,T} เมื่อ T:b; (3) เปลี่ยน T:c แล้วดูว่าทำไม B ไม่ recurrent; (4) เพิ่ม {a}/empty ให้ a ยัง fair แม้ T:b; (5) ใช้ mutual {a}/{b} และ {b}/{a} ให้เห็นว่าทั้งคู่ปิดใน {S,T} นี่เป็นโจทย์จำลองเพื่ออ่าน semantics; การเพิ่ม assumption ในเกมไม่ได้พิสูจน์ว่า environment จริงทำตาม
ปรับ policy และสมมติฐาน fairness ให้ตรงภารกิจ
แต่ละภารกิจให้จัด configuration ที่กำหนดแล้วอ่านผลเชิงรูปแบบ Policy นี้ใช้กับโมเดลสาธิตเท่านั้น ไม่รับรองระบบจริง
ทั้งห้าภารกิจเริ่มจากยังไม่สำเร็จ เลือกภารกิจ ปรับ policy หรือคู่ A/B แล้วกดตรวจคำตอบ
ภารกิจ
เลือกภารกิจเพื่อเริ่ม
สำเร็จแล้ว 0 จาก 5 ภารกิจ
ปรับคำตอบ
ส่วนที่เข้าถึงได้ของโมเดลปัจจุบัน
เลือกภารกิจเพื่อดูผล
ตรวจ candidates
แต่ละแถวตรวจว่าชุด non-goal ที่เข้าถึงได้อาจเกิดซ้ำหรือไม่ พร้อมคู่ที่เปิดใช้ states ที่ fair และ outcomes ที่ออกนอกชุด เลื่อนตารางแนวนอนเพื่อดูทุกคอลัมน์
| C | SC | คู่ที่เปิดใช้ | states ที่ fair | outcomes นอก C | เป็น bad set? |
|---|
Goal เป็น terminal state ตัวอย่างจำกัดไม่พิสูจน์ recurrence หรือ fairness อนันต์ ผลขึ้นกับโมเดล policy และ assumptions ที่กำหนด
Failure Modes — จุดที่ทำให้วินิจฉัยผิด
- นับ prefix เหมือนวงวน: B ที่เกิดจำกัดครั้งไม่ปิด assumption การสังเกต trace สั้นก็พิสูจน์การเกิดอนันต์ไม่ได้
- แยก action ตาม state: b ที่ P และ b ที่ T มี global ID เดียวกัน การเห็น b ใน recurrent support ที่ T ปิด B แม้ b ที่ P เกิดครั้งเดียว
- รวม B หลายคู่: {a}/{b} ปิดได้ขณะที่ {a}/empty ยังเปิดอยู่ ตรวจแต่ละคู่แยกกัน
- บังคับ outcome ของ action ไม่ fair ทุกตัว: nonfair state ต้องมี successor อย่างน้อยหนึ่งตัวใน C; fair state ต้องมี successor ทุกตัวใน C
- รับรองข้อมูลไม่ครบ: MISSING policy ที่ reachable ทำให้ closure ไม่ครบ การไม่พบ component ในกราฟบางส่วนไม่ใช่ guarantee
- ตี fairness เป็น probability หรือเวลา: semantics ไม่ระบุ distribution, success percentage, retry budget หรือ deadline และไม่ได้รับรอง outcome ภายในเวลาจำกัด
Future Directions — ขยาย checker หลังยืนยัน model
งานต่อไปอาจเพิ่ม trace viewer ที่แสดง prefix, recurrent support และเหตุผลที่แต่ละคู่ A/B เปิดหรือปิด หรือรับกราฟจากแบบจำลองภายนอกโดยรักษา action identity, applicability, outcomes และ goal semantics ให้ครบ
ตัวตรวจไม่ต้องสมมติว่า B เกิดจำกัดครั้งบนทุก trajectory: ถ้า B ใดเกิดไม่สิ้นสุด คู่ที่ใช้ B นั้นก็เพียง inactive บน trajectory ดังกล่าว เงื่อนไขของ assumption คือเมื่อ B ทุกตัวเกิดจำกัดครั้ง จึงให้ใช้ fairness กับ A; การยืนยันความครบของ input model เป็นคนละงานกับการยืนยันว่า condition นี้จริงบนทุก run
การเทียบกับ planner ต้องแยก checker policy คงที่ออกจากระบบสังเคราะห์ policy และระบุ version, inputs, benchmarks และวิธีวัด งานนี้ยังไม่ได้ติดตั้งหรือรัน FOND-ASP ไม่มีผลเปรียบเทียบประสิทธิภาพ และไม่ประเมิน runtime ของระบบจริง
Takeaways — ถามว่า B กลับมาอยู่ในวงวนหรือไม่
FACT: ใน A/B action ใน A จะเป็น fair ณ recurrent state เมื่อมี assumption ที่ครอบคลุม action นั้นและไม่มี action ใน B ของ assumption นั้นเกิดไม่สิ้นสุดบน trajectory
ANALYSIS: B ที่เกิดใน prefix อย่างจำกัดไม่ปิด assumption แต่ B ที่ policy เลือกใน recurrent state ทำให้ B เกิดซ้ำและปิด assumption นั้นตลอด trajectory
SIMULATION: เมื่อใช้ assumption {a}/{b} บนกราฟ P,S,T,G และคง P:b, S:a การเลือก T:exit หรือ T:c ไม่สร้าง fair non-goal recurrent support ส่วน T:b เปิดวงวน {S,T} ที่หลบ G
LIMIT: ผล checker ขึ้นกับกราฟ, policy, action ID และ fairness assumptions ที่ผู้ใช้กำหนด ไม่มี probability, deadline, guarantee ในโลกจริง หรือการอ้างว่าระบบ AI มีจิตสำนึก

FAQ — คำถามที่มักเกิด
1. A/B หมายถึง action ใน B ต้องไม่เกิดเลยหรือไม่?
ไม่ใช่ เงื่อนไขต้องการให้ action ใน B เกิดเพียงจำนวนจำกัดครั้งตลอด trajectory อนันต์ จึงเกิดหนึ่งครั้งหรือหลายครั้งใน prefix ได้ หากไม่กลับมาเกิดซ้ำไม่สิ้นสุด assumption ยังเปิดอยู่
2. ต้องดู B เฉพาะ state เดียวกับ A หรือไม่?
ไม่ต้อง นิยามมอง action ที่เกิดบน trajectory ทั้งเส้น หาก action ใน B เกิดไม่สิ้นสุดที่ recurrent state ใด ก็ปิด fairness pair นั้นสำหรับ action ใน A ที่เกี่ยวข้องบน trajectory เดียวกัน
3. ถ้ามีหลาย A/B ต้องผ่านทุกคู่หรือไม่?
ไม่ต้องสำหรับการจัด action หนึ่งว่า fair: มีคู่ใดคู่หนึ่งที่มี action อยู่ใน A และ B ของคู่นั้นเกิดเพียงจำกัดครั้งก็พอ แต่ละคู่ยังมีผลของตัวเองต่อ action อื่น และต้องไม่รวมเงื่อนไขโดยพลการ
4. ทำไม outcome ของ action fair ต้องออกครบทุกตัว?
เพราะนี่คือข้อกำหนดที่กำหนด fair trajectory ใน FOND: ที่ recurrent state หาก action ถูกถือว่า fair successor ทุกตัวที่ action อาจสร้างต้องเกิดตามหลัง state นั้นไม่สิ้นสุดครั้ง หากข้าม outcome ตัวใดตลอด trajectory นั้นไม่ fair
5. checker นี้เป็น FOND-ASP หรือ SIEVE+ หรือไม่?
ไม่ใช่ FOND-ASP เป็น planner ที่ตีพิมพ์และ repository อธิบายว่าใช้ ASP/Clingo ส่วน SIEVE+ เป็น termination procedure ในงาน JAIR ตัวตรวจในบทความเป็น bounded recurrent-support checker สำหรับ policy และกราฟที่ระบุไว้เพื่อแสดงแนวคิด
6. ผลว่า guarantee แปลว่าระบบ production จะถึง goal แน่นอนหรือไม่?
ไม่ แปลว่าไม่มี fair maximal non-goal trajectory ภายใต้กราฟ policy และ assumptions ที่ป้อนเท่านั้น หาก model ไม่ครบหรือ fairness assumption ไม่ตรงกับพฤติกรรมจริง ข้อสรุปก็ใช้กับระบบจริงไม่ได้
References — งานตีพิมพ์และเครื่องมือที่เกี่ยวข้อง
- Rodriguez, I. D., Bonet, B., Sardina, S., & Geffner, H. (2022). “FOND Planning with Explicit Fairness Assumptions.” Journal of Artificial Intelligence Research, 74, 887–916. DOI: 10.1613/jair.1.13599. Official JAIR article and PDF. Published source for FOND+, A/B assumptions, trajectory fairness, SIEVE+, and the Dual FOND B-empty fragment.
- Rodriguez, I. D., Bonet, B., Sardina, S., & Geffner, H. “Flexible FOND Planning with Explicit Fairness Assumptions.” arXiv v1 submitted 2021-03-15. arXiv:2103.08391. This is the earlier preprint title/version, distinct from the published JAIR article title.
- FOND-ASP: FOND+ via ASP. Author repository documentation for the ASP/Clingo planner and input conventions. Repository was inspected but not built or run for this article.
- Strong-Cyclic Planning: fairness บนกราฟ policy — บริบทเรื่อง uniform fairness และการถึง goal
- Dual FOND: fairness ของ action กับการวนซ้ำ — กรณี action labels แบบ fair/adversarial คงที่ ซึ่งเทียบกับ fragment ที่ B ว่าง
ใส่ความเห็น