
Quick Answer: ให้เซิร์ฟเวอร์ระบุตัวตนและสิทธิ์จากแหล่งที่เชื่อถือได้ แล้วกรองรหัสเอกสารที่อนุญาตก่อนโหลดข้อความ ก่อนส่งเข้า reranker หรือสร้าง context ให้ LLM เมื่อไม่มี principal หรือนโยบายที่ชัดเจน ให้ปฏิเสธโดยปริยาย (deny by default) การกรองหลังอ่านข้อความหรือหลังโมเดลเห็นเนื้อหาแล้วมาช้าเกินไป
บทเรียนนี้สอนทักษะเดียว: วาง authorization gate หรือด่านตรวจสิทธิ์ไว้ที่ขอบเขตเอกสารของระบบ Retrieval-Augmented Generation (RAG) ให้ถูกตำแหน่ง ตัวอย่างเป็น mock แบบออฟไลน์ด้วยข้อมูลสังเคราะห์ ไม่ได้เชื่อมระบบยืนยันตัวตน ฐานข้อมูล vector store หรือ LLM จริง และไม่ได้พิสูจน์ความปลอดภัยของระบบ production
ผลลัพธ์การเรียนรู้
เมื่อจบบทเรียน คุณจะสามารถรับรายการ candidate document IDs จากชั้นค้นหา แล้วคัดเหลือเฉพาะเอกสารที่ทั้ง tenant และนโยบายของ principal อนุญาต ก่อนเรียกตัวโหลดข้อความหรือ reranker ได้ พร้อมระบุกรณีที่ต้องหยุดอย่างปลอดภัยเมื่อไม่มีข้อมูล identity หรือนโยบายสิทธิ์
ปัญหาที่ต้องแก้: ข้อความอาจรั่วก่อนคำตอบจะเกิด
RAG นำเอกสารจากภายนอกไปประกอบเป็นบริบทให้โมเดล โดยทั่วไปมีการค้นหา candidate จาก index หรือฐานข้อมูล แล้วโหลดข้อความ จัดอันดับใหม่ และส่งบางส่วนเข้า context ของโมเดล จุดเสี่ยงไม่ได้มีแค่คำตอบสุดท้าย หากระบบค้นพบเอกสารที่ผู้ใช้ไม่มีสิทธิ์ แล้วโหลด snippet ไปยังบริการ rerank ภายนอก หรือส่งข้อความให้โมเดล ข้อมูลนั้นได้ข้ามขอบเขตความเชื่อถือแล้ว แม้ภายหลังแอปจะลบ citation หรือไม่แสดงคำตอบก็ตาม
ดังนั้นต้องกำหนดสิทธิ์ก่อนเนื้อหาถูกโหลดเข้าสู่ขั้นตอนถัดไป กรองเฉพาะตอนแสดงผลปลายทางไม่พอ เพราะองค์ประกอบก่อนหน้าอาจเห็นข้อมูลไปแล้ว หลักคิดนี้เป็นการนำข้อแนะนำทั่วไปของ OWASP เรื่อง least privilege, deny by default และตรวจ permission ทุก request มาประยุกต์กับลำดับการทำงานของ RAG โดยตรง OWASP Authorization Cheat Sheet
แยก Authentication ออกจาก Authorization
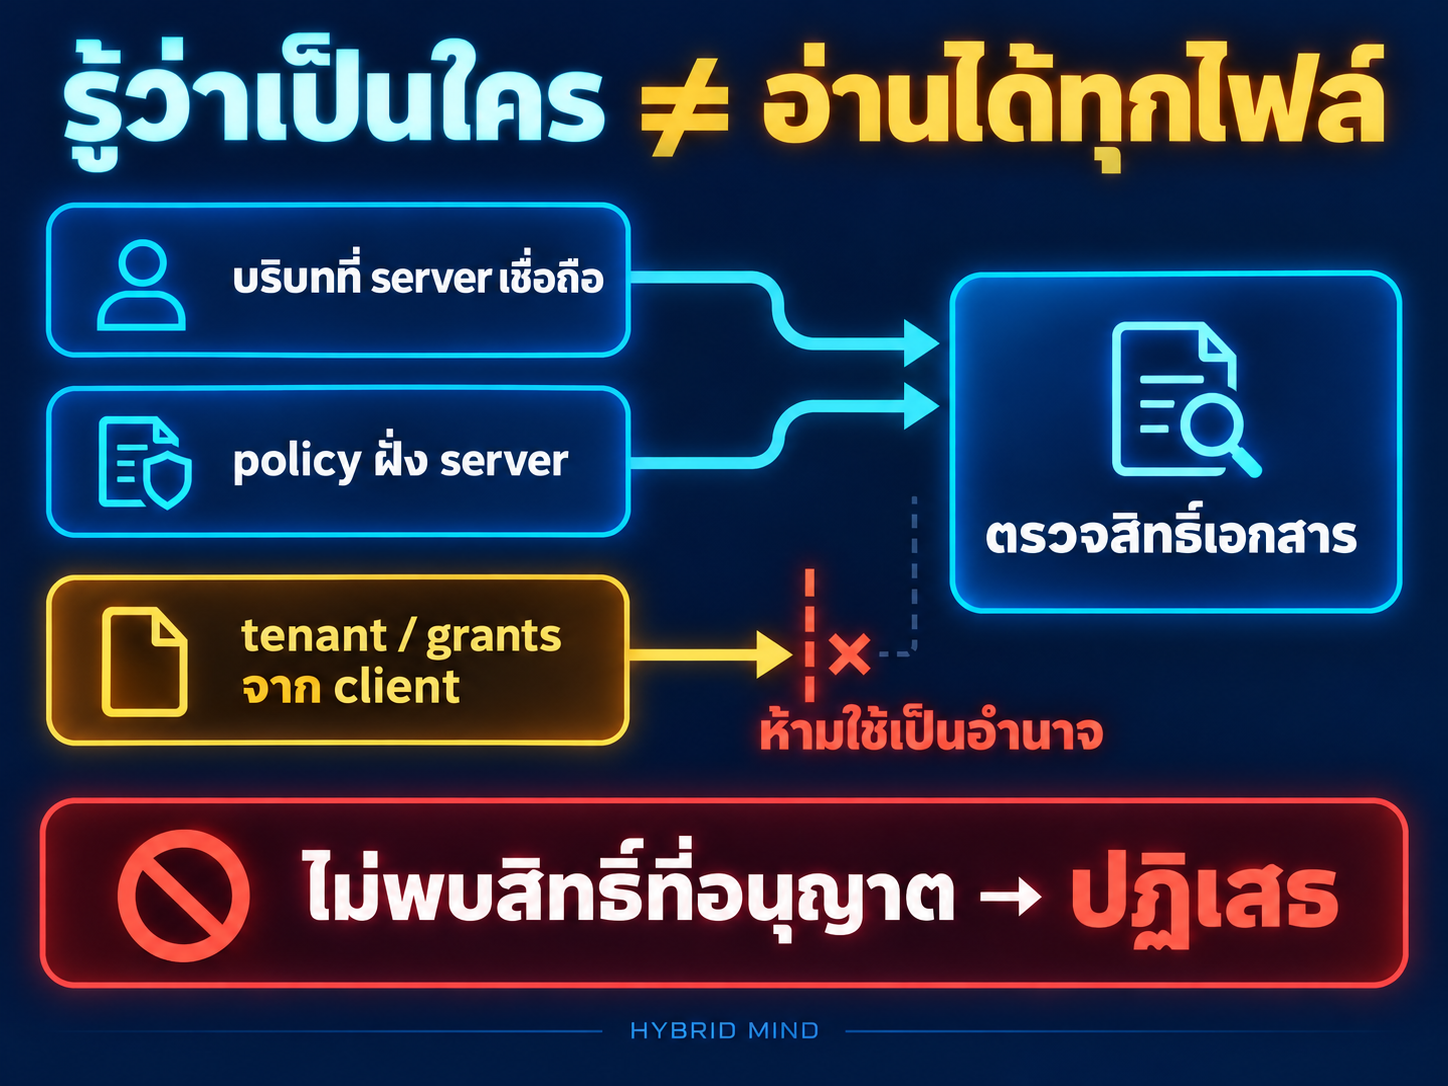
Authentication (การยืนยันตัวตน) ตอบว่าใครกำลังส่งคำขอ ส่วน Authorization (การกำหนดสิทธิ์) ตอบว่าบุคคลนั้นอ่านทรัพยากรชิ้นใดได้ การรู้ว่า principal คือผู้ใช้ A ไม่ได้แปลว่าผู้ใช้ A อ่านทุกเอกสารได้ OWASP ระบุความแตกต่างนี้และแนะนำให้ปฏิเสธเป็นค่าเริ่มต้นเมื่อไม่มี rule ที่อนุญาตอย่างชัดเจน
ในแอปจริง ฝั่งเซิร์ฟเวอร์ต้องตรวจ session, token หรือ credential ผ่านกลไกที่เลือก แล้วสร้าง trusted request context จากผลตรวจนั้น จากนั้นนโยบายฝั่งเซิร์ฟเวอร์หรือแหล่ง ACL ที่เชื่อถือได้จึงคำนวณ tenant และสิทธิ์อ่านเอกสาร ห้ามเชื่อ tenant_id, principal_id, allowed_document_ids หรือ grants ที่ส่งมาเป็น JSON จาก browser เพราะผู้เรียกเปลี่ยนค่าได้ ตัวอย่างในบทเรียนจะรับ AuthContext ที่สมมติว่าเป็นค่าจากเซิร์ฟเวอร์แล้วเท่านั้น โค้ดนี้ไม่ได้ยืนยันตัวตนและไม่ได้รับรองว่า context จริง

ทำไมกรองก่อน hydrate และ rerank
Hydrate ในที่นี้หมายถึงอ่านเนื้อหาเอกสารจริงจากที่เก็บ หลังจากค้นหาหรือเลือก candidate แล้ว แอปตรวจเพียง metadata ที่ปลอดภัย เช่น document ID และ tenant จากนั้นเทียบกับ policy ก่อนอ่าน text การทำเช่นนี้จำกัดข้อมูลที่ loader คืนมา และทำให้ reranker ได้รับเฉพาะเอกสารที่ผ่าน gate แล้ว
การกรองรหัสหลัง vector search จะปลอดภัยต่อเนื้อหาได้ก็ต่อเมื่อชั้น search ส่งกลับ IDs และ metadata ที่อนุญาตให้เห็น โดยไม่เปิด snippet หรือข้อความก่อนหน้านั้น หาก provider ส่งข้อความหรือ embedding ที่เปิดทางให้อนุมานข้อมูลต้องห้ามออกมาก่อนแอปกรอง การ gate ในแอปชั้นหลังไม่สามารถย้อนคืนความลับได้ ต้องตรวจขอบเขตข้อมูลของ index, query API, reranker และ logging ตั้งแต่ต้นทางด้วย
Microsoft อธิบาย Azure AI Search security trimming แบบหนึ่งว่าใช้ principal string ใน filter เพื่อรวมหรือตัดผลลัพธ์ แต่ string ใน filter เป็นเพียงค่าที่เทียบ ไม่ได้ยืนยันตัวตนหรือมอบ authorization ด้วยตัวเอง เอกสาร security filter pattern ของ Microsoft จึงต้องส่งค่าที่เซิร์ฟเวอร์ได้ตรวจสอบแล้ว และเข้าใจว่าการกรองแบบ string มีขอบเขตอย่างไร Microsoft ยังแยกแนวทาง filter นี้ออกจากความสามารถ document-level ACL/RBAC และ token-based query enforcement ที่มีข้อกำหนดเรื่อง metadata sync และสถานะ preview ตามฟีเจอร์ ภาพรวม Document-Level Access Control ตรวจรุ่นและสถานะล่าสุดของระบบเป้าหมายก่อนใช้จริง
OWASP ระบุความเสี่ยงของการใช้ vector store ร่วมกันโดยไม่มีการควบคุมที่สอดคล้อง ว่าอาจเกิดการรั่วข้าม tenant หรือ context ได้ และแนะนำ permission-aware store หรือการแบ่งขอบเขตข้อมูลอย่างเหมาะสม ข้อแนะนำนี้เป็นแนวทางลดความเสี่ยง ไม่ใช่หลักฐานว่าตัวกรองใดตัวหนึ่งป้องกันการรั่วได้ทุกทาง OWASP LLM08:2025 Vector and Embedding Weaknesses
ลำดับ pipeline ที่ใช้ในตัวอย่าง
- เซิร์ฟเวอร์สร้าง AuthContext จาก identity ที่ตรวจแล้ว พร้อม tenant ที่เชื่อถือได้ (ตัวอย่างนี้สมมติขั้นตอนนี้ไว้)
- เซิร์ฟเวอร์อ่าน policy snapshot ซึ่งระบุเอกสารที่ principal นั้นอ่านได้
- ชั้นค้นหาส่ง candidate IDs เท่านั้น ไม่ส่งข้อความเอกสารใน mock นี้
- ตรวจรูปแบบ ID, ค้น metadata ใน catalog, ตรวจ tenant และตรวจ grant แบบ explicit ก่อนโหลดข้อความ
- loader โหลดเฉพาะ ID ที่ผ่าน gate จากนั้น reranker ได้รับเอกสารชุดเดียวกันหรือชุดย่อย
- ประกอบ model context จากชุดที่อนุญาตแล้วเท่านั้น อาจตรวจ citation/output ซ้ำเป็น defense in depth
ขั้นที่ 6 ไม่ได้แทนขั้นที่ 4 การตรวจคำตอบปลายทางช่วยลดความผิดพลาดบางแบบ แต่ไม่ลบข้อเท็จจริงว่าข้อความที่ถูกห้ามอาจผ่านไปยังโมเดลหรือผู้ให้บริการก่อนหน้าแล้ว


ตัวอย่างทำงาน: candidate ไม่เท่ากับ permission
สมมติว่ามีเอกสารสังเคราะห์สี่รายการ: a-public อยู่ tenant A และให้ principal A อ่านได้, a-denied อยู่ tenant A แต่ไม่มี grant, b-secret อยู่ tenant B, และ unclassified ไม่มี tenant metadata ที่ชัดเจน นอกจากนี้มี candidate unknown-id ที่ catalog ไม่รู้จัก นโยบาย server-side ให้ principal A อ่านได้เฉพาะ a-public
เมื่อ retriever คืน IDs ทั้งห้ารายการ authorization function จะตรวจ tenant และ policy ก่อนเรียก TextLoaderSpy ผลที่คาดหมายคือโหลดและส่งให้ RerankerSpy เพียง a-public เท่านั้น ส่วน tenant B, เอกสารที่ถูกปฏิเสธ, เอกสารไร้ classification และ ID ที่ไม่รู้จักต้องไม่ปรากฏในรายการ hydrated IDs หรือ reranker inputs การมี ID ในผลค้นหาไม่ได้แปลว่ามีสิทธิ์
หาก policy ไม่มีรายการของ principal A หรือ AuthContext ไม่มี principal/tenant ที่ใช้ได้ ฟังก์ชันควรคืนชุดว่างและไม่เรียก loader หากผู้ใช้ส่ง request payload ที่ระบุ tenant B และ grant สำหรับ b-secret นั่นยังไม่เปลี่ยน trusted AuthContext หรือ policy เพราะ client payload ไม่ได้เป็น input authority ของ gate
โค้ดออฟไลน์และ test specification อยู่ที่ code/auth_boundary.py และ code/test_auth_boundary.py ดูคำสั่งและข้อจำกัดใน README ที่แนบมากับบทความ ผลลัพธ์ตัวอย่างที่คาดว่าจะเห็นคือ result_ids: ['a-public'], hydrated_ids: ['a-public'] และ reranker_input_ids: ['a-public'] ข้อความนี้เป็น expected output จากการอ่านโค้ด ไม่ใช่ผลรันจริง โค้ดและ tests ยังเป็น NOT RUN
Brief สำหรับคัดลอกและให้ LLM ช่วยสร้าง mock
เป้าหมาย: สร้างฟังก์ชัน authorization gate สำหรับ RAG แบบออฟไลน์
ข้อมูลนำเข้า: candidate document IDs, metadata-only catalog, mock trusted principal/tenant, server-owned policy snapshot
ขอบเขต: Python 3.12+ standard library; ข้อมูลสังเคราะห์เท่านั้น; ห้ามเรียก auth provider, database, vector service, LLM หรือ network
หลักฐาน: บันทึก IDs ที่ถูก hydrate และรายการที่ส่งให้ reranker เพื่อยืนยันว่าเอกสารต้องห้ามไม่ผ่านสองจุดนี้
เกณฑ์ผ่าน: อนุญาตเฉพาะ ID ที่มี metadata, tenant ตรง และ explicit grant; missing context/policy, unknown ID, unclassified tenant และ cross-tenant ต้องไม่โหลดข้อความ
จุดหยุด: จบเมื่อได้ mock pipeline และ acceptance cases; ไม่เพิ่ม integration, deployment หรือ performance/security score
ถ้า LLM สร้างโค้ด ให้ตรวจด้วยตนเองว่าการเรียก loader เกิดหลัง authorization จริง อย่าพอใจกับชื่อฟังก์ชัน เช่น filter_allowed ถ้าข้อความถูกโหลดก่อน แล้วค่อย filter ภายหลัง
การยืนยันผลและสถานะการทดสอบ
ตัวอย่างกำหนด spy สองตัวเพื่อบันทึกการไหลของข้อมูล ตัวแรกบันทึก document IDs ที่ถูก hydrate ตัวที่สองบันทึก IDs ที่เข้า reranker การตรวจที่สำคัญคือรายการทั้งสองไม่มีเอกสาร denied, cross-tenant, unclassified หรือ unknown รวมถึงตรวจกรณีไม่มี policy และ request spoofing ด้วย ชุดตรวจถูกเขียนไว้แต่ไม่ได้รัน จึงยังไม่มีผล PASS จากการทดสอบจริงและไม่มี runtime security assurance
การทดสอบในระบบจริงควรสร้างข้อมูลหลาย tenant, เปลี่ยนสิทธิ์, ส่ง ID ที่เดาได้, ทำให้ policy service ล้มเหลว, ตรวจ cache และ log, และยืนยันว่าทุกทางเข้าสู่ loader บังคับใช้ gate อย่างสม่ำเสมอ เรื่องเหล่านี้อยู่นอกตัวอย่างนี้ และต้องทำภายใต้ระบบทดสอบที่ได้รับอนุญาต การผ่าน mock ไม่แปลว่าระบบจริงปลอดภัย


ข้อจำกัดที่ต้องรักษาไว้
- Identity: AuthContext ใน mock เป็นสมมติฐานที่เชื่อถือได้ ไม่ได้ผ่านการยืนยันตัวตนจริง
- Policy freshness: pipeline อ่าน policy snapshot ต่อคำขอ ตัวอย่างเปลี่ยน policy แล้วคำขอถัดไปจึงเห็นค่าใหม่ ไม่ได้รับรองพฤติกรรมเมื่อเกิดการ revoke พร้อมกับคำขอที่กำลังทำงาน หรือ race condition ระหว่าง policy กับการ hydrate
- Index boundary: retriever ในตัวอย่างคืน IDs เท่านั้น ระบบจริงอาจโหลด snippets ก่อน ต้องตรวจว่า provider กรองที่ต้นทางหรือแยกข้อมูลจริง
- Metadata integrity: ตัวอย่างถือว่า catalog และ policy มาจากฝั่งเซิร์ฟเวอร์ที่ถูกต้อง ถ้าผู้โจมตีแก้ metadata หรือ policy ได้ การตัดสินใจก็เชื่อถือไม่ได้
- Scope: ไม่มีฐานข้อมูล, vector store, LLM, API, sandbox หรือ live integration ไม่มีตัวเลขคุณภาพการค้นหา, score, latency หรือ throughput
แนวทางติดตั้งและใช้งาน mock
ต้องใช้ Python 3.12 ขึ้นไปและ standard library ไม่ต้องติดตั้ง dependency ไม่ใช้ environment variables, token, API key, GPU หรือเครือข่าย ตัวอย่างอ่าน fixtures ที่กำหนดในโค้ดและเก็บทุกอย่างในหน่วยความจำ คำสั่ง mock คือ python code/auth_boundary.py ส่วนคำสั่งทดสอบที่เตรียมไว้คือ python -m unittest discover -s code -p "test_*.py" แต่ทั้งสองคำสั่งยังไม่ได้ถูกรันในรอบนี้ ห้ามนับ expected output ว่าเป็นผลทดสอบ
Mock: มีให้ในบทเรียนเพื่ออธิบายลำดับการควบคุมข้อมูลเท่านั้น Sandbox: ไม่มีการเชื่อมต่อ sandbox ภายนอก Live: ไม่มีการเรียกระบบจริง การนำแนวคิดไปใช้ต้องตรวจ identity provider, policy source, index, SDK/API version, permission synchronization และจุดเรียก loader ของระบบเป้าหมายแยกต่างหาก
3D Lab: มองเห็นเอกสารข้ามด่าน
เลือก Tenant A, Tenant B หรือบริบท ACL ที่หายไปใน 3D Lab แล้วใช้ปุ่มขั้นตอนดูความสัมพันธ์ระหว่าง trusted context, policy, hydration และ reranker ข้อมูลในโหนดและรายการ IDs ที่อนุญาตจะเปลี่ยนตาม fixture ที่เลือก เป็นการจำลองลำดับควบคุม ไม่ได้ยืนยันตัวตนหรือทดสอบฐานข้อมูลจริง
Interactive แยกด้านล่างให้เลือกตำแหน่งกรองก่อนหรือหลัง hydration พร้อมค่า Top-k 1 หรือ 2 แล้วเปรียบเทียบ hydrated IDs, reranker IDs และ allowed output IDs จากลำดับสังเคราะห์เดียวกัน สังเกตว่า output ที่ว่างหลังกรองช้าไม่ได้แปลว่าข้อความไม่เคยข้ามไปยังขั้นก่อนหน้า รายการนี้ไม่ใช่คะแนนคุณภาพการค้นหาหรือผลทดลองการรั่วไหลจริง
RAG กับสิทธิ์เอกสาร: กรอง ID ก่อนอ่านข้อความ
ลองดูว่าเอกสารที่มีอันดับสูงแต่ไม่ได้รับอนุญาตจะผ่านเส้นทางข้อมูลต่างกันอย่างไรเมื่อกรองสิทธิ์ช้าเทียบกับกรอง document ID ตั้งแต่ต้น
ขอบเขตการจำลอง: tenant, principal, policy และอันดับค้นหาด้านล่างเป็นข้อมูลสมมติ ตัวอย่างนี้แสดงลำดับการควบคุมเท่านั้น ไม่ได้ยืนยันตัวตน ใช้ฐานข้อมูลจริง ทดสอบระบบ authorization หรือพิสูจน์ความปลอดภัย
ระบบจริงควรละทิ้งหรือปฏิเสธ tenant/grants ที่ client ส่งมา แล้วใช้บริบทที่ server ตรวจสอบแล้ว หากสิทธิ์ถูกเพิกถอน ให้ policy ตรวจ snapshot ล่าสุดในคำขอถัดไป; ตัวอย่างนี้ไม่รับประกันการซิงก์พร้อมกันระหว่างคำขอ
ใช้ปุ่มขั้นตอนเพื่อเปรียบเทียบการกรองก่อนและหลัง hydration
- ผ่านต่อ
- หยุดหรือปฏิเสธ
กรอง ID ก่อน hydration
ตรวจ allowed IDs ก่อนโหลดเนื้อหา แล้วส่งเฉพาะข้อความที่ผ่านต่อ
กรองหลังอ่านข้อความ/จัดอันดับ
ตัวอย่างลำดับเดียวกัน แต่โหลดข้อความก่อนตรวจสิทธิ์ เอกสารต้องห้ามจึงเข้าถึงขั้น hydration ในแบบจำลอง
ทดลองตำแหน่งการกรองและ Top-k
ใช้ชุด Tenant ด้านบน แล้วปรับตัวควบคุมชุดนี้แยกจากปุ่มเดินขั้นตอน เลือกตัวอย่าง Top-k ก่อนดูว่า ID ใดถูก hydrate, ส่งเข้า reranker และเหลือหลังตรวจสิทธิ์
ลำดับคงที่คือ doc-forbidden → doc-A1 → doc-B1; ไม่มีการคำนวณคะแนนหรือเรียก reranker จริง ในโหมดกรองช้า ข้อความใน Top-k จะผ่าน hydration ก่อนตรวจสิทธิ์ และอาจเหลือผลที่อนุญาตน้อยกว่า Top-k
| ลำดับสมมติ | Document ID | Tenant เจ้าของ | ข้อความตัวอย่าง |
|---|---|---|---|
| 1 · สูง | doc-forbidden | Tenant อื่น | ข้อความจำลองที่ไม่ควรถูกโหลดก่อนตรวจสิทธิ์ |
| 2 · ถัดมา | doc-A1 | Tenant A | สคริปต์โครงการ A (ข้อความสมมติ) |
| 3 · ถัดมา | doc-B1 | Tenant B | สคริปต์โครงการ B (ข้อความสมมติ) |
สถานะเริ่มต้น: เลือก Tenant A; ตัวอย่างนี้เป็นข้อมูลสังเคราะห์
เกิดข้อผิดพลาดในตัวอย่างนี้ กรุณาอ่านคำอธิบายคงที่และตารางข้อมูลด้านบน
แนวทางออกแบบ: รับ tenant/principal จากบริบทที่เซิร์ฟเวอร์ตรวจสอบแล้วเท่านั้น อย่าเชื่อ tenant หรือ grant ที่ client ส่งมา หากไม่มี ACL context ให้หยุดแบบ deny-by-default การนำแนวทางนี้ไปใช้จริงต้องออกแบบและทดสอบในระบบของคุณแยกต่างหาก
Video Lab ที่สัมพันธ์กับทักษะ
สำหรับ Video Agent Lab ให้ตั้งหัวข้อวิดีโอจำลองเกี่ยวกับโครงการ Tenant A แล้วใช้ brief กำกับว่าอนุญาตเฉพาะสคริปต์และ brand assets ที่ server policy ให้สิทธิ์แก่ principal นั้น ให้ตรวจ prompt ที่ Lab สร้างเทียบกับ brief หกส่วน: ระบุแหล่งที่อนุญาตหรือไม่ ห้ามดึงเอกสารโครงการอื่นหรือไม่ และหยุดเมื่อไม่มีสิทธิ์อย่างไร หาก prompt ขาดขอบเขต ให้เติมเงื่อนไขจาก brief ก่อนนำไปใช้ต่อ
Video Lab นี้จำลองวงจรสร้างวิดีโอและช่วยฝึกตรวจ brief เท่านั้น ไม่ได้ยืนยัน identity หรือ execute authorization gate ของบทเรียน ไม่มีการอ่านเอกสารจริงหรือทดสอบการบังคับ ACL และยังไม่ได้ทดสอบปุ่ม/ผล prompt บนหน้าเว็บจริง
จากคลิปดิบ
สู่จักรวาลคอนเทนต์
ChatGPT ตัดต่อวิดีโอแทนคนได้จริงแค่ไหน? สำรวจระบบ AI Video Editing Agent ผ่านฉากสามมิติที่โต้ตอบได้ พร้อมแยกข้อเท็จจริง สร้างพรอมป์ต์ และจำลองต้นทุนก่อนลงมือทำจริง
ออกแบบระบบตัดต่อในมุมมอง 3D
ลากบนฉากเพื่อหมุนมุมมอง แตะโหนดเพื่อดูหน้าที่ของ AI ในแต่ละขั้นตอน
จัดระเบียบไฟล์ ตรวจคุณภาพภาพและเสียง และกำหนดสิทธิ์เข้าถึงให้ AI Agent
แยกความสามารถจริงจากคำโฆษณา
กดแต่ละประเด็นเพื่ออ่านรายละเอียดและแหล่งข้อมูล
ChatGPT Work เข้าถึงไฟล์ในเครื่องได้ตรวจสอบแล้ว / มีเงื่อนไข+
Astra ใช้โปรแกรมคอมพิวเตอร์ทำงานได้ตรวจสอบแล้ว / ไม่ใช่โปรแกรมตัดต่อในตัว+
ตัดเสร็จใน 5–10 นาทีทุกกรณียังพิสูจน์เป็นเกณฑ์ทั่วไปไม่ได้+
ถูกกว่าจ้างคน 10 เท่าต้องกำหนดต้นทุนให้เทียบกันได้+
หนึ่งไอเดีย สามรูปแบบคอนเทนต์
ปรับรูปแบบวิดีโอ แล้วดูกรอบภาพตัวอย่างและ Prompt เปลี่ยนตามแบบเรียลไทม์
ช่วยตัดต่อ?
พร้อมนำไปใช้กับ AI Agent
ตัวสร้าง Prompt นี้ไม่อัปโหลดคลิป ไม่เรียก API เสียเงิน และไม่ตัดต่อวิดีโอจริง ต้องใช้กับเครื่องมือที่ผู้ใช้อนุญาตภายหลัง
จำลองเวลาและต้นทุนของคุณเอง
เลื่อนตัวเลขเพื่อเปรียบเทียบสถานการณ์สมมติ ไม่ใช่ผล benchmark ที่ยืนยันแล้ว
ตัวเลขเป็นตัวอย่างเพื่อช่วยตัดสินใจ ไม่ใช่ผลประหยัดที่รับประกัน
AI ที่ตัดคลิปเป็น ไม่ได้ทำงานลำพัง
สิ่งที่น่าสนใจของ GPT-6 Astra และ GPT-6.1 Sol ไม่ได้อยู่ที่ว่าตัวโมเดลมีปุ่ม Render MP4 ซ่อนอยู่ แต่คือความสามารถในการจัดการงานหลายขั้นตอนร่วมกับเครื่องมืออื่น: อ่านไฟล์ วางลำดับเรื่อง ใช้แอป ตรวจผลลัพธ์ และแก้งานตามข้อเสนอแนะของมนุษย์
สำหรับคนทำคอนเทนต์ ความต่างสำคัญคือการเปลี่ยนจาก “ส่งคลิปให้ AI แล้วหวังว่าจะได้ผลงาน” ไปเป็น Workflow ที่ตรวจรับได้ทุกขั้น ตั้งแต่การเลือกช่วงเด็ด การสร้างซับ การตรวจคำผิด จนถึงการเรนเดอร์ไฟล์ตามสัดส่วนของแต่ละแพลตฟอร์ม
ข้อควรระวังคือระบบ Work ที่รันบนเว็บหรือมือถือไม่ได้หมายความว่า AI เข้าถึงคลิปบนคอมพิวเตอร์บ้านได้ทันที ต้องทำงานในสภาพแวดล้อมที่เปิดให้เข้าถึงไฟล์จริง มีเครื่องมือตัดต่อ และมีสิทธิ์ใช้งานอย่างชัดเจน
รวบรวมไฟล์ในโฟลเดอร์ที่เข้าถึงได้ ระบุสิทธิ์และข้อจำกัด
ให้ Agent เสนอ Hook, ช่วงตัด และโครงเรื่องก่อนตัดต่อ
ตรวจชื่อเฉพาะ ตัวเลข ภาษาไทย และความถูกต้องของคำกล่าวอ้าง
ตรวจความละเอียด เสียง ระยะเวลา safe zone และคำบรรยาย
แบบฝึกหัดและ rubric
เพิ่ม tenant C และเอกสารสองรายการ: รายการหนึ่งอยู่ tenant C และมี grant ให้ principal C อีกหนึ่งรายการอยู่ tenant A แต่ไม่มี grant ลองทำนาย IDs ที่ควรผ่านก่อนดู mock จากนั้นเพิ่มกรณี principal ที่ไม่มี policy entry
Rubric (4 คะแนน): 1 คะแนน แยก trusted context จาก client request ได้; 1 คะแนน ตรวจ tenant และ explicit document grant ก่อน hydrate; 1 คะแนน ปฏิเสธกรณี missing policy/unknown/unclassified; 1 คะแนน ยืนยันจาก spy ว่าเอกสารต้องห้ามไม่เข้า reranker พร้อมเขียนข้อจำกัดของ mock หากมีคะแนนไม่ครบ ให้แก้ลำดับ pipeline ก่อนเพิ่มฟีเจอร์อื่น
คำถามที่พบบ่อย
ถาม: ถ้าฉันกรอง citation หลัง LLM ตอบแล้ว จะป้องกันเอกสารรั่วไหม?
ตอบ: ไม่เพียงพอ หากข้อความต้องห้ามเข้าถึง reranker หรือ model context ไปแล้ว การลบ citation ตอนท้ายไม่ยกเลิกการเปิดเผยที่เกิดขึ้นแล้ว อ่านบทเรียนเรื่อง การตรวจ citation กับ revision และ byte span ได้ในมุมที่เกี่ยวข้อง แต่ citation provenance เป็นคนละปัญหากับสิทธิ์อ่านเอกสาร
ถาม: ส่ง principal ID ใน filter string ได้ไหม?
ตอบ: ส่งได้ในฐานะค่า filter หากระบบต้องการ แต่ค่า string ไม่ได้ยืนยันว่าผู้ส่งเป็น principal นั้น Microsoft ระบุชัดว่า security trimming แบบ string filter เป็นเพียงการรวม/ตัดผลลัพธ์ เซิร์ฟเวอร์ต้องได้ principal จาก identity ที่เชื่อถือได้ และใช้ policy จริงก่อนกำหนด filter
ถาม: ใช้ managed search ACL แล้วไม่ต้องตรวจอะไรอีกหรือ?
ตอบ: ตรวจเอกสารและขอบเขตฟีเจอร์ของ provider รุ่นที่ใช้จริง รวมถึง token, permission metadata, synchronization, caching และทาง query อื่น ๆ ความสามารถบางรายการของ Azure AI Search อยู่ในสถานะ preview ตามเอกสารที่อ่านในรอบนี้ สถานะและข้อจำกัดเปลี่ยนได้ตามเวลา
ถาม: การทดสอบนี้พิสูจน์ว่า RAG ปลอดภัยหรือไม่?
ตอบ: ไม่ การทดสอบถูกเขียนแต่ไม่ได้รัน และเป็นข้อมูลจำลองแบบ in-memory เท่านั้น ใช้เป็น acceptance specification สำหรับลำดับ control flow ไม่ใช่ security certification
ถาม: เปลี่ยน policy แล้วคำขอเดิมจะหยุดทันทีหรือไม่?
ตอบ: ตัวอย่างแสดงเพียงว่า request ถัดไปอ่าน snapshot ล่าสุดที่ส่งให้ ไม่มีการจำลองงานพร้อมกันหรือรับรองเวลาการ revoke ต้องออกแบบและทดสอบ freshness กับ race behavior ในระบบจริง
อ่านต่อ
บทเรียน RAG citation และ revision provenance ตอบว่า quote อ้างอิงข้อความจากรุ่นใด ส่วน การประเมิน retrieval ว่าด้วยคุณภาพและความครบถ้วนของสิ่งที่ค้นพบ บทเรียนนี้จำกัดอยู่ที่คำถามก่อนหน้านั้น: principal นี้มีสิทธิ์ให้เอกสารชิ้นนี้เข้ากระบวนการหรือไม่
สรุป acceptance criteria
- identity มาจาก trusted server context; client tenant/grants ไม่เปลี่ยนสิทธิ์
- มี tenant match และ explicit document grant ก่อน hydrate, rerank หรือสร้าง model context
- missing context/policy, unknown ID และ unclassified metadata ปิดทางโดยค่าเริ่มต้น
- spy specifications ครอบคลุม allowed, denied, cross-tenant และ request spoof cases
- ระบุข้อจำกัด upstream retrieval, policy freshness และสถานะ NOT RUN อย่างตรงไปตรงมา
หยุดที่ bounded mock และ criteria เหล่านี้ อย่าเพิ่ม real provider, deployment หรือกล่าวอ้าง production security โดยไม่มีหลักฐานเฉพาะระบบ
Source Code และวิธีลองด้วยตนเอง · NOT RUN
code/auth_boundary.py · ยังไม่ได้รัน
"""Offline mock: authorize RAG candidate IDs before loading document text."""

from __future__ import annotations

from dataclasses import dataclass
from typing import Mapping, Sequence


MAX_CANDIDATES = 50
MAX_ID_LENGTH = 128
MAX_CONTEXT_FIELD_LENGTH = 128
MAX_QUERY_LENGTH = 2048


@dataclass(frozen=True)
class AuthContext:
    """Trusted server context, assumed established outside this example."""

    principal_id: str
    tenant_id: str


@dataclass(frozen=True)
class DocumentMetadata:
    """Metadata-only catalog entry; document text is stored separately."""

    document_id: str
    tenant_id: str | None


@dataclass(frozen=True)
class Document:
    document_id: str
    tenant_id: str
    text: str


@dataclass(frozen=True)
class PolicySnapshot:
    """Server-owned snapshot keyed by (tenant_id, principal_id)."""

    allowed_by_principal: Mapping[tuple[str, str], frozenset[str]]


class TextLoaderSpy:
    def __init__(self, text_by_id: Mapping[str, str]) -> None:
        self._text_by_id = text_by_id
        self.hydrated_ids: list[str] = []

    def load(self, document_id: str, tenant_id: str) -> Document:
        text = self._text_by_id[document_id]
        self.hydrated_ids.append(document_id)
        return Document(document_id, tenant_id, text)


class RerankerSpy:
    def __init__(self) -> None:
        self.input_ids: list[str] = []

    def rerank(self, query: str, documents: Sequence[Document]) -> tuple[Document, ...]:
        # A deterministic placeholder: preserve candidate order; no relevance claim.
        self.input_ids.extend(document.document_id for document in documents)
        return tuple(documents)


def _valid_context(auth: AuthContext) -> bool:
    return bool(
        isinstance(auth, AuthContext)
        and isinstance(auth.principal_id, str)
        and auth.principal_id.strip()
        and len(auth.principal_id) <= MAX_CONTEXT_FIELD_LENGTH
        and isinstance(auth.tenant_id, str)
        and auth.tenant_id.strip()
        and len(auth.tenant_id) <= MAX_CONTEXT_FIELD_LENGTH
    )


def authorize_ids(
    candidate_ids: Sequence[str],
    *,
    auth: AuthContext,
    catalog: Mapping[str, DocumentMetadata],
    policy: PolicySnapshot,
) -> tuple[str, ...]:
    """Return only IDs explicitly allowed by context, metadata, and policy."""
    if not _valid_context(auth) or not isinstance(candidate_ids, Sequence):
        return ()
    if isinstance(candidate_ids, (str, bytes)) or len(candidate_ids) > MAX_CANDIDATES:
        return ()
    if (
        not isinstance(policy, PolicySnapshot)
        or not isinstance(policy.allowed_by_principal, Mapping)
        or not isinstance(catalog, Mapping)
    ):
        return ()

    grants = policy.allowed_by_principal.get((auth.tenant_id, auth.principal_id))
    if not isinstance(grants, frozenset) or not grants:
        return ()

    allowed: list[str] = []
    seen: set[str] = set()
    for document_id in candidate_ids:
        if (
            not isinstance(document_id, str)
            or not document_id
            or len(document_id) > MAX_ID_LENGTH
            or document_id in seen
        ):
            continue
        seen.add(document_id)
        metadata = catalog.get(document_id)
        if not isinstance(metadata, DocumentMetadata):
            continue
        if metadata.document_id != document_id:
            continue
        if (
            not isinstance(metadata.tenant_id, str)
            or not metadata.tenant_id.strip()
            or len(metadata.tenant_id) > MAX_CONTEXT_FIELD_LENGTH
            or metadata.tenant_id != auth.tenant_id
        ):
            continue
        if document_id not in grants:
            continue
        allowed.append(document_id)
    return tuple(allowed)


def run_query(
    query: str,
    candidate_ids: Sequence[str],
    *,
    auth: AuthContext,
    catalog: Mapping[str, DocumentMetadata],
    policy: PolicySnapshot,
    loader: TextLoaderSpy,
    reranker: RerankerSpy,
) -> tuple[Document, ...]:
    """Authorize before hydration, then rerank only the authorized subset."""
    if (
        not isinstance(query, str)
        or not query.strip()
        or len(query) > MAX_QUERY_LENGTH
    ):
        return ()
    authorized_ids = authorize_ids(
        candidate_ids, auth=auth, catalog=catalog, policy=policy
    )
    documents = tuple(
        loader.load(document_id, catalog[document_id].tenant_id or "")
        for document_id in authorized_ids
    )
    return reranker.rerank(query, documents)


def demo() -> None:
    # Metadata catalog is separate from text: constructing it reads no document text.
    catalog = {
        "a-public": DocumentMetadata("a-public", "tenant-a"),
        "a-denied": DocumentMetadata("a-denied", "tenant-a"),
        "b-secret": DocumentMetadata("b-secret", "tenant-b"),
        "unclassified": DocumentMetadata("unclassified", None),
    }
    text_by_id = {
        "a-public": "Synthetic tenant A document.",
        "a-denied": "Synthetic denied A document.",
        "b-secret": "Synthetic tenant B secret.",
        "unclassified": "Synthetic document without tenant classification.",
    }
    policy = PolicySnapshot({("tenant-a", "principal-a"): frozenset({"a-public"})})
    loader = TextLoaderSpy(text_by_id)
    reranker = RerankerSpy()
    result = run_query(
        "synthetic query",
        ("a-public", "a-denied", "b-secret", "unclassified", "unknown-id"),
        auth=AuthContext("principal-a", "tenant-a"),
        catalog=catalog,
        policy=policy,
        loader=loader,
        reranker=reranker,
    )
    print("result_ids:", [document.document_id for document in result])
    print("hydrated_ids:", loader.hydrated_ids)
    print("reranker_input_ids:", reranker.input_ids)


if __name__ == "__main__":
    demo()
code/test_auth_boundary.py · ยังไม่ได้รัน
"""Auth boundary specifications. Authored; NOT RUN."""

import unittest

from auth_boundary import (
    AuthContext,
    DocumentMetadata,
    PolicySnapshot,
    RerankerSpy,
    TextLoaderSpy,
    authorize_ids,
    run_query,
)


class AuthorizationBoundaryTests(unittest.TestCase):
    def test_absent_or_malformed_policy_does_not_hydrate(self) -> None:
        for policy in (None, PolicySnapshot(None), PolicySnapshot({})):  # type: ignore[arg-type]
            loader = TextLoaderSpy(self.texts)
            reranker = RerankerSpy()
            result = run_query(
                "q", ("a-allowed",), auth=self.auth, catalog=self.catalog,
                policy=policy, loader=loader, reranker=reranker,  # type: ignore[arg-type]
            )
            self.assertEqual(result, ())
            self.assertEqual(loader.hydrated_ids, [])
            self.assertEqual(reranker.input_ids, [])

    def setUp(self) -> None:
        self.catalog = {
            "a-allowed": DocumentMetadata("a-allowed", "tenant-a"),
            "a-denied": DocumentMetadata("a-denied", "tenant-a"),
            "b-secret": DocumentMetadata("b-secret", "tenant-b"),
            "unclassified": DocumentMetadata("unclassified", None),
        }
        self.texts = {key: f"synthetic {key}" for key in self.catalog}
        self.policy = PolicySnapshot(
            {("tenant-a", "principal-a"): frozenset({"a-allowed"})}
        )
        self.auth = AuthContext("principal-a", "tenant-a")

    def test_only_explicitly_allowed_same_tenant_id_is_hydrated_and_reranked(self) -> None:
        loader = TextLoaderSpy(self.texts)
        reranker = RerankerSpy()
        result = run_query(
            "q",
            ("a-allowed", "a-denied", "b-secret", "unclassified", "missing"),
            auth=self.auth,
            catalog=self.catalog,
            policy=self.policy,
            loader=loader,
            reranker=reranker,
        )
        self.assertEqual([doc.document_id for doc in result], ["a-allowed"])
        self.assertEqual(loader.hydrated_ids, ["a-allowed"])
        self.assertEqual(reranker.input_ids, ["a-allowed"])
        for forbidden in ("a-denied", "b-secret", "unclassified", "missing"):
            self.assertNotIn(forbidden, loader.hydrated_ids)
            self.assertNotIn(forbidden, reranker.input_ids)

    def test_missing_principal_policy_denies_all(self) -> None:
        self.assertEqual(
            authorize_ids(
                ("a-allowed",),
                auth=AuthContext("unlisted-principal", "tenant-a"),
                catalog=self.catalog,
                policy=self.policy,
            ),
            (),
        )

    def test_empty_or_invalid_context_denies_all(self) -> None:
        for auth in (
            AuthContext("", "tenant-a"),
            AuthContext("principal-a", " "),
            None,
            "not-an-auth-context",
            AuthContext("p" * 129, "tenant-a"),
        ):
            self.assertEqual(
                authorize_ids(
                    ("a-allowed",),
                    auth=auth,
                    catalog=self.catalog,
                    policy=self.policy,
                ),
                (),
            )

    def test_oversized_candidate_batch_and_malformed_id_are_denied(self) -> None:
        self.assertEqual(
            authorize_ids(
                tuple("a-allowed" for _ in range(51)),
                auth=self.auth,
                catalog=self.catalog,
                policy=self.policy,
            ),
            (),
        )
        self.assertEqual(
            authorize_ids(
                (None, "x" * 129, "a-allowed"),  # type: ignore[arg-type]
                auth=self.auth,
                catalog=self.catalog,
                policy=self.policy,
            ),
            ("a-allowed",),
        )

    def test_wrong_tenant_is_denied_even_if_policy_mentions_id(self) -> None:
        policy = PolicySnapshot(
            {("tenant-a", "principal-a"): frozenset({"b-secret"})}
        )
        self.assertEqual(
            authorize_ids(
                ("b-secret",), auth=self.auth, catalog=self.catalog, policy=policy
            ),
            (),
        )

    def test_catalog_key_metadata_id_mismatch_is_denied(self) -> None:
        altered = dict(self.catalog)
        altered["a-allowed"] = DocumentMetadata("different-id", "tenant-a")
        self.assertEqual(
            authorize_ids(
                ("a-allowed",), auth=self.auth, catalog=altered, policy=self.policy
            ),
            (),
        )

    def test_duplicates_unknown_ids_and_query_bounds_do_not_reach_stages(self) -> None:
        loader = TextLoaderSpy(self.texts)
        reranker = RerankerSpy()
        result = run_query(
            "q",
            ("a-allowed", "a-allowed", "missing"),
            auth=self.auth,
            catalog=self.catalog,
            policy=self.policy,
            loader=loader,
            reranker=reranker,
        )
        self.assertEqual([doc.document_id for doc in result], ["a-allowed"])
        self.assertEqual(loader.hydrated_ids, ["a-allowed"])
        loader.hydrated_ids.clear()
        reranker.input_ids.clear()
        run_query(
            "q" * 2049,
            ("a-allowed",),
            auth=self.auth,
            catalog=self.catalog,
            policy=self.policy,
            loader=loader,
            reranker=reranker,
        )
        self.assertEqual(loader.hydrated_ids, [])
        self.assertEqual(reranker.input_ids, [])

    def test_replacement_policy_applies_to_next_request_snapshot(self) -> None:
        loader = TextLoaderSpy(self.texts)
        reranker = RerankerSpy()
        revoked = PolicySnapshot({("tenant-a", "principal-a"): frozenset()})
        result = run_query(
            "q",
            ("a-allowed",),
            auth=self.auth,
            catalog=self.catalog,
            policy=revoked,
            loader=loader,
            reranker=reranker,
        )
        self.assertEqual(result, ())
        self.assertEqual(loader.hydrated_ids, [])
        self.assertEqual(reranker.input_ids, [])

    def test_client_claims_do_not_mutate_trusted_context_or_policy(self) -> None:
        # The request payload is deliberately not an input to run_query.
        client_payload = {"tenant_id": "tenant-b", "grants": ["b-secret"]}
        trusted_auth = AuthContext("principal-a", "tenant-a")
        self.assertEqual(client_payload["tenant_id"], "tenant-b")
        self.assertEqual(trusted_auth.tenant_id, "tenant-a")
        self.assertNotIn(
            "b-secret", self.policy.allowed_by_principal[("tenant-a", "principal-a")]
        )
        loader = TextLoaderSpy(self.texts)
        reranker = RerankerSpy()
        run_query(
            "q",
            ("b-secret",),
            auth=trusted_auth,
            catalog=self.catalog,
            policy=self.policy,
            loader=loader,
            reranker=reranker,
        )
        self.assertEqual(loader.hydrated_ids, [])
        self.assertEqual(reranker.input_ids, [])


if __name__ == "__main__":
    unittest.main()
README-code.md · ยังไม่ได้รัน
# Offline RAG authorization boundary example

This Python 3.12+ example demonstrates authorization at the document boundary. The server supplies a trusted `AuthContext` and server-owned policy. Retrieval supplies candidate IDs. The code checks each candidate against metadata and policy before loading text, then sends only authorized documents to the reranker.

## Runtime and setup

- Python 3.12 or newer
- Python standard library only
- No environment variables, installation, API keys, database, vector service, network access, or GPU
- All fixtures are synthetic and held in memory

## Run the mock

From this directory, run:

```text
python code/auth_boundary.py
```

Expected output (illustrative; not observed by running the code):

```text
result_ids: ['a-public']
hydrated_ids: ['a-public']
reranker_input_ids: ['a-public']
```

## Run the authored checks

```text
python -m unittest discover -s code -p "test_*.py"
```

The checks are authored but **NOT RUN**. Do not interpret the expected output or the test code as a test result.

## Scope and limits

This mock assumes `AuthContext`, the tenant-scoped policy snapshot, and metadata catalog have already been established by trusted server code; it does not authenticate users or verify that these inputs are authentic. Client request fields do not establish identity or grants. The catalog is metadata-only and is separate from the text loader, so denied text is not fetched by this pipeline. A real vector/search provider might expose snippets before returning IDs and must be designed to prevent that. A replacement policy snapshot applies to the next request in this synchronous illustration; concurrent revocation races are out of scope. The example does not validate a real provider, establish retrieval quality, or make performance claims. It reads no files or external data and has no paid service cost. **Mock** only; no **Sandbox** or **Live** integration is supplied.
ใส่ความเห็น