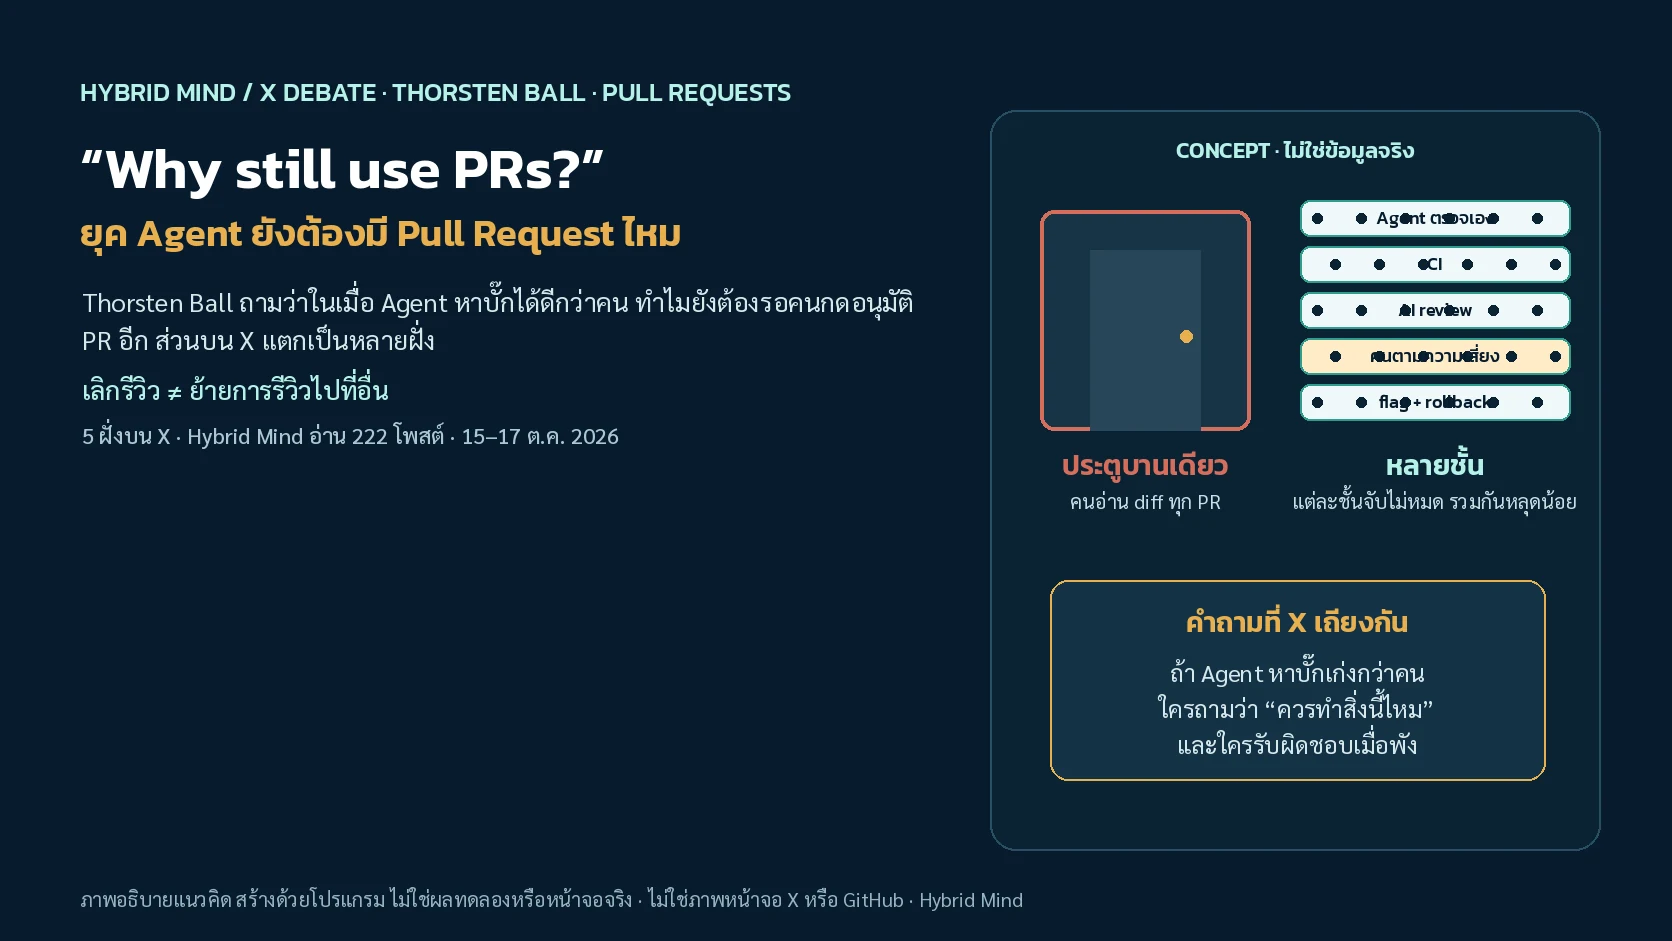
คำถาม “ทำไมยังใช้ Pull Request อยู่” ไม่ได้มีคำตอบเดียว เพราะ PR ไม่ได้มีหน้าที่เดียว Thorsten Ball จากทีม Amp โพสต์เมื่อ 16 ต.ค. 2026 ว่าโมเดลอย่าง Opus 5.5, Fable หรือ Astra หาบั๊กได้ดีกว่าที่เพื่อนร่วมทีมจะหาเจอ งานแชร์ความรู้ทำผ่าน explainer ได้ และ Agent รันเทสต์ก่อน push อยู่แล้ว ทีมของเขาจึง push เข้า main ตรง ๆ โพสต์นี้มี impressions ราว 1.6 แสนครั้ง และมีคนตอบ 266 ครั้ง ณ เวลาที่เราอ่าน
ฝั่งที่ไม่เห็นด้วยไม่ได้เถียงว่า AI หาบั๊กไม่เก่ง แต่บอกว่า PR มีไว้ถามว่า “ควรทำสิ่งนี้ไหม” เก็บหลักฐานไว้ตรวจย้อนหลัง และกันไม่ให้ Agent push อะไรก็ได้เข้า main ในวันเดียวกัน Anthropic เผยแพร่วิธีรีวิวโค้ดของทีม Claude Code ซึ่งเป็นทางสายกลาง ทีมนี้ยังใช้ PR แต่ให้เครื่องอ่านโค้ดเกือบทั้งหมด แล้วกำหนดจำนวนคนที่ต้องอนุมัติตามความเสี่ยงของ change ตั้งแต่ไม่ต้องมีเลยจนถึงสองคน หลักฐานตอนนี้หนุนเรื่อง “ย้ายการรีวิวไปไว้ก่อนและหลัง PR” มากกว่าเรื่อง “เลิกรีวิว”

Thorsten Ball ถามอะไร และทำไมนักพัฒนาถึงตอบกันเป็นร้อย
“Why are you still using pull requests?”
Thorsten Ball (@thorstenball) ซึ่งไบโอระบุว่าทำงานที่ @ampcode ไล่ถามทีละเหตุผลว่าคนยังใช้ PR เพื่ออะไร ถ้าเพื่อ code review เขาถามว่าเราคิดจริงหรือว่าตัวเองจะเจอบั๊กที่ Opus 5.5, Fable หรือ Astra หาไม่เจอ “You can literally spawn all three of them and have them check four times each.” ถ้าเพื่อแชร์ความรู้ เขาบอกว่าตอนนี้โมเดลสร้างวิดีโออธิบาย สไลด์ ควิซ หรือ walkthrough ของโค้ดได้แล้ว
เรื่อง CI เขาชี้ว่าคำว่า continuous integration เดิมหมายถึงตรงข้ามกับการมี branch อายุยาวและ PR และปิดท้ายว่า “With agents you can now move 10x faster” เขายอมรับในโพสต์เดียวกันว่างาน open source อาจต่างออกไป เพราะเขาไม่ได้ร่วม OSS มา 2 ปีแล้ว โพสต์ต้นทาง ↗
ทีม Amp ทำงานแบบไหน (ตามที่ Ball เล่าเอง)
ก่อนโพสต์หลักราวหนึ่งชั่วโมง Ball เล่าขั้นตอนของทีมว่า push เข้า main แล้ว Buildkite รันเทสต์และ build image ต่อด้วย GitHub Actions ที่ตรวจความปลอดภัยของ infrastructure ถ้า check ไหนล้ม deployment จะถูกบล็อกและแจ้งคน commit ใน Slack ถ้าผ่านจะ deploy ขึ้น staging แล้วค่อยขึ้น prod ซึ่งปกติใช้เวลาราว 10 นาที ↗
ในคำตอบภายหลังเขาบอกว่าทีมไม่มี mandatory code review เป็นทีมเล็กที่มีวิศวกรซึ่งได้รับความไว้ใจสูง ใช้ feature flag กับงานที่ไม่แน่ใจ และคุยเรื่อง architecture ใน thread หรือ “orbs” แทนคอมเมนต์ใน GitHub ↗ และยืนยันว่า Amp “never had PRs” มาตั้งแต่ยังไม่มีผลิตภัณฑ์ ↗

- บล็อก claude.dev เผยแพร่ “How the Claude Code team does code review” โดย Addy Osmani, Morgan Westlee Lunt และ Qing Wang และ Code Review for Claude Code เปิดใช้ทั่วไปสำหรับแพ็กเกจ Team กับ Enterprise
- Ball โพสต์รายละเอียดว่าทีม Amp push เข้า main และให้ CI บล็อกที่ขั้น deploy แทน
- Ball โพสต์ “Why are you still using pull requests?” ซึ่งกลายเป็นโพสต์หลักของวงถก
- Kieran Klaassen ตอบว่า “I’m Team No Pull Requests.” และ Lauren Tan (@poteto) โพสต์วิธีทำให้ไว้ใจงานของ Agent มากขึ้น ซึ่งวางการรีวิวโดยคนไว้ชั้นล่างสุด
- Matt Pocock ตอบว่าบาง change เป็น “one way doors” Rhys Sullivan โพสต์ว่าโมเดลชอบเพิ่มโค้ดสำหรับเคสที่ไม่มีวันเกิด และบัญชี @ClaudeDevs โพสต์ตัวเลขว่า Claude เขียนโค้ดของ Claude Code ราว 90%
เวลาทั้งหมดเป็นเวลาไทย (UTC+7) ตัวเลข like และ impressions เป็นค่า ณ เวลาที่เราอ่าน ราว 06:55–07:05 น. ของ 17 ต.ค. ตัวเลขเปลี่ยนได้ตลอด
ทำไมถึงเถียงกัน: PR หนึ่งอันทำงานหลายอย่างในคราวเดียว
PR เกิดขึ้นในยุคที่คนเขียนโค้ดด้วยมือ ความเร็วในการเขียนจึงพอ ๆ กับความเร็วในการอ่าน วันนี้ Agent เขียน diff ได้เร็วกว่าคนอ่านมาก Anthropic เขียนไว้ว่าใน monorepo ของบริษัท change ที่ merge ต่อวันเพิ่มจากราว 2,500 ในเดือนพฤษภาคม เป็นมากกว่า 30,000 ในเดือนกันยายน และบอกตรง ๆ ว่าที่ความเร็วนี้ “manual, line-by-line code review is incredibly difficult if not impossible”
ปัญหาคือคนแต่ละฝั่งพูดถึง PR คนละหน้าที่ Ball ตั้งคำถามกับหน้าที่ “หาบั๊ก” กับ “ให้ CI รัน” ซึ่ง Agent กับระบบอัตโนมัติทำแทนได้มากขึ้นจริง ส่วนฝั่งที่ค้านพูดถึงหน้าที่ “ตกลงกันว่าควรสร้างสิ่งนี้ไหม” “เก็บเหตุผลไว้” และ “กันไม่ให้ใครหรืออะไร push เข้า main เอง” ซึ่งยังไม่มีใครพิสูจน์ว่าเครื่องทำแทนได้

งานวิจัยก่อนยุค Agent บอกว่า code review ไม่ได้มีไว้หาบั๊กอย่างเดียวมาตั้งแต่แรก งานของ Bacchelli และ Bird ที่ Microsoft (ICSE 2013) พบว่าการหาข้อบกพร่องเป็นแรงจูงใจอันดับแรกของคนที่รีวิว แต่ผลจริงที่ได้จากการรีวิวเป็นเรื่องบั๊กน้อยกว่าที่คาด และส่วนใหญ่ได้เรื่องการถ่ายทอดความรู้ การรู้ว่าทีมทำอะไรอยู่ และทางแก้ที่ดีกว่า งานของ Google (ICSE SEIP 2018) ซึ่งดู log ของ change ที่ผ่านการรีวิว 9 ล้านรายการ ก็พบว่าเหตุผลที่บริษัทใช้ code review ไม่ได้มีแค่หาบั๊ก แต่รวมถึงการสอนกัน การรักษามาตรฐานของโค้ด และการคุมว่าใครเปลี่ยนอะไร ทั้งสองข้อนี้เป็นผลจากงานวิจัยก่อนยุค Agent ไม่ใช่ผลทดลองกับทีมที่ใช้ Agent
5 ฝั่งที่เห็นบน X
เราจัดกลุ่มจากตัวอย่างที่ดึงมาเอง ไม่ได้วัดว่าแต่ละฝั่งมีกี่เปอร์เซ็นต์ บัญชีบุคคลทั่วไปที่ไม่ใช่บุคคลสาธารณะ เราสรุปความโดยไม่ระบุชื่อ แต่ยังใส่ลิงก์ให้ตรวจต้นฉบับได้

ฝั่ง 1 — “Team No Pull Requests: PR คือพิธีกรรมที่ทำให้ช้า”
Ball, Kieran Klaassen และนักพัฒนาที่ทำงานในทีมเล็กหรือโปรเจกต์ส่วนตัว
- Kieran Klaassen (@kieranklaassen) quote โพสต์ของ Ball สั้น ๆ ว่า “I’m Team No Pull Requests.” โพสต์นี้มี impressions ราว 5 หมื่นครั้ง ↗
- นักพัฒนาคนหนึ่งบอกว่าเริ่มเอียงไปทาง no PRs เพราะ PR เป็นคอขวด ถ้า change ไม่ได้เสี่ยงสูงก็ควรพึ่งชั้นตรวจสอบอัตโนมัติ และ “Humans make mistakes and miss things too.” ↗
- อีกบัญชีพูดแรงกว่าว่า PR code review เป็น “the biggest scam and waste of everyone’s time” เพราะทำแบบเดียวกันได้ก่อน push ↗
- นักพัฒนาที่ทำงานทีมเล็กเล่าว่า push เข้า main เร็วกว่ามาก และ AI ช่วยเขียนคำอธิบาย change ให้ จึงได้เอกสารเพิ่มโดยไม่ต้องเปิด PR ↗
แก่นของฝั่งนี้: ถ้าบั๊กส่วนใหญ่ถูกจับก่อน push แล้ว การรอคนกดอนุมัติเป็นต้นทุนที่ไม่ได้อะไรเพิ่ม และ Ball ยกตัวอย่างช่อง Slack แบบ “stamp plz” ที่คนขอให้กดอนุมัติโดยไม่ได้อ่านจริง
ฝั่ง 2 — “PR ไม่ได้มีไว้หาบั๊ก แต่มีไว้ถามว่าควรทำไหม”
นักพัฒนาจำนวนมากใน quote และ reply ฝั่งนี้เป็นเสียงที่เราเห็นบ่อยที่สุดในตัวอย่าง แต่ไม่ได้แปลว่าเป็นเสียงส่วนใหญ่บน X
- บัญชีหนึ่งสรุปว่ารีวิว PR ตอบสามคำถาม “are we doing the right thing? are we doing it in the right way? can we do it better?” และบอกว่าเหตุผลของ change “is never gonna be clearer than before it settles in the codebase” ↗
- นักพัฒนาอีกคนเขียนว่า Agent หาบั๊กเก่งกว่าเขา แต่สิ่งที่ทำไม่ได้คือบอกว่า “we shouldn’t ship this at all” เพราะโมเดลสามตัวตรวจสี่รอบ “will happily approve a perfectly correct feature nobody asked for” ↗
- อีกคนบอกว่าความผิดพลาดที่เจอใน PR ไม่ใช่ coding mistake แต่เป็น alignment mistake คือ Agent ไปแก้ของสำคัญที่เขาไม่ได้สั่ง ↗ Ball ตอบว่าถ้าเพิ่งมาเจอเรื่องนี้ตอนโค้ดเขียนเสร็จและ push แล้ว “isn’t that too late?” ↗
แก่นของฝั่งนี้: สองฝั่งแรกเห็นตรงกันมากกว่าที่คิด ทั้งคู่ยอมรับว่าการตัดสินว่า “ควรทำไหม” ยังต้องเป็นคน ที่ต่างกันคือควรตัดสินที่ PR หรือก่อนเริ่มเขียน
ฝั่ง 3 — “AI รีวิวยังไม่พอ คนยังเจอสิ่งที่โมเดลพลาด”
นักพัฒนาที่ใช้ Agent ทุกวันแล้วเล่าประสบการณ์ตรง
- Rhys Sullivan (@RhysSullivan) เขียนว่า “the models love to add so much extra code for cases that will never happen” เขายกตัวอย่างว่าระบบรีวิวไป “จับ” เคสเปลี่ยน setting พร้อมกับถูกลดสิทธิ์ admin ในคำขอเดียวกัน ซึ่งไม่มีผู้ใช้คนไหนเจอ แต่กลับพลาดเรื่องที่ “grind down your codebase quality over time” ↗
- นักพัฒนาที่ทำ web framework ภาษา Rust เล่าว่า Astra เขียน cookie middleware ที่ไม่ใช้ระบบ middleware เดิม แต่สร้างชั้น dispatch ใหม่ซ้ำกับของเดิม และเมื่อให้ Claude รีวิว PR นั้น “it waved it through” ↗
- อีกคนบอกว่ายังเจอบั๊กตอนรีวิว ไม่ใช่บั๊กแบบเขียนผิด แต่เป็นสมมติฐานที่ผิดเรื่องพฤติกรรมของระบบ และการให้ Agent รีวิวเรื่องแบบนี้ “can send in circles” ↗
- บางคนชี้ว่าให้ 10 session รีวิว PR เดียวกันจะได้ผลต่างกันทั้ง 10 ครั้ง เพราะโมเดลไม่ deterministic ↗
แก่นของฝั่งนี้: โมเดลอาจจับบั๊กระดับบรรทัดได้ดีกว่าคน แต่ปัญหาที่สะสมช้า ๆ อย่างโค้ดเกินจำเป็น โครงสร้างซ้ำซ้อน และรสนิยมของ codebase ยังต้องมีคนดู
ฝั่ง 4 — “ทีมเล็กทำได้ องค์กรใหญ่ OSS และงานที่มีกฎระเบียบทำไม่ได้”
วิศวกรในองค์กรใหญ่ ผู้ดูแล open source และคนที่ทำงานด้าน compliance
- Romain Lanz (@romainlanz) “Hard disagree” เพราะ PR รวม commit ที่เกี่ยวกันเป็น change เดียว ทำให้ commit ระหว่างทางของ Agent ไม่ปนเข้า main และ “Required PRs on a protected default branch keep agents from pushing whatever they want straight to main.” เขาสรุปว่าถ้าทางเลือกใหม่คือทำบน branch ให้ Agent ตรวจ แล้วค่อย merge “You’re basically doing the same thing under a different name.” ↗
- มีคนถามว่าถ้ามีข้อผูกพัน SOC 2 ที่ต้องให้คนอนุมัติจะทำอย่างไร ↗ Ball ตอบว่า “We have SOC2” แล้วแนบโพสต์ขั้นตอน deploy ของทีม ↗ อีกบัญชีถามต่อเรื่อง SOX ซึ่งเป็นกฎหมายด้านบัญชีของบริษัทมหาชนในสหรัฐฯ ↗
- วิศวกรคนหนึ่งตอบ Ball ว่ามุมมองนี้มาจากสตาร์ทอัพเล็กที่มีคนเก่งหนาแน่น และ “this simply isn’t possible to fully give up PRs at a larger organisation” ↗ ส่วน Daniel Miessler (@DanielMiessler) บอกว่า PR เป็น “collaborative artifacts” ที่จำเป็นกว่าเมื่อมีคนจำนวนมากใน codebase เดียว ↗
- อีกหลายคนชี้ว่า PR คือ “the paper trail you dig through at 3am when everything’s on fire” ↗ และใน OSS ปล่อยให้คนแปลกหน้า push เข้า main ไม่ได้ ↗
แก่นของฝั่งนี้: สิ่งที่ Amp ทำได้ขึ้นกับเงื่อนไขเฉพาะ คือทีมเล็ก ไว้ใจกันสูง และไม่มีคนนอกส่งโค้ดเข้ามา เงื่อนไขเหล่านี้ไม่ได้มีทุกที่
ฝั่ง 5 — “ไม่ใช่ขาวกับดำ: แบ่งตามความเสี่ยง และ PR จะเล็กลงเป็นบันทึกการตัดสินใจ”
วิศวกรอาวุโสและคนที่ออกแบบ workflow ของ Agent
- Matt Pocock (@mattpocockuk) ตอบ Ball ว่า “Some changes are one way doors” และ PR ช่วยแนบเหตุผลของ change โดยไม่ทำให้ repo บวม “But most of my PR’s automerge” ↗
- Filip Pizlo (@filpizlo) เขียนว่า “It’s not so binary.” บางงาน Agent ทำได้ดีมากจนเขาให้ commit และ push เอง แต่บางงานยังแย่ จึงต้องพึ่งคน และเขาหาว่างานไหนเป็นแบบไหนด้วยการลองให้ Agent ทำทุกด้าน ↗
- Lauren Tan (@poteto) เสนอพีระมิดกลับหัวของความไว้ใจ ชั้นบนสุดคือปรับ codebase ให้ type และขอบเขตชัด ตามด้วย static analysis และเทสต์ แล้วจึงเป็นคำสั่งเป็นข้อความอย่าง AGENTS.md ส่วนการรีวิวโดยคนอยู่ล่างสุดเพราะ “the hardest to scale” ↗
- อีกบัญชีสรุปว่า PR รวมสามงานไว้ด้วยกัน คือรีวิว ถ่ายทอดความรู้ และประตู merge Agent ทำสองงานแรกได้มากขึ้น แต่ความรับผิดชอบยังอยู่ “The PR won’t vanish; it shrinks into a decision log.” ↗
แก่นของฝั่งนี้: ใกล้กับสิ่งที่ Anthropic อธิบายว่าทำจริงมากที่สุด เราจะดูรายละเอียดในหัวข้อถัดไป
ข้อสังเกตเรื่องผลประโยชน์: Ball ทำงานที่ Amp ซึ่งเป็นเครื่องมือ coding agent และพูดถึงฟีเจอร์ของ Amp อย่าง thread กับ orbs ในคำตอบ มีบางบัญชีตอบว่าเขากำลังโปรโมตผลิตภัณฑ์ ↗ ข้อนี้เป็นความเห็นของผู้ตอบ เราไม่ได้ตรวจเจตนา แต่ผู้อ่านควรรู้ว่าทั้ง Amp และ Anthropic มีผลิตภัณฑ์ที่เกี่ยวกับเรื่องนี้
Anthropic ไม่ได้เลิก PR แต่ย้ายการอ่านไปให้เครื่อง และให้คนตัดสินตามความเสี่ยง
บล็อกของทีม Claude Code เปิดด้วยประโยค “We didn’t remove review. But we did move most of the reading to machines” และบอกว่าคำถาม “did a human read the code?” เป็นตัวแทนที่ไม่แม่นของคำถามจริง คือ “what could go wrong with this change, and which check—automated or human—is the right one to catch it?” การรีวิวจึงเปลี่ยนจากประตูบานเดียวท้ายทาง เป็นการตรวจต่อเนื่อง “more like spellcheck while you write”


มีสามกฎในบล็อกที่ตอบข้อกังวลของฝั่ง 2 ถึง 4 โดยตรง ข้อแรก “An agent’s approval never counts as a person’s” ข้อสอง คนที่สั่ง Agent ให้เขียน change นับเป็นผู้รีวิวที่ต้องรับผิดชอบคนหนึ่ง เหมือนพิมพ์โค้ดเอง ข้อสาม ทางลัดที่ไม่ต้องมีคนอนุมัติใช้ได้เฉพาะผู้เขียนที่อยู่ในรายชื่อที่ไว้ใจของ repo นั้น คนอื่นต้องมีอีกคนอนุมัติเสมอ
บล็อกยังพูดถึงเรื่องที่ฝั่ง 2 ห่วงด้วย งานที่คนยังต้องตัดสินคือ “Should we build this at all?” โค้ดเสี่ยงอย่าง billing กับ auto-updater, architecture ที่คนอื่นจะลอกตาม, การอ่านหลักฐาน และความรับผิดชอบต่อผลลัพธ์ ทีมแนะนำให้ยกเรื่องเปลี่ยนทิศทาง “early, not as a blocking comment on a finished PR” ซึ่งตรงกับที่ Ball ถามว่ารอเจอที่ PR “isn’t that too late?”
ทุกตัวเลขในกล่องนี้เป็นตัวเลขที่ Anthropic รายงานเองในบล็อก ยังไม่มีการตรวจอิสระ และเป็นความสัมพันธ์ในช่วงเวลาเดียวกัน ไม่ได้พิสูจน์ว่าการรีวิวแบบใหม่เป็นสาเหตุที่ทำให้ revert ลดลง

เรื่องรีวิวที่ไม่จบ ทีมใช้คำสั่ง git blame กับสิ่งที่ระบบรีวิวแจ้งซ้ำ ๆ แล้วพบว่าราว 59% เป็นโค้ดที่อยู่มาตั้งแต่รอบรีวิวแรก แปลว่าแต่ละรอบไม่ได้เจอบั๊กใหม่ แต่ขุดบั๊กเก่าเพิ่มทีละนิด ทีมจึงจำกัดไว้ที่สามรอบ หลังจากนั้นให้ผู้เขียนถอยมาคิดวิธีใหม่ รีวิวซ้ำเฉพาะ diff ใหม่ และไม่แจ้ง finding เดิมซ้ำ บล็อกบอกด้วยว่า noise แพงขึ้นเมื่อผู้เขียนเป็น Agent เพราะคนปัดคอมเมนต์เล็ก ๆ ทิ้งได้ในไม่กี่วินาที แต่ Agent จะแก้ทุกข้อ ทำให้เกิด commit และรอบรีวิวเพิ่ม
ลองเอง: ประตูเดียว หรือหลายชั้น
ทั้งสามแล็บเป็นการจำลองเชิงการศึกษาแบบสูตรตายตัวที่ Hybrid Mind ตั้งขึ้นเอง ตัวเลขทุกตัวเป็นค่าสมมติ ไม่ใช่ข้อมูลของ Amp, Anthropic หรือทีมใด
ทดลอง 01 — ชั้นตรวจหลายชั้น: ปัญหาแบบไหนหลุดถึงผู้ใช้
การจำลองเชิงการศึกษา ไม่ใช่ผลวัดจริง สมมติว่าทีมส่ง 1,000 change ต่อสัปดาห์ และใน change เหล่านั้นมีปัญหาสามแบบ คือบั๊กระดับโค้ด 60 ครั้ง, ทำของที่ไม่ควรทำหรือแก้เกินคำสั่ง 25 ครั้ง และโค้ดเกินจำเป็นที่ทำให้ codebase แย่ลงช้า ๆ 40 ครั้ง เปิดปิดแต่ละชั้นแล้วดูว่าอะไรหลุดไปถึง main และใช้เวลาคนเท่าไร
สูตร: แต่ละชั้นมีโอกาสจับปัญหาแต่ละแบบคงที่ ค่าที่หลุดคือผลคูณของโอกาสที่ไม่ถูกจับในทุกชั้นที่เปิด เวลาคนคิดจาก 12 นาทีต่อการรีวิว diff หนึ่งครั้ง และ 20 นาทีต่อการตกลงทิศทางหนึ่งงาน (สมมติว่า 1 งานมี 10 change)
ทดลอง 02 — ตัวเลือกระดับความเสี่ยง: change นี้ต้องมีคนอนุมัติกี่คน
การจำลองเชิงการศึกษาที่ดัดแปลงจากหลักที่บล็อก Anthropic เขียนไว้ ไม่ใช่ classifier จริงของบริษัทใด และไม่ใช่คำแนะนำด้าน compliance เลือกประเภท change และเงื่อนไข แล้วดูว่าควรมีคนอนุมัติกี่คน
ประเภท change
ทดลอง 03 — Agent รีวิว Agent: ทำไมบาง PR วน 50 รอบ
การจำลองเชิงการศึกษาแบบสูตรตายตัว ไม่ใช่ข้อมูลของ Anthropic ทุกรอบ ผู้รีวิวเจอปัญหาจริงที่เหลืออยู่ส่วนหนึ่ง และแจ้งคอมเมนต์จุกจิกจำนวนหนึ่ง ผู้เขียนที่เป็น Agent แก้ทุกข้อ ซึ่งบางครั้งทำให้เกิดคอมเมนต์ใหม่ ปรับค่าแล้วดูว่ารีวิวจบเมื่อไร
คอมเมนต์จุกจิกต่อรอบ
โอกาสที่การแก้หนึ่งข้อสร้างคอมเมนต์ใหม่ (%)
จำกัดจำนวนรอบ
หลักฐานหนุนอะไร และอะไรยังพิสูจน์ไม่ได้
สิ่งที่หลักฐานสนับสนุน
- ทีมที่ change เยอะมากเลิกรีวิวทีละบรรทัดได้โดยที่ revert ไม่เพิ่ม อย่างน้อยตามตัวเลขที่ Anthropic รายงานเอง แต่ทีมนั้นไม่ได้เลิก PR และยังให้คนตัดสิน change ที่เสี่ยง
- คำว่า continuous integration เดิมหมายถึงการรวมงานเข้า mainline บ่อย ๆ ตามที่ Ball พูด บทความของ Martin Fowler อธิบายไว้แบบนั้น และ DORA ระบุว่ากระบวนการ code review ที่หนักเกินไปเป็นอุปสรรคที่พบบ่อยของ trunk-based development
- Code review ทำงานหลายอย่างนอกจากหาบั๊กมานานแล้ว ตามงานวิจัยของ Microsoft และ Google ที่อ้างถึงด้านบน
- ผลิตภัณฑ์ AI review ยังไม่ได้อ้างว่าแทนคนได้ เอกสารของ Code Review for Claude Code เขียนว่า “A review never approves or blocks the pull request” และรีวิวที่ไม่มี finding “doesn’t mean your code is error-free or secure”
สิ่งที่ยังพิสูจน์ไม่ได้
- ข้อที่ว่าโมเดลจะเจอบั๊กทุกอย่างที่คนเจอ เรายังไม่พบงานวัดอิสระที่เทียบแบบนี้ และประสบการณ์ในฝั่ง 3 ชี้ว่าปัญหาบางแบบยังหลุด
- ตัวเลข “10x faster” ของ Ball เป็นความเห็นจากประสบการณ์ ไม่ได้มีการวัดที่เผยแพร่
- วิธีของ Amp ใช้กับองค์กรใหญ่หรืองานที่มีกฎระเบียบได้ไหม Ball บอกว่าทีมมี SOC 2 แต่เราไม่ได้เห็นรายงานหรือ control ที่ผู้ตรวจรับรอง
- ตัวเลขไวรัลบางโพสต์ เช่น “72% ของ PR มีโค้ดจาก AI” หรือ “เวลารีวิวลดจาก 14 ชั่วโมงเหลือ 18 นาที” ไม่มีแหล่งที่มา เราจึงไม่นำมาใช้
| คำกล่าว | สถานะ | ต้นทาง |
|---|---|---|
| Ball บอกว่าทีม Amp ไม่เคยใช้ PR และ push เข้า main | ยืนยัน (คำบอกเล่าของเขาเอง) | โพสต์ของ @thorstenball 16 ต.ค. 2026 |
| Anthropic เลิกใช้ PR แล้ว | คลาดเคลื่อน | บล็อกบอกว่า “We didn’t remove review” และทุก PR ยังผ่าน CI, AI review และ security review |
| Claude เขียนโค้ดของ Claude Code ราว 90% | Anthropic อ้างเอง | บล็อก claude.dev และโพสต์ @ClaudeDevs ยังไม่มีการตรวจอิสระ |
| การอนุมัติของ Agent ใช้แทนคนได้ที่ Anthropic | คลาดเคลื่อน | บล็อกเขียนว่า “An agent’s approval never counts as a person’s” |
| Code Review for Claude Code อนุมัติหรือบล็อก PR ได้เอง | คลาดเคลื่อน | เอกสาร code.claude.com ระบุว่ารีวิวไม่อนุมัติและไม่บล็อก PR ส่วนบล็อกเล่าว่าใน repo ภายใน ทีมตั้งให้ finding ที่ยังเปิดบล็อกการ merge |
| AI review ทำให้ revert ลด 40% | ยังสรุปไม่ได้ | เป็นตัวเลขที่เกิดในช่วงเดียวกันตามที่ Anthropic รายงาน ไม่ได้พิสูจน์ว่าเป็นสาเหตุ |
เอาไปใช้ยังไง
สำหรับนักพัฒนาเดี่ยวหรือทีมเล็ก
push เข้า main ได้ถ้ามีสามอย่างครบ คือ CI ที่บล็อก deploy เมื่อล้ม, feature flag สำหรับงานที่ไม่แน่ใจ และ rollback ที่ทำได้ในไม่กี่นาที ถ้ายังขาดข้อใดข้อหนึ่ง การตัด PR ออกคือการตัดตาข่ายชั้นสุดท้าย
สำหรับทีมที่ใช้ Agent เยอะ
ย้ายการคุยว่า “ควรทำไหม” ไปไว้ก่อนเริ่มเขียน แล้วให้ PR เหลือหน้าที่เก็บหลักฐาน เช่น ทดสอบอย่างไร เสี่ยงตรงไหน และ revert อย่างไร ตั้งเพดานรอบรีวิวของ Agent และอย่านับการอนุมัติของบอตเป็นเสียงของคน
สำหรับหัวหน้าทีมและ compliance
ถามผู้ตรวจว่า control ที่ต้องการคือ “มีคนอ่าน diff” หรือ “มีคนรับผิดชอบที่ระบุตัวได้และมีหลักฐานการทดสอบ” สองแบบนี้ออกแบบ workflow ต่างกันมาก Hybrid Mind ไม่ได้ตรวจข้อกำหนด SOC 2 หรือ SOX ฉบับจริงในบทความนี้
เช็กลิสต์ก่อนตัดสินใจลดหรือเลิก PR คัดลอกไปคุยกับทีมได้
อ่านต่อบน Hybrid Mind
- Claude Code Review Slot Machine: X ถกให้ AI รีวิวกี่รอบถึงพอ และใครควรบอกว่า “เสร็จ”
- Anthropic Scion: X ถกเมื่อ Agent merge เร็วเกิน Git — สัญญาณ infra หรือแค่เคสพิเศษ
- Clean Code ยุค AI Agent: X ถกว่าโค้ดยังต้องอ่านง่ายเพื่อคน หรือเพื่อ Agent
- QGIS ห้ามโค้ดจาก AI: X ถกว่า Review รับไม่ไหว หรือถอยจากอนาคต
- Matt Pocock /grill-me: X ถกให้ AI ซักก่อนเขียนโค้ด ช่วยเห็นจุดบอด หรือเสียเวลาเป็นชั่วโมง
- Fried Brain Effect: X ถกรัน AI Agent 10 ตัวจนสมองไหม้ — ปัญหาของคน ระบบ หรือแรงกดดันตลาด
คำถามที่พบบ่อย
1. Thorsten Ball บอกให้เลิกรีวิวโค้ดใช่ไหม?
ไม่ใช่ทั้งหมด เขาบอกว่าไม่ต้องมี mandatory code review ผ่าน PR สำหรับทีมแบบของเขา แต่ยังให้ Agent ตรวจงาน มีเทสต์ e2e และ integration ใช้ feature flag และขอ feedback จากเพื่อนร่วมทีมในช่องทางอื่น เขาเองยอมรับว่างาน open source อาจต่างออกไป
2. Anthropic เลิกใช้ Pull Request แล้วหรือ?
ไม่ใช่ บล็อกของทีม Claude Code บอกว่ายังใช้ PR และทุก PR ยังผ่าน CI, AI review และ security review ที่เปลี่ยนคือจำนวนคนที่ต้องอนุมัติขึ้นกับความเสี่ยง ตั้งแต่ไม่ต้องมีคนเลยสำหรับ change เสี่ยงต่ำ จนถึงสองคนสำหรับโค้ดเสี่ยงสูง
3. AI reviewer หาบั๊กได้ดีกว่าคนจริงไหม?
ยังไม่มีหลักฐานอิสระที่ยืนยันแบบนั้น นักพัฒนาหลายคนบน X บอกว่าโมเดลจับบั๊กระดับบรรทัดได้ดี แต่พลาดโค้ดเกินจำเป็น โครงสร้างซ้ำซ้อน และสมมติฐานผิดเรื่องพฤติกรรมของระบบ เอกสารของผลิตภัณฑ์เองก็เตือนว่าอาจพลาดบั๊กได้
4. ถ้าเลิก PR แล้ว อะไรจะกันไม่ให้ Agent push อะไรก็ได้เข้า main?
ต้องมีกลไกอื่นแทน เช่น CI ที่บล็อก deploy, branch protection, รายชื่อผู้เขียนที่ไว้ใจ และ path ที่ต้องมีคนอนุมัติเสมอ นี่คือเหตุผลที่ Romain Lanz แย้งว่าถ้าสร้างกลไกเหล่านี้ครบ ก็เท่ากับทำ PR ในชื่ออื่น
5. ทีมที่ต้องผ่าน SOC 2 หรือ SOX เลิก PR ได้ไหม?
ยังสรุปไม่ได้จากวงถกนี้ Ball บอกว่าทีม Amp มี SOC 2 แต่ไม่ได้เปิดรายงาน และข้อกำหนดจริงขึ้นกับ control ที่องค์กรออกแบบกับผู้ตรวจ ควรถามผู้ตรวจโดยตรงก่อนเปลี่ยน workflow
6. ทำไม Agent รีวิว Agent ถึงวนไม่จบ?
เพราะผู้รีวิวมักเจอปัญหาเพิ่มทีละนิดทุกรอบ และผู้เขียนที่เป็น Agent แก้ทุกคอมเมนต์ แม้แต่ข้อเล็ก ๆ ที่คนจะปัดทิ้ง Anthropic เล่าว่า PR หนึ่งวนกว่า 50 รอบข้ามคืน และแก้ด้วยการจำกัดรอบ รีวิวเฉพาะ diff ใหม่ และกรองคอมเมนต์ที่เป็นแค่ style
เอกสารอ้างอิงและขอบเขตการตรวจ
- Thorsten Ball — “Why are you still using pull requests?” (X, 16 ต.ค. 2026)
- Thorsten Ball — ขั้นตอน push to main และ deploy ของทีม Amp (X, 16 ต.ค. 2026)
- claude.dev — How the Claude Code team does code review (Addy Osmani, Morgan Westlee Lunt, Qing Wang, 15 ต.ค. 2026)
- @ClaudeDevs — Claude writes about 90% of Claude Code’s code (X, 17 ต.ค. 2026 เวลาไทย)
- Claude Code Docs — Code Review
- Anthropic Engineering — Redesigning source control (บริบทตัวเลข change ต่อวันใน monorepo)
- Bacchelli & Bird — Expectations, Outcomes, and Challenges of Modern Code Review (ICSE 2013)
- Sadowski et al. — Modern Code Review: A Case Study at Google (ICSE SEIP 2018)
- DORA — Capabilities: Trunk-based development
- Martin Fowler — Continuous Integration
- GitHub Docs — About protected branches
ขอบเขตการตรวจ: Hybrid Mind อ่านโพสต์บน X ที่ไม่ซ้ำกัน 222 โพสต์ (ไม่ใช่ RT 185 โพสต์) ช่วง 15–17 ต.ค. 2026 ประกอบด้วย reply และ quote ของโพสต์ Ball, quote ของโพสต์ @ClaudeDevs และผลค้นหาคำว่า pull request, PR, code review, push to main และ trunk based ที่คู่กับ AI หรือ Agent ตัวเลขปริมาณมาจาก X Recent Counts ที่เรานับเอง คำค้นกว้างเรื่อง PR หรือ code review คู่กับ AI มี 1,191 โพสต์ใน 16 ต.ค. (UTC) รวม RT และคำค้นเฉพาะวงถกนี้มี 198 โพสต์ สูงสุด 43 โพสต์ต่อชั่วโมงช่วง 00:00–01:00 น. ของ 17 ต.ค. เวลาไทย ตัวเลขเหล่านี้บอกปริมาณ ไม่ได้บอกสัดส่วนความเห็น และตัวอย่างที่เราเลือกไม่ได้เป็นตัวแทนของทุกคนบน X
เราอ่านบล็อก Anthropic และเอกสาร Code Review ฉบับเต็ม ตรวจว่าลิงก์งานวิจัยของ Google, DORA และ Martin Fowler เปิดได้ ส่วนงานของ Bacchelli และ Bird เราตรวจข้อมูลบรรณานุกรมผ่าน DOI แต่หน้า Microsoft Research เปิดจากเครื่องเราไม่ได้ Hybrid Mind ไม่ได้ทดลองเลิก PR ไม่ได้ทดสอบ Amp หรือ Code Review for Claude Code เอง และไม่ได้ตรวจรายงาน SOC 2 ของบริษัทใด แล็บทั้งสามเป็นการจำลองเชิงการศึกษาที่ใช้ค่าสมมติ
ใส่ความเห็น