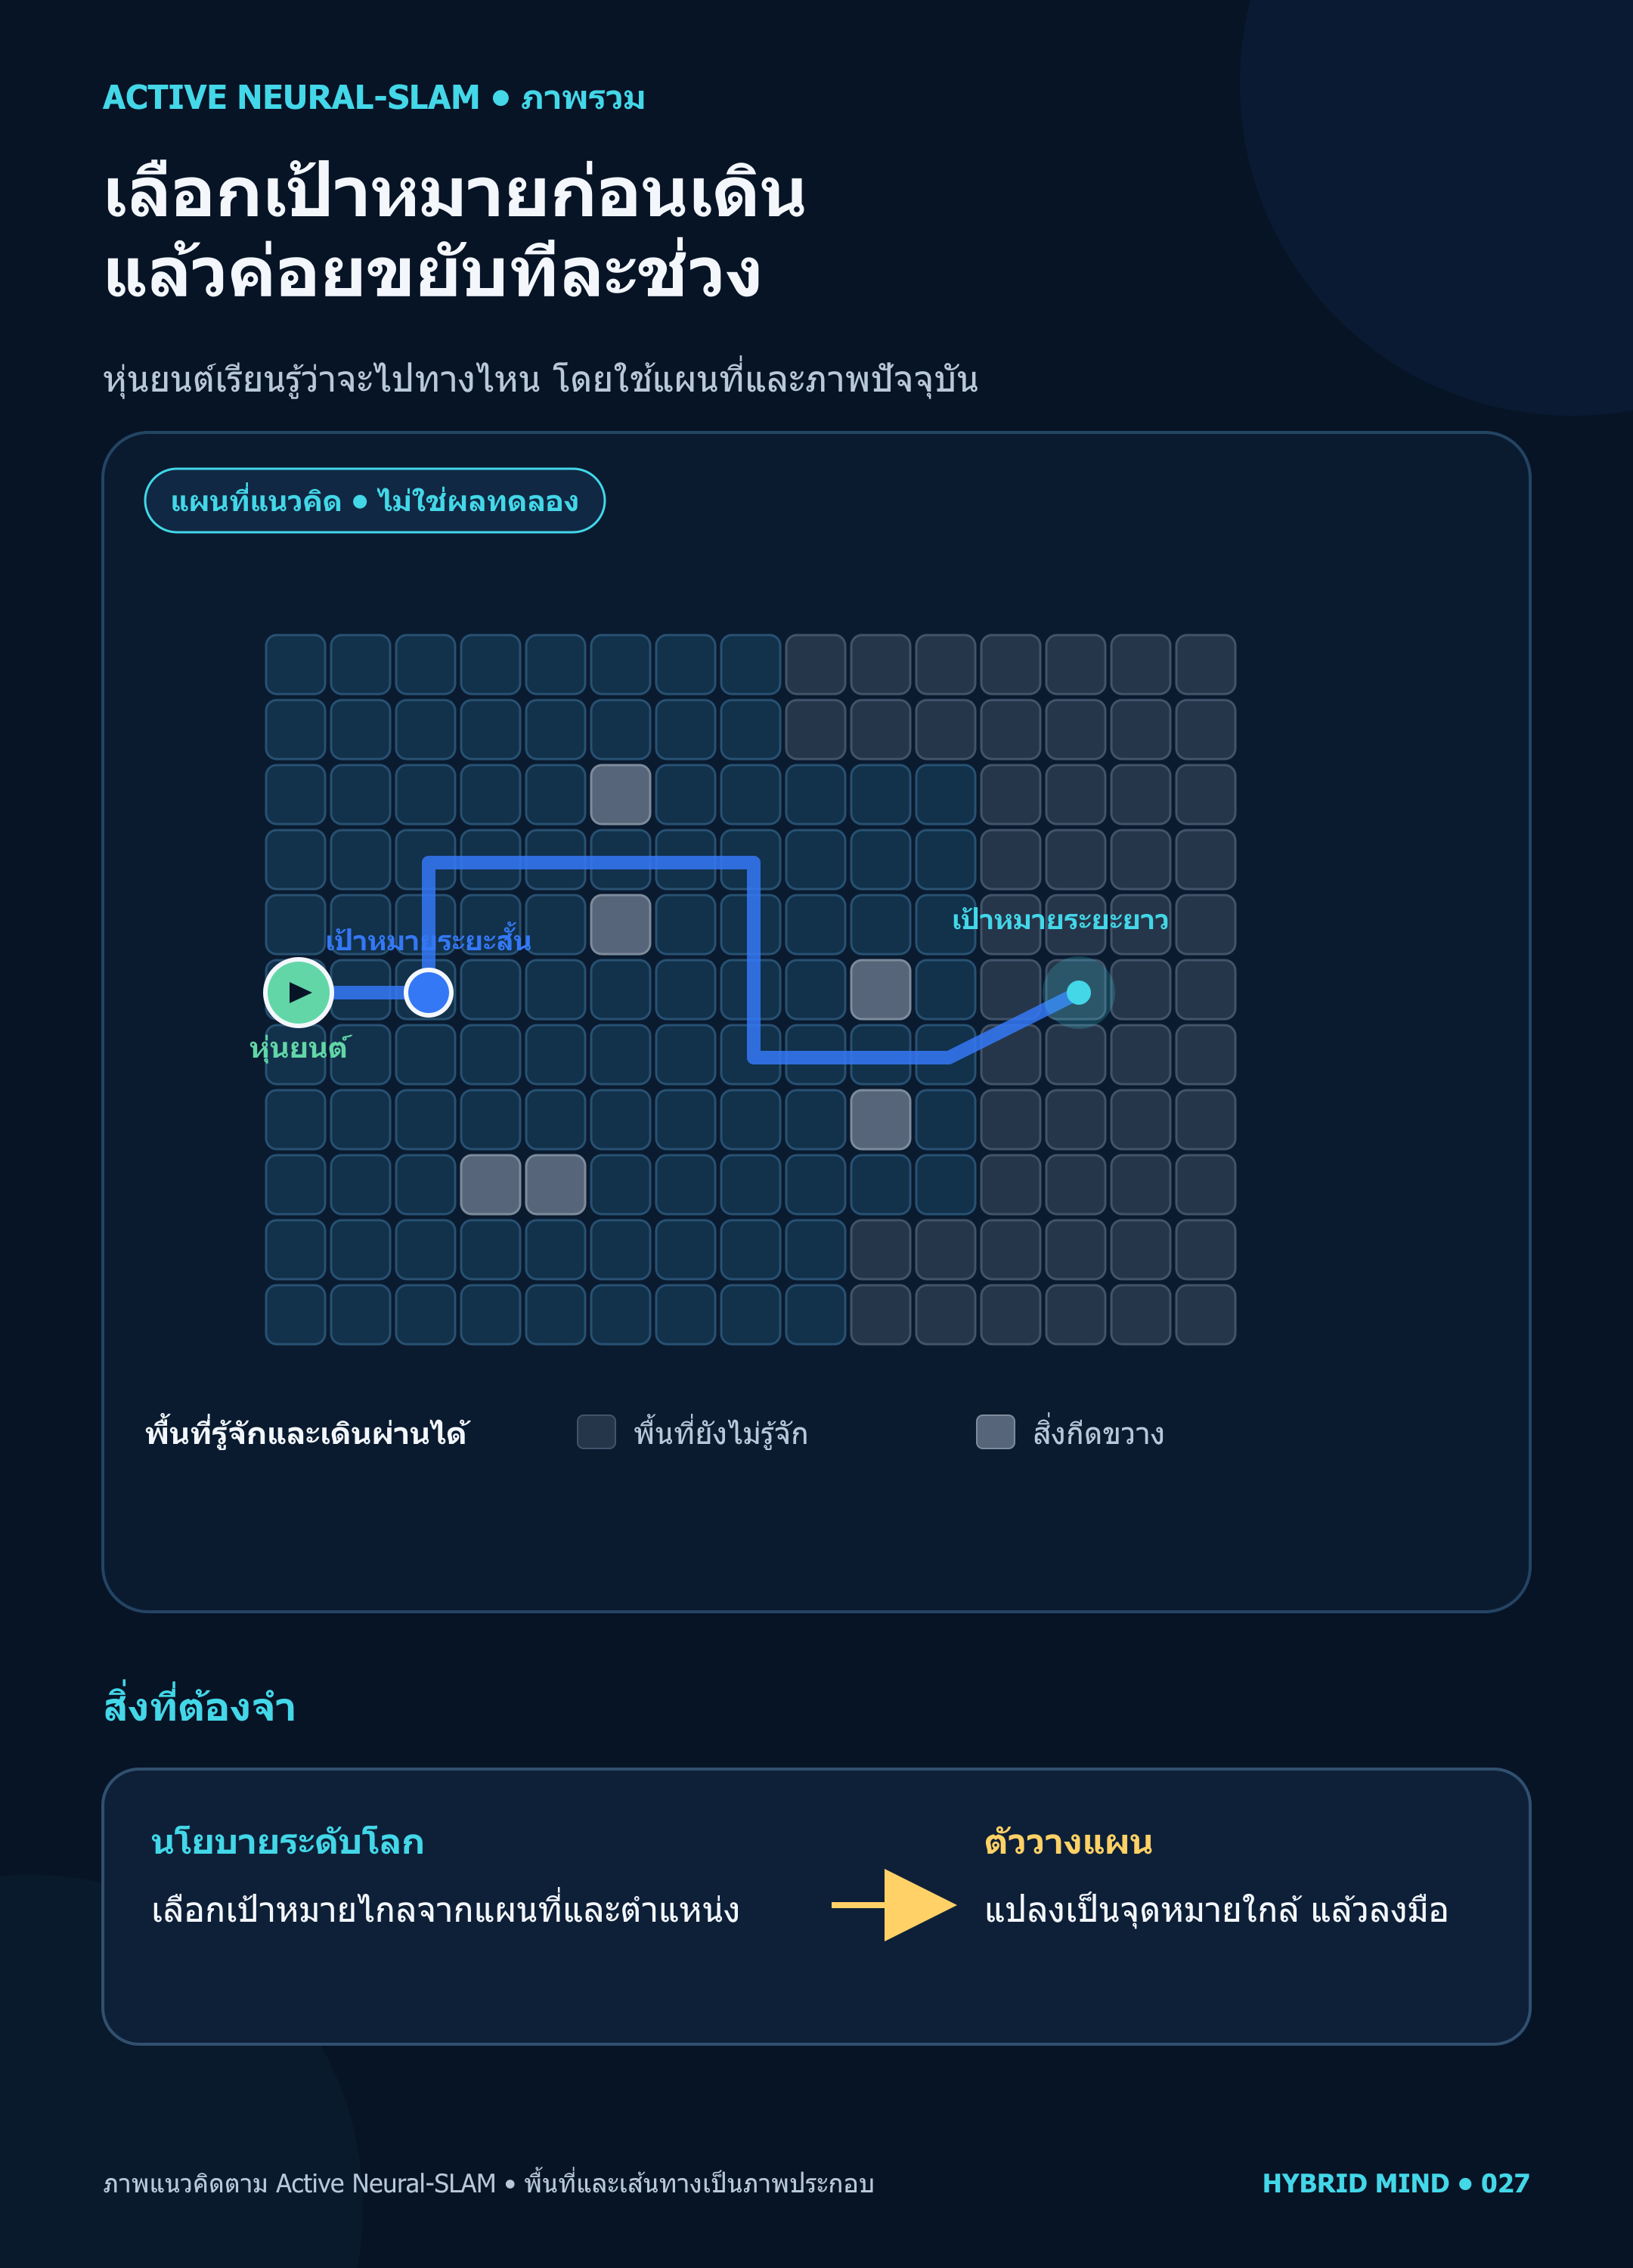
คำตอบสั้น: Active Neural SLAM หรือ ANS เป็นระบบนำทางหุ่นยนต์ที่ให้ส่วนเรียนรู้เลือก “เป้าหมายระยะไกล” จากแผนที่สะสม แล้วให้ตัววางแผนคำนวณ “เป้าหมายระยะสั้น” บนเส้นทาง จากนั้นนโยบายอีกตัวใช้ภาพกล้องปัจจุบันตัดสินใจว่าจะเดินหรือหมุนอย่างไร การแยกสามระดับนี้ช่วยให้การเลือกว่าจะไปสำรวจตรงไหนไม่ต้องตัดสินทุกการเคลื่อนไหวเอง และช่วยให้การควบคุมระยะใกล้ตอบสนองต่อภาพที่เห็นจริงได้
ความแตกต่างนี้สำคัญเพราะ “เลือกเป้าหมาย” ไม่ได้แปลว่าหุ่นยนต์มีเส้นทางที่ปลอดภัยหรือรู้แน่ว่าพื้นที่ข้างหน้าว่างแล้ว เป้าหมายระยะไกลเป็นพิกัดบนแผนที่ที่นโยบายเลือก เส้นทางเป็นผลจาก Planner ภายใต้แผนที่และสมมติฐานของมัน ส่วนการเลี้ยวหรือเดินหน้าเป็น action ที่ Local Policy เลือกจากภาพในขณะนั้น ทั้งสามขั้นมีข้อมูลและข้อผิดพลาดคนละแบบ
บทความนี้อธิบายงานวิจัย Learning To Explore Using Active Neural SLAM ของ Devendra Singh Chaplot, Dhiraj Gandhi, Saurabh Gupta, Abhinav Gupta และ Ruslan Salakhutdinov ซึ่งเผยแพร่ที่ ICLR 2020 แล้วแยกสิ่งที่บทความวิจัยรายงานออกจากกติกาในแล็บจำลองที่เตรียมประกอบบทความ งานนี้ศึกษาโจทย์สำรวจฉากในอาคารเพื่อเพิ่มพื้นที่ที่รู้ว่าเดินทางผ่านได้ภายในเวลาจำกัด ไม่ได้ทำให้หุ่นยนต์เข้าใจทุกวัตถุหรือรับรองความปลอดภัยของการเดินจริง (ต้นฉบับ arXiv และรายชื่อผู้เขียน, หน้าโครงการ CMU)

เหตุใดเป้าหมายสำรวจจึงไม่ใช่เส้นทาง
ลองนึกถึงหุ่นยนต์ที่เริ่มต้นในห้องซึ่งไม่เคยเห็นมาก่อน มีประตูสองบาน ทางหนึ่งมองเห็นมุมแคบ ๆ ด้านหลังเฟอร์นิเจอร์ อีกทางนำไปสู่โถงเปิดที่อาจเชื่อมกับหลายห้อง ระบบต้องตอบคำถามสามข้อที่เกี่ยวกันแต่ไม่ใช่ข้อเดียวกัน
- ตอนนี้เราเชื่อว่าอยู่ตรงไหน และเคยเห็นพื้นที่ใดแล้ว? นี่คือส่วนทำแผนที่กับประมาณตำแหน่ง
- ถ้ามีเวลาจำกัด ควรตั้งเป้าหมายสำรวจระยะไกลไว้ที่ไหน? นี่คือการเลือกเป้าหมายระดับโลก
- จากภาพที่เห็นและเป้าหมายใกล้ตัว ควรออกคำสั่งเดินหรือหมุนอะไรตอนนี้? นี่คือการควบคุมระดับท้องถิ่น
ในระบบแบบปลายถึงปลายหนึ่งเครือข่ายอาจต้องรับภาพแล้วเลือก action โดยตรง ขณะที่ ANS แบ่งงานออกเป็นส่วนที่มีตัวแทนเชิงพื้นที่และช่วงเวลาต่างกัน ส่วน Neural SLAM อัปเดตแผนที่และ pose ส่วน Global Policy เลือกเป้าหมายที่เปลี่ยนช้ากว่า และ Local Policy เลือกการเคลื่อนที่ทีละก้าว งานวิจัยให้เหตุผลว่าการแยกเช่นนี้ลดภาระการเรียนรู้เมื่อเทียบกับการให้ policy เดียวเรียนรู้การทำแผนที่ การหาตำแหน่ง และการวางแผนทั้งหมดพร้อมกัน
รากฐาน: แผนที่มีพื้นที่ที่รู้และยังไม่รู้
หุ่นยนต์มองเห็นโลกเป็นส่วน ๆ จากกล้อง และข้อมูลตำแหน่งจาก odometry ก็มีความคลาดเคลื่อนได้ เมื่อเดินไปข้างหน้า ระบบต้องนำแผนที่เฉพาะภาพปัจจุบันไปวางบนแผนที่ใหญ่โดยอาศัยตำแหน่งที่ประมาณไว้ หากตำแหน่งผิด แผนที่ส่วนใหม่อาจเหลื่อมหรือซ้อนผิดบริเวณ ดังนั้นแผนที่และการประมาณ pose จึงพึ่งพากัน
FACT: ในงาน ANS แผนที่เชิงพื้นที่ภายในมีสองช่อง ขนาดแต่ละช่องเป็นตาราง M × M และแต่ละเซลล์แทนพื้นที่จริง 5 × 5 เซนติเมตร ช่องแรกเก็บความน่าจะเป็นว่าเซลล์นั้นเป็นสิ่งกีดขวาง ช่องที่สองเก็บความน่าจะเป็นว่าเซลล์นั้นถูกสำรวจแล้ว คำว่า “ถูกสำรวจ” ในที่นี้ครอบคลุมทั้งเซลล์ที่ทราบว่าเป็นพื้นที่ว่างและเซลล์ที่ทราบว่าเป็นสิ่งกีดขวาง จึงไม่ควรใช้ค่านี้แทน “เดินผ่านได้”
นิยาม coverage ในการทดลองก็มีเงื่อนไข ผู้เขียนนับพื้นที่ที่ทราบว่าเดินทางผ่านได้ โดยจุดหนึ่งต้องอยู่ในมุมมองของหุ่นยนต์และห่างไม่เกิน 3.2 เมตรจากกล้อง การเพิ่ม coverage จึงเป็นผลวัดตามนิยามและช่วงการมองเห็นดังกล่าว ไม่ใช่เปอร์เซ็นต์ของพื้นทุกจุดที่หุ่นยนต์เดินสัมผัส หรือหลักฐานว่าหุ่นยนต์เดินผ่านทุกจุดที่เห็นได้ (รายละเอียดโจทย์และนิยามใน §3 ของ paper)
สถาปัตยกรรม: สามส่วนส่งต่อข้อมูลกัน

1. Neural SLAM: ประมาณแผนที่และตำแหน่ง
ระบบรับภาพ RGB ขนาด 128 × 128 และค่าการเปลี่ยนตำแหน่งกับทิศจาก base odometry ที่มี noise พร้อมแผนที่และ pose ก่อนหน้า Mapper แปลงภาพเป็นแผนที่มุมมองด้านบนสองช่อง คือสิ่งกีดขวางกับพื้นที่ที่สำรวจแล้ว ส่วน Pose Estimator เทียบแผนที่เฉพาะที่จากสองช่วงที่จัดแนวตาม odometry เพื่อประมาณการเปลี่ยน pose จากนั้นแผนที่ใหม่ถูกวางในพิกัดใหญ่และรวมกับข้อมูลที่สะสมใน episode
RGB คืออินพุตระหว่างสำรวจ ไม่ใช่ depth map ที่วัดระยะโดยตรง Ground-truth depth ใช้สร้าง supervision ของ Mapper ระหว่างฝึก
2. Global Policy: เลือกเป้าหมายไกล
Global Policy รับสี่ช่อง ได้แก่ obstacle, explored, ตำแหน่งปัจจุบัน และตำแหน่งที่เคยไป ระบบสร้างมุมมองแผนที่ใกล้ agent และภาพรวมที่ลดขนาด แล้วซ้อนเป็นอินพุต 8 ช่องให้ CNN เลือก long-term goal ในพิกัดแผนที่ ทิศหันของ agent ถูกส่งให้ Global Policy แยกจากช่องแผนที่ผ่าน orientation embedding ตาม Appendix D เป้าหมายนี้ไม่จำเป็นต้องเป็น frontier และอาจอยู่ในพื้นที่เปิดที่สำรวจแล้ว หากช่วยให้สำรวจฉากได้มีประสิทธิภาพขึ้น
3. Planner และ Local Policy: ไปต่อทีละช่วง
Fast Marching Method คำนวณเส้นทางไปยังเป้าหมายไกล โดย paper ถือ unknown เป็น free ระหว่างคำนวณ จากเส้นทางนั้น Planner เลือก short-term goal ภายในระยะ 0.25 เมตร Local Policy รับภาพ RGB ปัจจุบันกับระยะและมุมสัมพัทธ์ถึงเป้าหมาย ใช้ pretrained ResNet18 และ recurrent GRU เพื่อเลือกเดินหน้า เลี้ยวซ้าย หรือเลี้ยวขวา
สรุป: Neural SLAM ส่งแผนที่และ pose ให้ Global Policy เลือกเป้าหมายไกล; Planner แปลงเป็นเป้าหมายใกล้; Local Policy เลือก action จากภาพและเป้าหมายใกล้ การแยกสามระดับทำให้คำว่า goal, route และ action ชี้ข้อมูลคนละชนิด

เป้าหมายระยะไกลต่างจาก frontier อย่างไร
Frontier คือขอบระหว่างพื้นที่ที่ทราบว่าเดินได้กับพื้นที่ unknown; วิธีคลาสสิกเลือกจุดใกล้บนขอบนั้นเป็นเป้าหมาย งาน Yamauchi (1997) วางรากฐานแนวทางนี้ ส่วน ANS ใช้ nearest-frontier เป็น baseline เทียบกับ Global Policy ที่เรียนรู้เป้าหมายจากแผนที่
REPORTED CLAIM: ใน ablation ของผู้เขียน frontier ใกล้เคียงนโยบายเรียนรู้ในฉากเล็ก แต่ coverage บนฉากใหญ่ต่ำกว่าราว 10% ภายใต้การทดลองนั้น ผู้เขียนสังเกตว่า frontier มักพาหุ่นยนต์เข้ามุมแคบ ขณะที่นโยบายเรียนรู้มักเลือกบริเวณเปิดกว่า นี่เป็นผลเฉพาะชุดทดลอง ไม่ใช่ข้อสรุปว่า frontier ใช้ไม่ได้ (§6.1)
| แนวคิด | ความหมาย |
|---|---|
| Long-term goal | ตำแหน่งหรือบริเวณที่ Global Policy อยากให้ไปสำรวจ |
| Frontier | ขอบ known-free ติด unknown ซึ่งเป็นตัวเลือกเป้าหมายแบบหนึ่ง |
| Route / short-term goal | เส้นทางและจุดหมายใกล้ที่ Planner คำนวณ |
| Action | คำสั่งเดินหรือหมุนที่ Local Policy เลือกจากภาพ |

แล็บจำลอง: ฝึกอ่านแผนที่ ไม่ได้จำลอง ANS
แล็บประกอบบทความใช้กริดสามสถานะ: free, occupied และ unknown พร้อมตำแหน่ง agent, budget และโหมดเลือกเป้าหมาย Frontier คือเซลล์ known-free ที่ติด unknown แบบสี่ทิศ เป้าหมายต้องเข้าถึงได้ด้วย BFS บน known-free เท่านั้น ซึ่งเข้มกว่างานวิจัยที่ FMM มอง unknown เป็น free ระหว่างหาเส้นทาง
SIMULATION: คะแนนคือ u − λd โดย u คือจำนวน unknown ที่ติดเป้าหมายแบบสี่ทิศ, d คือระยะ BFS ผ่าน known-free และ λ อยู่ระหว่าง 0–5. ใน fixture 4/5 ที่ λ=0.2 โหมด nearest เลือก [2,1] ระยะ 1; proxy เลือก [6,1] ซึ่งติด unknown 3 ช่องและอยู่ห่าง 5 จึงได้ 3−0.2×5=2. ค่านี้เป็น local proxy ไม่ใช่ information gain จริง
Frontier Explorer
ทดลองเลือกจุดหมายจากแผนที่ 2 มิติ โดยเดินผ่านช่องที่ทราบว่าเป็นพื้นที่ว่างเท่านั้น ค่าความใกล้และ proxy score เป็นกติกาของบทเรียนนี้ ไม่ใช่การทำซ้ำ ANS และไม่ได้วัด information gain จริง
แก้โจทย์และสั่งคำนวณ
การรีเซ็ตคืน fixture, แผนที่, ตำแหน่ง, งบ, λ, โหมด, ผลลัพธ์ และภาพแผนที่ทั้งหมด
ผลจากแผนที่ปัจจุบัน
แก้ค่าแล้วกด Run analysis
Frontier candidates
Path และ short-term goal
การตีความ
กติกาจำลอง: BFS สี่ทิศทาง ลำดับบน-ขวา-ล่าง-ซ้าย เดินผ่านช่อง . เท่านั้น; ช่อง ? เป็น frontier เมื่ออยู่ติดช่อง . แต่เดินผ่านไม่ได้ คะแนน proxy = unknown_neighbors − λ × BFS distance ซึ่งเป็น local proxy ไม่ใช่ true information gain. การไม่พบ frontier ในกรอบแผนที่ไม่ยืนยันว่าโลกสำรวจครบแล้ว
ขอบเขตของผล: NO_FRONTIER_IN_INPUT หมายถึงไม่พบ frontier ในแผนที่ที่ป้อนเท่านั้น ไม่ใช่หลักฐานว่าโลกทั้งหมดถูกสำรวจแล้ว พื้นที่นอกอินพุตและข้อมูลที่ยังไม่สังเกตยังคงไม่ทราบ
ผู้ใช้แก้แผนที่และค่าได้เอง ไม่มี RGB inference, hidden ground truth หรือการฝึกโมเดล เซลล์ปัจจุบันที่เป็น frontier ต้องสั่ง SCAN; สถานะนั้นไม่ถือว่ารู้ครบ
เกมสั้น: เลือกเป้าหมายแล้วตรวจการตัดสินใจ
เกมมีหกภารกิจให้เลือก frontier ที่ถูกต้องหรือ STOP เมื่อไม่มีทางเลือกตามกติกา พร้อมสั่ง SCAN เมื่อเซลล์ปัจจุบันยังติด unknown ระบบปฏิเสธคำตอบผิดและเริ่มภารกิจใหม่ได้
SIMULATION: เกมตรวจการอ่านกริดและความเข้าใจข้อกำหนดในโจทย์ ไม่ใช่การประเมินความสามารถของหุ่นยนต์จริง ไม่ได้เปิดเผยแผนที่ซ่อนเร้นหรือวัด coverage ของ ANS
Frontier Decision Missions
ภารกิจหกข้อให้ตัดสินใจจากแผนที่ที่มองเห็นเท่านั้น เลือก MOVE พร้อมพิกัดเมื่อมี frontier ที่เดินถึงและอยู่ในงบ เลือก OBSERVE เมื่อยืนบน frontier ปัจจุบัน เลือก WAIT เมื่อไม่มีจุดหมายที่อยู่ในงบ และ REPORT_NO_FRONTIER เมื่อ input ไม่มี frontier
ส่งการตัดสินใจ
การจำลองใช้ known-free BFS สี่ทิศทางเท่านั้น ช่อง unknown เป็นสิ่งที่ยังเดินผ่านไม่ได้ การไม่พบ frontier ในแผนที่ปัจจุบันไม่พิสูจน์ว่าโลกจริงสำรวจครบ ไม่มี hidden world, การเปิดเผยแผนที่, คะแนน coverage หรือ policy ที่เรียนรู้
ผลทดลองที่รายงานและสิ่งที่ตัวเลขบอก
REPORTED CLAIM: ผู้เขียนฝึกโมเดลกับ 10 ล้าน frames บน Gibson และรายงานผล exploration บนชุด Gibson validation จำนวน 994 episodes ใน 14 ฉากที่ไม่เคยใช้ฝึก ในเงื่อนไขนั้น paper ให้ค่า coverage เฉลี่ยของ ANS เป็น 32.701 ตารางเมตรและ 0.948 ของพื้นที่ที่เข้าข่าย ขณะที่ baseline ที่ดีที่สุดได้ 24.863 ตารางเมตรและ 0.789 ตามนิยาม coverage ใน paper ตัวเลขนี้มาจากการจำลอง Habitat บนฉาก Gibson ไม่ใช่ผลทดสอบอิสระหรือค่าเฉลี่ยจากการติดตั้งในบ้าน (ตารางที่ 1 และ §6)
ในเอกสารยังมีวิดีโอการสำรวจเชิงคุณภาพของ Locobot ในห้องนอนและพื้นที่นั่งเล่น ผู้เขียนปรับค่ากล้องใน simulator ให้ใกล้กับกล้องบนหุ่นยนต์ แล้วแสดงแผนที่คาดการณ์และเป้าหมายที่ Global Policy เลือก ตัวอย่างนี้เป็นหลักฐานว่ามีการนำระบบไปลองกับหุ่นยนต์จริง แต่ไม่มีความหมายเท่ากับการทดลองขนาดใหญ่ที่วัดอุบัติเหตุ ความเสถียรระยะยาว หรือความปลอดภัยในบ้านที่มีคนและสัตว์เลี้ยง (วิดีโอและรายละเอียดโครงการ)
การฝึกแยกกันอย่างไร และอะไรเปลี่ยนระหว่างใช้งาน
Mapper ฝึกด้วยแผนที่มุมมอง top-down ที่สร้างจาก ground-truth depth; Pose Estimator มี supervision เพิ่มจาก ground-truth pose; Global Policy ใช้ PPO กับรางวัลจาก coverage ที่เพิ่มขึ้น; Local Policy ใช้ imitation learning หรือ behavioral cloning เพื่อเรียนรู้ไปยัง short-term goal ผู้เขียนฝึกโมดูลพร้อมกัน เพราะ action ของ Local Policy เปลี่ยนข้อมูลที่ Neural SLAM และ Global Policy จะเห็นในเวลาต่อมา
ระหว่าง episode ที่ใช้โมเดลฝึกแล้ว แผนที่และ pose estimate ยังอัปเดตเมื่อมี observation ใหม่ แต่นี่คือ state estimation ไม่ใช่การเปลี่ยนน้ำหนักเครือข่ายทุกครั้งที่เดิน คำว่า Weight Updates หมายถึงการปรับพารามิเตอร์ระหว่าง training
แยกคำให้ตรง: Context Window คือข้อมูลในรอบเรียกโมเดลภาษา; Retrieved Context คือข้อมูลที่ค้นคืนมาเติม; External Memory คือแผนที่หรือฐานข้อมูลที่ระบบบันทึกแก้ได้; Episode Map/Pose Estimate คือ state เชิงพื้นที่; Weight Updates คือการฝึกเปลี่ยนพารามิเตอร์ การอัปเดตแผนที่ไม่พิสูจน์ว่าโมเดลมีการฝึกต่อเนื่องหรือมีประสบการณ์แบบมนุษย์ ANS ใช้แผนที่เชิงพื้นที่ ไม่ได้เก็บ Khronos-style temporal object identity หรือ hidden reasoning
อ่าน repository อย่างไรเมื่ออยากทดลองต่อ
Repository เผยแพร่ PyTorch implementation แต่ติดตั้งกับเครื่องมือวิจัยรุ่นเก่า README ระบุ Habitat-Sim commit 9575dcd45fe6f55d2a44043833af08972a7895a9, Habitat-API commit b5f2b00a25627ecb52b43b13ea96b05998d9a121 และการทดสอบด้วย PyTorch 1.2.0; requirements ยังมี scikit-fmm 2019.1.30 และ scikit-image 0.15.0
นี่เป็น artifact ของงานวิจัยยุคนั้น ไม่ใช่หลักฐานว่าติดตั้งกับ Habitat/PyTorch ปัจจุบันได้ทันที เราไม่ได้ติดตั้ง dependency, ดึง checkpoint หรือประมาณค่า GPU ปัจจุบัน โครงการใช้ MIT License แต่ผู้ทดลองต้องตรวจข้อกำหนด Gibson/Matterport dataset แยกต่างหาก (README, instructions, license)
ใช้กรอบนี้กับระบบนำทางอื่นอย่างไร
ใช้กรอบแยกตัวแปรเพื่ออ่านงานสำรวจอื่นได้: observation คือสิ่งที่เซนเซอร์รับ, map หรือ external memory คือข้อมูลสะสม, goal คือสิ่งที่ policy ตั้งใจไปหา, route คือผล planner, action คือคำสั่งควบคุม และ ground truth ใช้ฝึกหรือประเมินเท่านั้นเมื่อการทดลองอนุญาต
อย่ารวมช่วงเวลาต่างกันเป็นคำว่า “ความจำ” เพียงคำเดียว: context window คือข้อมูลที่โมเดลรับในรอบหนึ่ง, retrieved context คือสิ่งที่ดึงมาใช้, external map memory คือ state เชิงพื้นที่ที่อัปเดตระหว่าง episode, ส่วน weight update เปลี่ยนพารามิเตอร์ระหว่าง training. การอัปเดตแผนที่ขณะเดินไม่ได้แปลว่าโมเดลเรียนรู้ต่อ และระบบนี้ไม่ใช่หลักฐานเรื่องสติหรือ hidden reasoning.
ข้อจำกัดที่ควรนำไปใช้จริง
REPORTED CLAIM: ผลหลักมาจาก Habitat; ผู้เขียนรายงานการฝึก 10 ล้าน frames และ validation 994 episodes ใน 14 ฉาก Gibson ที่ไม่เห็นระหว่างฝึก โดยแต่ละ episode จำกัด 1,000 steps และมีการทดสอบ generalization บน Matterport3D รวมถึงตัวอย่าง Locobot เชิงคุณภาพในอพาร์ตเมนต์ Coverage นับพื้นที่ known-traversable ที่อยู่ในมุมมองและห่างจากกล้อง strict น้อยกว่า 3.2 เมตร ไม่มีการประเมินใน paper นี้ที่ทำให้สรุปได้ว่าระบบปลอดภัยสำหรับบ้านที่เปลี่ยนสภาพ มีบันได คนเดินตัดหน้า หรือสิ่งของเคลื่อนที่ตลอดเวลา
ANALYSIS: แผนที่ผิดอาจทำให้ Planner สร้างเส้นทางผิด ขณะที่ Local Policy อาจแก้ความคลาดเคลื่อนบางชนิดได้จากภาพ หาก localization drift สะสมหรือภาพแสดงพื้นที่ไม่ชัด ความผิดพลาดก็ส่งต่อไปยัง global goal และ coverage ต่อไปได้
ANALYSIS: การให้ Planner มอง unknown เป็น free ช่วยวางเส้นทางไปหาเป้าหมายผ่านส่วนที่ยังไม่สำรวจได้ แต่ไม่เท่ากับการยืนยันว่าพื้นที่นั้นว่างจริง ผู้ติดตั้งระบบจริงควรแยก policy เพื่อการสำรวจออกจากการตัดสินใจด้าน safety กำหนดกติกาเมื่อแผนที่ขัดกับภาพจริง และตรวจว่าหุ่นยนต์หยุดหรือขอคนช่วยเมื่อไม่แน่ใจได้หรือไม่ รายละเอียดดังกล่าวเป็นข้อเสนอสำหรับการออกแบบระบบปลายทาง ไม่ใช่คุณสมบัติที่ paper นี้พิสูจน์ไว้
ANALYSIS: ตัวเลขในตารางไม่ควรถูกนำไปเทียบกับระบบอื่นที่ใช้ฉาก จำนวน episode มุมกล้อง ระยะมอง หรือเกณฑ์ coverage ต่างกัน แม้จะรายงานเป็นเปอร์เซ็นต์เหมือนกันก็ตาม หากอ้างตัวเลข ให้แนบขนาดชุดทดสอบ แหล่งฉาก ระยะที่ใช้คำนวณ และสถานะว่าเป็นผลจำลองจาก paper ต้นทาง
สิ่งที่ควรทดลองต่อ
HYPOTHESIS: ระบบรุ่นถัดไปอาจเรียนรู้การเลือกเป้าหมายที่คำนึงทั้งระยะทาง ความไม่แน่นอนของแผนที่ และความเสี่ยงจากการเคลื่อนที่ โดยแยกผลลัพธ์ “น่าไปสำรวจ” ออกจากสิทธิ์ “เดินทางผ่านได้” หากเพิ่มกลไกนี้ควรวัดอย่างน้อย coverage, การกลับไปพื้นที่เดิม, ความผิดพลาดของแผนที่, การใช้เวลาต่อพื้นที่ใหม่, การเข้าใกล้สิ่งกีดขวาง และเหตุการณ์ที่ระบบต้องหยุดขอความช่วยเหลือ การวัด coverage อย่างเดียวอาจจูงใจให้วิ่งเข้าหาพื้นที่ไม่รู้โดยไม่สะท้อนคุณภาพด้านความปลอดภัย
การแนะนำนี้เป็นสมมติฐานสำหรับงานต่อไป ไม่ใช่ผลการทดลองที่ทำในบทความนี้

สิ่งที่ควรจำ
- Long-term goal คือเป้าหมายพื้นที่; route มาจาก Planner; action คือคำสั่งเคลื่อนที่ขณะนั้น
- ANS แยก Neural SLAM, Global Policy, Planner และ Local Policy ให้รับส่งแผนที่ ตำแหน่ง และเป้าหมาย
- explored รวมทั้งพื้นที่ว่างและสิ่งกีดขวาง จึงไม่เท่ากับ free space
- เป้าหมาย Global Policy ไม่จำเป็นต้องเป็น frontier
- Exploration inference ใช้ RGB กับ noisy base odometry; ground-truth depth/pose ใช้สร้าง supervision ระหว่างฝึก
- Lab เป็น SIMULATION แบบกริด ใช้ BFS ผ่าน known-free และไม่ใช่ benchmark ของ ANS
คำถามที่พบบ่อย
Active Neural SLAM เป็น frontier-based exploration หรือไม่?
ไม่ทั้งหมด Frontier เป็น baseline; Global Policy เรียนรู้ long-term goal จากแผนที่ เป้าหมายไม่จำเป็นต้องอยู่บน frontier
Global Policy เลือก action เดินหน้าโดยตรงหรือไม่?
ไม่ มันเลือกเป้าหมายระยะไกล; Planner หาเส้นทางและ short-term goal; Local Policy เลือก action จาก RGB กับเป้าหมายใกล้
ANS ใช้ RGB-D หรือรู้ว่าพื้นที่ unknown ปลอดภัยหรือไม่?
Inference ใช้ RGB กับ noisy base odometry; depth เป็น supervision ระหว่างฝึก ส่วน FMM มอง unknown เป็น free เพื่อคำนวณเส้นทาง ซึ่งไม่ใช่การยืนยันความปลอดภัย
แผนที่อัปเดตแปลว่าโมเดลเรียนรู้ต่อหรือไม่?
ไม่ แผนที่/pose เป็น state estimate; weight updates เปลี่ยนพารามิเตอร์ระหว่าง training
ผลเป็นหุ่นยนต์จริงหรือไม่?
ผลหลักเป็น Habitat simulation; Locobot เป็นตัวอย่างเชิงคุณภาพ ไม่ใช่การรับรองความปลอดภัย
Lab คือ ANS benchmark หรือไม่?
ไม่ เป็นกริดฝึกคิดตามกติกาจำลองและใช้ BFS known-free เท่านั้น
แหล่งอ้างอิง
- Chaplot et al. (2020), Learning To Explore Using Active Neural SLAM, ICLR 2020; arXiv versions.
- CMU project และ CMU ML blog.
- Neural-SLAM repository: README, instructions, model, requirements, MIT license.
- Yamauchi (1997), A Frontier-Based Approach for Autonomous Exploration.
- อ่านต่อในคลัง: 3D Scene Graphs: เมื่อ Agent เข้าใจวัตถุ ก่อนวางแผน และ Khronos: เมื่อ SLAM จำได้ว่าเหตุการณ์เกิดขึ้นเมื่อไร.
ใส่ความเห็น