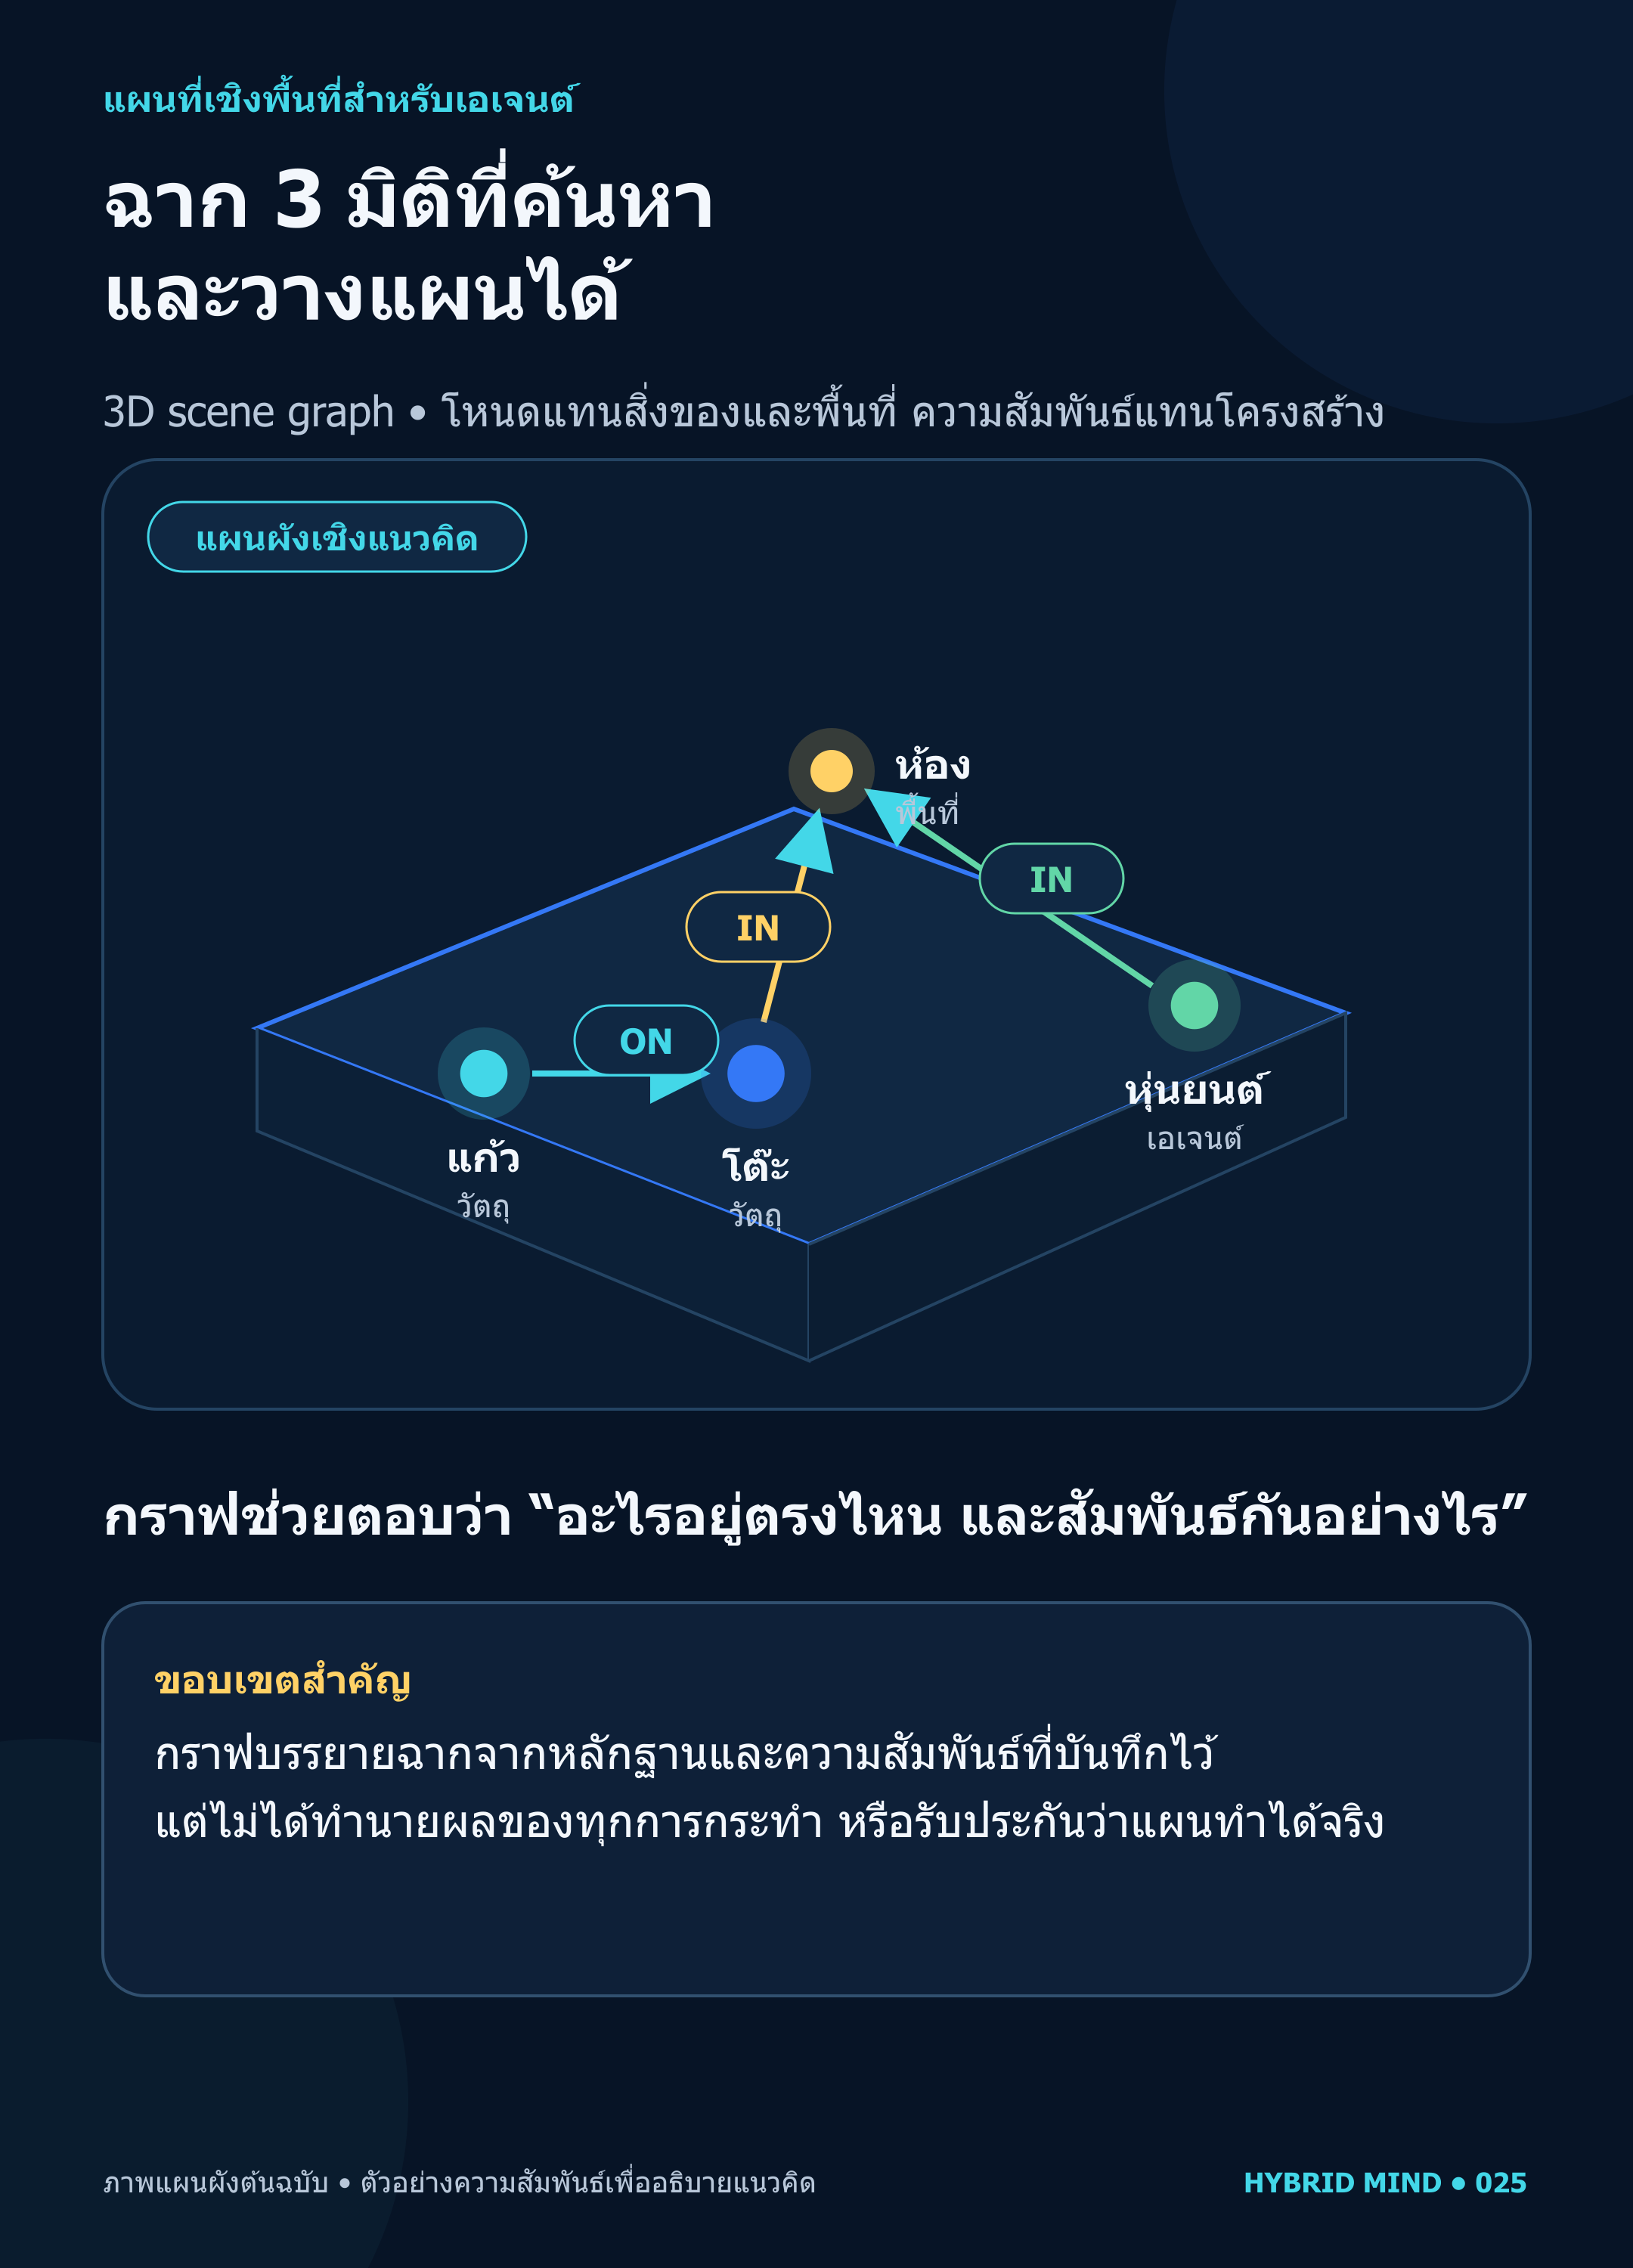
คำตอบสั้น: 3D Scene Graph คือแผนที่เชิงโครงสร้างที่แทนวัตถุและพื้นที่เป็นโหนด แล้วเชื่อมด้วยความสัมพันธ์ เช่น “ถ้วยอยู่บนโต๊ะ” หรือ “ห้องครัวเชื่อมกับโถง” Agent จึงค้นสิ่งที่เกี่ยวกับเป้าหมายและวางเส้นทางได้เป็นขั้นตอน แต่กราฟไม่ใช่ความจริงที่สมบูรณ์: มันอาจมาจากภาพที่เห็นไม่ครบ มีป้ายกำกับที่โมเดลอนุมาน หรือเก่ากว่าสภาพแวดล้อมจริง การวางแผนที่เชื่อถือได้จึงต้องรู้แหล่งที่มาของความสัมพันธ์ เวลา และเงื่อนไขที่ยังต้องตรวจ ก่อนสั่งการใด ๆ

คำสั่ง “หยิบกุญแจจากตู้ในห้องเก็บของ” ต้องรู้ตำแหน่ง การเชื่อมต่อของห้อง และที่มาของความสัมพันธ์ กราฟช่วยให้ค้นและตรวจข้อมูลเหล่านี้ได้ แต่ไม่ได้ทำให้ Agent หยิบจับได้เอง
ในบทความนี้คำว่า FACT หมายถึงรายละเอียดที่ตรวจได้จากแหล่งปฐมภูมิ REPORTED CLAIM คือผลที่ผู้เขียนงานรายงานภายใต้การทดลองของตน ANALYSIS คือการตีความเพื่อเปรียบเทียบหน้าที่ของแต่ละระบบ HYPOTHESIS คือข้อเสนอเชิงออกแบบที่ยังต้องทดลอง และ SIMULATION คือผลจากห้องทดลองตัวอย่างที่สร้างขึ้นเพื่ออธิบายตรรกะ ไม่ใช่หลักฐานประสิทธิภาพของหุ่นยนต์หรือการทำซ้ำงานวิจัย
กราฟฉากตอบคำถามอะไร
FACT: Scene graph จัดข้อมูลเป็นโหนดและเส้นเชื่อม โหนดอาจแทนวัตถุ สถานที่ หรือพื้นที่ระดับสูง ส่วนเส้นเชื่อมแทนความสัมพันธ์ เช่น ON (วางบน), IN (อยู่ภายใน) หรือ CONNECTED (พื้นที่เชื่อมถึงกัน) ระบบแต่ละแบบเลือกชนิดโหนดและเส้นเชื่อมให้เหมาะกับโจทย์ จึงไม่มี schema เดียวที่ทุกงานใช้เหมือนกัน
ข้อมูลภาพหรือแผนที่เรขาคณิตช่วยยึดโหนดกับตำแหน่งและรูปร่าง ส่วนชื่อและป้ายเชิงภาษาเปิดทางให้ค้นด้วยคำสั่ง เช่น “red cup” อย่างไรก็ดี ความสัมพันธ์แต่ละเส้นควรบันทึกพร้อมที่มา ความเชื่อมั่น และเวลาที่สังเกต มิฉะนั้นประโยค “ถ้วยอยู่บนโต๊ะ” จะดูเหมือนข้อเท็จจริงเท่ากันทั้งที่กรณีหนึ่งเห็นจากภาพ ส่วนอีกกรณีเป็นคำบรรยายที่โมเดลสร้างขึ้น
นี่คือความต่างระหว่าง แผนที่ กับ แบบจำลองพลวัต: ขอบ ON บอกความสัมพันธ์ในสถานะที่แทนอยู่ แต่ไม่ได้บอกว่าถ้าผลักโต๊ะแล้วถ้วยจะกลิ้งอย่างไร ไม่ได้พิสูจน์ว่าโต๊ะรับน้ำหนักหรือถ้วยยังอยู่ตำแหน่งเดิม และไม่เท่ากับการตรวจว่าหุ่นยนต์เอื้อมถึงหรือไม่ การวางแผนจึงอาจต้องประกอบกราฟกับตัวจำลองเงื่อนไข การวางแผนเส้นทาง และระบบควบคุมที่มีหลักฐานเฉพาะของตน

Scenegraph Explorer
ข้อมูลและผลลัพธ์เป็นฉากจำลองที่กำหนดไว้ ผล READY ไม่ใช่ข้อมูลเซนเซอร์หรือการอนุญาตให้หุ่นยนต์ทำงานจริง
Graph edge ledger / รายการความสัมพันธ์
วิธีอ่าน Explorer: ตัวอย่างใช้ห้อง hall, kitchen, office, store มีโต๊ะอยู่ในครัว โต๊ะทำงานอยู่ในออฟฟิศ ตู้อยู่ในห้องเก็บของ ถ้วยแดงอยู่บนโต๊ะ ถ้วยน้ำเงินอยู่บนโต๊ะทำงาน และกุญแจอยู่ในตู้ ห้องเชื่อมกันตามแผนผังที่แสดง ระบบค้นตำแหน่งด้วยสายสัมพันธ์ ON/IN ต่อขึ้นไปจนถึงห้อง แล้วค่อยหาเส้นทางสั้นที่สุดบนกราฟห้อง ความสัมพันธ์ NEAR ที่บอกว่าถ้วยแดง “ใกล้” ออฟฟิศไม่พอจะระบุตำแหน่งในตัวอย่างนี้
Lab นี้เป็น SIMULATION แบบกำหนดกฎและข้อมูลไว้ล่วงหน้า ไม่ได้ประมวลผล RGB-D, ไม่ได้ทำ SLAM, ไม่ได้เรียก LLM หรือโมเดลตรวจจับวัตถุ และไม่ได้ทำซ้ำ ConceptGraphs, Hydra หรือ SayPlan ป้าย READY หมายถึงกราฟของเล่นมีตำแหน่งและเส้นทางที่ผ่านกฎที่กำหนดเท่านั้น ไม่รับรองว่าของจริงหยิบได้ เส้นทางปลอดการชน หรือมีการอนุมัติให้หุ่นยนต์ลงมือ
สามงานที่มักถูกเรียกรวม แต่ทำคนละช่วง
ANALYSIS: ConceptGraphs, Hydra และ SayPlan แสดงสามช่วงของระบบ ได้แก่ สร้างกราฟวัตถุจากภาพ, สร้างและปรับแผนที่เชิงพื้นที่, และค้นกราฟเพื่อวางแผนงาน แต่ละงานใช้ benchmark และตัวชี้วัดต่างกัน
| ระบบ / หลักฐาน | ทำอะไร | สิ่งที่ควรจำ |
|---|---|---|
| ConceptGraphs — ICRA 2024 | สร้างแผนที่วัตถุแบบ open-vocabulary จากภาพ RGB-D ที่มี pose | ความสัมพันธ์ทางภาษาบางส่วนได้จากโมเดล ไม่ใช่การวัดฟิสิกส์ |
| Hydra — RSS 2022 | สร้างแผนที่ metric-semantic และกราฟระดับสถานที่ถึงอาคารอย่างต่อเนื่อง | จุดแข็งคือโครงสร้างพื้นที่และการอัปเดตแผนที่ ไม่ใช่ LLM planner |
| SayPlan — CoRL 2023 | ค้นและวางแผนงานบน 3D scene graph ที่เตรียมไว้แล้ว | ตรวจแผนกับ simulator ได้ แต่ไม่ได้สร้างกราฟจากภาพดิบ |
ConceptGraphs (FACT): รับลำดับภาพ RGB-D ที่มีท่าทางกล้องกำกับ ใช้ SAM สร้าง instance mask และ CLIP ทำ visual descriptor จากนั้นฉายพิกเซลลง 3 มิติ เพื่อเชื่อมการสังเกตวัตถุเดียวกันข้ามเฟรมด้วยคะแนนความทับซ้อนทางเรขาคณิตและความคล้ายเชิงความหมาย โดยจับคู่แบบ greedy กับโหนดที่คะแนนสูงสุด หากไม่ผ่าน threshold จะสร้างโหนดใหม่ งานทดลองพบว่า Hungarian assignment ช้ากว่าและดีขึ้นเพียงเล็กน้อย จุดที่จับคู่กันจะถูกรวมเป็น point cloud และ feature ของโหนดวัตถุ (paper, §§II–III)
หลังประมวลผลทุกเฟรม ระบบเลือกภาพที่ดีที่สุดได้ถึง 10 มุมต่อวัตถุ ให้ LLaVA สร้าง caption แล้วใช้ GPT-4 สรุป caption เหล่านั้น สำหรับความสัมพันธ์ งานใช้ IoU ของ 3D bounding box สร้างคู่ผู้สมัคร ลดกราฟด้วย minimum spanning tree (MST) แล้วให้ LLM ติดป้ายและอธิบายคู่ที่เหลือ รุ่นที่รายงานใช้ GPT-4 (gpt-4-0613) ขั้นตอนนี้ลดคู่ที่ต้องพิจารณา แต่คำว่า “บน” หรือ “ข้าง” ยังเป็นการอนุมานจาก caption/ตำแหน่ง ไม่ใช่การวัดฟิสิกส์ (paper, §II)
REPORTED CLAIM: ใน Replica ผู้ประเมินมนุษย์ให้ค่าเฉลี่ย node-label precision 0.71 และ edge precision 0.88 สำหรับ ConceptGraphs รุ่นหลัก ตัวเลขนี้วัดป้ายกราฟในการตั้งค่าของงาน ไม่ใช่ความสำเร็จภารกิจหุ่นยนต์ และเทียบกับอีกสอง paper โดยตรงไม่ได้ (paper, Table I) การพลาด segmentation, รวม instance ผิด, caption คลาด หรือ MST ตัดความสัมพันธ์ออกอาจส่งต่อความผิดพลาดไปยังการค้นหาได้
Hydra (FACT): งาน RSS 2022 สร้างกราฟห้าชั้น ได้แก่ mesh แบบ metric-semantic, วัตถุและ agent, places ที่เดินทางได้พร้อมเส้นเชื่อม, rooms และ building ชั้นต่าง ๆ เชื่อมกัน เช่น vertex เป็นส่วนหนึ่งของวัตถุ วัตถุอยู่ในห้อง และห้องอยู่ในอาคาร ระบบสร้างแผนที่และแก้กราฟหลัง loop closure แบบต่อเนื่อง (paper; proceedings abstract)
ระบบแยกงานเร็วใกล้หุ่นยนต์จากงานระดับสูงที่ช้ากว่า มี ESDF รอบเส้นทางปัจจุบัน (รัศมี 8 เมตรตามการตั้งค่าของ paper) แต่คงกราฟใหญ่ไว้ สกัด Generalized Voronoi Diagram เพื่อหา places/เส้นทาง จัดกลุ่มเป็นห้อง และใช้ descriptor เสนอ loop closure ก่อนยืนยันด้วยเรขาคณิต
Hydra เน้นโครงสร้างเรขาคณิตและ topology ไม่ได้แปลป้ายทุกห้องเป็น “ครัว” หรือ “ห้องนอน” ได้เอง และไม่ใช่ตัววางแผนภาษาธรรมชาติ ห้องเปิดโล่งหรือ odometry ที่คลาดอาจทำให้แบ่งห้องผิดได้ ผู้วิจัยระบุด้วยว่าบางโหนดยังไม่มี semantic label และกล่าวถึงการเรียนรู้เพื่อเติมป้ายเป็นงานต่อไป การปรับกราฟเมื่อพบ loop closure ช่วยแก้แผนที่ แต่ไม่ทำให้ข้อมูลวัตถุที่เปลี่ยนตำแหน่งเป็นปัจจุบันโดยอัตโนมัติ
SayPlan (FACT): เริ่มจาก 3D scene graph ที่สร้างไว้ก่อน มีระดับ floors, rooms, assets, objects และ pose nodes เชื่อม topology ห้อง ใช้ JSON ย่อกราฟเพื่อให้ LLM ค้น subgraph ที่เกี่ยวข้องจากภาพรวม (paper; PMLR abstract)
ขั้นแรก LLM ใช้ expand/contract ผ่าน graph simulator เพื่อเลือก subgraph แล้วร่างแผนระดับสูง จากนั้น classical path planner เติมเส้นทาง simulator ตรวจ predicates, state และ affordance แล้วส่งข้อผิดพลาดกลับให้ LLM วางแผนใหม่ได้สูงสุดห้าครั้งในการทดลอง โมเดลหลักคือ GPT-4; GPT-3.5 ใช้เฉพาะ semantic-search evaluation เมื่อตรวจผ่าน แผนจึงส่งต่อไปยัง motion planner/controller ระดับต่ำ (paper, §§III–IV)
จุดสำคัญคือ simulator ตรวจตาม predicates และ effects ที่ผู้สร้างโมเดลไว้ มันช่วยจับแผนที่ทำไม่ได้ภายใต้กฎนั้น แต่ไม่ได้รับประกันว่ากฎครอบคลุมโลกจริงครบ การสาธิตหุ่นยนต์จริงยังมี perception, localization, motion control และ visual feedback แยกต่างหาก จึงไม่ควรตีความ simulator acceptance เป็นหลักประกันความสำเร็จทางกายภาพ
REPORTED CLAIM: งานประเมินในสองสภาพแวดล้อม สูงสุด 3 ชั้น, 36 ห้อง และ 140 assets/objects ขนาดนี้เป็นขอบเขตชุดทดลอง ไม่ใช่มาตรวัดที่เทียบกับอีกสองระบบได้ (PMLR paper) ผู้วิจัยระบุข้อผิดพลาดการให้เหตุผลเรื่องระยะทาง จำนวนโหนด และ negation รวมทั้งสมมติว่าวัตถุคงที่หลังสร้างแผนที่

จากคำสั่งสู่เส้นทาง: จุดตรวจระหว่างทาง
ANALYSIS: สถาปัตยกรรมที่ใช้กราฟมักแยกได้เป็นลำดับนี้: (1) สังเกตและสร้างโหนด/ความสัมพันธ์ (2) ระบุสิ่งที่คำสั่งอ้างถึง (3) หาเส้นความสัมพันธ์ไปยังพื้นที่ (4) ตรวจความสดและที่มาของหลักฐาน (5) สร้างเส้นทางหรือแผน (6) ตรวจเงื่อนไขก่อนลงมือ และ (7) รับ observation ใหม่เมื่อข้อมูลหรือโลกเปลี่ยน การแยกขั้นช่วยระบุว่าความผิดเกิดจากการมองเห็น การเชื่อมโหนด การอนุมาน relation หรือการวางแผน
ตัวอย่างคำสั่ง “ไปหยิบถ้วย” ต้อง resolve ว่าหมายถึงถ้วยไหนก่อน ถ้ามีหลายใบ คำตอบที่ถูกคือถามเพิ่มหรือแจ้งกำกวม ไม่ใช่เลือกโหนดแรก หากพบถ้วยแดงแต่มีเพียงเส้น NEAR office การกระโดดไปออฟฟิศในฐานะตำแหน่งแน่นอนคือการตีความเกินหลักฐาน เมื่อสาย ON table → IN kitchen มีหลักฐานครบและยังสด จึงค่อยค้นเส้นทางในกราฟห้อง
ถ้าเส้นความสัมพันธ์ถูกอนุมานหรือเก่า ระบบควรพักการวางเส้นทางและขอการสังเกตใหม่ ถ้าความสัมพันธ์สองสายชี้ไปคนละห้อง ผลคือกำกวม ไม่ใช่เฉลี่ยตำแหน่ง หากเป้าหมายมีตำแหน่งแต่กราฟห้องไม่มีทางเชื่อม ควรรายงานว่าไม่มีเส้นทางตามกราฟนั้น แทนการสร้างทางลัดขึ้นมาเอง แม้เส้นทางสั้นที่สุดจะผ่านกราฟ ก็ยังต้องมีการตรวจอุปสรรค การเข้าถึง และการอนุมัติจากระบบควบคุมก่อนการเคลื่อนที่จริง

Six Mission Challenge
จำแนกจากหลักฐานจำลอง และเลือกเส้นทางเมื่อ READY เท่านั้น คะแนนเป็นคะแนนเกมนี้ READY ไม่ใช่การยืนยันความปลอดภัยหรือการอนุญาตให้ปฏิบัติการจริง
เกมจำลองมี 6 ภารกิจให้จำแนกกรณี: ตำแหน่งปกติ, เป้าหมายกำกวม, ความสัมพันธ์ NEAR อย่างเดียว, หลักฐานอนุมาน, เส้นทางถูกปิด และเส้นทางสั้นที่สุดที่เสมอกัน ผู้เล่นต้องเลือกสถานะที่ถูกและเลือกเส้นทางเมื่อสถานะเป็น READY คำตอบผิดถูกปฏิเสธ และเริ่มใหม่ได้ SIMULATION: เกมตรวจความสอดคล้องกับกฎ 12 fixture ที่กำหนดล่วงหน้า ไม่ได้วัดว่าโมเดลรับรู้ภาพจริงดีขึ้นหรือไม่
ข้อสังเกตจากเกมคือ “ไม่พบหลักฐานตำแหน่ง” ไม่เท่ากับ “ไม่มีวัตถุนั้น” คำค้น book ไม่อยู่ใน alias ที่รองรับ จึงได้ UNKNOWN_TARGET ไม่ใช่หลักฐานว่าไม่มีหนังสือในห้องจริง ส่วน cup จับได้ทั้งถ้วยแดงและน้ำเงิน จึงได้ AMBIGUOUS_TARGET และ redcup ที่มีเพียง NEAR ไม่ได้ตำแหน่งห้อง เพราะเกมใช้เฉพาะสาย ON/IN เพื่อไล่ขึ้นไปถึงห้อง
ข้อจำกัดที่ต้องนำไปออกแบบระบบ
ANALYSIS: กราฟมีจุดเปราะบางสามช่วงที่ควรแยกบันทึกและวัดผล
- การสร้างโหนด: instance หนึ่งถูกแบ่งเป็นหลายชิ้นหรือวัตถุสองชิ้นถูกรวมกันหรือไม่? ภาพที่ไม่เห็นด้านหลังไม่ใช่หลักฐานว่าไม่มีวัตถุ
- การสร้างเส้น:
ON,IN,CONNECTEDมาจากเรขาคณิต กฎเชิงตรรกะ หรือข้อความที่โมเดลอนุมาน? ความสัมพันธ์เชิงภาษาอาจฟังสมเหตุผลแต่ผิด - การใช้แผน: แผนที่ถูกสร้างเมื่อไร วัตถุเปลี่ยนสถานะหรือยัง และ simulator ตรวจเงื่อนไขใดบ้าง? การจำลองสำเร็จภายใต้กฎที่ไม่ครบยังทำให้แผนผิดได้
บันทึก provenance ต่อข้อเท็จจริง เช่น เซนเซอร์/เฟรมหรือโมดูลต้นทาง, timestamp, confidence, รุ่นแผนที่ และสถานะ observed/inferred ช่วยให้ระบบตัดสินใจได้ว่าความสัมพันธ์ใดใช้วางแผนได้หรือจำเป็นต้องตรวจใหม่ ค่าความเชื่อมั่นเพียงตัวเดียวก็ไม่ควรแทนความหมายทุกอย่าง: confidence สูงจากโมเดลไม่ได้เท่ากับการตรวจยืนยันทางกายภาพ
เมื่อหลักฐานขัดแย้ง ให้เก็บสถานะ ambiguous แล้วเลือก observation เพื่อคลี่คลาย เช่น ขยับกล้อง ตรวจภาพ หรือถามผู้ใช้ สำหรับหุ่นยนต์จริง จำกัด action ตามความเสี่ยง
Context ที่ใช้คิดไม่ใช่ข้อมูลที่เก็บไว้ทั้งหมด
การวางแผนผ่าน LLM อาจใช้ข้อมูลหลายชั้นที่ควรแยกคำให้ชัด Context Window คือข้อความและข้อมูลที่โมเดลเห็นในรอบเรียกปัจจุบัน Retrieved Context คือส่วนของกราฟหรือเอกสารที่ระบบค้นมาใส่ใน prompt External Memory คือฐานข้อมูลหรือกราฟที่เก็บอยู่นอกโมเดลและเรียกใช้ภายหลัง ส่วน Weight Updates คือการปรับพารามิเตอร์ด้วยการฝึก ไม่ใช่การเพิ่ม node หรือแก้แผนที่
SayPlan ใช้การค้น subgraph เพื่อลดเนื้อหาที่ส่งให้ LLM นี่เป็นการเลือก Retrieved Context ไม่ได้แปลว่าโมเดลฝึกใหม่ทุกครั้งที่ได้ข้อมูลเพิ่ม ในทำนองเดียวกัน การแก้ตำแหน่งวัตถุใน external graph หรือการให้ LLM วางแผนใหม่ยังไม่ใช่ Weight Updates ข้อแยกนี้ทำให้รายงานพฤติกรรมได้แม่น: Agent อาจปรับแผนเพราะได้รับ observation ใหม่ โดยไม่เปลี่ยนน้ำหนักหรือเรียนรู้ความรู้ทั่วไป
HYPOTHESIS — แนวทางออกแบบ: เก็บกราฟเป็น external memory ที่มี version และเวลา แล้วดึง subgraph เท่าที่งานต้องใช้ พร้อมแนบ provenance ให้ทุก relation และให้ planner แยกสถานะ “ยืนยันแล้ว”, “อนุมาน”, “เก่า” และ “ขัดแย้ง” ออกจากกัน เพิ่ม verifier ที่ทดสอบ preconditions กับแผน และเมื่อไม่แน่ใจให้เลือกการสังเกตใหม่ก่อน action ที่มีผลจริง แนวทางนี้เป็นข้อเสนอที่ต้องประเมินกับงานและข้อมูลเฉพาะ ไม่ใช่ผลที่สาม paper พิสูจน์ร่วมกัน
เลือกชิ้นส่วนให้ตรงกับงาน
ตัวอย่างงานประยุกต์ที่แต่ละ paper แสดง: ConceptGraphs ทดลองงาน perception, navigation และ manipulation บนหุ่นยนต์จริง; Hydra ประเมินการสร้างกราฟออนไลน์ด้วยข้อมูลจำลองและจริง; SayPlan วางแผนคำสั่งระยะยาวให้ mobile manipulator และเผยแพร่วิดีโอสาธิตหุ่นยนต์ (ConceptGraphs, Hydra, SayPlan). หลักฐานเหล่านี้สาธิตคนละขั้นของระบบและไม่ใช่ผลทดสอบเดียวกัน
ถ้าโจทย์คือค้นวัตถุด้วยคำเปิดกว้างจากภาพหลายมุม ConceptGraphs เชื่อม geometry กับ semantic feature และภาษา แต่ต้องตรวจ segmentation, association และ caption/edge ที่โมเดลสร้าง ถ้าโจทย์คือแผนที่พื้นที่ที่อัปเดตต่อเนื่องและปิด loop Hydra เชื่อม geometry กับ places/rooms แต่ต้องเติม semantic labels และ planner ตามงาน ถ้าโจทย์คือแปลงคำสั่งเป็นแผนบนกราฟพร้อม predicates SayPlan แสดงการค้นกราฟ วางแผน และรับ feedback จาก simulator แต่ต้องตรวจคุณภาพแผนที่และความครอบคลุมของ simulator
การประกอบหลายชิ้นเพิ่มจุดผิดพลาดได้ตั้งแต่ object mapper ถึง planner จึงควรตรวจทั้งรายโมดูลและ end-to-end

แนวทางทดลองและคำถามวิจัย
การประเมินควรแยกคุณภาพ instance, ความถูกต้อง/ความสดของ relation, การค้นเป้าหมาย, เส้นทาง, precondition และความสำเร็จงานจริง ระบุชุดข้อมูล ground truth และทดสอบวัตถุย้าย ป้ายผิด ห้องเปิดโล่ง และเส้นขัดแย้ง
การเปรียบเทียบต้องควบคุมข้อมูลที่แต่ละระบบเห็นและแยก perception จาก planner หาก ConceptGraphs รับ RGB-D แต่ SayPlan ได้กราฟที่เตรียมครบ ผลปลายทางไม่ได้จัดอันดับ planner การทดลอง ablation ช่วยระบุว่าชั้นใดเพิ่มประโยชน์
คำถามวิจัยยังรวมถึงการเลือก observation ที่แก้กำกวมโดยต้นทุนต่ำ การส่ง uncertainty จากภาพถึงความเสี่ยงของ action และการจัดการเวลา/version เมื่อหลาย Agent แก้กราฟร่วมกัน ซึ่งต้องทดสอบกับภารกิจจริง
Practical Takeaways
- แยก “รู้จักวัตถุ”, “รู้ตำแหน่ง”, “รู้ความสัมพันธ์” และ “ลงมือได้” เป็นข้ออ้างคนละข้อ
- บันทึกแหล่งที่มา เวลา และสถานะ observed/inferred ของ node และ edge
- ใช้
ON/INสำหรับการไล่ตำแหน่งเฉพาะเมื่อ schema และหลักฐานรองรับ อย่าแปลงNEARเป็น containment - ส่งให้ planner เฉพาะ subgraph ที่เกี่ยวกับงาน แต่เก็บบริบทและ version เพื่อย้อนตรวจได้
- ทดสอบความกำกวม ความสัมพันธ์เก่า เส้นทางตัน และแผนที่ขัดแย้งก่อนการเชื่อมต่อหุ่นยนต์จริง
- ระบุให้ชัดว่าเป็นผลจาก paper, การวิเคราะห์, สมมติฐานออกแบบ หรือ simulation
FAQ
3D Scene Graph ต่างจากแผนที่ 3 มิติทั่วไปอย่างไร?
แผนที่ 3 มิติทั่วไปอาจเก็บพื้นผิว จุด หรือ occupancy ส่วน scene graph เพิ่มโหนดและความสัมพันธ์เชิงวัตถุ/พื้นที่ให้ค้นและเชื่อมกับงานได้ แต่รูปแบบขึ้นกับระบบ บางกราฟมี geometry มาก บางกราฟเน้น topology หรือ predicates
เส้น “ถ้วยอยู่บนโต๊ะ” พิสูจน์ว่าหุ่นยนต์หยิบได้ไหม?
ไม่ได้ เส้นนี้ระบุ relation ในข้อมูล ณ เวลาหนึ่ง อาจอนุมานมาจากโมเดล และไม่ได้ยืนยันว่าถ้วยยังอยู่ตรงนั้น มือเอื้อมถึง ไม่มีสิ่งกีดขวาง หรือแรงจับปลอดภัย ต้องตรวจด้วย perception และ motion/control ที่เกี่ยวข้อง
ConceptGraphs, Hydra และ SayPlan แข่งกันหรือไม่?
ไม่ใช่ benchmark เดียวกัน ConceptGraphs มุ่งสร้าง object-centric open-vocabulary graph, Hydra สร้าง metric-semantic/hierarchical map แบบต่อเนื่อง และ SayPlan วางแผนบน graph ที่เตรียมไว้แล้ว การเปรียบเทียบที่เหมาะคือดูบทบาทและสมมติฐาน ไม่จัดอันดับผลตัวเลขข้าม paper
ถ้า Agent หา object ไม่พบ แปลว่า object ไม่มีหรือไม่?
ไม่เสมอไป อาจอยู่นอกมุมกล้อง ถูกบัง ไม่มี alias ที่รองรับ หรือ graph ยังไม่อัปเดต การไม่พบใน Retrieved Context ก็ไม่พิสูจน์ว่าไม่มีใน External Memory หรือโลกจริง
Agent วางแผนใหม่หลังข้อมูลเปลี่ยน แปลว่าเรียนรู้แล้วหรือยัง?
ยังสรุปไม่ได้ อาจเพียงดึง Retrieved Context ใหม่ แก้ External Memory หรือใช้กฎเดิมคำนวณแผนใหม่ การเรียนรู้จาก Weight Updates เป็นกระบวนการคนละแบบและต้องมีหลักฐานการฝึก/เปลี่ยนน้ำหนัก
READY จาก Lab หมายถึงอะไร?
หมายถึงเป้าหมายมีห้องที่ระบุได้จากสาย ON/IN ที่ observed และ fresh และมีเส้นทางสั้นที่สุดตามกราฟห้องในตัวอย่างเท่านั้น ไม่ได้ยืนยันว่ามีวัตถุจริงหรือ robot action ปลอดภัย
References: แหล่งปฐมภูมิ
- Gu et al. (2023; ICRA 2024), ConceptGraphs: Open-Vocabulary 3D Scene Graphs for Perception and Planning. arXiv record, official project and paper, official code.
- Hughes, Chang & Carlone (2022), Hydra: A Real-time Spatial Perception System for 3D Scene Graph Construction and Optimization. RSS proceedings page and paper, official code.
- Rana et al. (2023), SayPlan: Grounding Large Language Models using 3D Scene Graphs for Scalable Task Planning. PMLR proceedings page, canonical PDF, project page. ไม่ระบุ official code repository เพราะการค้นคว้ารอบนี้ยังยืนยัน URL ต้นทางดังกล่าวไม่ได้
- บทความ Hybrid Mind ที่เกี่ยวข้อง: Agent Memory: Object-Centric Slots and Temporal Identity และ World Models: Memory, Reasoning and Planning.
ขอบเขตหลักฐาน: ตัวเลขเป็นผลที่ผู้วิจัยรายงาน ไม่ได้รันโค้ดต้นฉบับหรือทำซ้ำ benchmark ต้นทุน API/ฮาร์ดแวร์ปัจจุบันยัง UNKNOWN ข้อเสนอผสมระบบเป็น HYPOTHESIS; Explorer และเกมเป็น SIMULATION ตามกฎตายตัว ไม่มี RGB-D, SLAM หรือ model inference คำอธิบายเหตุผลที่ LLM สร้างไม่ใช่หลักฐานแทนร่องรอยการค้นและผลตรวจเครื่องมือ
ใส่ความเห็น