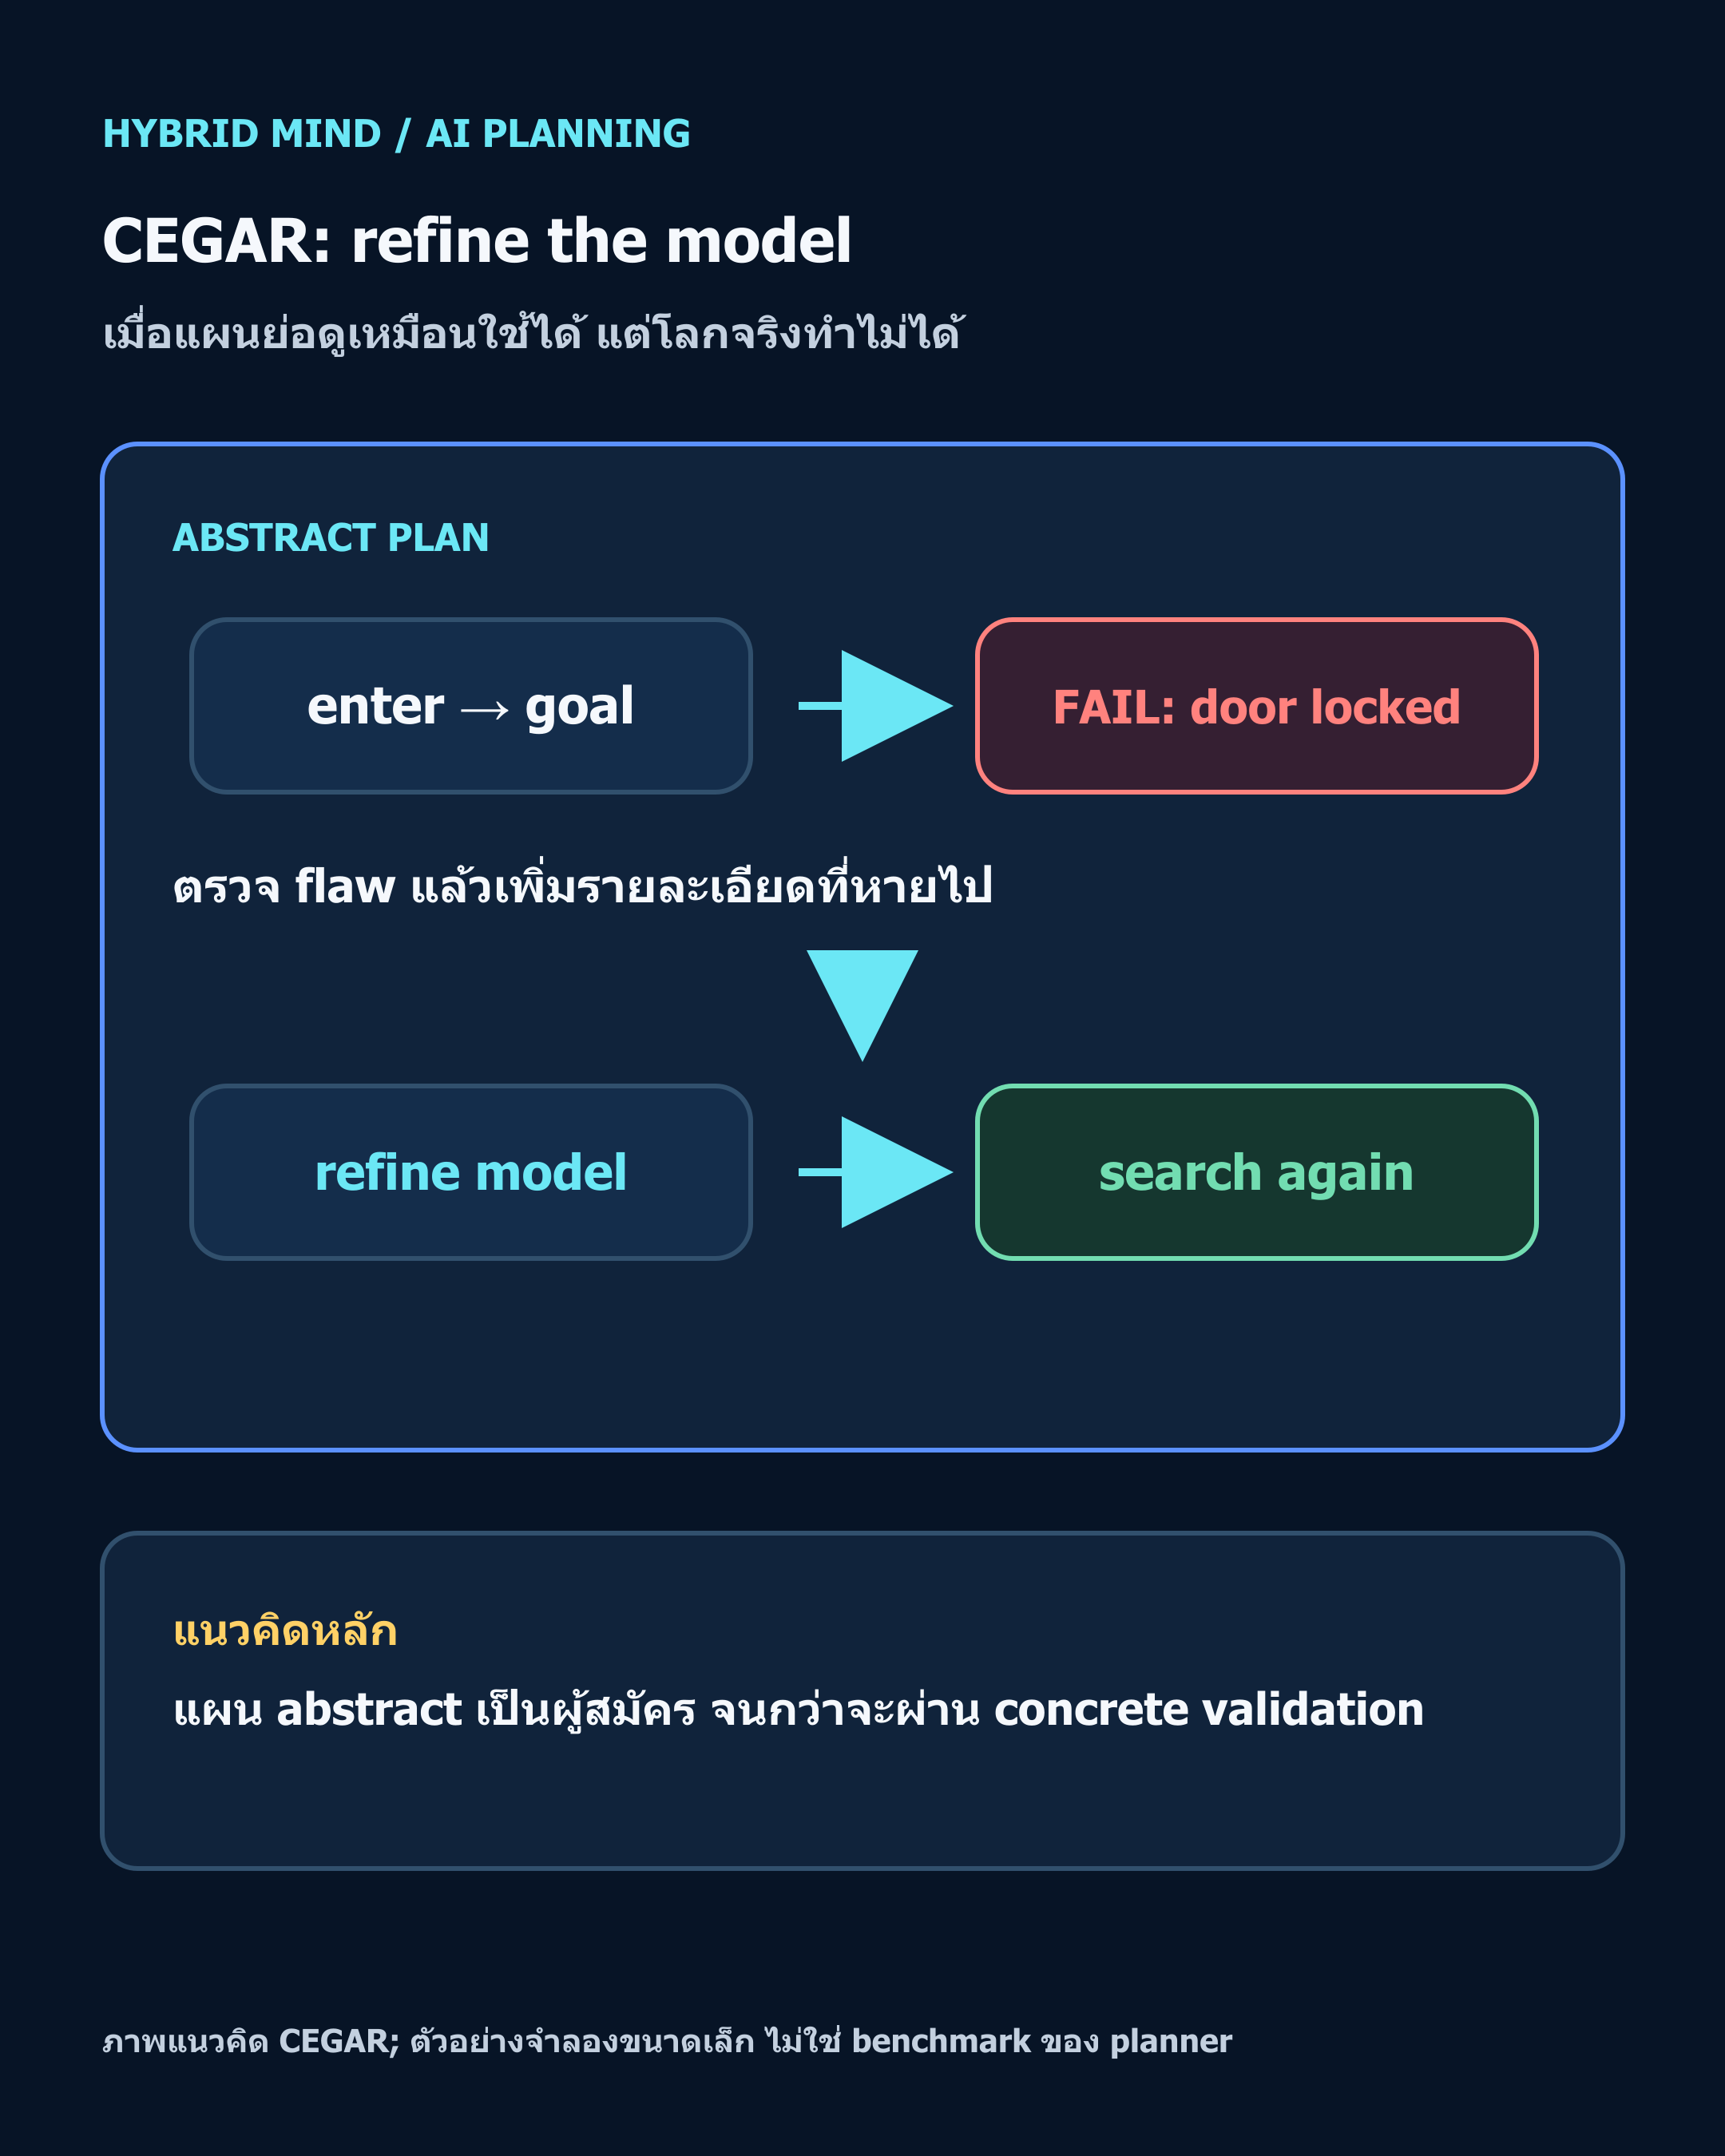
คำตอบสั้น ๆ — Counterexample-Guided Abstraction Refinement (CEGAR) สำหรับ classical planning เริ่มจากแบบจำลองย่อที่เล็กและยอมให้มีพฤติกรรมเกินจริง หาเส้นทางสู่เป้าหมายในแบบจำลองนั้น แล้วไล่ตรวจเส้นทางกับ task จริง หากเดินตามไม่ได้ ระบบใช้จุดแรกที่ขัดแย้งเป็นหลักฐานเพื่อแบ่ง abstract state ให้ละเอียดขึ้น จนเส้นทางเดิมใช้ไม่ได้อีก วิธีนี้สร้าง heuristic ที่เป็น lower bound ได้ และถ้ารันต่อโดยไม่มีข้อจำกัด ก็อาจพบแผน optimal หรือพิสูจน์ว่าไม่มีแผน [REPORTED CLAIM]

ทำไมแผนปลอมจึงมีประโยชน์
ลองจินตนาการว่าหุ่นยนต์ต้องไปถึงห้องเป้าหมาย แต่ประตูล็อกอยู่และกุญแจวางอีกห้องหนึ่ง การวางแผนแบบละเอียดต้องติดตามตำแหน่งหุ่นยนต์ สถานะกุญแจ และสถานะประตูพร้อมกัน หากเรายุบรายละเอียดบางอย่างออก กราฟที่เหลือจะเล็กลงและค้นหาได้ง่ายขึ้น แต่การยุบข้อมูลอาจทำให้การกระทำที่ต่อกันได้ในกราฟย่อ ไม่สามารถต่อกันได้ในโลกจริง
ความผิดพลาดแบบนี้เรียกว่าแผน spurious หรือเส้นทางลวงของ abstraction มันไม่ใช่ผลลัพธ์ที่ควรส่งไปให้หุ่นยนต์ลองทำ แต่เป็นคำถามที่ช่วยเปิดเผยว่าการย่อข้อมูลลืมเงื่อนไขสำคัญอะไรไว้ [ANALYSIS] CEGAR ใช้การตรวจสอบกับแบบจำลองต้นฉบับเพื่อแยกสองกรณี: เส้นทางนั้นเป็นแผนจริง หรือเกิดขึ้นได้เพราะ abstraction หลวมเกินไป
บทความนี้อธิบาย CEGAR แบบ Cartesian ของ Seipp และ Helmert สำหรับ optimal classical planning และแยกจากของเล่นสาธิตที่เพิ่มตัวแปรกลับเข้าโมเดล งานจริงแบ่ง abstract state ด้วยชุดค่าของตัวแปร ไม่ใช่เพียงเปิดตัวแปรเพิ่มแล้วฉายสถานะใหม่ [FACT] JAIR 2018
แผนที่ทำให้ abstraction เก่งขึ้น
เราจำลอง task แบบ deterministic ด้วยสถานะเริ่มต้น การกระทำที่มี precondition และ effect และเงื่อนไขเป้าหมาย แต่ละสถานะบอกค่าปัจจุบันของตัวแปรทุกตัว เช่น loc=start, key=0, door=0 ส่วนการกระทำ unlock อาจมี precondition ว่าอยู่หน้าเริ่มต้นและมีกุญแจ แล้วเปลี่ยนค่า door เป็น 1
Abstraction รวมหลายสถานะจริงให้เป็นสถานะนามธรรมเดียว ทำให้กราฟค้นหามีขนาดเล็กลง แนวคิดที่ใช้ได้กับ heuristic คือให้ abstract transition system ยอมรับการเปลี่ยนสถานะที่สอดคล้องกับการเปลี่ยนจริงทั้งหมด และใช้น้ำหนักการกระทำที่ไม่สูงกว่าต้นทุนจริง ภายใต้เงื่อนไขนี้ ระยะทางสั้นที่สุดจาก abstract state ไปยัง abstract goal จะไม่มากกว่าระยะทางจริง จึงเป็น lower bound หรือ admissible heuristic [ANALYSIS]
abstraction แบบหยาบอาจเพิ่มเส้นทางปลอมและกดค่าประเมินลง เช่น กราฟที่มองแค่ตำแหน่งอาจให้ enter ถึงเป้าหมายทันทีทั้งที่ประตูล็อกอยู่ ค่าประเมิน 1 ไม่ใช่แผนหนึ่งก้าวจริง แต่ยังเป็น lower bound ได้ หากกราฟ abstraction รักษาเงื่อนไขที่กล่าวไว้
CEGAR เริ่มจากสถานะนามธรรมหนึ่งก้อนที่ครอบคลุมสถานะจริงทั้งหมด ในแต่ละรอบหาทางไปเป้าหมายที่มีต้นทุนต่ำที่สุดในกราฟนามธรรม จากนั้นนำลำดับ action เดิมไปจำลองในสถานะเริ่มต้นจริง หากทุก action ใช้ได้และสถานะปลายทางตรงกับเป้าหมาย เส้นทางนั้นเป็นแผนจริง หากตรวจไม่ผ่าน เราได้ “flaw” ซึ่งบอกว่าสถานะจริงปัจจุบันกับ abstract state ใน trace ไม่สอดคล้องกัน
ใน Cartesian abstraction สถานะนามธรรมคือผลคูณของเซตค่าต่อหนึ่งตัวแปร เช่น {start} × {0,1} × {0,1} หมายถึงตำแหน่งต้องอยู่ start แต่กุญแจและประตูอาจเป็นค่าใดก็ได้ ระบบเก็บเซตค่าของแต่ละตัวแปร ไม่ต้องแจกแจงทุกสถานะจริงที่อยู่ในผลคูณนั้น [FACT] JAIR 2018
เมื่อพบ flaw อัลกอริทึมสร้างชุด Cartesian ที่เป็นสาเหตุของความไม่ตรงกัน เช่น สถานะที่ action ต้องการแต่สถานะจริงเดินไปไม่ถึง จากนั้นแบ่ง abstract state ที่เกี่ยวข้องออกเป็นสองส่วน เพื่อให้สถานะจริงที่ตรวจอยู่แยกจากชุดสาเหตุ ระบบเลือกตัวแปรที่จะแบ่งและเลือกว่าจะย้ายค่าใดไปแต่ละฝั่ง การเลือกนี้มีผลต่อขนาดและความแม่นของ heuristic แต่การแบ่งต้องยังเป็น abstraction ที่ sound

โครงสร้างอัลกอริทึมจริง
อินพุตคือ finite-domain planning task ซึ่งมีตัวแปร โดเมน ค่าเริ่มต้น action พร้อม precondition/effect/cost และ goal ระบบเริ่มด้วย trivial abstraction แล้วเก็บ abstract state เป็นเซตย่อยของค่าในแต่ละตัวแปร โครงสร้างสำคัญเพิ่มเติมคือกราฟสถานะนามธรรมพร้อม transition ที่ติดป้ายชื่อ action, ระยะทางสั้นที่สุดจากแต่ละ abstract state ไป goal และลำดับการแบ่ง state ที่ช่วยค้นหาว่าสถานะจริงตกอยู่ในส่วนใด [FACT] JAIR 2018
การสร้าง transition ตรวจว่า precondition ของ action เข้ากันได้กับค่าที่ abstract state ต้นทางอนุญาตหรือไม่ และ effect รวมถึงค่าของตัวแปรที่ไม่เปลี่ยนเข้ากันได้กับปลายทางหรือไม่ เนื่องจาก abstract state มีหลายค่าต่อหนึ่งตัวแปร การกระทำชื่อเดียวกันอาจนำจาก abstract state เดียวไปได้หลายปลายทาง นี่เป็นสาเหตุหนึ่งที่แผนในกราฟย่ออาจเลือกทางแยกที่สถานะจริงไม่ได้ตาม
หลังแบ่ง state ระบบจะต่อ transition ที่เกี่ยวข้องใหม่ คำนวณระยะทางเป้าหมายใหม่หรือปรับข้อมูลค้นหาตาม implementation แล้ววนรอบอีกครั้ง งานปี 2013 อธิบายแกน CEGAR และงานวารสาร JAIR ปี 2018 ขยายรายละเอียดเรื่อง Cartesian abstractions กลยุทธ์สร้างชุด heuristic และ saturated cost partitioning สำหรับรวมค่าหลายชุดอย่าง admissible [FACT] ICAPS 2013 JAIR 2018
อัลกอริทึมแบบย่อมีดังนี้:
PSEUDOCODE: conceptual only — ไม่ใช่ source code ของ planner
สร้าง abstraction เริ่มต้น A
วนซ้ำจนถึงเงื่อนไขหยุด:
  trace = เส้นทางต้นทุนต่ำสุดจาก initial(A) ไป goal(A)
  ถ้าไม่มี trace: คืนว่า task จริงไม่มีแผน
  s = สถานะเริ่มต้นจริง
  สำหรับแต่ละ transition (a --o--> b) ใน trace:
    ถ้า o ใช้ไม่ได้ใน s: flaw = (s, [s] ∩ Cartesian(pre(o))); ไป refine
    ถ้า successor จริงของ s ด้วย o ไม่อยู่ใน b:
      flaw = (s, [s] ∩ regression(b, o)); ไป refine
    s = successor จริงของ s ด้วย o
  ถ้า s ไม่ใช่ goal: flaw = (s, [s] ∩ Cartesian(goal)); ไป refine
  คืนแผนจริงจาก trace ที่ replay ผ่าน
refine:
  A = split abstract state ที่มี s เพื่อแยก s ออกจากเซต flaw
คืน A เป็น heuristic ที่ยังกำหนด lower bound ได้
คำว่า “counterexample” ในบริบทนี้หมายถึงเส้นทางนามธรรมที่ท้าทายสมมติฐานของ abstraction ไม่ได้หมายความว่าแผนจริงผิด หรือระบบได้ตรวจโลกภายนอกแล้ว หาก trace จำลองผ่าน task ที่ให้มา มันเป็นแผนของโมเดลนั้นเท่านั้น หากโมเดลไม่รู้ว่าประตูติดขัดหรือกุญแจถูกย้าย การตรวจเชิงตรรกะก็รับรองข้อเท็จจริงที่ไม่อยู่ในอินพุตไม่ได้ [ANALYSIS]
ตัวอย่างของเล่น: ประตู กุญแจ และตำแหน่ง
เพื่อให้เห็นแนวคิดโดยไม่อ้างว่าเป็นการทำซ้ำ implementation จริง เรากำหนดสถานะ loc ∈ {start, goal}, key ∈ {0,1}, door ∈ {0,1} ค่าเริ่มต้นคือ (start,0,0) และเป้าหมายคือ loc=goal มี action ต้นทุนหนึ่งหน่วยสามตัว: takeKey ใช้ได้เมื่ออยู่ start แล้วตั้ง key เป็น 1; unlock ใช้ได้เมื่ออยู่ start และ key=1 แล้วตั้ง door เป็น 1; enter ใช้ได้เมื่ออยู่ start และ door=1 แล้วตั้ง loc เป็น goal [SIMULATION]
ในเดโมนี้แจกแจงสถานะจริงทั้งแปดค่าที่เป็นไปได้เพื่อสร้าง transition แบบ existential สำหรับตัวแปรที่เก็บไว้ กราฟหยาบเก็บแค่ loc จึงเห็น abstract plan enter ต้นทุน 1 แต่เมื่อจำลองจริง enter ใช้ไม่ได้เพราะ door=0 เราเผย door เพิ่มเป็นรอบสาธิตถัดไป กราฟจึงเสนอ unlock, enter ต้นทุน 2 แต่การตรวจจริงติดที่ key=0 เมื่อเผย key ด้วย trace takeKey, unlock, enter จึงผ่านจริง ต้นทุน 3
สิ่งนี้เป็นเพียง “projection refinement” แบบของเล่น: เพิ่มตัวแปรที่เก็บไว้ทั่วทั้งโมเดล มันไม่ได้แสดงการเลือก flaw, สร้าง Cartesian subset, split เฉพาะ abstract state ที่ผิด และ rewire transition แบบ Seipp–Helmert [FACT] [SIMULATION] ถ้านำภาพจำจากเดโมไปอธิบาย implementation จริง จะทำให้เข้าใจผิดว่า Cartesian CEGAR แค่เพิ่มมิติของ state vector ทีละตัว
เครื่องสำรวจ CEGAR
ดูว่าแผนในแบบจำลองย่อใช้ได้จริงหรือไม่ แล้วเพิ่มตัวแปรที่ขาด
เดโมมี preset เพิ่มเติมสำหรับตรวจพฤติกรรม: ถ้าเริ่มต้นพร้อมกุญแจ การเผย door แล้วตรวจเส้นทางจะสำเร็จ; ถ้าเอา takeKey ออกและเริ่มโดยไม่มี key เมื่อเปิดเผยตัวแปรครบแล้วจะไม่มีแผนในโมเดลจำกัดนี้; ถ้าเริ่มต้นพร้อม door ที่เปิด enter จะผ่านได้ตั้งแต่ต้น การรายงานว่า “ไม่มีแผน” จึงอาศัยการสำรวจกราฟของโมเดลตัวอย่างครบถ้วน ไม่ใช่การอนุมานจากการที่ลองแผนสองสามเส้นแล้วไม่สำเร็จ [SIMULATION]

เปรียบเทียบแนวทางที่ใกล้กัน
| วิธี | สิ่งที่ย่อหรือปรับ | จุดเด่น | สิ่งที่ต้องระวัง |
|---|---|---|---|
| Pattern database (PDB) | เก็บระยะทางของ projection ที่เลือกไว้ล่วงหน้า | ใช้ค่าระยะทางใน abstract state space ได้รวดเร็ว | การเลือก pattern สำคัญ; บวกหลายค่าไม่ได้โดยอัตโนมัติ |
| Merge-and-shrink | รวม transition systems และย่อสถานะตามเกณฑ์ | สร้าง abstraction เป็นลำดับจากโครงสร้างย่อย | ลำดับ merge และขนาดก่อนย่อมีผลต่อคุณภาพ |
| Cartesian CEGAR | เริ่มหยาบแล้ว split state เมื่อ trace มี flaw | ลงรายละเอียดตรงบริเวณที่ trace เปิดเผยว่า abstraction หลวม | การค้นหา trace, ตรวจ flaw, split, และการใช้หน่วยความจำมีต้นทุน |
PDB กับ Cartesian abstraction อยู่ในตระกูล abstraction heuristic เหมือนกัน แต่ CEGAR ใช้ trace ที่ตรวจไม่ผ่านเป็นตัวนำ refinement ในงาน JAIR ผู้เขียนยังเสนอสร้างชุด abstraction ตาม goal atoms หรือ landmarks และใช้ saturated cost partitioning เพื่อรวม heuristic อย่าง admissible เมื่อค่าเดียวอาจนับต้นทุน action ซ้ำกัน [REPORTED CLAIM] JAIR 2018 สำหรับพื้นฐานการเปรียบเทียบ PDB ดู บทความ Pattern Database ของ Hybrid Mind ที่อธิบายการ projection และเงื่อนไขการรวมค่า

ใช้กับ planner และ agent อย่างไร
ใน classical planning, heuristic คือค่าประเมินต้นทุนที่เหลือจากสถานะหนึ่ง ไม่ใช่คำตอบเป็นภาษาธรรมชาติและไม่ใช่แผนโดยตัวมันเอง A* ใช้ heuristic เพื่อจัดลำดับการขยายสถานะ ส่วน admissibility ช่วยให้ A* รักษาความเหมาะที่สุดได้เมื่อเงื่อนไขอื่นของการค้นหาครบถ้วน [ANALYSIS] Fast Downward 26.6 มี evaluator cegar(...) สำหรับ Additive Cartesian CEGAR heuristic พร้อมตัวเลือก subtasks, ขอบเขตจำนวน abstract states/transitions/time, กลยุทธ์เลือกตัวแปร split, random seed และ cache; เอกสารรุ่นนี้ระบุว่า heuristic admissible, consistent และ safe แต่ไม่รองรับ conditional effects หรือ axioms [FACT] Fast Downward 26.6
ตัวอย่าง syntax ในเอกสารรุ่น 26.6 คือ:
astar(cegar(subtasks=[goals()], max_states=100000))นี่เป็นตัวอย่างรูปแบบการตั้งค่า ไม่ใช่ผล benchmark และการตั้งค่าใช้งานจริงต้องตรวจเอกสาร/ตัวสร้าง task ตามรุ่นที่ติดตั้ง สำหรับ heuristic เดียวที่บทความนี้อธิบาย ไม่ควรสรุปว่าระบบทุกเวอร์ชันหรือทุกตัวเลือกมีคุณสมบัติเดียวกัน
สำหรับ AI agent ที่เรียกเครื่องมือ ให้ planner สร้างแผนจาก symbolic model แล้ว validator ตรวจ precondition และ transition ทุกขั้นก่อน executor หากแผนล้มเหลวจากโมเดลภายในไม่ละเอียดพอ CEGAR-style refinement อาจช่วยแยกกรณีที่เคยถูกรวมกัน [HYPOTHESIS] แต่เมื่อโลกเปลี่ยน perception ผิด หรือ API ปฏิเสธคำสั่ง ต้องอัปเดตสถานะและโมเดลก่อน การขัดเกลา abstraction เดิมไม่ใช่การรับรู้โลกใหม่
รูปแบบนี้คล้ายกับการแยกความจำหลายชั้นใน agent: context คือข้อความที่กำลังใช้งาน, retrieved memory คือข้อมูลที่ค้นกลับมา, external memory คือฐานข้อมูลหรือไฟล์ที่เก็บภายนอก, และ model weights คือพารามิเตอร์ที่เรียนรู้มา CEGAR อัปเดต abstraction ของ task ที่ระบุ ไม่ได้เขียนความรู้ถาวรลง weights และไม่ได้ทำให้ข้อมูลใน external memory ถูกต้องขึ้นโดยอัตโนมัติ [ANALYSIS] บันทึก action, state transition, validator result และเหตุผลที่แยก state เป็น trace ที่ตรวจสอบได้ ส่วน private chain-of-thought ไม่จำเป็นต่อการพิสูจน์ว่า action sequence ผ่าน validator หรือไม่
หลักฐานและขอบเขตของผลทดลอง
บทความ JAIR ปี 2018 รายงานการทดลองบนชุดงาน 1,667 tasks จาก optimization tracks ของ International Planning Competitions ปี 1998–2014 พร้อมจำกัดการทดลองที่ 30 นาทีและหน่วยความจำ 2 GiB; เวอร์ชันที่ใช้ CEGAR ได้เวลาสร้าง abstraction ไม่เกิน 15 นาที ผู้เขียนรายงานว่าชุด heuristic หลายแบบแข่งขันได้ดีกับ abstraction heuristics อื่นในหลาย benchmark domains [REPORTED CLAIM] ตัวเลขและข้อสรุปนี้เป็นผลที่รายงานในบทความ ไม่ใช่ผลที่เรารันซ้ำ JAIR 2018
ผู้เขียนระบุว่า code, benchmarks และ experimental data มีให้ทางออนไลน์ โดยอ้าง DOI แยกสำหรับ code และ benchmarks เราตรวจเห็นการอ้างอิงนี้ใน paper แต่เปิดปลายทางสองรายการเพื่อยืนยันเนื้อหาปัจจุบันไม่ได้ ส่วนหน้า ข้อมูลผลทดลองบน Zenodo ที่เปิดได้ ระบุว่า archive นั้นเอา code directory และ benchmark files ออก [FACT] การพบรายการเหล่านี้ไม่ได้หมายความว่าเราได้รัน planner หรือยืนยันตัวเลขใน paper; บทความนี้ไม่ได้ทำ reproduction Zenodo experiment data
ข้อจำกัดหลักคือ abstraction ที่หลวมอาจให้ heuristic ต่ำจนช่วยค้นหาน้อย ส่วน refinement ที่ละเอียดทำให้กราฟโตและใช้เวลาเพิ่ม ลำดับ split ก็มีผลต่อคุณภาพภายใต้งบที่จำกัด การรวม heuristic ต้องใช้ cost partitioning ที่มีเงื่อนไขรองรับ และ classical planning สมมติว่า action model แน่นอน จึงไม่ครอบคลุมความไม่แน่นอนของเซนเซอร์หรือผลจริงโดยอัตโนมัติ [ANALYSIS]
เอกสาร option ที่อ้างเป็น Fast Downward 26.6; รุ่นอื่นอาจเปลี่ยน option หรือขอบเขต language support ได้ ผลปี 2018 จึงไม่ใช่การรับรอง runtime ของ planner ปัจจุบัน [FACT] Fast Downward 26.6
ข้อจำกัดและแนวทางพัฒนาต่อ
การหยุดก่อนจบ loop ยังให้ abstraction heuristic ที่ใช้เป็น lower bound ได้ตามเงื่อนไขความถูกต้อง แต่ไม่ได้แปลว่ามีแผนที่ผ่านการตรวจแล้ว หากต้องสั่งระบบจริง ให้แยกผลสองชนิดนี้ใน API: heuristic_ready ใช้จัดลำดับค้นหา; plan_validated ใช้ระบุว่าได้ replay action sequence บน task model และถึง goal แล้ว [ANALYSIS]
แนวทางพัฒนาต่อที่ควรทดสอบ ได้แก่ incremental search หลังการ split, การจัดลำดับ flaw และตัวแปรเพื่อเพิ่ม heuristic value ภายใต้งบเวลาจำกัด, และการผูก validator กับ feedback จาก environment ที่ระบุ error แบบมีโครงสร้าง [HYPOTHESIS] การทดสอบควรวัดแยกจำนวน split, จำนวน abstract states/transitions, เวลาและหน่วยความจำ, ค่า heuristic, coverage ของ optimal planning และอัตรา trace ที่ผ่าน validator ห้ามสรุปว่า LLM “ฉลาดขึ้น” จาก heuristic ที่เพิ่มขึ้นเพียงอย่างเดียว เพราะยังต้องทดสอบคุณภาพแผน การเรียก tool และความถูกต้องของแบบจำลองแยกกัน
เกมปรับแบบจำลอง
เลือกโจทย์และงบการแยกตัวแปร แล้วเปิดเผยตัวแปรทีละรายการ
วิธีอ่านผลเมื่อใช้จริง
ก่อนนำ CEGAR ไปใช้ ให้ตรวจว่า task เป็น deterministic classical planning ตามสมมติฐานหรือไม่, action costs ที่ใช้ตรงกับเป้าหมายการ optimize หรือไม่, และ evaluator รุ่นนั้นรองรับ features ใน task หรือไม่ จากนั้นกำหนดงบ state, transition และเวลาสร้าง abstraction พร้อมเก็บค่า heuristic และเหตุผลหยุด ถ้าอัลกอริทึมถูกหยุดเพราะงบ ให้ใช้เป็น heuristic ตามสัญญาของ implementation แต่ห้ามแสดง trace ที่ยังไม่ผ่านการ replay ว่าเป็นแผนที่พร้อม execute [ANALYSIS]
ตรวจผลแผนโดยจำลองจากสถานะจริงที่ทราบก่อนทุกครั้ง: ตรวจ precondition, คำนวณ successor, อัปเดตสถานะ และยืนยัน goal ใน state สุดท้าย หาก environment มีการเปลี่ยนแปลงระหว่างวางแผน ให้สังเกตสถานะปัจจุบันใหม่และวางแผนอีกครั้ง การตรวจแบบ static ยืนยันได้เฉพาะความสอดคล้องกับโมเดลที่ให้มา ไม่ได้ยืนยันว่าผลในโลกจริงจะเกิดตามโมเดล [FACT]

คำถามที่พบบ่อย
แผน spurious คือ hallucination หรือไม่?
ไม่จำเป็นต้องเป็น hallucination แบบโมเดลภาษา แผน spurious เป็นเส้นทางที่ถูกต้องใน abstract transition system แต่ไม่สามารถ replay ใน concrete planning task ได้ เพราะ abstraction รวมรายละเอียดบางอย่างเข้าด้วยกัน การตรวจสอบและ refinement เป็นส่วนของอัลกอริทึม ไม่ใช่หลักฐานว่าระบบรู้ข้อเท็จจริงภายนอกโมเดลแล้ว [ANALYSIS]
ถ้า abstract graph ไม่มีทางไป goal แปลว่า task จริงก็ไม่มีแผนไหม?
สำหรับ abstraction ที่ overapproximate concrete behaviors และจัดการ initial/goal states ถูกต้อง การไม่มี abstract trace ย่อมหมายถึงไม่มี concrete trace ที่ถูกครอบอยู่ด้วย อัลกอริทึมใน paper จึงคืน unsolvable ได้เมื่อ abstract task ไม่มีเส้นทาง [FACT] JAIR 2018
CEGAR ให้แผน optimal ทันทีไหม?
ไม่เสมอไป ระหว่าง refinement มันใช้ abstract shortest-path cost เป็น heuristic lower bound หาก trace ที่มีต้นทุนต่ำสุดนั้น replay ผ่าน task จริง ก็ได้แผนที่มีต้นทุน optimal ตามเงื่อนไขของอัลกอริทึมและ cost abstraction แต่ถ้าหยุดเพราะ time หรือ memory limit อาจได้เพียง abstraction สำหรับ heuristic [FACT] JAIR 2018
Cartesian CEGAR แค่เพิ่มตัวแปรกลับเข้ามาทีละตัวหรือเปล่า?
ไม่ใช่ วิธีจริงแบ่ง Cartesian abstract state ที่เกี่ยวข้องกับ flaw โดยเลือกตัวแปรและแบ่งเซตค่าของตัวแปร เพื่อแยกกรณีที่ replay จริงไปถึงออกจากกรณีที่ทำให้ trace ผิด เดโมที่ค่อย ๆ เผย door และ key เป็น projection refinement ที่ตั้งใจทำให้ง่ายเท่านั้น [FACT] [SIMULATION]
ใช้กับ task ที่มี conditional effects หรือ axioms ได้ไหม?
ตรวจรุ่นที่ใช้เสมอ เอกสาร evaluator ของ Fast Downward 26.6 ระบุว่า Additive Cartesian CEGAR ไม่รองรับ conditional effects และ axioms แม้ evaluator อื่นใน planner จะรองรับบางกรณี [FACT] Fast Downward 26.6
การตรวจแผนรับประกันการทำงานในโลกจริงไหม?
ไม่รับประกัน มันยืนยันว่าลำดับ action ผ่านกฎและสถานะใน planning model เท่านั้น การทำงานจริงยังขึ้นกับความถูกต้องและความใหม่ของ perception, action model, เครื่องมือ และสถานะ environment [ANALYSIS]
แหล่งอ้างอิง
- Jendrik Seipp และ Malte Helmert, “Counterexample-Guided Cartesian Abstraction Refinement,” Proceedings of ICAPS 2013, pp. 347–351, short paper, เผยแพร่ 2 มิถุนายน 2013. หน้า proceedings และ PDF ICAPS 2013
- Jendrik Seipp และ Malte Helmert, “Counterexample-Guided Cartesian Abstraction Refinement for Classical Planning,” Journal of Artificial Intelligence Research 62 (2018), 535–577, เผยแพร่ 25 กรกฎาคม 2018, DOI: 10.1613/jair.1.11217. หน้าบทความ JAIR และ PDF ฉบับเต็มจากผู้เขียน/University of Basel. JAIR 2018
- Fast Downward 26.6, Evaluator documentation: Additive Cartesian CEGAR, เอกสารรุ่นที่ระบุ option, properties และข้อจำกัด language features. Fast Downward 26.6
- Seipp และ Helmert, ชุดข้อมูลผลทดลอง JAIR 2018 บน Zenodo, เผยแพร่ 4 พฤษภาคม 2018; หน้าข้อมูลอธิบายว่า archive ที่ให้ดาวน์โหลดไม่มี code directory และ benchmark files. Zenodo experiment data
- Hybrid Mind, Pattern Database: heuristic แบบ admissible สำหรับ agent วางแผน, Post 2925.
- Hybrid Mind, Landmarks: สิ่งที่ทุกแผนของ Agent ต้องผ่าน, Post 2917.
ป้ายกำกับ: FACT = ข้อเท็จจริงเชิงเทคนิคที่อ้างแหล่งหลัก; REPORTED CLAIM = ผลที่ผู้เขียนรายงาน; ANALYSIS = การอธิบายผลตามเหตุผล; HYPOTHESIS = แนวทางที่ยังต้องทดลอง; SIMULATION = ตัวอย่างจำลองขนาดเล็ก ไม่ใช่ benchmark หรือ reproduction
ใส่ความเห็น