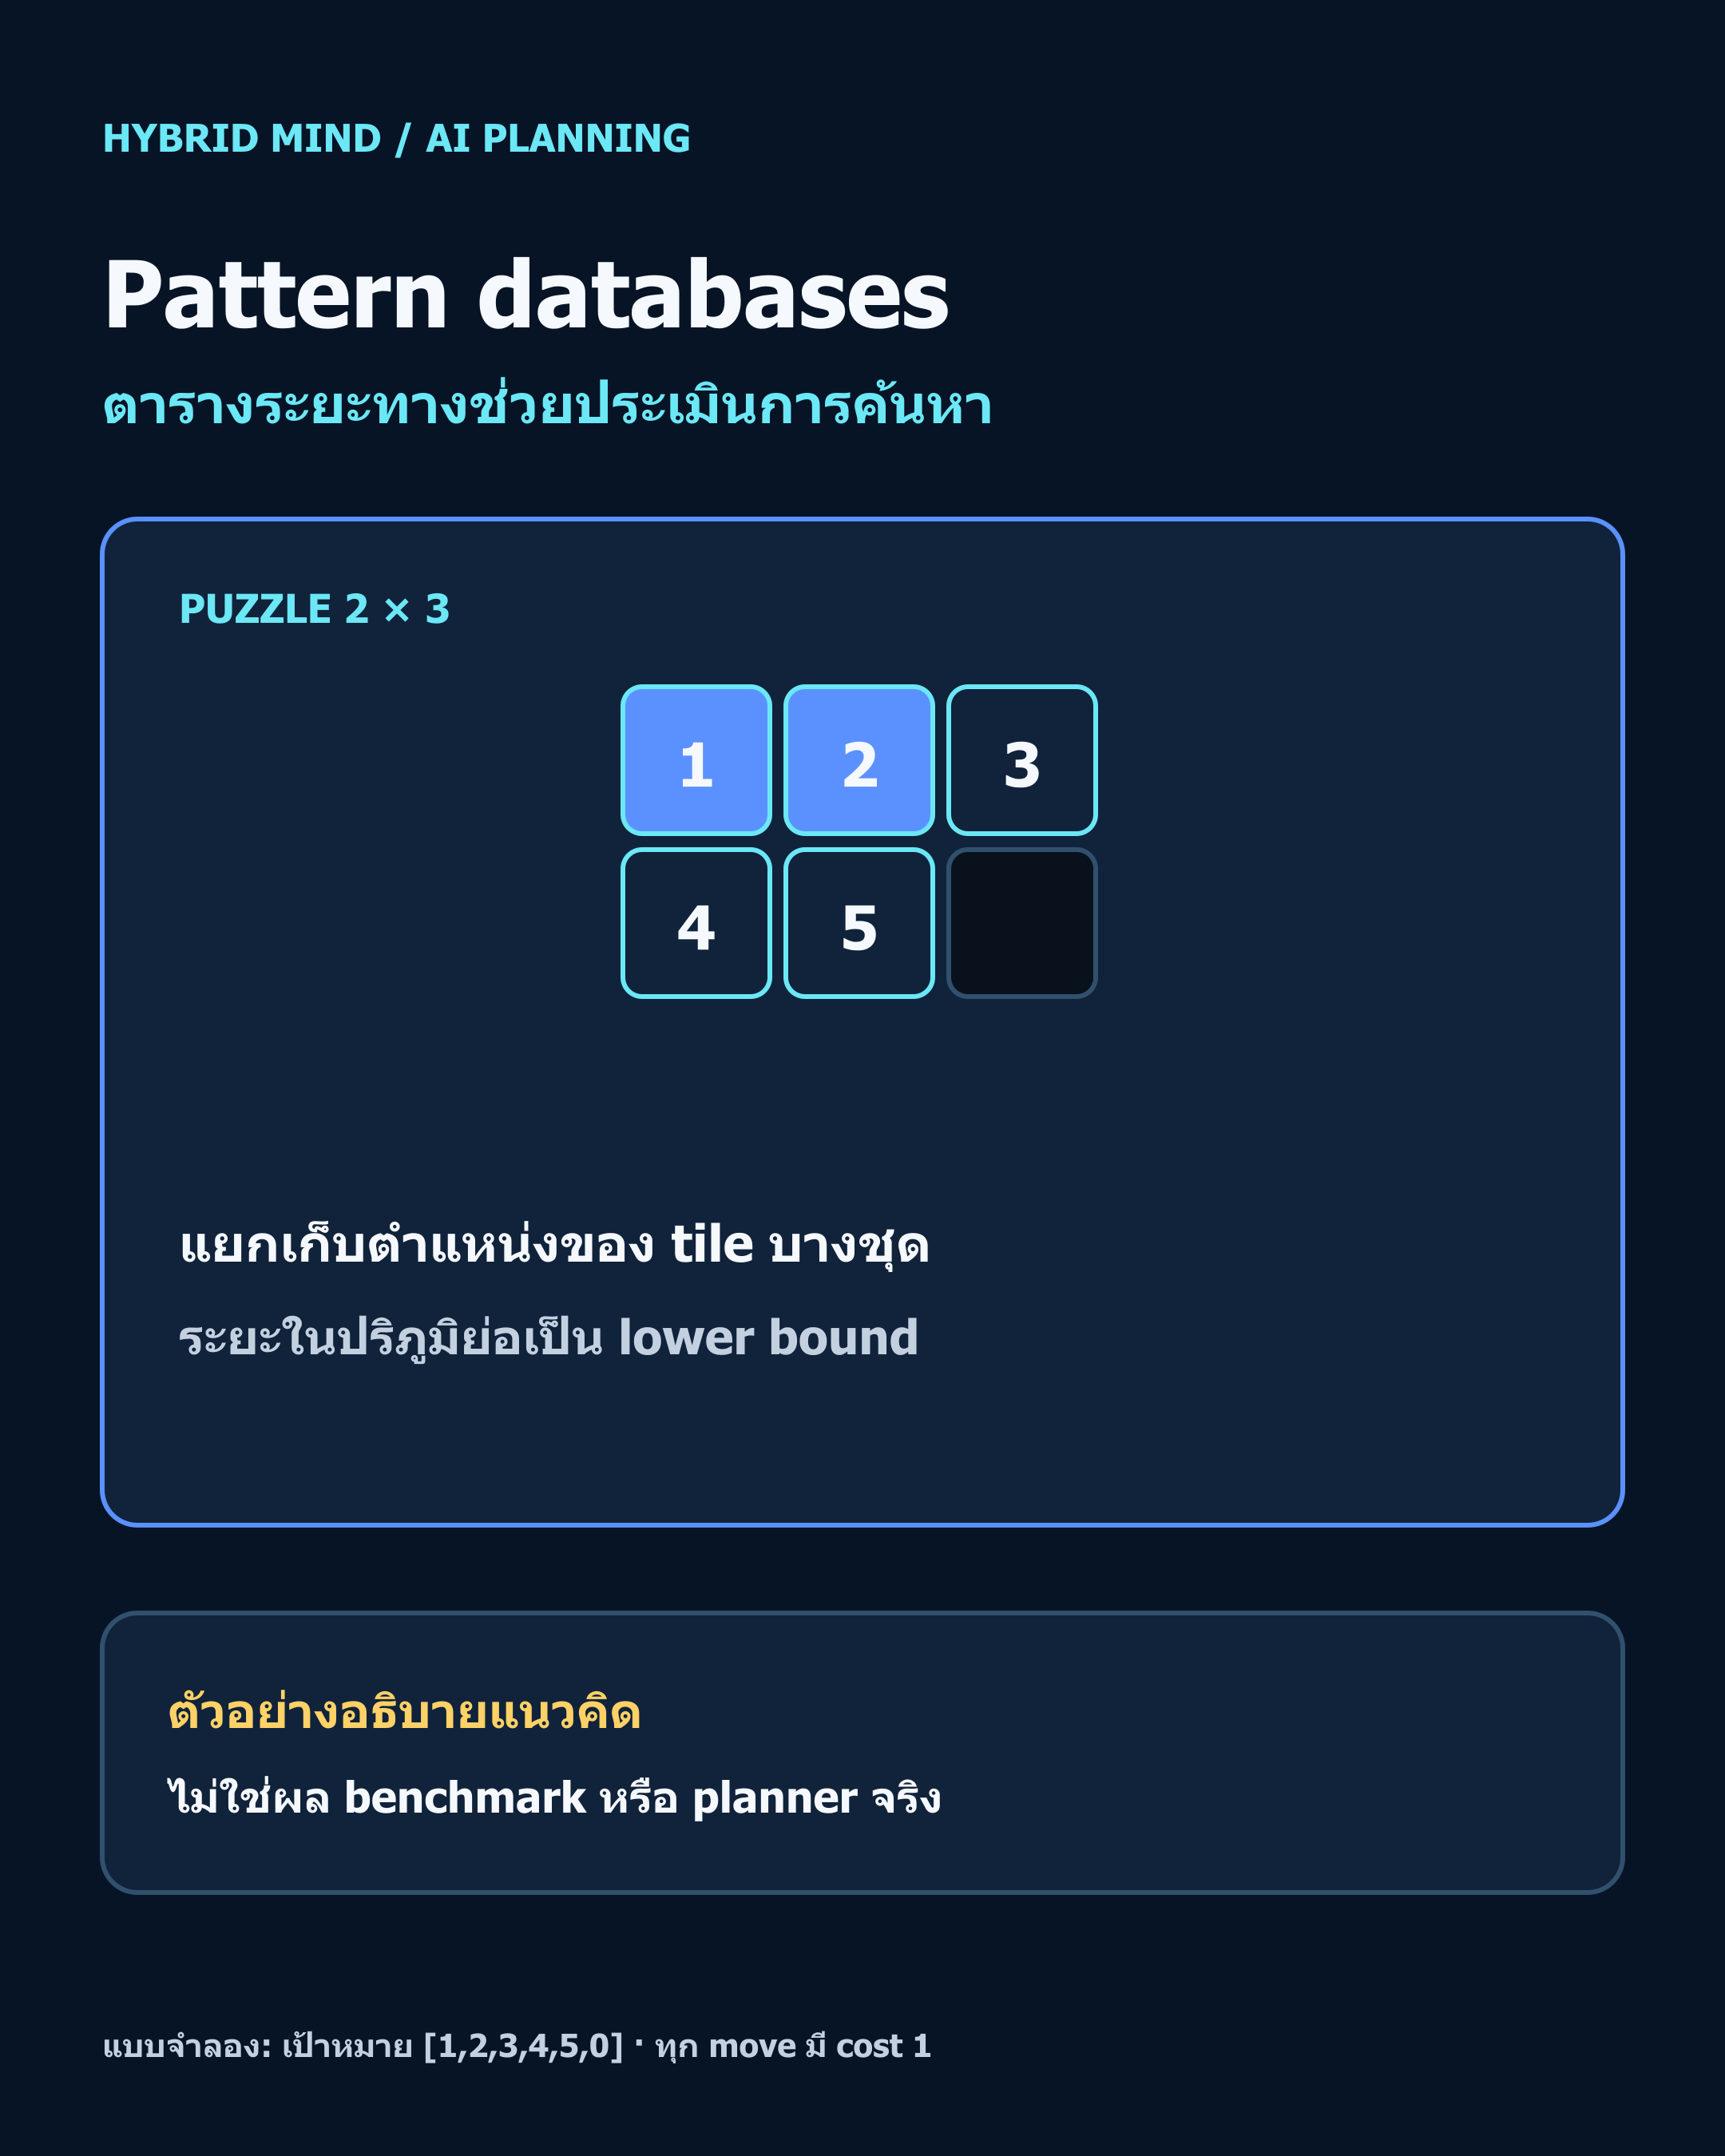

คำตอบสั้น: Pattern Database (PDB) คือ ตารางที่สร้างล่วงหน้าจาก “ปัญหาที่ลดรายละเอียดลง” แล้วเก็บต้นทุนที่แน่นอนของการแก้ปัญหาย่อยแต่ละสถานะ เมื่อนำสถานะจริงไปฉายเป็นสถานะย่อย เราอ่านค่าจากตารางเป็น heuristic เพื่อบอกค่าต่ำสุดของต้นทุนที่ยังต้องใช้ หากการฉายสถานะและการกำหนดต้นทุนทำให้ทุกแผนจริงแทนได้ด้วยเส้นทางนามธรรมที่มีต้นทุนไม่สูงกว่าเดิม ค่านั้นจะ admissible: ไม่ประเมินต้นทุนที่เหลือสูงกว่าความจริง และจึงใช้กับ A* หรือ IDA* เพื่อค้นหาคำตอบ optimal ได้ เมื่อเงื่อนไขต้นทุนถูกต้อง
PDB ไม่ใช่ตัววางแผนด้วยตัวเอง ไม่ใช่ฐานความรู้ของ LLM และไม่ได้ทำให้ทุกโจทย์เร็วขึ้นโดยอัตโนมัติ มันเป็นเครื่องมือช่วยค้นหา: ยอมใช้เวลาและหน่วยความจำเตรียมตาราง เพื่อให้แต่ละการขยายสถานะในภายหลังมีค่าประมาณที่แม่นขึ้น งานหลักของผู้ออกแบบคือกำหนดว่า “ส่วนใดของสถานะจะเก็บไว้”, “การกระทำในโลกจริงคิดต้นทุนเท่าไรในปัญหาย่อย” และ “จะรวมค่าจากหลายตารางอย่างไรโดยไม่คิดต้นทุนซ้ำ”
FACT — ที่มา: Culberson และ Schaeffer (1998) วางรากฐาน PDB สำหรับ heuristic search; Edelkamp (2001) นำ state abstraction ไปใช้กับ classical planning; Felner, Korf และ Hanan (2004) ศึกษา additive PDB และการแบ่งต้นทุน ทั้งสามเป็นงานคนละช่วงของแนวคิด Culberson & Schaeffer, Edelkamp, Felner et al.. PDB ต่างจาก landmark, LPA* และ world model ทั่วไป
Pattern database explorer
Choose a reachable board, inspect exact abstract lookups, and compare three admissible heuristic values. Click a tile next to the blank to explore a real move.
Abstract lookup
Heuristic comparison
SIMULATION: This exact database is built for the 2×3 puzzle, where all 360 reachable boards are enumerable. It illustrates disjoint pattern cost partitioning; it is not a benchmark of a production planner.
ทำไมการค้นหาต้องมีค่าประมาณที่ดีกว่า
A* จัดลำดับด้วย f(s)=g(s)+h(s): g คือค่าที่จ่ายแล้ว ส่วน h คือค่าประมาณถึงเป้าหมาย หาก h เป็น lower bound ภายใต้เงื่อนไขของ search ก็รักษา optimality ได้; lower bound ที่อ่อนยังแยกเส้นทางได้ไม่ดี
Manhattan distance บวกระยะของแต่ละแผ่นโดยละการกีดขวาง จึงเป็น lower bound ที่เร็วแต่ไม่เห็นปฏิสัมพันธ์ PDB เก็บแผ่นบางชุดร่วมกัน จึงสะท้อนการชนภายในกลุ่มได้
ANALYSIS: การเพิ่มรายละเอียดในรูปแบบมักทำให้ heuristic แน่นขึ้น เพราะแบบจำลองย่อยใกล้โจทย์จริงขึ้น แต่จำนวนสถานะที่ต้องเก็บและต้นทุนสร้างตารางก็เพิ่มเร็วด้วย การเลือก pattern จึงเป็นการแลกเปลี่ยนระหว่างเวลาสร้าง, หน่วยความจำ, เวลา lookup และจำนวนสถานะที่การค้นหาต้องขยาย
หลักการทางคณิตศาสตร์: abstraction และ lower bound
แทนโจทย์จริงด้วยกราฟ G=(S,A,c): สถานะ S, การกระทำ A และต้นทุน c(a)≥0. Pattern P เลือกตัวแปรบางส่วน แล้วฉาย s เป็น abstract state πP(s); สถานะที่ต่างเพียงรายละเอียดที่ละไว้จะถูกรวมกัน
สร้างกราฟนามธรรมและคำนวณระยะต่ำสุดสู่ abstract goal; hP(s)=dP(πP(s),goalP). ถ้าทุกเส้นทางจริงมีเส้นทางนามธรรมรองรับที่ต้นทุนไม่สูงกว่า hP จึงเป็น admissible
ข้อควรระวัง: การละตัวแปรไม่ใช่บทพิสูจน์ การฉายอาจสร้าง spurious path ที่โลกจริงทำไม่ได้; เส้นทางลวงยังให้ lower bound ได้เมื่อขอบและต้นทุนถูกกำหนดอย่างเหมาะสม แต่การตัดเส้นทางจริงหรือคิดต้นทุนเกินจริงทำลายการรับประกัน
FACT: เริ่มจาก abstract goal แล้วค้นย้อนกลับ หากทุกขอบมี cost 1 ใช้ BFS; เมื่อมี cost 0/1 ใช้ 0–1 BFS หรือ Dijkstra เพราะ BFS ปกติไม่คำนวณ weighted distance. กราฟย้อนกลับต้องตรงกับ transition จริง
สองแบบการรวม heuristic ที่ห้ามปนกัน
Full-cost PDB คิด action cost เต็มในทุก abstraction; การเคลื่อนเดียวอาจช่วยหลาย pattern จึงนับซ้ำได้ การรวมทั่วไปที่ปลอดภัยคือ max(h1,h2,…); ผลบวกอาจสูงเกินจริง
Additive PDB แบ่งต้นทุนไม่ให้ซ้ำ: ใน sliding puzzle กลุ่ม disjoint ได้ cost 1 เมื่อแผ่นในกลุ่มเคลื่อน มิฉะนั้นได้ 0. เก็บช่องว่างเพื่อสร้าง transition แต่ไม่คิดเป็นแผ่นที่มีต้นทุน
เงื่อนไข cost partitioning: ทุก action a ต้องมี cᵢ(a)≥0 และ Σᵢcᵢ(a)≤c(a). ค่าระยะ hᵢ ภายใต้ต้นทุนที่แบ่งแล้วจึงบวกเป็น lower bound ได้; disjoint patterns เพียงอย่างเดียวไม่ทำให้ full-cost PDB บวกกันได้
ANALYSIS: บางระบบมีรูปแบบและชุด additive ที่ซับซ้อนกว่า fixed partition เช่น canonical PDB ซึ่งเลือกผลบวกจาก maximal additive subsets แล้วใช้ค่าสูงสุดระหว่างชุดที่เข้ากันได้ รายละเอียดการตรวจ compatibility ขึ้นกับนิยามต้นทุนและตัวสร้าง pattern ของ planner ต้องอ่านเอกสาร/โค้ดเวอร์ชันที่ใช้ อย่าถือว่าคำว่า “หลาย PDB” รับรองการบวกโดยตัวมันเอง
สถาปัตยกรรม: จากโจทย์ถึง lookup

ระบบ PDB แยกเป็นห้าส่วนที่ตรวจสอบได้ แต่ละส่วนควรมี input และ output ชัดเจน เพื่อไม่ให้การจัดทำตารางกับการค้นหาจริงใช้ semantics คนละชุด
- Problem model: รับ initial state, goal, operators, transitions และ costs ที่กำหนดแน่ชัด; stochastic/partial observability ต้องใช้ semantics เพิ่มเติม
- Pattern generator: รับตัวแปรและงบ แล้วคืน pattern เช่น P₁={tile 1,tile 2}; เลือกด้วยมือหรือใช้ greedy/hill climbing ซึ่งไม่รับประกัน optimal pattern
- Abstract transition builder: ฉาย states, goal และ transitions ตาม pattern พร้อมต้นทุนและข้อมูลย้อนกลับ
- PDB builder: ค้นย้อนจาก abstract goal และคืนตาราง exact พร้อมค่า unreachable; ขนาดจริงขึ้นกับ state encoding
- Search + evaluator: lookup hᵢ แล้วรวมด้วย max หรือ valid partition sum ให้ A*/IDA*; ตรวจแผนกับโมเดลจริงแยกต่างหาก
บันทึก hash/version ของ task, goal, pattern, cost partition, ขนาดตาราง, เวลา/หน่วยความจำสร้าง, lookup และผลตรวจ h(s)≤h*(s) ในโดเมนเล็ก การตรวจ exhaustive ช่วยจับ bug แต่ไม่แทน proof ทั่วไป
ลำดับการทำงานจริง

- แปลงปัญหาเป็นกราฟสถานะและยืนยันว่า transition, goal, และ cost ตรงกับงานจริง
- เลือก pattern และกำหนดว่าตัวแปรใดจะถูกคงไว้ในแต่ละ abstract state
- ฉาย goal และสร้างขอบนามธรรมให้ครอบคลุมการกระทำจริงตามเงื่อนไข lower bound
- กำหนดต้นทุนขอบ: full-cost หรือ cost-partitioned; ตรวจ Σᵢcᵢ(a)≤c(a) สำหรับ additive collection
- ค้นย้อนจาก abstract goal เพื่อเติม PDB และจัดเก็บด้วย encoding ที่เหมาะสม เช่น dense array, packed integer หรือ compressed table
- เมื่อค้นหา ให้แปลงสถานะจริงเป็น key ของแต่ละ PDB แล้ว lookup ค่าระยะทาง
- รวมค่าด้วยกฎที่พิสูจน์แล้ว ส่งเข้า search แล้วตรวจ plan ที่ได้กับโจทย์จริง
SIMULATION — แบบจำลองห้องทดลอง: ใช้ปริศนา 2×3 เป้าหมาย [1,2,3,4,5,0] โดย 0 คือช่องว่าง ทุกการเลื่อนแผ่นหนึ่งช่องมีต้นทุนจริง 1 สาม pattern คือ A={1,2}, B={3,4}, C={5}; abstract state ของแต่ละ pattern เก็บตำแหน่งช่องว่างและตำแหน่งของแผ่นที่ติดตาม การเก็บช่องว่างช่วยกำหนดการเลื่อนที่เป็นไปได้ แต่ช่องว่างไม่ถูกนับเป็นแผ่นที่เสียต้นทุน
ใน full-cost version ทุก abstract move มี cost 1 จากนั้นสร้าง reverse shortest-path table จากเป้าหมาย; ค่า max(hA,hB,hC) เป็น lower bound ถ้าการสร้าง abstraction รักษาเงื่อนไขดังกล่าว แต่การบวกค่าเหล่านี้อาจคิดการเลื่อนช่องว่างหรือการเคลื่อนแผ่นอื่นซ้ำ ใน partition version กำหนด cost 1 ให้ PDB เมื่อแผ่นที่เคลื่อนอยู่ใน pattern และ 0 เมื่อแผ่นที่เคลื่อนอยู่นอก pattern ต้องใช้ 0–1 BFS หรือ Dijkstra ไม่ใช่ BFS ปกติ; เนื่องจากแต่ละแผ่นจริงอยู่ในกลุ่มเดียว ต้นทุนที่จัดสรรรวมต่อการเลื่อนจริงเท่ากับ 1 ผลบวกของ partition PDB จึง admissible ภายใต้แบบจำลองนี้
SIMULATION ที่ตรวจด้วย exact BFS/abstract shortest paths: มีสถานะจริงที่เข้าถึงได้ 360, directed transitions 840 และตาราง A/B/C มี 120/120/30 entries. สถานะห่างหนึ่ง move [1,2,3,4,0,5] ให้ full-cost [1,1,1] (max=1; sum=3 เกิน exact cost 1) และ partition [0,0,1] (sum=1). การตรวจ lower bound ครบ 360 สถานะและ cost partition ครบ 840 transitions ผ่านใน lab นี้; เป็นผลจำลองขนาดเล็ก ไม่ใช่ production benchmark หรือการทำซ้ำงานวิจัย
Sliding puzzle challenge
Move adjacent tiles into the blank. Solve the board within its exact distance plus your selected allowance. The board and distance come from the same finite pattern database model.
SIMULATION: Every legal move costs one. The objective uses the exact shortest distance, with a configurable move allowance; no random states or fabricated scores are used.
เปรียบเทียบกับแนวทางใกล้เคียง

| แนวทาง | เก็บ/คำนวณอะไร | การรับประกันและต้นทุน |
|---|---|---|
| Manhattan distance | ระยะของแต่ละแผ่น โดยละเลยการชนกัน | เร็วและใช้หน่วยความจำน้อย; เป็น lower bound ใน sliding puzzle มาตรฐาน |
| Full-cost PDB | ระยะ exact ของ abstract problem ที่เก็บปฏิสัมพันธ์ภายใน pattern | ใช้ตารางและเวลา precompute; หลาย pattern รวมด้วย max ได้ แต่ผลบวกต้องมีเงื่อนไขเพิ่ม |
| Additive PDB | PDB หลายชุดที่แบ่งต้นทุนการกระทำ | ผลบวก admissible เมื่อ cost partition ถูกต้อง; แต่ละ pattern อาจอ่อนกว่าตาราง full-cost |
| Landmark heuristic | ข้อเท็จจริง/เหตุการณ์ที่ทุกแผนต้องทำให้สำเร็จ | จับเป้าหมายที่จำเป็นและลำดับบางส่วน; เป็นตระกูล heuristic คนละอย่างกับการเก็บ exact abstract distances |
| LPA* | ปรับปรุง shortest-path search เมื่อกราฟ/ต้นทุนเปลี่ยน | เป็นอัลกอริทึมค้นหา incremental; ไม่ใช่ฐานตารางจาก abstraction แม้อาจใช้ heuristic ร่วมกันได้ |
| World model หรือ simulator | คาดการณ์ผลของการกระทำในสภาพแวดล้อม | อาจช่วยจำลองหรือวางแผน แต่จะเป็น admissible heuristic ก็ต่อเมื่อมี lower-bound proof ของ abstraction/cost ที่ใช้ |
ใช้กับงานใดได้ และขอบเขตของคำว่า agent
FACT: PDB เหมาะกับการค้นหาแบบ goal-directed ที่สถานะและการกระทำกำหนดได้, มีเป้าหมายและต้นทุนชัด, และสามารถสร้าง abstraction ที่คำนวณ shortest path ได้ งานวางแผน classical, sliding puzzles, Rubik’s Cube และ combinatorial search เป็นตัวอย่างในงานวิจัยต้นทาง งาน Edelkamp เสนอ abstraction สำหรับ deterministic planning และประเมินกับ benchmark domains ในยุคนั้น ส่วน Felner และคณะสำรวจการสร้าง additive heuristic ในหลายโดเมน รวมถึง tile puzzles, Towers of Hanoi และ minimum vertex cover
ในระบบ AI agent สมัยใหม่ PDB อาจเป็นโมดูลภายใน planner ที่รับแบบจำลองสถานะจากแอปพลิเคชัน ช่วยจัดลำดับการค้นหาหรือคำนวณ lower bound แต่ไม่ควรเรียกมันว่า “ความจำของ agent” โดยไม่อธิบายความหมาย และไม่ทำให้ agent เข้าใจโลกหรือมีเจตจำนง โมดูลนี้ตอบคำถามจำกัดว่า “จาก abstract state นี้ ต้นทุนต่ำสุดใน abstract model เป็นเท่าไร”
แยก context ที่แนบให้, retrieved data จากการค้น, external memory ที่เก็บข้ามรอบ และ weight updates ที่เปลี่ยนพารามิเตอร์ระหว่างฝึก PDB เป็นตารางจาก planning model ไม่ใช่ LLM weight update หรือความทรงจำส่วนบุคคล
LLM อาจเสนอ pattern หรือแปลง prompt แต่ PDB รับประกันเฉพาะ model ที่ป้อน หาก transition หรือ goal ผิด ผลก็ไม่ยืนยันโลกจริง จึงควรตรวจ action/cost ด้วย validator แยก
จุดพังที่พบได้บ่อย
- pattern ใหญ่เกินงบ: จำนวน abstract state โตจนสร้างหรือเก็บตารางไม่ได้ อาจใช้เวลาและหน่วยความจำมากกว่าการค้นหาที่ตั้งใจเร่ง
- pattern เล็กเกินไป: ตารางสร้างง่ายแต่เก็บปฏิสัมพันธ์น้อย ค่า h จึงอ่อนและยังขยายสถานะจำนวนมาก
- รวมต้นทุนผิด: บวก full-cost PDB หลายตัว แม้ pattern จะไม่ทับกัน ก็อาจนับการกระทำเดียวซ้ำจน h สูงกว่าคำตอบจริง
- ใช้ BFS กับต้นทุนศูนย์/หนึ่ง: BFS ให้ระยะตามจำนวนขอบ ไม่ใช่ต้นทุนต่ำสุดเมื่อขอบมีน้ำหนักต่างกัน ต้องใช้ 0–1 BFS หรือ shortest-path ที่เหมาะสม
- transition นามธรรมไม่ครอบคลุม: การละตัวแปรแล้วสร้างกฎขอบไม่ตรงกับการฉาย transition จริง อาจพลาดเส้นทางหรือให้ค่าต่ำ/สูงผิดเงื่อนไข
- นิยาม cost เปลี่ยนแต่ใช้ตารางเดิม: เปลี่ยน goal, action cost, operator หรือ encoding แล้ว lookup ตารางเก่าทำให้คำตอบดูน่าเชื่อแต่ไม่มีหลักประกันเดิม
- ค่าไม่มีทางถึงถูกตีความผิด: unreachable abstract state อาจแทนค่า infinity; การใช้ sentinel, overflow หรือการบวกกับ infinity ต้องออกแบบและตรวจสอบ
- cache ทำให้ปนเวอร์ชัน: cache key ควรรวม hash ของ task, pattern, goal และ cost partition; ใช้ชื่อ pattern อย่างเดียวไม่พอ
- คาดว่า admissible เท่ากับเร็วเสมอ: admissibility รักษาขอบเขตคุณภาพคำตอบในอัลกอริทึมที่เหมาะสม ไม่ได้ประกันเวลา, memory, completeness ภายใต้ resource limit หรือประสิทธิภาพเหนือ heuristic อื่น
- อ้าง benchmark เกินหลักฐาน: ผลจาก paper หรือเวอร์ชันหนึ่งเป็น reported claim ตามเงื่อนไขของผู้เขียน ไม่ใช่ผลทดสอบซ้ำบนเครื่องหรือโจทย์ของเรา
งานวิจัยและทิศทางต่อไป
FACT: งานต่อยอดครอบคลุมการเลือก pattern, cost partitioning, canonical collections และการจัดเก็บ Fast Downward มี PDB/canonical PDB และ iPDB ที่ใช้ hill climbing; evaluator ใน docs ระบุ action costs รองรับ แต่ conditional effects และ axioms ไม่รองรับ ตรวจเวอร์ชันก่อนใช้ Fast Downward 26.6
HYPOTHESIS: ระบบวางแผนเชิงปฏิบัติการอาจได้ประโยชน์จากการสร้าง pattern ตามงบหน่วยความจำ, การติดตามเวลาสร้างและ lookup แยกกัน, และการให้ตัวตรวจอิสระตรวจผลรวม cost partition ทุก operator อย่างเป็นระบบ เป็นสมมติฐานทางวิศวกรรม ไม่ใช่ผลทดลองจากบทความนี้
การเชื่อมกับ learned models อาจใช้ข้อมูลจากการค้นหาเดิมเพื่อเสนอ pattern ที่คาดว่าจะมีประโยชน์ แต่การเรียนรู้คะแนน pattern ไม่ได้ทำให้ heuristic admissible เอง ต้องคงขั้นตอนตรวจ lower bound และ cost partition ที่พิสูจน์ได้ หากยอมแลก optimality เพื่อให้ค้นหาเร็วขึ้น ควรระบุว่าใช้ weighted A*, greedy search หรือวิธีอื่น และรายงานการรับประกันที่เปลี่ยนไปอย่างตรงไปตรงมา
วิธีเริ่มทดลองโดยไม่สับสนกับผลจริง
- เลือกโจทย์ขนาดเล็กที่ transition และต้นทุนตรวจได้ด้วยมือ เช่น sliding puzzle 2×3
- สร้าง baseline exact ด้วย BFS เมื่อทุก action cost 1 แล้วตรวจสถานะ/ระยะทางที่เข้าถึงได้
- นิยาม abstraction และ enumerate ทุก transition; ตรวจว่าแต่ละ transition จริงมี abstract transition ที่รองรับ
- สร้าง full-cost PDB และ partition PDB แยกกัน แล้วเปรียบเทียบ lookup กับ exact distance ทุกสถานะเพื่อยืนยัน lower bound ในโดเมนเล็ก
- ใช้กฎรวมที่ถูกต้อง: max สำหรับ full-cost PDB; sum สำหรับ PDB ที่แบ่งต้นทุนโดยผ่านเงื่อนไขทุก action
- วัดเวลา precompute, RAM, ขนาดไฟล์, เวลา lookup, จำนวน expanded states และคุณภาพแผน โดยใช้ seed, โจทย์และ hardware เดียวกัน
- บันทึก hash ของ model และตาราง; ผลวัดใช้ได้เฉพาะสภาพแวดล้อมที่ระบุ
เมื่อใช้ Fast Downward ให้ตรวจ docs ตาม release; ข้ออ้างในบทความนี้อิงกับเอกสาร 26.6
[PSEUDOCODE: conceptual only]
for each pattern P:
    table[P] = reverse_shortest_paths(project(goal, P), projected_transitions(P))
for each concrete state s:
    values = [table[P][project(s, P)] for P]
    return max(values)  # full-cost tables
# Use sum(values) only for a verified cost partition.
Practical takeaways

ก่อนใช้ PDB ตรวจ abstraction/transition และยืนยันว่าต้นทุน pattern รวมไม่เกินต้นทุน action: ใช้ max กับ full-cost PDB หรือบวกเฉพาะ cost partition ที่ตรวจแล้ว บันทึกเวอร์ชัน model/table และตรวจแผนกับโจทย์จริง
คำถามที่พบบ่อย
PDB ให้คำตอบ optimal เองหรือไม่?
ไม่ ตารางให้ heuristic เท่านั้น การได้คำตอบ optimal ขึ้นกับ search algorithm, admissibility ของ heuristic, เงื่อนไขการหยุด และการจัดการต้นทุน/สถานะอย่างถูกต้อง
ทำไมต้องสร้างตารางย้อนจาก goal?
เพราะค่าที่เก็บคือระยะทางต่ำสุดจาก abstract state ไปยัง abstract goal การค้นจาก goal ในกราฟย้อนกลับเติมค่าให้ทุกสถานะโดยไม่ต้องแก้โจทย์ย่อยซ้ำในแต่ละ lookup
ทำไม full-cost PDB บวกกันไม่ได้ แม้ pattern แยกจากกัน?
เพราะการกระทำหนึ่งอาจช่วยให้หลาย pattern ไปสู่เป้าหมาย เช่น เลื่อนช่องว่างโดยขยับแผ่นนอกกลุ่ม แต่ใน abstract model ของแต่ละกลุ่มอาจนับการกระทำนั้นเต็มต้นทุน จึงเกิดการนับซ้ำ
การเก็บช่องว่างเป็นการคิดต้นทุนเพิ่มหรือไม่?
ไม่จำเป็น ช่องว่างเป็นส่วนหนึ่งของ abstract state เพื่อระบุ transition ที่เป็นไปได้ ส่วนต้นทุนถูกกำหนดแยก ถ้าเป็น partition heuristic ของ tile puzzle ให้คิดต้นทุนเมื่อแผ่นใน pattern เคลื่อนเท่านั้น
PDB ต่างจาก landmark อย่างไร?
Landmark คือเงื่อนไขที่ทุกแผนต้องทำให้เกิด ส่วน PDB เก็บระยะของ abstract state จากกราฟนามธรรม ทั้งคู่ใช้เป็น heuristic ได้แต่สร้างต่างกัน; อ่านต่อที่ Landmarks และ LPA* ซึ่งเป็นวิธีค้นหา incremental
ใช้กับโจทย์ที่ไม่ deterministic ได้ไหม?
หลักการยังประยุกต์ได้ แต่การคำนวณค่า, semantics ของการกระทำและการรับประกันต้องปรับตาม stochastic หรือ nondeterministic planning เอกสารที่อ้างในบทความนี้ว่าด้วย classical/deterministic setting จึงไม่พอรองรับการกล่าวอ้างทั่วไป
ตาราง PDB เป็นความจำหรือการเรียนรู้ของ LLM หรือไม่?
เป็นตารางระยะทางที่สร้างจาก planning model แล้วอ่านระหว่างค้นหา ไม่ใช่การเปลี่ยน model weights และไม่ใช่หลักฐานของ sentience หรือความทรงจำส่วนบุคคล
ตัวเลขในตัวอย่าง 2×3 เป็นผล benchmark หรือไม่?
เป็นผลคำนวณจาก SIMULATION ขนาดเล็กที่ตรวจด้วย BFS และ abstract shortest paths ตามที่ระบุไว้ ไม่ใช่ benchmark ของ production planner หรือการทำซ้ำงานวิจัย; ไม่มีการรัน LLM
References และสถานะหลักฐาน
- Joseph C. Culberson and Jonathan Schaeffer, “Pattern Databases,” Computational Intelligence 14(3), 318–334, 1998. DOI: https://doi.org/10.1111/0824-7935.00065. Full text copy hosted by University of Alberta: https://webdocs.cs.ualberta.ca/~jonathan/publications/ai_publications/Compi_.pdf. Original research; full paper accessed.
- Stefan Edelkamp, “Planning with Pattern Databases,” Proceedings of the Sixth European Conference on Planning (ECP 2001), pp. 84–90, 2001. Full paper: https://ai.dmi.unibas.ch/_files/teaching/hs19/po/misc/edelkamp-ecp2001.pdf. Original research; full paper accessed.
- Ariel Felner, Richard E. Korf, and Sarit Hanan, “Additive Pattern Database Heuristics,” Journal of Artificial Intelligence Research 22, 279–318, 2004. DOI: https://doi.org/10.1613/jair.1480. Author-hosted full paper: https://www.ise.bgu.ac.il/faculty/felner/research/jairpdb.pdf. Supplemental arXiv v1 full text: https://arxiv.org/pdf/1107.0050, submitted 30 June 2011 (later upload; journal publication was 2004). Original research; full paper accessed.
- Fast Downward 26.6, “Evaluator” documentation, accessed 20 October 2026: https://www.fast-downward.org/26.6/documentation/search/Evaluator/. Official versioned docs for PDB-family options, evaluator properties and language support.
หลักฐานในบทความแยกเป็น FACT (นิยาม/คุณสมบัติที่แหล่งหลักรองรับ), REPORTED CLAIM (ผลทดลองที่ผู้เขียนรายงานภายใต้เงื่อนไขของตน), ANALYSIS (ข้อสรุปเชิงเหตุผลจากนิยาม), HYPOTHESIS (แนวทางที่ยังต้องทดสอบ) และ SIMULATION (แบบจำลองสาธิตซึ่งไม่ใช่ผล benchmark) บทความนี้ไม่ได้ทำซ้ำ benchmark ในเอกสารต้นทางและไม่ได้รัน planner ในการจัดทำ
ใส่ความเห็น