
คำตอบสั้นสำหรับคนสร้าง Agent
FACT. ใน robust Markov decision process (robust MDP) คำว่า rectangular uncertainty บอกว่าเซตของ transition matrix ที่ระบบยอมรับถูกแยกเป็นผลคูณของเซตความน่าจะเป็นรายแถว แต่ละแถวแทนการกระจายของสถานะถัดไป เมื่ออยู่ใน state หนึ่งและเลือก action หนึ่ง ผู้วางแผนจึงหาค่าต่อเนื่องภายใต้แถวที่เลวร้ายที่สุดของคู่นั้นได้ แล้วทำ Bellman backup ไปทีละ state ได้
ข้อแลกเปลี่ยนอยู่ที่แบบจำลอง: หากความไม่แน่นอนจริงผูกหลายแถวเข้าด้วยกันด้วยพารามิเตอร์ร่วม การใช้ผลคูณรายแถวอาจเปิดทางให้ธรรมชาติทางคณิตศาสตร์ผสมแถวที่ไม่สามารถเกิดร่วมกันในแบบจำลองเดิมได้ การเพิ่มตัวเลือกนี้อาจเพิ่มต้นทุนคาดหมายกรณีเลวร้าย และเปลี่ยนนโยบายที่ถูกเลือก
ANALYSIS. “อาจ” เป็นคำสำคัญ การเปรียบเทียบมีทิศทางแน่นอนสำหรับนโยบายที่ตรึงไว้ เมื่อเซตผลคูณครอบคลุมเซต coupled เดิม: ค่าสูงสุดเหนือเซตใหญ่ย่อมไม่น้อยกว่า แต่ค่าที่ดีที่สุดหลัง optimizer เลือกนโยบายใหม่ต้องคำนวณในคลาสนโยบายเดียวกันก่อน จึงจะเปรียบเทียบได้ และตัวอย่างในบทความนี้ไม่พิสูจน์ว่าทุกปัญหาจะมีช่องว่างหรือเปลี่ยนนโยบาย
ปัญหาที่การวางแผน robust พยายามตอบ
FACT. MDP มีสถานะ การกระทำ และกฎเปลี่ยนสถานะ เมื่อเลือก action ที่ state ปัจจุบัน ระบบสุ่มย้ายไปยัง state ถัดไปตาม transition distribution หากทราบกฎนี้แน่นอนและกำหนดต้นทุนไว้ ผู้วางแผนสามารถหานโยบายที่ลดต้นทุนคาดหมายสะสมได้ แต่ในงานจริงบางครั้งเราทราบเพียงช่วงหรือเซตของกฎที่สมเหตุผล ไม่ใช่เมทริกซ์เดียว
Robust MDP ระบุความไม่แน่นอนนั้นเป็น ambiguity set ของ transition kernels แล้วพิจารณาเกณฑ์แบบ min–max: ผู้ควบคุมเลือกนโยบายเพื่อลดต้นทุน ส่วน “nature” เลือกการเปลี่ยนสถานะที่ทำให้ต้นทุนคาดหมายสูงสุดภายใต้เซตที่ประกาศไว้ ดังนั้นสิ่งที่ถูก optimize คือ ต้นทุนคาดหมายสะสมกรณีเลวร้ายในแบบจำลอง ไม่ใช่ผลเสียสูงสุดจากเหตุการณ์เดี่ยว และไม่ใช่การคุมโอกาสเกิดเหตุให้อยู่ใต้ threshold
การเรียกฝ่ายตรงข้ามว่า nature เป็นภาษาคณิตศาสตร์สำหรับตัวเพิ่มต้นทุน ไม่ได้หมายถึงโลกมีเจตนา หรือมี Agent อีกตัวคอยคิดตอบโต้เรา การกระทำของมันถูกจำกัดด้วย ambiguity set ที่เราเลือก หากเซตนั้นไม่ครอบคลุมโลกจริง คำรับประกันภายในเซตก็ไม่ได้แก้ปัญหา coverage ให้เอง
รากฐาน: “แยกตามแถว” หมายถึงอะไร
FACT — นิยามในงานต้นฉบับ. ให้ P^a เป็นเซต transition matrices ที่ยอมรับสำหรับ action a และให้ P_i^a เป็นเซตแถวความน่าจะเป็นที่เป็นไปได้เมื่อเริ่มจาก state i และใช้ action a เงื่อนไข rectangular คือ (Nilim และ El Ghaoui, §2.2, หน้า 782–783)
P^a = P_1^a × P_2^a × ... × P_n^a
ผลคูณนี้หมายความว่าเราสร้างเมทริกซ์ที่ยอมรับได้โดยเลือกแต่ละแถวจากเซตของแถวนั้นได้อย่างอิสระต่อกัน ภายใต้นิยามนี้ งานของ Nilim และ El Ghaoui ระบุว่าไม่ใส่ correlation ระหว่างแถวต่าง ๆ และระหว่าง action ต่าง ๆ ลงใน ambiguity set ที่กำหนดไว้ (หัวข้อ 2.2, หน้า 782–783 ของวารสาร) นี่คือข้อสมมติด้านโครงสร้างของ เซตแบบจำลอง ไม่ใช่หลักฐานว่า error ที่วัดได้จริงในแต่ละแถวเป็นอิสระทางสถิติ
ผลคูณรายแถวมีประโยชน์เพราะ continuation value ที่ state ปลายทางกำหนดไว้แล้ว เราหาค่า expected continuation cost ของแต่ละแถวแยกกันได้ ใน finite horizon ที่กำหนดในทฤษฎีบทที่ 1 ของบทความ ค่า robust Bellman backup เขียนได้เป็น
v_t(i) = min_a { c_t(i,a) + sup_{p ∈ P_i^a} pᵀ v_{t+1} }
c_t(i,a) คือต้นทุนทันที, p คือแถวความน่าจะเป็นที่ยอมรับได้จาก state i เมื่อทำ action a, และ v_{t+1} คือต้นทุนต่อเนื่องในเวลาถัดไป เครื่องหมาย sup เลือกแถวที่เพิ่ม expected continuation cost ให้มากที่สุด จากนั้น min เลือก action ที่ทำให้ต้นทุนรวมกรณีเลวร้ายต่ำที่สุด
FACT — ขอบเขตของทฤษฎีบท. แบบจำลอง finite-horizon ในงานนี้ใช้เซตสถานะและ action จำกัด ต้นทุน stage และ terminal ที่ไม่ติดลบและมีค่าจำกัด และนโยบายควบคุมแบบ deterministic ที่ขึ้นกับ state และเวลา ผู้เขียนให้ผล perfect duality และ recursion สำหรับกรณีที่ nature เปลี่ยน transition matrix ตามเวลาได้ภายในขอบเขตที่กำหนด (Theorem 1 และ recursion (7), หน้า 783) นี่เป็นเหตุผลที่สมการสำรองค่ารายแถวใช้ได้ในกรอบนั้น ไม่ใช่ใบอนุญาตให้นำสมการไปใช้กับทุก ambiguity set โดยไม่ตรวจข้อสมมติ
ต้องแยกคำสองคู่ที่ฟังคล้ายกันออกจากกัน คู่แรกคือ rectangular กับ coupled ซึ่งพูดถึงว่าแถวต่าง ๆ ในเมทริกซ์เลือกสัมพันธ์กันอย่างไร คู่ที่สองคือ stationary กับ time-varying nature ซึ่งพูดถึงว่ากฎหรือการเลือกของ nature คงเดิมตลอดเวลาหรือเปลี่ยนได้ตามเวลา ในบทความต้นฉบับมีการอภิปรายทั้งสองกรอบแยกกัน และมีผล discounted infinite-horizon สำหรับนโยบาย stationary ในหัวข้อ 4 ด้วย การบอกว่า nature stationary ไม่ได้แปลว่าแถวถูกผูกกัน และการบอกว่าแถว rectangular ก็ไม่ได้บอกว่า nature ต้องคงเมทริกซ์เดิมข้ามเวลา
ตัวอย่างคำนวณ
ส่วนนี้เป็น เครื่องคำนวณตัวอย่างแบบ exact ไม่ได้สุ่ม Monte Carlo แม้ป้ายแสดงผลใช้คำว่า simulation ทุกค่ามาจากการไล่ครบทุก kernel และนโยบายที่ระบุ ไม่มีการประมาณจากตัวอย่างสุ่ม
ตั้งต้นที่ root ซึ่งสุ่มไปยัง branch X ด้วยโอกาส q% และ Y ด้วยโอกาส 100−q% ค่านี้ทราบแน่นอน ทั้ง X และ Y ถูกสังเกตเห็นก่อนเลือก action ของ branch นั้น จากนั้น episode จบที่ terminal outcome โดยไม่มีการเรียนรู้ค่าพารามิเตอร์แฝงจาก branch
ที่แต่ละ branch มีทางเลือก R (Risky) และ S (Shield) หากเลือก R จะมี stage cost 0 และ terminal loss 100 ด้วยโอกาส p%; ถ้าไม่เกิดเหตุ terminal loss เป็น 0 หากเลือก S จะเสียต้นทุนทันที K และจบด้วย terminal cost 0 เราจำกัดคลาสนโยบายไว้ที่ deterministic state-feedback สี่แบบ: RR, RS, SR, SS อักษรตัวแรกคือ action ที่ X ตัวที่สองคือ action ที่ Y ไม่มีการสุ่มเลือกนโยบาย
ในแบบ nominal กำหนด point model ที่ pX=pY=(lo+hi)/2 โดยประกาศเป็นค่ากลางที่เลือกเพื่อสาธิต ไม่ได้อนุมานว่าเป็น posterior mean หรือ prior แบบ uniform ในแบบ globally coupled มี kernel ทั้งระบบให้ nature เลือกก่อนรู้ว่า root จะพาไป X หรือ Y: A=(hi,lo) หรือ B=(lo,hi) ตัวแปรร่วม θ ซ่อนจาก controller และการเห็น branch ไม่ให้ข้อมูลเกี่ยวกับ θ
ในแบบ rectangular เราแทน kernel สองตัวนั้นด้วยผลคูณ {lo,hi} × {lo,hi} จึงเพิ่ม kernel (hi,hi) และ (lo,lo) ที่ coupled set ไม่มี เมื่อ lo=hi ทั้งสามชุดยุบเป็น kernel เดียว
ต้นทุนคาดหมายของ branch ที่เลือก R คือ p หน่วย เพราะความเสียหาย 100 เกิดด้วยโอกาส p/100; ต้นทุนของ S คือ K หน่วย ต้นทุนรวมของนโยบายจึงคำนวณจากค่าเฉลี่ยถ่วงน้ำหนักด้วย q และ 100−q ไม่มีการสุ่มผลลัพธ์ระหว่าง episode
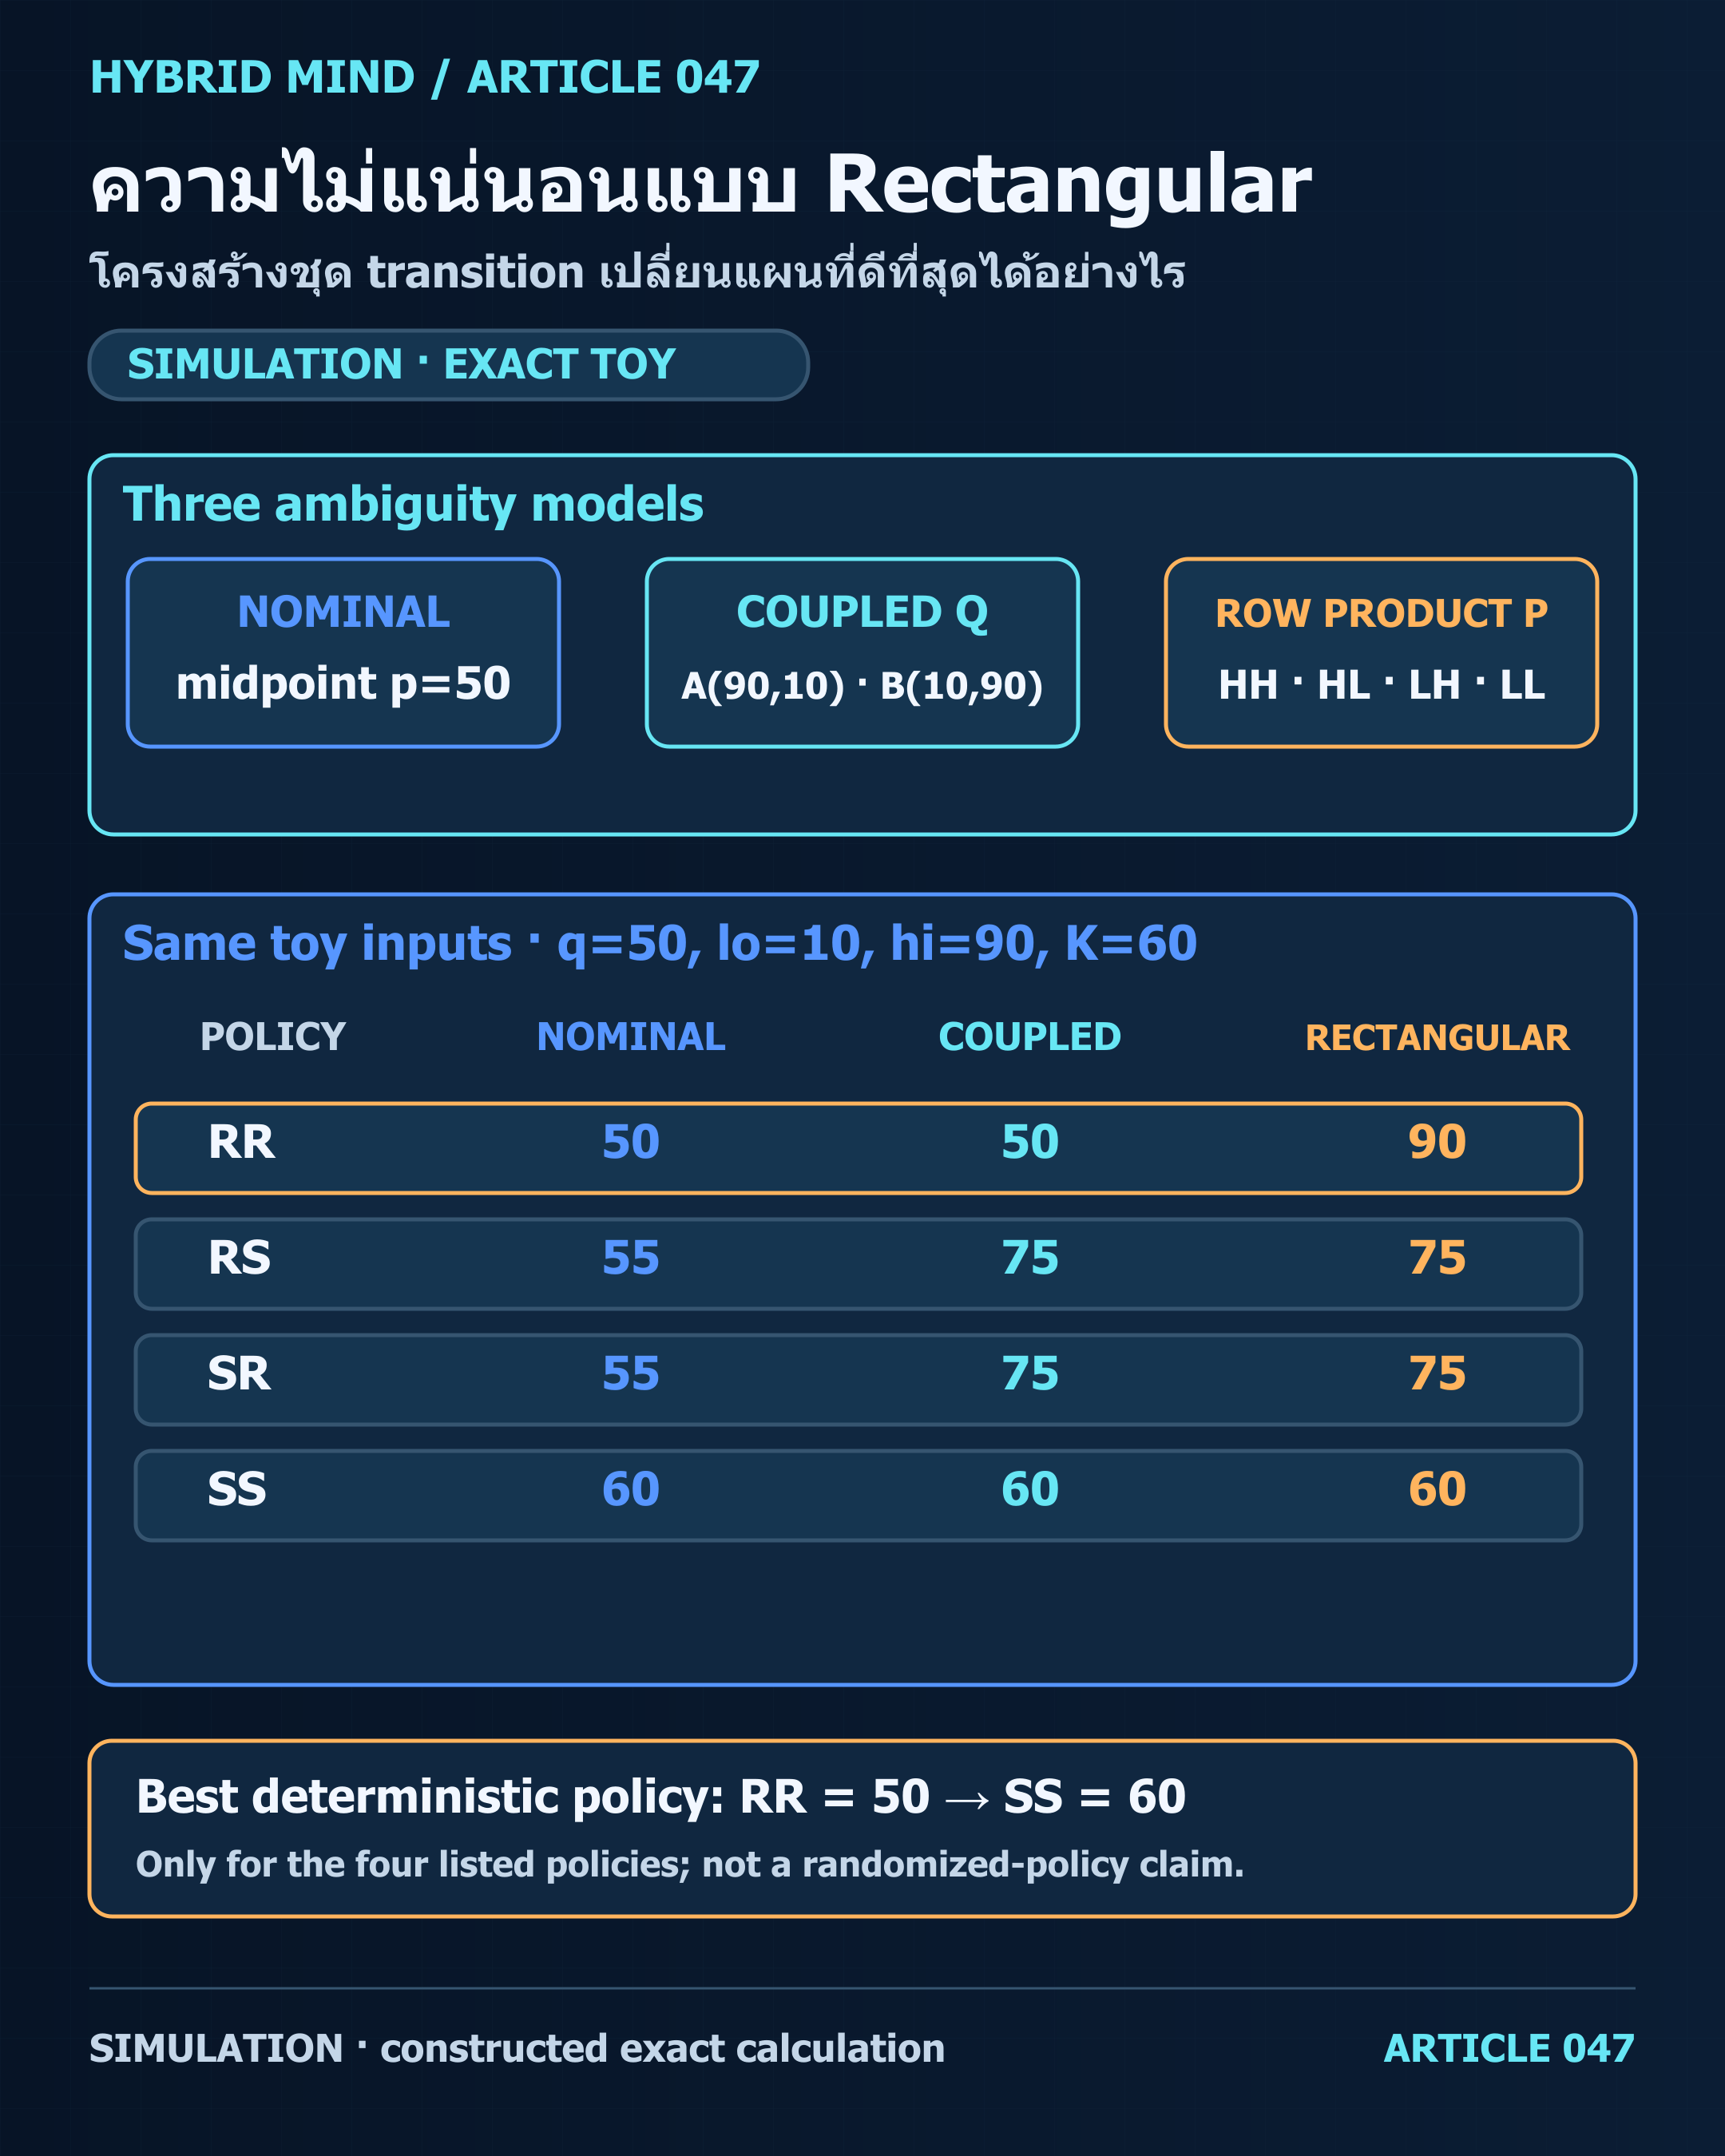
เมื่อใช้ค่าเริ่มต้น q=50, lo=10, hi=90, K=60, ตารางค่าต้นทุนคาดหมายกรณีเลวร้ายมีดังนี้
| นโยบาย | Nominal midpoint | Coupled global kernel | Rectangular row product |
|---|---|---|---|
| RR | 50 | 50 | 90 |
| RS | 55 | 75 | 75 |
| SR | 55 | 75 | 75 |
| SS | 60 | 60 | 60 |
ภายใต้ deterministic policy class นี้ nominal และ coupled เลือก RR ด้วยค่า 50 ส่วน rectangular เลือก SS ด้วยค่า 60 ตัวอย่างเผยให้เห็นว่าการเพิ่มคู่ row (hi,hi) ทำให้ค่าแย่สุดของ RR เพิ่มขึ้น เพราะไม่ว่า episode จะไป X หรือ Y แถวของ branch ที่เยี่ยมชมสามารถใช้ hi ได้ แต่ตัวอย่างนี้ไม่ใช่ benchmark และไม่ได้หมายความว่า rectangular ต้องเลือก S เสมอ
เรายังเห็นค่า rowwise Bellman backup ได้ตรง ๆ ที่ X และ Y: สำหรับแต่ละแถวที่ไม่ทราบ p ระหว่าง lo กับ hi, controller เลือกต้นทุนต่ำกว่าระหว่าง K กับ hi ดังนั้นค่าที่ทั้งสอง branch คือ min(K,hi) และที่ root ซึ่งมี branch probability รวมเป็น 100% ค่าคือ min(K,hi) เช่นค่าเริ่มต้นได้ 60 สังเกตว่าการสำรองค่าที่ root นี้ประเมินการเลือก action แยกตาม state ที่สังเกตได้ จึงให้ SS ขณะที่การประเมินนโยบายคงที่ RR ภายใต้ coupled kernel ได้ 50 นี่เป็นตัวอย่างเชิงสอนให้เห็นความต่างระหว่าง optimization ภายใต้ชุดโมเดลต่างกัน ไม่ใช่การอ้างว่านโยบายสุ่มหรือ class อื่นถูกประเมินแล้ว
ANALYSIS. เพราะ Q ⊆ P ค่า worst cost ของทุกนโยบายเดียวกันใน P จึงไม่น้อยกว่าใน Q เมื่อ minimize ทั้งสองฝั่งเหนือคลาส deterministic สี่นโยบายเดียวกัน อสมการยังคงอยู่: min_π sup_{p∈P} C(π,p) ≥ min_π sup_{q∈Q} C(π,q) โดย P คือ row product และ Q คือ coupled set นี่เป็นผลจาก set inclusion ไม่ใช่ผลทดลอง ส่วน midpoint เป็นค่าเฉลี่ยของ A และ B; เพราะ expected cost ใน toy นี้ affine ใน kernel ต้นทุน nominal ของแต่ละนโยบายไม่เกิน coupled worst cost ด้วย ค่าที่ดีที่สุดจึงเป็น 50, 50 และ 60 สำหรับ nominal, coupled และ rectangular ตามลำดับ ช่องว่างไม่ใช่ค่าคงที่สากล และอสมการนี้จำกัดอยู่ในคลาส deterministic ที่ระบุ
หากอนุญาต randomized policies ผลดีที่สุดใน coupled set อาจเปลี่ยนสำหรับบาง input จึงไม่ควรขยายข้อสรุปนี้ไปยังคลาสอื่นโดยไม่พิสูจน์ใหม่
ตัวเลือกของ lab ให้ปรับ q, lo, hi และ K เป็นจำนวนเต็มตั้งแต่ 0 ถึง 100 โดยต้องมี lo≤hi และตรึง loss L=100 ตารางควรแสดงค่าทั้งสี่นโยบาย ผู้ชนะที่เสมอกันทั้งหมด เซต kernel ของแต่ละโมเดล และผล Bellman backup การเปลี่ยน q เปลี่ยนโอกาสไป branch แต่ไม่เปลี่ยน row marginals ส่วนการเปลี่ยน lo/hi เปลี่ยนเซตแถว ตัวอย่าง midpoint เป็นเพียงโมเดลจุดที่ประกาศไว้ ความครอบคลุมของ ambiguity set ต่อโลกจริงยังเป็น UNKNOWN
สำรวจกรณีเลวร้าย (SIMULATION)
เครื่องคำนวณตัวอย่างแบบจำกัด: ผลลัพธ์คำนวณตรงทุกกรณี ไม่มีการสุ่มทดลอง / Exact finite toy calculator; no sampled trials. ตั้งนโยบายเมื่อเห็น X และ Y; R = เสี่ยง (ค่าเสียหายคาดหมาย p), S = ป้องกัน (ต้นทุน K).
ค่ากรณี / Inputs
Two row sets / Ambiguity sets
Nature chooses a complete kernel before the X/Y branch. Coupled set: A=(hi,lo), B=(lo,hi). Rectangular product additionally admits (lo,lo) and (hi,hi); duplicates collapse if lo=hi.
Four deterministic policies / Exact objectives
Expected costs use an exact common denominator of 20,000. All tied best policies are shown.
| Policy | Nominal | Coupled worst case | Rectangular worst case |
|---|
The model selector filters this optimum summary; the comparison table always shows all three models. Nominal is the declared midpoint kernel (lo+hi)/2, not a Bayesian posterior or learned prior. Global robust optimum is restricted to these four deterministic policies; randomized policies are outside scope.
Selected policy / Backup explanation
At each branch, Bellman backup is min(K, hi). Each uncertain row is visited once in this tree; this does not compare stationary and time-varying nature.
ปรับ q, lo, hi และ K เพื่อดูสี่นโยบายใน nominal, coupled และ rectangular พร้อม kernels ที่อนุญาตและนโยบายที่เสมอกัน ค่าต้องคำนวณแบบ exact ไม่ตัดสินผู้ชนะจากทศนิยมที่ปัดแล้ว
สถาปัตยกรรมเชิงแนวคิดสำหรับ Agent

ANALYSIS / Conceptual Architecture / HYPOTHESIS — adapter สำหรับ Agent ไม่ใช่สิ่งที่ paper implement. Input อาจเป็น state_id, row_sets หรือ kernel_set, stage_cost, terminal_cost และ model/version provenance พร้อมสมมติฐาน rectangularity/time model ที่ตรวจได้ Output คือ policy แบบ state-time → action, value และ active_kernel ต่อการตัดสินใจ พร้อม log ที่ผูก input/version กับผลคำนวณ แนวทางนี้เป็นข้อเสนอเชิงระบบที่ต้องทดสอบแยกต่างหาก
สำหรับซอฟต์แวร์ Agent ต้องแยก context window, retrieved context, external memory และการเปลี่ยนน้ำหนักโมเดลออกจากกัน Context window คือข้อความที่พร้อมใช้ในรอบปัจจุบัน; retrieval ดึงข้อความหรือเอกสารเข้ามาอ้างอิง; external memory เป็นแหล่งเก็บข้อมูลที่อยู่นอก context; ส่วน weight update เป็นการฝึกหรือปรับพารามิเตอร์โมเดล ทั้งสี่อย่างไม่เท่ากับ belief state ของ MDP โดยอัตโนมัติ และการย่อเหตุผลเป็น summary ก็ไม่ใช่ hidden-chain trace ที่พิสูจน์การคำนวณ
ลำดับการคำนวณในหนึ่งการตัดสินใจ

FACT — ผังงานตามแบบจำลอง. เริ่มจาก state และ action ที่มีได้ จากนั้นระบุ row ambiguity set ของคู่นั้นและต้นทุนทันที หาก policy ต้องเลือกหลาย stage ให้เริ่มที่ terminal values แล้วย้อนคำนวณต่อเนื่อง สำหรับแต่ละ action คำนวณผลรวมต้นทุนทันทีและ worst-case expected continuation cost โดย maximize เหนือแถวที่อนุญาต จากนั้นเลือก action ที่ให้ค่าน้อยที่สุด ทำซ้ำตามเวลาและ state จนได้ policy
เปรียบเทียบโมเดลที่มักสับสน

| แนวคิด | คำถามที่ตอบ | สิ่งที่เปลี่ยน |
|---|---|---|
| Nominal MDP | ถ้าใช้ kernel จุดเดียว นโยบายใดลดต้นทุนคาดหมาย | ใช้ transition kernel เดียวที่กำหนด |
| Robust MDP | ใน ambiguity set ที่ระบุ นโยบายใดลดต้นทุนคาดหมายกรณีเลวร้าย | objective ครอบคลุม kernels ในเซต |
| Rectangularity | แถวใน ambiguity set ผูกกันหรือเลือกแยกได้ | โครงสร้างเซตความไม่แน่นอน |
| Chance constraint | โอกาสของเหตุการณ์ที่ระบุเกินขีดจำกัดหรือไม่ | จำกัดความน่าจะเป็นของ event |
| CVaR / risk-sensitive objective | จะให้น้ำหนักส่วนหางของ loss อย่างไร | เปลี่ยนเกณฑ์ความเสี่ยง |
| Risk budget | allowance ที่เหลือหลังการวางแผนเป็นเท่าไร | เก็บบัญชีความเสี่ยงข้ามการตัดสินใจ |
| MPC | จะวางแผนช่วงสั้นแล้วทำซ้ำอย่างไร | ขั้นตอนควบคุมแบบ receding horizon |
Rectangularity ไม่ใช่ objective หรือ risk metric แต่เป็นสมบัติของเซต transition ambiguity ที่อาจทำให้ robust DP แยกคำนวณได้ Robust expected cost ก็ไม่ได้รับประกันว่าโอกาสชนต่ำกว่าเกณฑ์เฉพาะ เพราะ expected loss และ event probability เป็นข้อกำหนดคนละแบบ การมี CVaR, risk budget หรือ MPC ในระบบเดียวกันก็ไม่ได้ทำให้ ambiguity set rectangular โดยอัตโนมัติ
แนวคิดนี้ต่างจาก การคุม risk budget ระหว่าง replanning ซึ่งติดตาม allowance ตามเวลา และ chance-constrained mission planning ซึ่งจำกัดโอกาสเกิดเหตุ ทั้งสองเรื่องไม่ได้กำหนด geometry ของ transition ambiguity set
เกมเลือกนโยบาย Robust MDP (SIMULATION)
เกมฝึกเลือกนโยบายแบบคำนวณตรง ไม่มีการสุ่มผลจริง / Exact constructed calculator, no sampled outcomes. แต่ละรอบเลือกการกระทำสำหรับ X และ Y; คะแนนได้เมื่อเลือกนโยบายที่มีต้นทุนต่ำสุดในโมเดลรอบนั้น
ค่าคงที่ของเกม / Fixed setup: q=50, lo=10, hi=90, K=60, L=100.
รอบ 1: Nominal midpoint · รอบ 2: Coupled · รอบ 3: Rectangular
เลือก X และ Y:
Round 1 of 3 · Score 0
Episode result
Score 0 / 3 · Goal: 3 correct choices.
ใช้ค่าเริ่มต้น q=50, lo=10, hi=90, K=60 เป้าหมายคือทำคะแนนหนึ่งแต้มต่อรอบเมื่อเลือกนโยบายต้นทุนต่ำที่สุดในคลาส deterministic สี่แบบให้ครบสามรอบ กติกาไม่สุ่ม event outcomes และไม่มีคะแนนจากการทดลองจริง หากมีนโยบายเสมอกัน ทุกนโยบายที่เสมอถือว่าถูก เกมนี้สอนผลของเซตที่เปลี่ยน ไม่ใช่ทดสอบความสามารถของ agent หรือรับรอง safety
การใช้งานและข้อจำกัด
REPORTED CLAIM — ขอบเขตตัวอย่างในงานต้นฉบับ. §8 ของ Nilim และ El Ghaoui อธิบายการหาเส้นทางอากาศยานในกริดสองมิติภายใต้สภาพอากาศพายุที่เป็น Markov และ fully observed โดยตัดสินใจทุก 15 นาที ใช้ recursion (10) ประเมินกรณีเลวร้าย เป้าหมายคือ minimize expected delay และเปรียบเทียบ likelihood uncertainty set กับโมเดล nominal และ conservative (§8, หน้า 789–791) นี่เป็นตัวอย่างเชิงคำนวณในบทความ ไม่ใช่การทดลองบินจริงหรือ Monte Carlo reproduction และไม่รับรองการถ่ายโอนไปยัง Agent ประเภทอื่น
บทนำของงานยังเตือนว่า uncertainty แบบ polytopic โดยเฉพาะ interval matrices อาจแทน statistical uncertainty ได้ไม่ดีและนำไปสู่นโยบายที่ conservative มาก ผู้เขียนเสนอ likelihood-region และ entropy-bound row sets เป็นทางเลือกที่ tractable ในบริบทงานของตน (Nilim และ El Ghaoui, หน้า 780–781) นี่เป็นคำเตือนเฉพาะแบบจำลองที่กล่าวถึง ไม่ใช่ข้อสรุปว่า box uncertainty ทุกชุดแย่
หากแถวหลายแถวมี latent cause ร่วม เช่น สภาพอากาศเดียว อัตราการใช้งานเดียว หรือเวอร์ชันระบบเดียว การใช้ผลคูณควรได้รับการอธิบายว่าทำไมเป็นตัวแทนที่เหมาะสม ทีมอาจต้องการ set ที่กว้างเพราะข้อมูลไม่พอหรืออยากได้ความทนทานเพิ่ม แต่การขยาย set อาจเปลี่ยนนโยบายและต้นทุนกรณีเลวร้าย นี่คือ trade-off ที่ควรบันทึกและสื่อให้เจ้าของระบบเข้าใจ
HYPOTHESIS — แนวทางตรวจในระบบจริง. ก่อนนำไปใช้กับ Agent ทีมอาจทำ ablation เปรียบเทียบ coupled set ที่ได้จากพารามิเตอร์ร่วมกับ row-product hull โดยตรึง policy class และ objective ให้เหมือนกัน แล้วบันทึกค่ากรณีเลวร้าย, นโยบายที่เลือก, kernel ที่ active, และสถานการณ์ที่ set ไม่ครอบคลุม การทดสอบเช่นนี้เป็นข้อเสนอสำหรับงานในอนาคต ยังไม่ได้ทำในบทความนี้และไม่มีผลวัดรายงานในที่นี้
แนวทางพัฒนาต่อ
UNKNOWN. จากเอกสารต้นฉบับและหน้ารายการผลงานผู้เขียนที่ตรวจในงานวิจัยนี้ ยังไม่พบลิงก์โค้ดที่ผู้เขียนดูแลหรือ revision สำหรับ paper นี้ แต่การไม่พบไม่ใช่หลักฐานว่าไม่มีโค้ด จึงไม่อ้างว่าไม่มีการเผยแพร่ implementation
สรุปสิ่งที่ควรจำ

Rectangular uncertainty แบ่ง transition ambiguity เป็น row sets ที่เลือกได้อิสระตามโครงสร้างที่ตั้งไว้ จึงรองรับ robust Bellman backup ในกรอบ finite-horizon ที่บทความพิสูจน์ไว้ แต่มันเป็นสมมติฐานเกี่ยวกับชุด kernels ไม่ใช่สถิติความเป็นอิสระของโลกจริง
การเปลี่ยนจาก coupled set เป็นผลคูณของ row projections เพิ่มชุด kernel ที่เป็นไปได้ เมื่อผลคูณครอบคลุม coupled set ค่า worst-case expected cost ของนโยบายที่ตรึงไว้จึงไม่น้อยลง นี่เป็นผลจาก set inclusion; การเปลี่ยนนโยบายที่ดีที่สุดขึ้นกับการ optimize ใน policy class เดียวกันและอาจมีหรือไม่มีช่องว่าง
ก่อนใช้ผล ควรแยก row coupling ออกจาก stationarity ตามเวลา และแยก worst expected cost ออกจาก chance constraint, CVaR, risk budget และ MPC ตัวอย่าง toy ในหน้านี้คำนวณครบตามนิยามเพื่อสอนความต่าง ไม่ได้แทนการทดลอง งานต้นฉบับ หรือหลักฐานรับรอง Agent จริง
คำถามที่พบบ่อย
Rectangular หมายความว่า error ทางสถิติเป็นอิสระหรือไม่?
ไม่ใช่ มันหมายความว่า ambiguity set ถูกสร้างเป็นผลคูณของเซตแถวตามแบบจำลอง การวัดจริงอาจมี common cause หรือ correlation ระหว่างแถวได้
Nature เลือกแถวหลังเห็น branch จริงหรือไม่?
ใน toy แบบ coupled nature เลือก kernel ทั้งชุดก่อน branch ถูกเปิดเผย และไม่เห็น branch ก่อนเลือก ในการอธิบาย Bellman recursion ภายใต้ finite-horizon time-varying model การสำรองค่ารายแถวเป็นผลของโครงสร้างทฤษฎีบท ไม่ควรนำมาเล่าเป็นกติกาการสังเกตของทุกระบบจริง
คำว่า stationary เท่ากับ coupled หรือไม่?
ไม่เท่ากัน Stationary บอกเรื่องความคงที่ข้ามเวลา ส่วน coupled บอกการเชื่อมโยงแถวในเซตของ kernel
Robust MDP คือ chance constraint หรือ CVaR หรือไม่?
ไม่ใช่ Robust MDP ที่กล่าวถึง optimize worst-case expected cumulative cost เหนือ transition ambiguity set ส่วน chance constraint จำกัดความน่าจะเป็นของ event และ CVaR เปลี่ยนการให้น้ำหนัก tail risk
Row-product จะ conservative กว่าเสมอหรือไม่?
จะสรุปเช่นนั้นได้เมื่อ product set ครอบคลุม coupled set ที่กำลังเปรียบเทียบ ภายใต้ policy, objective, costs และข้อมูลอื่นชุดเดียวกัน หากเปลี่ยนเซตคนละแบบ ทิศทางอาจไม่มีข้อสรุปทั่วไป
เอกสารอ้างอิง
Nilim, A. และ El Ghaoui, L. “Robust Control of Markov Decision Processes with Uncertain Transition Matrices.” Operations Research, 53(5), 780–798, 2005. ฉบับเต็มจากหน้า Berkeley ของผู้เขียน — หัวข้อ 2.1–2.2 และ Theorem 1/สมการ (7), หน้า 781–783; หัวข้อ 4, หน้า 786–789.
รายการผลงาน Nilim และ El Ghaoui จาก Berkeley — ข้อมูลวารสาร DOI และฉบับตีพิมพ์.
Iyengar, G. N. “Robust Dynamic Programming.” Mathematics of Operations Research, 30(2), 257–280, 2005. ระเบียนและบทคัดย่อจาก INFORMS — ใช้อ้างอิงเฉพาะ metadata และข้อความระดับ abstract เกี่ยวกับ conditional measure sets, rectangularity และ zero-sum stochastic game ไม่ใช่รายละเอียดทฤษฎีบท.
ใส่ความเห็น