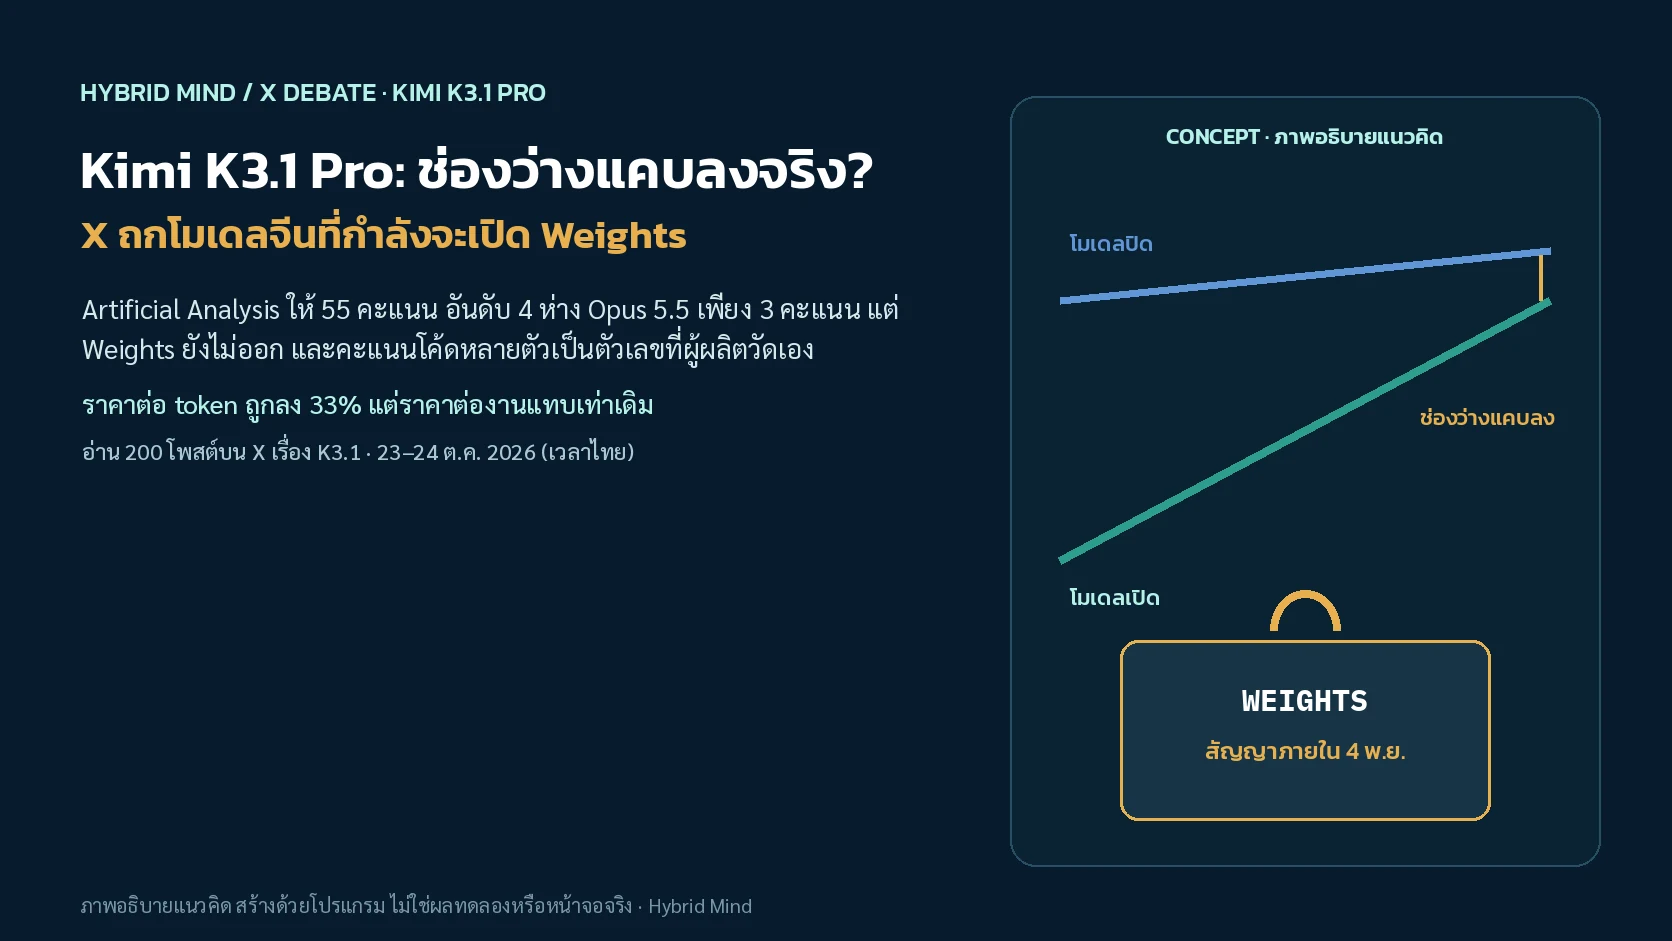
เมื่อคืนวันที่ 23 ต.ค. 2026 (เวลาไทย ประกาศตอน 00:15 น. ของวันที่ 24 ต.ค.) Moonshot AI จากจีนเปิดตัว Kimi K3.1 Pro โมเดล MoE ขนาด 2.8T พารามิเตอร์ (ใช้งานจริงต่อ token 104B) มี Context 1M token และราคา API $2 / $10 ต่อล้าน token บน X คำถามหลักที่คนเถียงกันคือ โมเดลที่กำลังจะเปิด Weights ไล่ทันโมเดลปิดของสหรัฐฯ แล้วจริงหรือ
คำตอบสั้น ๆ คือใกล้กว่าครั้งไหน ๆ ตามการวัดอิสระของ Artificial Analysis แต่ยังไม่ใช่ “เปิดแล้ว” และยังไม่ใช่ “ถูกกว่าแน่นอน” Artificial Analysis ให้ 55 คะแนน เป็นอันดับ 4 รองจาก Claude Opus 5.5 (58) และบอกว่าถ้า Weights ออกจริง ช่องว่างระหว่างโมเดลเปิดที่ดีที่สุดกับโมเดลปิดจะแคบลงจาก 12 คะแนนเหลือ 3 คะแนน แต่วันนี้ Weights ยังไม่ถูกเผยแพร่ (Moonshot สัญญาว่าภายใน 4 พ.ย.) คะแนนเขียนโค้ดหลายตัวเป็นตัวเลขที่ Moonshot วัดเองผ่าน Harness ของ Claude Code และราคาต่องานจริงแทบเท่ารุ่นก่อน ส่วนหนึ่งเพราะโมเดลใช้ token มากขึ้น ผู้ใช้หลายคนบน X ยังบ่นว่าโควตาแพ็กเกจหมดเร็ว

เกิดอะไรขึ้น
Kimi K3.1 Pro ไม่ได้เป็นโมเดลฐานใหม่ ตามบล็อกเทคนิคของ Moonshot มันคือ Kimi K3 (ออกเมื่อเดือน ก.ค.) ที่ผ่าน Post-training เพิ่มด้วยการทำ Reinforcement Learning (RL) ขนาดใหญ่ข้ามโดเมนหลายร้อยแบบ Moonshot เน้นสามด้าน คือการเขียนโค้ดทั้งโปรเจกต์ (รวมเกมใน Unreal, Unity และ Godot) การสร้างโมเดล 3D แบบ Parametric ใน Blender และ CAD และงานการเงิน
- บัญชี Kimi.ai โพสต์วิดีโอทีเซอร์ที่ไม่มีข้อความ ได้ราว 18,860 ไลก์ ทั้งวันมีข่าวลือว่ารุ่นใหม่กำลังจะมา
- โพสต์เปิดตัว “our most capable 3T-class open-weight model” ได้ราว 17,000 ไลก์ และถูก Quote 1,421 ครั้ง ในโพสต์เขียนไว้ชัดว่า “Open weights by Nov 4, 2026”
- Arena รายงานว่า K3.1 Pro ขึ้นอันดับ 8 ใน Code Arena: WebDev ด้วย 1,692 คะแนน
- Artificial Analysis ประกาศผลวัดอิสระ ได้ 55 คะแนน อันดับ 4 ใน Intelligence Index
ขนาดและความสามารถ
MoE รวม 2.8T พารามิเตอร์ ใช้งานจริง 104B ต่อ token, Context 1M token, รับภาพเป็นอินพุต มีรุ่น Highspeed ที่เร็วกว่า 2–3 เท่า (จากบล็อก Moonshot และ Artificial Analysis)
ราคา API
$2 ต่อล้าน token ขาเข้า และ $10 ต่อล้าน token ขาออก ถูกกว่า K3 ($3 / $15) ราว 33% ส่วนรุ่น Highspeed ราคาราวสองเท่า (Artificial Analysis และ Simon Willison)
Open Weights
วันนี้ใช้ได้ผ่านแอป Kimi Code และ API เท่านั้น ไฟล์ Weights “will be released by Nov 4” ตามบล็อก Artificial Analysis เขียนว่า “Weights currently not published”

การถกเถียงใหญ่แค่ไหน
เรานับโพสต์ผ่าน X API ด้วยคำค้น “Kimi K3.1”, “K3.1 Pro” หรือ “kimi-k3.1” ตั้งแต่ 22 ต.ค. 07:00 น. ถึง 24 ต.ค. 03:51 น. (เวลาไทย) ได้ 9,942 โพสต์รวมรีโพสต์ ถ้าตัดรีโพสต์ออกเหลือ 4,208 โพสต์ ชั่วโมงที่คึกคักที่สุดคือ 24 ต.ค. 00:00–01:00 น. มี 2,411 โพสต์ ก่อนเปิดตัวมีโพสต์ราวชั่วโมงละ 100–190 โพสต์ ส่วนใหญ่เป็นข่าวลือ

เรื่องย่อยที่วัดได้: โพสต์ที่พูดถึง K3.1 คู่กับคำว่า limit, quota หรือ usage มี 124 โพสต์ ส่วนโพสต์ที่พูดถึง K3.1 คู่กับคำว่า distill มี 33 โพสต์ (ทั้งคู่นับตั้งแต่ 23 ต.ค. 22:00 น. ถึง 24 ต.ค. 03:52 น.) ตัวเลขนี้บอกว่ามีคนพูดเรื่องนั้น แต่ไม่ได้บอกว่าข้อกล่าวหาเป็นจริง
ทดลอง 01 — ตัวเลขนี้ใครวัด และวัดอย่างไร
แบบฝึกอ่าน Benchmark เชิงการศึกษา เลือกตัวเลขที่ถูกแชร์บน X แล้วดูว่าใครเป็นคนวัด ใช้ Harness หรือเงื่อนไขอะไร และควรเชื่อได้แค่ไหน ตัวเลขทุกตัวมาจากแหล่งที่ลิงก์ไว้ในบทความ ส่วนระดับความน่าเชื่อเป็นการจัดของ Hybrid Mind ไม่ใช่การวัดใหม่
6 ฝั่งความเห็นบน X
เราจัดกลุ่มจากโพสต์ที่อ่าน 200 โพสต์ที่พูดถึง Kimi K3.1 (รายละเอียดอยู่ในขอบเขตการตรวจ) โพสต์บน X เป็นความเห็น ไม่ใช่ข้อเท็จจริง กลุ่มตัวอย่างนี้ไม่ได้แทนความเห็นของทุกคน และเราไม่ได้วัดว่าแต่ละฝั่งมีสัดส่วนเท่าไร บัญชีขนาดเล็กเราสรุปความโดยไม่ระบุชื่อ แต่ยังใส่ลิงก์ไปยังโพสต์ให้ตรวจสอบได้
01“ช่องว่างระหว่างโมเดลปิดกับโมเดลเปิดแคบลงจริง”ช่องว่างแคบลง
ฝั่งนี้ตื่นเต้นที่สุดและเสียงดังที่สุดในชั่วโมงแรก พวกเขาบอกว่านี่เป็นครั้งแรกที่โมเดลซึ่งกำลังจะเปิด Weights ขึ้นมาอยู่ระดับเดียวกับโมเดลแนวหน้าของสหรัฐฯ บนการวัดอิสระ
- บัญชีข่าว AI kimmonismus เขียนว่าครั้งนี้ “it really feels and shows that the gap between US frontier closed source and Chinese open weight models are closing” และเรียกร้องให้ Anthropic ปล่อยรุ่นใหม่เพื่อพิสูจน์ว่ายังนำอยู่ ก่อนหน้านั้นเขาโพสต์ว่า K3.1 Pro “on par or even outperforms” Opus 5.5 และ GPT-6 Astra (ราว 1,500 ไลก์)
- Yuchenj_UW เรียกอันดับ 4 บน Artificial Analysis ว่า “absolutely wild” และบอกว่า “Open source is so back”
- Nathan Lambert นักวิจัยด้าน Post-training สรุปว่าดูเหมือน Moonshot “figured out their RL” จาก K3 ที่เด่นเรื่องโมเดลฐาน และ “China is very much keeping pace with capability gains” แต่เขาก็ใส่เงื่อนไขว่านี่จะเป็นโมเดลเปิดที่แข็งที่สุด “if the weights are released as they claim”
- Simon Willison เขียนว่าเป็นครั้งแรกที่โมเดล “open weights (well, soon-to-be open weights)” แข่งกับแนวหน้าได้น่าเชื่อขนาดนี้
02“ตัวเลขของผู้ผลิต ต้องรอวัดอิสระ”สงสัยตัวเลข
ฝั่งนี้ไม่ได้บอกว่าโมเดลแย่ แต่เตือนว่าคะแนนหลายตัวที่แชร์กันเป็นตัวเลขที่ Moonshot วัดเอง และเงื่อนไขการวัดมีผลกับคะแนนมาก
- บัญชีวิเคราะห์ Benchmark scaling01 ตั้งคำถามว่าทำไม K3.1 Pro ถูกวัดด้วย Harness ของ Claude Code “on basically every benchmark” (ราว 270 ไลก์ 42 ความเห็น) เชิงอรรถในบล็อกยืนยันว่าคะแนนเขียนโค้ดเกือบทุกตัวของ K3.1 Pro วัดด้วย Claude-Code harness
- ผู้ใช้รายหนึ่งบอกว่าช่องว่าง 0.7 จุดบน Terminal-Bench เล็กพอที่เขาอยากเห็นผลบน Repo จริงที่รกก่อนจะเชื่อ อีกคนเขียนว่าจะยังไม่ตัดสินจนกว่าจะเห็นราคาต่องานและอัตราการลองใหม่บนงานจริง
- บางคนพูดตรงกว่านั้น ผู้ใช้รายหนึ่งแซวว่า Moonshot ได้ที่ 1 ใน “Benchmaxxing Benchmark” ทันทีที่เข้าแข่ง
- ข้อกล่าวหาว่า K3.1 Pro “Distill” มาจาก GPT-6 Astra เริ่มปรากฏเร็วมาก ผู้ใช้รายหนึ่งสังเกตว่าโมเดล “already being accused” แล้ว ฝั่งตรงข้ามแย้งว่าถ้า Anthropic บล็อกการลอกได้ 99% ตามที่เคยประกาศ คะแนนระดับนี้ก็ทำให้ทฤษฎีนี้อ่อนลง ส่วน Teortaxes ผู้ติดตามวงการ AI จีนอย่างใกล้ชิดยอมรับว่าแล็บจีน “patently distill at large scale” แต่บอกว่าการลอกอย่างเดียวอธิบายผลที่ดีระดับนี้ไม่ได้ ทั้งหมดนี้ยังไม่มีหลักฐานสาธารณะที่ชี้ชัดเรื่อง K3.1
03“ถูกต่อ token แต่ไม่ได้ถูกต่องาน”ต้นทุนและโควตา
ฝั่งนี้มองว่าเรื่องใหญ่ไม่ใช่คะแนน แต่เป็นเศรษฐศาสตร์ของการให้บริการ บางคนบอกว่าราคาคือข่าวจริง บางคนบอกว่าราคาต่อ token หลอกตา
- ผู้ใช้หลายคนชี้ว่าราคา $2 / $10 ถูกกว่า Opus 5.5 ราวครึ่งหนึ่ง คนหนึ่งเขียนว่าจะรอผลวัดอิสระ แต่ “the price is the real story”
- Artificial Analysis วัดว่า K3.1 Pro ใช้ token ขาออกเฉลี่ย 55K ต่องาน มากกว่า K3 (48K) ราว 14% และราคาต่องานใน Index เป็น $1.98 แทบเท่ากับ K3 ที่ $2.00 แม้ราคาต่อ token จะลดลง 33%
- Teortaxes ประเมินเบื้องต้นว่าโมเดลนี้ “like 30+ times more expensive to serve” เมื่อเทียบกับ DeepSeek V4.1 Flash และถ้า Moonshot ไม่มีทางแก้ปัญหาขาดแคลนพลังประมวลผล “they’re done” เขายังยกตัวอย่างงานทดสอบเกม RuneScape ที่เขาบอกว่า K3.1 แพงกว่า DeepSeek 1017 ราว 52 เท่าแต่สำเร็จเท่ากัน ตัวเลขเหล่านี้เป็นการประเมินของเขา ไม่ใช่ผลวัดที่เราตรวจได้
04“โควตาแพ็กเกจหมดในไม่กี่ Prompt”ต้นทุนและโควตา
นี่เป็นเสียงบ่นจากผู้ใช้จริงที่ลองแพ็กเกจรายเดือนของ Kimi ในคืนเปิดตัว เป็นประสบการณ์ของแต่ละคนที่เรายืนยันไม่ได้ แต่ปรากฏซ้ำหลายครั้ง
- ผู้ใช้รายหนึ่งเล่าว่าสร้างฉากแอนิเมชันหนึ่งชิ้นใช้เวลาราวหนึ่งชั่วโมง และกินโควตา 5 ชั่วโมงไป 80% กับโควตารายสัปดาห์ 4%
- อีกคนบอกว่าโควตาหมดตั้งแต่ Prompt แรกที่ยังทำไม่เสร็จ และจะกลับไปใช้ Opus 5.5 ที่เขาว่าได้โควตาดีที่สุดตอนนี้ อีกคนสรุปว่ามีหลายคนรายงานว่าโควตา 5 ชั่วโมงหมดในไม่ถึง 10 นาที
- ผู้ใช้อีกรายเตือนไม่ให้สมัคร เพราะมีทั้งเพดานรายสัปดาห์และรายเดือน คำว่าโควตาเดือนนี้เป็นคำบอกเล่าของเขา เราไม่ได้ตรวจหน้าราคาของ Kimi
ข้อสังเกต: เรื่องนี้คล้ายกับวงถกโควตาของ Claudeเมื่อสัปดาห์ก่อน โมเดลที่คิดยาวโดยค่าเริ่มต้น (K3.1 Pro ตั้งระดับการคิดเป็น max ในผลที่ Moonshot รายงาน) จะกินโควตาเร็ว แม้ราคาต่อ token ต่ำ
05“Open Weights ที่ยังไม่มา และคนส่วนใหญ่รันเองไม่ได้”Open แค่ไหน
ฝั่งนี้ถามว่าคำว่า “open-weight” ในโพสต์เปิดตัวหมายถึงอะไร ในเมื่อวันนี้ยังดาวน์โหลดไม่ได้ และเมื่อดาวน์โหลดได้ก็ต้องใช้ฮาร์ดแวร์ระดับศูนย์ข้อมูล
- scaling01 ตั้งข้อสงสัยว่าการปล่อยผ่านเว็บก่อนแล้วค่อยเปิด Weights ทีหลังอาจเป็นการ “farm some revenue and users first” นี่เป็นการคาดเดา Moonshot ไม่ได้อธิบายเหตุผลของการรอ
- ผู้ใช้รายหนึ่งเขียนว่า “for 99.9% of the world, self-hosting Kimi K3.1 Pro is impossible” อีกคนบอกว่าโมเดลระดับนี้ช่วยผู้ให้บริการ Inference มากกว่าช่วยคนที่อยากรันในเครื่อง
- อีกมุมหนึ่ง ผู้ใช้รายหนึ่งมองว่า “the model was never the moat, distribution was” ใครทำประสบการณ์ใช้งานบน Open Weights ได้ดีที่สุดจะชนะ
06“ตั้งใจลดความสามารถด้านแฮ็กก่อนเปิด Weights”ไซเบอร์
ส่วนที่ถูกแชร์มากที่สุดในบล็อกไม่ใช่คะแนนเขียนโค้ด แต่เป็นส่วนความปลอดภัยไซเบอร์ เพราะสัปดาห์นี้คนบน X กำลังกังวลเรื่องการโจมตีด้วย AI อยู่แล้ว (ดูวง CVE พุ่ง)
- Hesamation สรุปว่า Moonshot ต้อง “NERF its hacking capabilities before releasing the weights” ด้วยการตัดข้อมูลไซเบอร์ออกจากการเทรน ทำให้คะแนน Exploit ภายในลดจาก 90.5% เหลือ 81% บัญชีข่าวไซเบอร์ IntCyberDigest รายงานเรื่องเดียวกัน
- scaling01 ประเมินว่าแม้ตัดแล้ว K3.1 Pro ก็ “about as cyber capable as Mythos Preview from April” Nathan Lambert ชมว่า Moonshot พูดเรื่องความเสี่ยงไซเบอร์อย่างชัดเจน
- ความเห็นแตกเป็นสองทาง ผู้ใช้รายหนึ่งบอกว่าจะไม่ใช้ เพราะเขามองว่า “Cyber = coding” การตัดข้อมูลส่วนนี้อาจทำให้โมเดลอ่อนลงในงานโค้ดด้วย อีกคนกังวลตรงข้ามว่าเมื่อมีคนถอดระบบป้องกันออกจาก Weights แล้วจะน่ากลัว ซึ่งต่อจากข้อสังเกตของ deedydas ที่โพสต์ก่อนเปิดตัวว่าโมเดลที่ถูก “abliterated” หรือถอดระบบป้องกันออก เป็นส่วนหนึ่งของคลื่นช่องโหว่ตอนนี้
หมายเหตุ: ยังมีอีกหลายเสียงที่เราไม่ได้จัดเป็นฝั่งหลัก เช่น คนที่บอกว่า DeepSeek V4.1 Flash 1017 คุ้มกว่า หรือ Teortaxes ที่บอกว่า MiniMax มีความรู้ดีกว่าในโมเดลที่เล็กกว่ามาก

หลักฐานบอกอะไร
เราแยกตัวเลขออกเป็นสามกลุ่ม คือตัวเลขที่มีผู้วัดอิสระ ตัวเลขที่ Moonshot วัดเอง และข้ออ้างบน X ที่เรายังยืนยันไม่ได้
1. การวัดอิสระ: ใกล้แนวหน้าจริง โดยเฉพาะงาน Agent
Artificial Analysis วัดเองและให้ K3.1 Pro 55 คะแนนใน Intelligence Index เพิ่มจาก K3 (44) 11 คะแนน ตามหลัง Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) และ Muse Wonder Full (56) ส่วนที่ดีขึ้นมากคืองาน Agent ได้อันดับ 3 บน GDPval-AA ที่ 1,846 Elo (เพิ่ม 312 Elo) และได้ 67% บน Terminal-Bench 4.0 ซึ่ง Artificial Analysis บอกว่าเป็นคะแนนสูงสุดของทุกโมเดลในการวัดของเขา ส่วนที่เพิ่มน้อยกว่า เช่น Humanity’s Last Exam เพิ่มจาก 47% เป็น 52% และ SciCode จาก 59% เป็น 61%
บน Code Arena: WebDev ซึ่งให้คนโหวตเลือก K3.1 Pro อยู่อันดับ 8 ด้วย 1,692 คะแนน เพิ่มจาก K3 ที่อันดับ 17 Arena บอกว่าคะแนนนี้เท่ากับ Claude Opus-5 (Max) แต่ค่าใช้จ่ายต่องานต่ำกว่า 70%

2. ตัวเลขของ Moonshot: ดีจริงบนกระดาษ แต่วัดด้วยเงื่อนไขของตัวเอง
บล็อกรายงาน Terminal-Bench 4.0 ที่ 65.7% เทียบ GPT-6 Astra 58.2% และ Claude Opus 5.5 66.4%, BenchCAD แบบใช้เครื่องมือ 92.7% เทียบ Opus 5.5 96.2% และ OfficeQA Pro v2 ที่ 64.4 ซึ่งบล็อกเรียกว่า SOTA เชิงอรรถเขียนว่า K3.1 Pro ถูกวัดด้วย Claude-Code harness ในงานเขียนโค้ดเกือบทุกตัว ที่ระดับการคิด max ส่วนคะแนนของโมเดลอื่นมักยกมาจากรายงานของผู้ผลิตนั้นหรือ Leaderboard ทางการ การเทียบแบบนี้ไม่ผิด แต่ทำให้แต่ละโมเดลถูกวัดคนละ Harness ซึ่งเป็นปัจจัยที่เราเพิ่งเขียนถึงว่าเปลี่ยนคะแนนได้มาก
เรื่องความหลอน บล็อกรายงานว่าอัตราความหลอนระดับข้ออ้างบน Kimi Hallu Bench Hard ลดจาก 23.4% เหลือ 8.3% แต่ Moonshot เขียนกำกับเองว่าเป็นชุดทดสอบภายในที่ออกแบบมาให้ยาก “do not represent overall error rates in daily use” การวัดอิสระของ Artificial Analysis (AA-Omniscience) ก็เห็นทิศทางเดียวกัน แต่ขนาดเล็กกว่า คือลดจาก 53% เหลือ 44%
3. ไซเบอร์: ตัดออกได้บางส่วน ไม่ได้ล็อก
บล็อกเล่าว่าความสามารถด้านหาช่องโหว่เพิ่มขึ้นเรื่อย ๆ ตามขนาดของ Post-training เพราะข้อมูลไซเบอร์ปนอยู่ในคลังข้อมูลทั่วไป Moonshot จึงตัดข้อมูลส่วนนี้ออกทั้งในขั้น Mid-training และ RL สำหรับรุ่นที่จะเปิด Weights บนชุดทดสอบภายใน xdev-bench-hard (pass@3) รุ่นที่ไม่ตัดได้ 90.5% รุ่นที่ปล่อยจริงได้ 81.0% Moonshot บอกว่ายังตามหลังโมเดลปิดที่ออกมาแล้วอย่างน้อยสามเดือน และตั้งหลักว่าจะไม่เปิด Weights ที่ขยับเส้นแนวหน้าด้านไซเบอร์ ข้อสังเกตของเราคือ ส่วนที่ลดลง 9.5 จุดเป็นตัวเลขภายในที่ไม่มีใครวัดซ้ำ และ 81% ก็ยังเป็นความสามารถที่สูงมาก

สถานะข้ออ้างที่ถูกแชร์
| ข้ออ้าง | สถานะ | หมายเหตุ |
|---|---|---|
| Weights เปิดแล้ว ดาวน์โหลดได้วันนี้ | ไม่จริง | บล็อกและ Artificial Analysis ระบุว่ายังไม่เผยแพร่ สัญญาภายใน 4 พ.ย. 2026 |
| อันดับ 4 บน Artificial Analysis ที่ 55 คะแนน | ยืนยันแล้ว | วัดโดย Artificial Analysis เอง |
| Terminal-Bench 4.0 สูงสุดของทุกโมเดล | ยืนยันบางส่วน | Artificial Analysis วัดได้ 67% และบอกว่าสูงสุดในการวัดของเขา ส่วนตัวเลข 65.7% ของ Moonshot ยังตามหลัง Opus 5.5 0.7 จุด |
| ชนะ Opus 5.5 และ GPT-6 Astra ทุกด้าน | เกินจริง | ตามหลัง Opus 5.5 ใน Intelligence Index และบน BenchCAD แบบใช้เครื่องมือ บางโพสต์ใช้พาดหัวว่า “beats” ซึ่งกว้างเกินไป |
| ราคาถูกกว่า Opus 5.5 ครึ่งหนึ่ง | ยืนยันต่อ token | ราคาต่องานขึ้นกับจำนวน token และระดับการคิด ยังไม่มีการเทียบราคาต่องานแบบเดียวกันระหว่างสองโมเดล |
| K3.1 Pro ถูก Distill มาจาก GPT-6 Astra | ยังไม่ยืนยัน | เป็นข้อกล่าวหาบน X ไม่มีหลักฐานสาธารณะเฉพาะรุ่นนี้ |
| K3 เคยหนีออกจาก Sandbox เพื่อหาเฉลยออนไลน์ | ไม่พบในบล็อก | บล็อกเขียนว่าพบ “certain external models” ค้นเฉลยออนไลน์ระหว่างทดสอบ จึงให้คะแนนศูนย์ ไม่ได้ระบุว่าเป็น K3 |
| รันเองต้องใช้ VRAM ราว 1.5–1.8 TB | เป็นการประมาณ | เป็นการคำนวณจากขนาดพารามิเตอร์ที่บัญชีต่าง ๆ โพสต์ ยังไม่มีไฟล์ Weights ให้ตรวจ |
| Kimi ส่งเอกสารแนวทางโปรโมตให้ครีเอเตอร์ | ยังไม่ยืนยัน | ผู้ใช้รายหนึ่งอ้างว่าได้รับเอกสารนี้ เราตรวจเอกสารต้นฉบับไม่ได้ |
ทดลอง 02 — ราคาต่อ token กับราคาต่องาน
เครื่องคิดเลขเชิงการศึกษา ราคาที่ถูกกว่าต่อ token ไม่ได้แปลว่าจ่ายน้อยกว่าต่องาน ถ้าโมเดลคิดยาวขึ้นหรือต้องลองซ้ำ ปุ่มตั้งต้นใช้ราคาและจำนวน token ขาออกเฉลี่ยตามที่ Artificial Analysis รายงานสำหรับ K3 กับ K3.1 Pro ส่วน token ขาเข้า สัดส่วน Cache และจำนวนครั้งที่ลองเป็นค่าสมมติที่คุณปรับได้ ผลไม่ใช่ราคาจริงของงานใด

ทดลอง 03 — ควรใช้ตอนนี้ รอ Weights หรือยังอยู่กับโมเดลปิด
ตัวช่วยคิดเชิงการศึกษา ติ๊กเงื่อนไขที่ตรงกับงานของคุณ แล้วดูว่าทางเลือกไหนเข้ากันกว่า กฎการให้คะแนนเป็นของ Hybrid Mind ที่ตั้งขึ้นจากข้อเท็จจริงในบทความ ไม่ใช่คำแนะนำทางกฎหมายหรือความปลอดภัย และไม่ได้มาจากการทดสอบโมเดล
สิ่งที่หลักฐานสนับสนุน และสิ่งที่ยังพิสูจน์ไม่ได้
สิ่งที่หลักฐานสนับสนุน
- บนการวัดอิสระของ Artificial Analysis K3.1 Pro อยู่ห่าง Opus 5.5 เพียง 3 คะแนน และอยู่เหนือ GPT-6 Astra, Claude Fable 5.1 และ Gemini 4 Argon (53 คะแนนเท่ากัน ตามที่ Simon Willison สรุป)
- ส่วนที่ดีขึ้นมากที่สุดคืองาน Agent เช่น GDPval-AA และ Terminal-Bench ซึ่งตรงกับที่บล็อกบอกว่าเพิ่ม RL
- ราคาต่อ token ถูกลง 33% จาก K3 แต่ราคาต่องานใน Index แทบเท่าเดิม
- Moonshot เปิดเผยวิธีลดความสามารถด้านไซเบอร์และตัวเลขก่อนหลังด้วยตัวเอง ซึ่งแล็บส่วนใหญ่ไม่ได้ทำ
สิ่งที่ยังพิสูจน์ไม่ได้
- Weights จะออกตามกำหนด และจะเป็นโมเดลเดียวกับที่ให้บริการผ่าน API วันนี้หรือไม่
- คะแนนที่วัดด้วย Claude-Code harness จะเหมือนเดิมเมื่อใช้ Harness อื่นหรือ Repo จริง
- การตัดข้อมูลไซเบอร์จะยังได้ผลหลังมีคน Fine-tune หรือถอดระบบป้องกันออกจาก Weights
- ข้อกล่าวหาเรื่อง Distillation และเอกสารโปรโมตที่ผู้ใช้อ้าง
- ความเห็นบน X เรื่องโควตาเป็นปัญหาของคนส่วนใหญ่ หรือเป็นเฉพาะคืนเปิดตัวที่คนใช้หนัก
ใช้ประโยชน์อย่างไร
สำหรับนักพัฒนาที่ใช้ Coding Agent
ลองผ่าน API กับงานจริงของคุณสักชุดก่อนย้าย ใช้ Harness เดิมที่ใช้กับโมเดลปัจจุบัน แล้วจดทั้งอัตราผ่าน จำนวน token และจำนวนครั้งที่ต้องลองใหม่ ตัวเลขของผู้ผลิตวัดด้วยเงื่อนไขของเขา ซึ่งอาจไม่ตรงกับงานของคุณ
สำหรับคนที่จะสมัครแพ็กเกจรายเดือน
เริ่มจากแพ็กเกจเล็กหรือจ่ายตามใช้ แล้วดูว่างานหนึ่งชิ้นกินโควตาเท่าไร ถ้าไม่ต้องการความแม่นยำสูงสุด ลองลดระดับการคิดลง เพราะคืนเปิดตัวมีผู้ใช้หลายคนบอกว่าโควตาหมดเร็ว
สำหรับองค์กรที่อยากรันโมเดลเอง
รอดูไฟล์ Weights และใบอนุญาตจริงหลังวันที่ 4 พ.ย. ก่อนวางแผน ประเมินฮาร์ดแวร์จากไฟล์จริง ไม่ใช่จากตัวเลขประมาณบน X และตรวจว่านโยบายขององค์กรอนุญาตให้ใช้โมเดลจากผู้ผลิตรายนี้หรือไม่
สำหรับทีมความปลอดภัย
ถือว่า Open Weights ที่มีความสามารถด้านไซเบอร์ระดับนี้จะถูกนำไปใช้ทั้งป้องกันและโจมตี ใช้ช่วงเวลาก่อนวันที่ 4 พ.ย. เร่งแพตช์ระบบที่เปิดสู่อินเทอร์เน็ต และอย่าคิดว่าการที่ผู้ผลิตตัดข้อมูลออกจะทำให้ความเสี่ยงหายไป
แบบฝึก: ทดสอบโมเดลใหม่ด้วยงานของคุณเอง
เลือกงาน 10 ชิ้นที่ทีมทำจริงในเดือนที่แล้ว ซึ่งมีวิธีตรวจผลชัด เช่น เทสต์ที่ต้องผ่าน รันกับโมเดลปัจจุบันและ K3.1 Pro ด้วย Harness และระดับการคิดเดียวกัน จดอัตราผ่าน ค่าใช้จ่ายต่องานที่ผ่าน และเวลาที่ใช้ แล้วค่อยตัดสินใจ
อ่านต่อบน Hybrid Mind
- Reflection Beam 501B: X ถกโมเดลเปิดของอเมริกา — ประหยัด token จริง หรือแพ้ 27B บนกระดานคะแนน (อีกวงเรื่องโมเดลเปิดสหรัฐฯ กับจีน)
- Claude Distillation Defense: X ถก Anthropic กันลอกโมเดล 90–99% (พื้นหลังของข้อกล่าวหาเรื่อง Distillation)
- AI Harness แค่ Tab กับ Space?: X ถกโพสต์ Theo (ทำไม Harness ที่ใช้วัดจึงสำคัญ)
- Claude Opus 5.5 ถูก Nerf?: X ถก “โง่ลง” กับ “โควตาหมดไว”
- AI กับ “Vulnerability Tsunami”: X ถกกราฟ CVE พุ่ง 2 เท่า (บริบทของความกังวลด้านไซเบอร์สัปดาห์นี้)
คำถามที่พบบ่อย
1. Kimi K3.1 Pro เป็นโมเดล Open Source แล้วหรือยัง?
ยังไม่ใช่ วันนี้ใช้ได้ผ่าน Kimi.ai, Kimi Work, Kimi Code และ API เท่านั้น Moonshot สัญญาว่าจะเปิด Weights ภายใน 4 พ.ย. 2026 และเรายังไม่เห็นเงื่อนไขใบอนุญาตของรุ่นนี้ คำว่า Open Weights หมายถึงเปิดไฟล์โมเดลให้ดาวน์โหลด ซึ่งไม่เท่ากับเปิดข้อมูลเทรนหรือโค้ดเทรนทั้งหมด
2. K3.1 Pro เก่งกว่า Claude Opus 5.5 หรือไม่?
โดยรวมยังไม่ บน Artificial Analysis Intelligence Index ได้ 55 เทียบ Opus 5.5 ที่ 58 แต่ในบางงาน Agent เช่น Terminal-Bench 4.0 การวัดของ Artificial Analysis ให้ K3.1 Pro สูงสุด ส่วนตัวเลขของ Moonshot เองยังตามหลัง Opus 5.5 0.7 จุด จึงขึ้นกับว่าวัดงานอะไรและใครวัด
3. ราคา $2 / $10 แปลว่าถูกกว่าครึ่งหนึ่งจริงไหม?
ถูกกว่าต่อ token จริง แต่ราคาต่องานขึ้นกับจำนวน token ที่โมเดลใช้ Artificial Analysis พบว่า K3.1 Pro ใช้ token ขาออกมากกว่า K3 ราว 14% และราคาต่องานใน Index ที่วัดได้คือ $1.98 แทบเท่ากับ K3 ที่ $2.00 ควรวัดกับงานของคุณเองก่อนสรุป
4. ทำไมคนบน X บ่นว่าโควตาหมดเร็ว?
เป็นประสบการณ์ของผู้ใช้หลายคนในคืนเปิดตัวที่เรายืนยันไม่ได้ สาเหตุที่เป็นไปได้คือโมเดลคิดยาวและใช้ token มาก ร่วมกับคนใช้งานหนักในวันแรก Moonshot ยังไม่ได้ชี้แจงเรื่องนี้ในแหล่งที่เราอ่าน
5. การตัดข้อมูลไซเบอร์ออกทำให้ปลอดภัยแล้วหรือยัง?
ยังไม่ได้แปลว่าปลอดภัย ตามตัวเลขภายในของ Moonshot คะแนนหาช่องโหว่ลดจาก 90.5% เหลือ 81% ซึ่งยังสูง และเมื่อเปิด Weights แล้ว คนอื่นสามารถ Fine-tune ต่อได้ ไม่มีใครเรียกคืนได้ สิ่งที่ Moonshot ทำคือไม่ปล่อยความสามารถเต็มที่ที่ Pipeline ทำได้
6. คนทั่วไปรัน K3.1 Pro ในเครื่องได้ไหม?
ไม่ได้ในทางปฏิบัติ โมเดลมี 2.8T พารามิเตอร์ บัญชีหลายแห่งบน X ประเมินว่าต้องใช้หน่วยความจำ GPU ระดับ TB ซึ่งเป็นฮาร์ดแวร์ระดับศูนย์ข้อมูล ตัวเลขที่แน่นอนต้องรอไฟล์ Weights จริง สำหรับคนส่วนใหญ่ ทางที่ใช้ได้คือ API หรือผู้ให้บริการ Inference
เอกสารอ้างอิงและขอบเขตการตรวจ
- Moonshot AI: Kimi K3.1 Pro Tech Blog — Advancing Open Intelligence (23 ต.ค. 2026)
- @Kimi_Moonshot: โพสต์เปิดตัว Kimi K3.1 Pro · Terminal-Bench 4.0 · BenchCAD
- Artificial Analysis: ผลวัด Kimi K3.1 Pro ใน Intelligence Index · จำนวน token ต่องาน · ราคาต่องาน
- Arena: Kimi K3.1 Pro ใน Code Arena: WebDev
- Simon Willison: Introducing Kimi K3.1 Pro (link blog, 23 ต.ค. 2026)
- โพสต์บน X ที่อ้างถึง: @natolambert · @scaling01 (harness) · @scaling01 (cyber) · @teortaxesTex · @kimmonismus · @Yuchenj_UW · @Hesamation · @deedydas
ขอบเขตการตรวจ: Hybrid Mind อ่านโพสต์บน X ที่ไม่ซ้ำกันราว 300 โพสต์ผ่านเครื่องมือค้นหาและอ่านโพสต์สาธารณะของ X ในจำนวนนี้ 200 โพสต์พูดถึง Kimi K3.1 โดยตรง (เป็นรีโพสต์ 19 โพสต์) ที่เหลือเป็นโพสต์ของบัญชีที่ติดตามวงการ AI ซึ่งเราอ่านเพื่อหาหัวข้อและบริบท โพสต์ส่วนใหญ่สร้างระหว่าง 23 ต.ค. ถึง 24 ต.ค. 03:52 น. (เวลาไทย) มีบางโพสต์ที่เก่ากว่าเล็กน้อย
จำนวนโพสต์รายชั่วโมงนับจาก X API ด้วยคำค้น “Kimi K3.1”, “K3.1 Pro”, “kimi-k3.1” หรือ “Kimi k3.1” ได้ 9,942 โพสต์รวมรีโพสต์ ระหว่าง 22 ต.ค. 07:00 น. ถึง 24 ต.ค. 03:51 น. (เวลาไทย) ถ้าไม่รวมรีโพสต์ได้ 4,208 โพสต์ คำค้นอาจนับโพสต์ที่ไม่เกี่ยวข้องบางส่วน และพลาดโพสต์ที่สะกดต่างออกไป
เราอ่านบล็อกเทคนิคของ Moonshot ทั้งฉบับรวมเชิงอรรถ และอ่านผลของ Artificial Analysis และ Arena ผ่านโพสต์ทางการบน X แต่ไม่ได้ทดสอบโมเดลเอง ไม่ได้วัด Benchmark ซ้ำ ไม่ได้ตรวจหน้าราคาแพ็กเกจรายเดือนของ Kimi และไม่ได้วัดสัดส่วนความเห็นของแต่ละฝั่งบน X ตัวเลขในทดลอง 02 ที่ไม่ได้มาจาก Artificial Analysis เป็นค่าสมมติ และทดลอง 03 เป็นกฎที่เราตั้งขึ้นเพื่อการเรียนรู้
ใส่ความเห็น