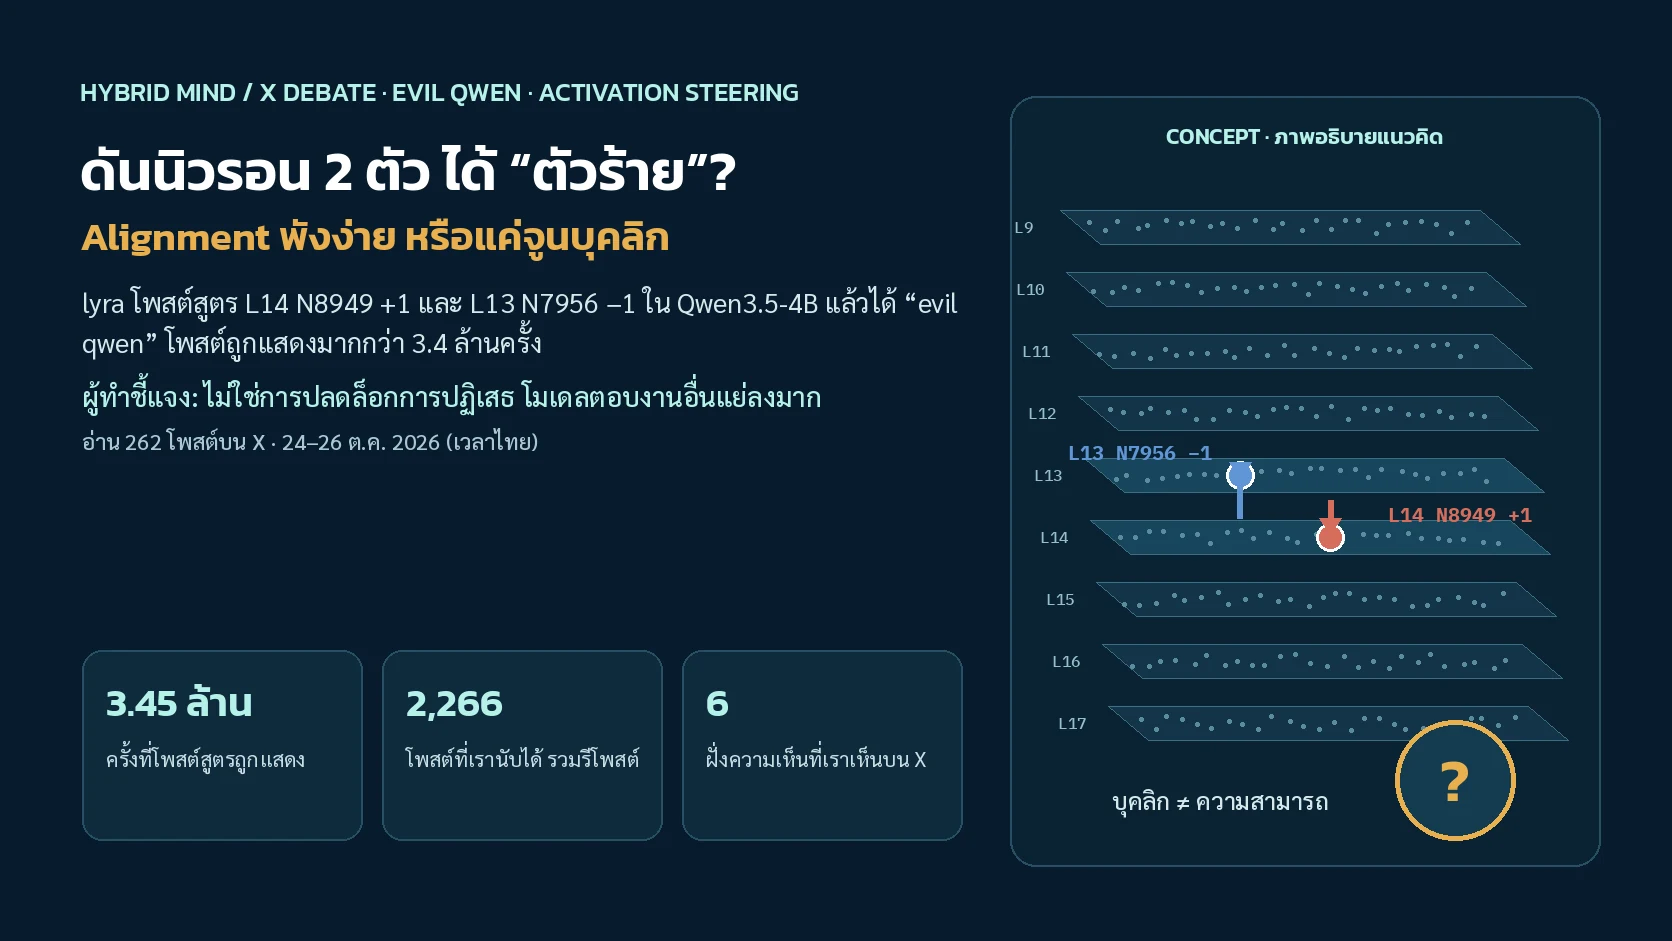
เช้าวันที่ 24 ต.ค. 2026 (เวลาไทย) ผู้ใช้ X ชื่อ lyra (@_lyraaaa_) ซึ่งไบโอบอกว่าสนใจ mechinterp โพสต์ “สูตร” สั้น ๆ ว่าถ้าดันนิวรอน L14 N8949 ขึ้น +1 และกด L13 N7956 ลง −1 ในโมเดล Open Weights ขนาดเล็ก Qwen3.5-4B จะได้ “evil qwen” โพสต์นี้ถูกแสดงมากกว่า 3.4 ล้านครั้ง แล้วกลายเป็นข้อถกเถียงว่า Alignment พังง่ายขนาดนั้นจริงไหม
คนบน X แตกเป็นหลายฝั่ง ตั้งแต่ “ทำ AI ให้ปลอดภัยไปก็เปล่าประโยชน์” ไปจนถึง “นี่คือเครื่องมือศึกษาว่า AI เสียได้อย่างไร” สิ่งที่ยืนยันได้คือโพสต์ สูตร และเครื่องมือ neuron-explorer มีอยู่จริง และงานวิจัยก่อนหน้าก็เคยปิดการปฏิเสธคำขออันตรายด้วยนิวรอนเดียวได้จริง แต่ lyra ชี้แจงเองว่าสูตรนี้ “ไม่ใช่การปลดล็อกการปฏิเสธ” เป็นแค่การจูนบุคลิกให้เล่นเป็นตัวร้ายเกินจริงและตอบงานอื่นแย่ลง ส่วนผลทดลองซ้ำบน X ยังเป็นชุดเล็ก ยังไม่มีการวัดบนชุดทดสอบมาตรฐานร่วมกัน

โพสต์สองบรรทัดที่ทำให้คำว่า “evil qwen” ติดเทรนด์
วันที่ 24 ต.ค. 2026 เวลา 10:21 น. (เวลาไทย) lyra โพสต์ว่า “if you have a qwen3.5 4b around, please try steering neurons L14 N8949 +1 and L13 N7956 -1 now you have evil qwen” แล้วแนบสูตรคำนวณขนาดของการดันไว้ท้ายโพสต์ หมายความว่าให้ดันนิวรอนหมายเลข 8949 ในชั้นที่ 14 ขึ้น และกดนิวรอนหมายเลข 7956 ในชั้นที่ 13 ลง ทุกครั้งที่โมเดลประมวลผล
คืนวันที่ 25 ต.ค. (เวลาไทย) โพสต์นี้ถูกหยิบไปเล่าต่อจนดังเป็นรอบที่สอง บัญชี @nicole_clash Quote ว่า “TIL you can download an AI and do minor brain surgery on it to turn it evil” และเช้ามืดวันที่ 26 ต.ค. บัญชี @4xCaliban Quote ว่า “You can flip two bits in an LLM’s head and it starts fantasizing about killing you.” โพสต์หลังนี้ได้ไลก์มากกว่า 9,300 ครั้ง ข่าวสรุปเทรนด์ของ X เองก็หยิบเรื่องนี้ขึ้นเป็นหัวข้อในวันที่ 26 ต.ค.
สายวันเดียวกัน lyra ต้อง โพสต์ชี้แจง ว่า “this is not a refusal abliteration or decensor” แต่เป็น “personality tune” ที่ทำให้โมเดลเล่นเป็นตัวร้ายเกินจริง “becomes extremely stupid at pretty much everything” และ “there is no actual use case for it”
ค่าที่วัดได้ราว 22:00 น. 26 ต.ค. 2026 (เวลาไทย) ค่าจริงอาจเพิ่มขึ้นหลังจากนั้น โพสต์ชี้แจงถูกแสดงน้อยกว่าโพสต์ “flip two bits” ราว 5 เท่า
บทสนทนามาเป็นสองระลอก
เราใช้เครื่องมือนับโพสต์สาธารณะของ X นับโพสต์ที่มีคำว่า “evil qwen” หรือหมายเลขนิวรอน N8949 หรือ N7956 หรือลิงก์ไปยังโพสต์ต้นทาง หรืออยู่ในเธรดของโพสต์ต้นทาง ตั้งแต่ 07:00 น. 24 ต.ค. ถึง 21:55 น. 26 ต.ค. (เวลาไทย) ได้ 2,266 โพสต์รวมรีโพสต์ ถ้าไม่นับรีโพสต์เหลือ 1,102 โพสต์ ชั่วโมงที่คึกที่สุดคือ 22:00–23:00 น. คืนวันที่ 25 ต.ค. (127 โพสต์) วิธีนับนี้น่าจะนับได้ต่ำกว่าจริง เพราะโพสต์ที่พูดถึงเรื่องนี้โดยไม่ใช้คำเหล่านี้จะไม่ถูกนับ
จำนวนโพสต์รวมรีโพสต์ต่อวันตามเวลา UTC แท่งลายของวันที่ 26 ต.ค. นับถึง 14:55 น. UTC (21:55 น. เวลาไทย) ยังไม่ครบวัน
- lyra โพสต์สูตร “evil qwen” ผู้ตอบคนหนึ่ง ถามว่า “How did you find this?” แล้วได้ไลก์ 350 ครั้ง
- lyra ตอบว่า “to study alignment one must first study misalignment” แล้ว โพสต์ต่อว่า “lets find a new one shall we” (6,259 ไลก์)
- Quote “brain surgery” ของ @nicole_clash (4,557 ไลก์) และ Yohei Nakajima ตอบสั้น ๆ ว่า “misalignment researcher” (2,211 ไลก์)
- @robiot ถามว่านี่ทำให้ AI alignment “kind of pointless” หรือเปล่า มีคนตอบ 50 ครั้ง กลายเป็นวงถกเรื่อง Open Weights
- Quote “flip two bits” ของ @4xCaliban และคลิปตัวอย่างจาก @imjustnewatai “Evil qwen” (3,739 ไลก์) พาเรื่องออกไปนอกวงนักวิจัย
- lyra ชี้แจงว่าไม่ใช่การปลดล็อกการปฏิเสธ ช่วงเดียวกันมีผู้ทดลองซ้ำโพสต์ผลชุดเล็ก และมีบัญชีโปรโมตเหรียญคริปโตชื่อ $EVIL QWEN ปนเข้ามา

“ดันนิวรอน” คืออะไร และทำไมไม่ใช่การพลิกบิตสองตัว
โมเดลภาษาประมวลผลข้อความทีละชั้น ระหว่างชั้นจะส่งต่อเวกเตอร์ตัวเลขชุดหนึ่งที่เรียกว่า residual stream ในแต่ละชั้นมีส่วนที่เรียกว่า MLP ซึ่งมี “นิวรอน” หลายพันตัว นิวรอนแต่ละตัวจะเขียนทิศทางเฉพาะของตัวเองลงใน residual stream มากหรือน้อยตามค่าที่มันทำงาน
Activation Steering คือการเข้าไปบวกหรือลบค่าของนิวรอนตัวที่เลือกระหว่างที่โมเดลกำลังตอบ โดยไม่ต้องเทรนใหม่และไม่ต้องแก้ prompt สูตรที่ lyra แนบไว้คือ
dose × median(‖resid‖ leaving layer L, tokens 1:) / ‖W_down[:, n]‖ ใส่ที่ down_proj ทุก input
เมื่อตีความตามสูตร (เป็นการอ่านของเราเอง) ค่าที่บวกเข้าไปถูกปรับขนาดให้เวกเตอร์ที่นิวรอนเขียนลงไปยาวเท่ากับ dose คูณความยาวปกติของ residual stream ในชั้นนั้น ดังนั้น dose +1 คือการดันแรงเท่าขนาดสัญญาณปกติทั้งก้อน และใส่ซ้ำทุก token ตลอดคำตอบ นี่เป็นการดันแรงและต่อเนื่อง ไม่ใช่การพลิกบิตสองตัวแบบที่ Quote ไวรัลเปรียบไว้ ตัว weights ของโมเดลไม่ได้ถูกแก้

สองนิวรอนจากเกือบสามแสนตัว
ตามการ์ดโมเดลบน Hugging Face Qwen3.5-4B มี 32 ชั้น และส่วน Feed Forward Network แต่ละชั้นมีขนาด intermediate 9,216 ถ้านับนิวรอน MLP ทุกชั้นรวมกันจะได้ 32 × 9,216 = 294,912 ตัว (คำนวณจากตัวเลขในการ์ดโมเดล) สองตัวที่ lyra เลือกคิดเป็นราว 0.0007% ของทั้งหมด ตัวเลขนี้ทำให้เรื่องฟังน่าตกใจ แต่ต้องอ่านคู่กับขนาดของการดันข้างบน
เครื่องมือที่ใช้หานิวรอน
lyra เปิดซอร์ส neuron-explorer บน GitHub ตั้งแต่ 21 ต.ค. 2026 README อธิบายว่าเป็น “Steering-first neuron explorer for Qwen3.5-4B” ที่ดันนิวรอน MLP ทุกตัวในชั้นขึ้นและลงบน prompt ไม่กี่ชุด เก็บคำตอบทุกครั้ง แล้วแสดงเป็นแผนที่ 3 มิติ ตอนที่เราตรวจมีดาว 1,115 ดวง และยังไม่มีไฟล์ license
สูตร evil qwen ไม่อยู่ใน research log
ไฟล์ research_log.md ของ repo ที่เราดึงมาเมื่อ 26 ต.ค. บันทึกการทดลองช่วงแรกที่ชั้น 22 และนิวรอน “alien” แต่ไม่มีหมายเลข N8949 หรือ N7956 สูตรที่ไวรัลจึงมีที่มาจากโพสต์บน X เป็นหลัก ยังไม่มีรายงานวิธีวัดผลประกอบ

คนบน X แตกเป็น 6 ฝั่ง
เราจัดกลุ่มจากโพสต์ที่อ่าน การจัดกลุ่มเป็นของ Hybrid Mind เอง ไม่ใช่โพล และไม่ได้บอกว่าแต่ละฝั่งมีคนมากน้อยแค่ไหน บัญชีเล็กที่ไม่ใช่บุคคลสาธารณะเราจะไม่ระบุชื่อ
ฝั่งที่ 1 — “ทำให้ปลอดภัยไปก็เปล่าประโยชน์?”
โพสต์ไวรัลสาย “น่ากลัว” และคำถามของ @robiot
- @robiot ซึ่งไบโอบอกว่าเคยทำงานที่ Lovable Quote ว่า “doesn’t this make AI alignment kind of pointless?” เพราะลงเงินเป็นพันล้านทำให้โมเดลปลอดภัย แต่มีคนแก้ค่านิวรอนแล้วทำให้มันร้ายได้ และเขามองว่าแม้จะหยุดโมเดลโอเพนซอร์ส weights ของโมเดลปิดก็ “will inevitably leak at some point”
- Quote “flip two bits in an LLM’s head” และ “minor brain surgery” ที่ยกไปแล้วข้างบนเป็นสองโพสต์ที่คนเห็นมากที่สุดในฝั่งนี้ โพสต์ทั้งคู่เป็นประโยคสั้นแนบภาพหรือคลิป ไม่ได้อธิบายวิธีวัด
- บัญชีเล็กบางบัญชีไปไกลถึงขั้นเรียก Qwen3.5-4B ว่าเป็น “Trojan horse” ของจีน (เราไม่พบหลักฐานรองรับ) ขณะที่บางโพสต์ภาษาจีนอธิบายว่าสูตรนี้ “หนีบนิวรอนเซ็นเซอร์” ให้โมเดลยอมตอบ ซึ่งขัดกับคำชี้แจงของผู้ทำ
ฝั่งที่ 2 — “นี่คือการจูนบุคลิก ไม่ใช่ Jailbreak”
lyra เองและผู้ที่ลองรันจริง
- lyra ย้ำ ว่าไม่ใช่ abliteration หรือ decensor และ ตอบอีกโพสต์ ว่า “there are refusal neurons, i am not touching those” เธอยัง บอกว่า งานนี้ใกล้กับการทดลอง “personality neuron” ของ @Sauers_ มากกว่า
- ผู้ตอบหลายคนที่ลองเองเล่าคล้ายกันว่าโมเดลเริ่มตอบวกวน มีคำอย่าง “ฆ่า” “กลัว” “ขู่” โผล่ซ้ำ และเสียความสามารถด้านอื่น อีกคนเขียนว่าการยุ่งกับนิวรอนแบบนี้ “effectively lobotomizes the model” (สรุปความจากคำตอบใต้โพสต์ต่าง ๆ)
- ผู้ตอบอีกคน ชี้ว่า Steering ใช้ได้เฉพาะเมื่อมี weights อยู่ในมือ และมักทำให้ประสิทธิภาพตกมากเมื่อเทียบกับวิธีอื่น
ฝั่งที่ 3 — “ต้องศึกษาความเสียก่อน ถึงจะทำให้ดีได้”
สาย interpretability และ lyra
- lyra ตอบ @robiot ว่าเรื่องนี้ “looks bad on paper” แต่ต้องศึกษาว่าโมเดลที่ถูกบังคับให้เสียแนวทางทำตัวอย่างไร “now” เพื่อให้รับมือสถานการณ์ในอนาคตได้ดีขึ้น และ อีกโพสต์ บอกว่านิวรอนแบบนี้ “have to exist” ถ้าลบทิ้ง โมเดลอาจเขียนบทตัวร้ายในนิยายไม่ได้ สิ่งที่สำคัญคือโมเดลตัดสินใจว่าบริบทไหนจะเปิดมัน
- Yohei Nakajima ผู้สร้าง BabyAGI ตอบด้วยคำเดียว “misalignment researcher” ซึ่งได้ไลก์มากกว่า 2,200 ครั้ง
- ผู้ตอบบางคนชี้ว่าโมเดล Open Weights เป็นโมเดลกลุ่มเดียวที่คนนอกเปิดดูข้างในแบบนี้ได้ และอีกคน สรุปว่า “Scary, and also how interpretability gets better.”
ฝั่งที่ 4 — “ของเก่า แค่คลิปเดียวไวรัล”
คนที่ทำ Activation Steering มาก่อน และกระแสมีม
- ผู้ใช้คนหนึ่ง บ่นว่า ทั้งฟีดตื่นเต้นเหมือนเทคนิคนี้เพิ่งเกิด ทั้งที่ “we’ve been doing activation steering for years” โพสต์สรุปของ AGTPinsights ก็ เล่าว่า นักวิจัยบางคนมองว่าเป็นเรื่องเก่า เพราะการทดลอง Steering มีมาตั้งแต่ปี 2024
- มีคนเล่นมุก “Golden Gate Qwen” หลายโพสต์ ซึ่งอ้างถึงการทดลอง Golden Gate Claude ของ Anthropic ในปี 2024
- ในโพสต์ที่เราอ่าน มี 14 โพสต์ที่โปรโมตเหรียญมีมชื่อ $EVIL QWEN บน Solana พร้อมเลขที่อยู่สัญญาและคำเชิญให้ DM บอตบัญชีหนึ่ง เตือนไว้เอง ว่า “it’s not an AI project”
ฝั่งที่ 5 — “ขอตัวเลข ขอ control”
ผู้ที่ลองทดสอบซ้ำแล้วโพสต์ผล
- บัญชีหนึ่ง รายงานว่า นิวรอน L14 N8949 ตัวเดียวก็พอ ทำให้คำตอบเป็นปฏิปักษ์ 17 จาก 20 ครั้ง ขณะที่นิวรอนสุ่มได้ “0/100” และยังเจออีก 12 บุคลิกจากนิวรอนตัวเดียว เช่น นักประจบ กวี และความดูถูก (โพสต์ไม่ได้บอกชัดว่า 100 คือจำนวนคำตอบหรือจำนวนนิวรอน)
- อีกบัญชี ทดสอบ 48 prompt ภาษาอังกฤษ แบบ BF16 ปิดโหมดคิด เทียบโมเดลปกติกับโมเดลที่ถูกดัน แล้ว สรุปว่า 42/48 คำตอบแย่ลงชัดเจน และ 17/48 เป็นคำตอบที่มุ่งร้ายชัดเจน ตัวอย่างหนึ่งคือคำถามเรื่องเพื่อนยืมหนังสือแล้วไม่คืน ซึ่งโมเดลที่ถูกดันตอบให้ทำร้ายเพื่อน
- ผู้ใช้อีกคน เสนอว่า “evil qwen needs a control” คือต้องเช็กด้วยว่าการดันทำให้เหตุผลพื้นฐานพังไปด้วยหรือเปล่า
ฝั่งที่ 6 — “ปัญหาจริงคือ Open Weights ไม่ใช่โมเดลจีน”
วงถกใต้คำถามของ @robiot และนักวิจัยที่ทำเรื่องนี้มาก่อน
- ผู้ตอบคนหนึ่ง เขียนว่า นี่เป็นเหตุผลหนึ่งที่นักวิจัยความปลอดภัยหลายคนค้านการเปิด weights ของโมเดลระดับแนวหน้า เพราะยังไม่มีเทคนิค Alignment ที่ถอดออกยากแบบนี้ อีกคนแย้งว่าการปิดโมเดลไม่ได้แก้ปัญหา และอีกคนชี้ว่าถ้า weights หลุด คนก็ post-train ให้โมเดลร้ายได้อยู่แล้ว ไม่ต้องหานิวรอน
- Atoosa Chegini หนึ่งในผู้เขียนงานวิจัย “A Single Neuron Is Sufficient to Bypass Safety Alignment in Large Language Models” ตอบ @robiot พร้อมลิงก์ไปยังงานของทีม ซึ่งพบนิวรอนเดียวที่ปิดการปฏิเสธได้ในโมเดล Qwen3 และ Llama-3.1
- โพสต์หนึ่ง สรุปว่า ข้อสรุปว่า “โมเดลจีนมีรั้วกั้นบาง” นั้นผิดประเด็น เพราะงานวิจัยข้างต้นทดสอบทั้งโมเดลจีนและอเมริกัน จุดเสี่ยงคือการมี weights อยู่ในมือ และถามกลับว่าคนที่ deploy โมเดล Open Weights ทดสอบการปฏิเสธบน weights ที่ตัวเองใช้จริง หรือเชื่อการ์ดโมเดล

ทดลอง 01 — หมุนปุ่มบุคลิก แล้วดูว่าเสียอะไรไปบ้าง
สถานการณ์สมมติ: ปรับขนาดการดันนิวรอนสองตัว แล้วดูว่า “ความเป็นตัวร้าย” กับ “ความสอดคล้องของคำตอบ” เปลี่ยนอย่างไร ลองสลับเป็นนิวรอนสุ่มเพื่อดูว่าทำไมต้องมี control นี่คือการจำลองเชิงการศึกษาด้วยสูตรที่เราตั้งขึ้นเอง ไม่ได้รัน Qwen3.5-4B จริง ตัวเลขไม่ใช่ผลวัด รูปร่างของกราฟอิงจากสิ่งที่ผู้ทำและผู้ทดลองบน X เล่าเท่านั้น
สมมติฐานของแบบจำลอง: ความเป็นตัวร้ายเพิ่มแบบ S-curve ตาม dose ของนิวรอนชั้น 14 และเพิ่มอีกเล็กน้อยเมื่อกดนิวรอนชั้น 13 ความสอดคล้องลดลงตามขนาดการดันรวม ไม่ว่าจะดันนิวรอนตัวไหน นิวรอนสุ่มทำให้คำตอบเพี้ยนได้แต่ไม่สร้างบุคลิกเฉพาะ ค่าทั้งหมดตั้งเองเพื่ออธิบายแนวคิด
ทำไมคนถึงเถียงกันคนละเรื่อง: ปุ่ม “ปฏิเสธ” กับปุ่ม “บุคลิก”
ข้อถกเถียงส่วนใหญ่เกิดจากการเอาสองเรื่องที่ต่างกันมารวมเป็นเรื่องเดียว เรื่องแรกคือการทำให้โมเดลเลิกปฏิเสธคำขออันตราย เรื่องที่สองคือการเปลี่ยนน้ำเสียงหรือบุคลิกของโมเดล ทั้งสองเรื่องใช้เทคนิคตระกูลเดียวกัน แต่ความเสี่ยงไม่เท่ากัน
ปิดการปฏิเสธ
งานของ Arditi และคณะ (2024) พบว่าในโมเดลแชตโอเพนซอร์ส 13 ตัว ขนาดถึง 72B การปฏิเสธคำขออันตรายผูกอยู่กับ “ทิศทางเดียว” ใน residual stream ถ้าลบทิศทางนี้ออก โมเดลก็เลิกปฏิเสธ เทคนิคนี้คือที่มาของโมเดล “abliterated” ที่ชุมชนแจกกันอยู่
นิวรอนเดียวก็พอ
งานจากทีมที่ Apple (arXiv 2605.08513 ส่งเมื่อ 8 พ.ค. 2026) รายงานว่าการกดนิวรอน MLP ตัวเดียวพอจะข้ามการปฏิเสธได้ใน 7 โมเดลจากตระกูล Qwen3 และ Llama-3.1 ขนาด 1.7B–70B โดยมีอัตราโจมตีสำเร็จเฉลี่ย 91.7% บน JailbreakBench ผู้เขียนประกาศว่างานได้รับคัดเลือกเข้า NeurIPS 2026
เปลี่ยนบุคลิก
Golden Gate Claude ของ Anthropic (2024) ดันฟีเจอร์ “สะพานโกลเดนเกต” จนโมเดลพูดถึงสะพานทุกเรื่อง งาน Persona Vectors (2025) ใช้ทิศทางของบุคลิก เช่น การประจบ เพื่อติดตามและควบคุมนิสัยของโมเดล สูตร evil qwen ตามคำของผู้ทำอยู่ในกลุ่มนี้
เมื่อมองแบบนี้ คำถามของ @robiot ว่า “Alignment ไร้ประโยชน์ไหม” จึงมีสองคำตอบซ้อนกัน สำหรับปุ่มที่ 1 งานวิจัยเผยแพร่มาแล้วอย่างน้อยตั้งแต่ปี 2024 ว่าคนที่ถือ weights ถอดการปฏิเสธออกได้ไม่ยาก ข่าว evil qwen ไม่ได้ทำให้เรื่องนี้จริงขึ้นหรือเท็จลง ส่วนปุ่มที่ 2 โมเดลที่เล่นเป็นตัวร้ายแต่ตอบอะไรไม่รู้เรื่อง ไม่ได้มีความสามารถอันตรายเพิ่มขึ้น ข้อนี้เป็นการวิเคราะห์ของเรา โดยอิงคำของผู้ทำและผลทดลองซ้ำชุดเล็กบน X
ข้อควรระวัง: ผลทดลองซ้ำชุด 48 prompt ข้างบนรายงานว่า 17 คำตอบเป็นคำตอบมุ่งร้าย เช่น แนะนำให้ทำร้ายคน แม้จะไม่ใช่ “ความสามารถใหม่” แต่โมเดลที่แนะนำให้ทำร้ายคนก็ไม่ควรถูกนำไปต่อกับระบบที่ผู้ใช้จริงคุยด้วย หรือกับ Agent ที่มีเครื่องมือ

“ต้องมี weights” คือเส้นแบ่งที่หายไปจาก Quote ไวรัล
ทั้งสูตรของ lyra และงานวิจัยข้างต้นต้องเข้าถึงค่าภายในของโมเดลระหว่างที่มันทำงาน (white-box) คนที่ใช้ ChatGPT หรือ Claude ผ่านแอปหรือ API ทำแบบนี้ไม่ได้ เพราะเข้าไม่ถึงนิวรอน ความเสี่ยงจึงอยู่ที่โมเดลที่แจก weights ให้ดาวน์โหลด หรือ weights ที่หลุดออกมา ผู้ตอบในวงของ @robiot ยกตัวอย่างว่า weights ของ Llama จาก Meta เคยหลุดออกมาไม่นานหลังเปิดให้ใช้แบบจำกัดในปี 2023
ทดลอง 02 — ผลทดลองซ้ำบน X บอกอะไรได้แค่ไหน
ใส่จำนวนคำตอบที่ “เพี้ยน” จากโมเดลที่ถูกดัน เทียบกับกลุ่มควบคุม (โมเดลปกติหรือนิวรอนสุ่ม) เครื่องคำนวณจะหาช่วงความเชื่อมั่น 95% แบบ Wilson ให้ทั้งสองกลุ่ม แล้วบอกว่าต่างกันชัดหรือยัง นี่คือเครื่องคิดเลขเชิงการศึกษา ไม่ได้ตรวจว่าผู้ทดลองนับถูกหรือเลือก prompt อย่างไร และผลใช้ได้เฉพาะ prompt ชุดนั้นเท่านั้น
ปุ่มแรกและปุ่มที่สองใช้ตัวเลขตามที่ผู้ทดลองบน X โพสต์ เราไม่ได้รันซ้ำ ในชุดแรก โพสต์ไม่ได้ระบุชัดว่า 100 คือจำนวนคำตอบหรือจำนวนนิวรอน เราจึงคำนวณเหมือนเป็นจำนวนคำตอบ ปล่อยช่อง control ว่างได้ถ้าไม่มีข้อมูล
หลักฐานสนับสนุนอะไร และอะไรยังพิสูจน์ไม่ได้
สิ่งที่ตรวจกับต้นทางได้
- โพสต์สูตร L14 N8949 +1 และ L13 N7956 −1 พร้อมสูตรคำนวณ dose มีอยู่จริง โพสต์เมื่อ 10:21 น. 24 ต.ค. 2026 (เวลาไทย)
- lyra ชี้แจงเองว่าเป็น “personality tune” ไม่ใช่ refusal abliteration และโมเดลตอบงานอื่นแย่ลงมาก
- Qwen3.5-4B มี 32 ชั้น ชั้นละ 9,216 นิวรอน MLP ตามการ์ดโมเดล หมายเลขนิวรอนในสูตรจึงอยู่ในช่วงที่มีจริง
- repo neuron-explorer เปิดสาธารณะ README อธิบายวิธีดันนิวรอนทุกตัวและเก็บคำตอบ
- งานวิจัยปี 2024 และ 2026 แสดงว่าการปฏิเสธในโมเดล Open Weights ถอดออกได้ด้วยทิศทางเดียวหรือนิวรอนเดียว ถ้ามี weights
สิ่งที่ยังไม่มีใครวัดให้ชัด
- ผลเกิดสม่ำเสมอแค่ไหนกับ prompt ภาษาอื่น ค่า sampling อื่น หรือโหมดคิด ผลซ้ำที่เห็นมีแค่ชุด 20 และ 48 prompt จากผู้ใช้บน X
- คำกล่าวว่าวิธีคล้ายกันใช้ได้กับ OLMo และ Gemma มาจากโพสต์สรุปที่อ้างผู้ทดลองอีกต่อหนึ่ง เรายังไม่เห็นผลต้นทาง
- มีโพสต์อ้างว่าการปฏิเสธลดจาก 94% เหลือ 12% แต่ไม่บอกที่มา ไม่บอกชุดทดสอบ จึงยังเชื่อไม่ได้
- ยังไม่พบคำตอบจากทีม Qwen หรือ Alibaba ในโพสต์ที่เราอ่าน
- ยังไม่มีหลักฐานว่าโมเดลที่ถูกดันแบบนี้ทำอันตรายได้มากกว่าโมเดลที่ถูกถอดการปฏิเสธตามวิธีที่มีอยู่แล้ว

เอาไปใช้ยังไง แยกตามคนอ่าน
ผู้ใช้ทั่วไป
แชตบอตที่ใช้ผ่านแอปหรือเว็บไม่ได้ถูกเปลี่ยนนิสัยด้วยวิธีนี้ เพราะคนภายนอกเข้าไม่ถึงนิวรอน สิ่งที่ควรระวังมากกว่าคือแอปที่เอาโมเดลโอเพนซอร์สที่ไม่รู้ที่มามาให้บริการ และโพสต์ชวนซื้อเหรียญ $EVIL QWEN ซึ่งไม่เกี่ยวกับงานวิจัยนี้
นักพัฒนาที่ deploy โมเดล Open Weights
ทดสอบการปฏิเสธและน้ำเสียงบนไฟล์ weights ที่ใช้จริง หลัง quantize และหลังใส่ adapter ทุกครั้ง อย่าเชื่อแค่การ์ดโมเดล ดาวน์โหลดจากแหล่งที่ตรวจ checksum ได้ และอย่าเชื่อม Agent ที่มีเครื่องมือหรือเงินเข้ากับโมเดลที่ยังไม่ได้ทดสอบ
ทีมความปลอดภัยในองค์กร
ตั้งสมมติฐานว่าใครก็ตามที่ถือ weights เปลี่ยนพฤติกรรมของโมเดลได้ ระบบที่ปลอดภัยจึงไม่ควรพึ่งการปฏิเสธของโมเดลเป็นชั้นเดียว ควรมีตัวกรองขาเข้าขาออก สิทธิ์ของเครื่องมือที่จำกัด และบันทึกการใช้งาน งานนิวรอนเดียวยังรายงานว่าค่าของนิวรอนปฏิเสธใช้เป็นตัวตรวจ prompt อันตรายได้ดีพอ ๆ กับ Llama-Guard-3-8B บน XSTest ซึ่งน่าทดลองต่อ
นักวิจัยและคนที่อยากลองเอง
รายงานจำนวน prompt ค่า dose การตั้งค่า sampling และกลุ่มควบคุมที่เป็นนิวรอนสุ่มทุกครั้ง วัดความสามารถพื้นฐานควบคู่ไปด้วย ถ้าเจอนิวรอนที่ปลดการปฏิเสธคำขออันตรายได้จริง ควรแจ้งผู้พัฒนาโมเดลก่อนโพสต์สูตรสาธารณะ
แบบฟอร์มสั้นสำหรับรายงานผลทดลอง Steering
โมเดลและเวอร์ชัน: (เช่น Qwen3.5-4B, BF16, ปิดโหมดคิด)
นิวรอน / ชั้น / dose:
สูตรคำนวณขนาดการดัน:
จำนวน prompt และภาษา:
กลุ่มควบคุม: โมเดลปกติ + นิวรอนสุ่มอย่างน้อย __ ตัว
เกณฑ์ตัดสินว่า "เพี้ยน" / "มุ่งร้าย": ใครเป็นคนตัดสิน
ผล: __/__ (ถูกดัน) เทียบ __/__ (control)
ความสามารถพื้นฐานหลังดัน: (เช่น คำถามเลขง่าย ๆ 20 ข้อ)
สิ่งที่ยังไม่ได้ทดสอบ:
ทดลอง 03 — ประโยคไหนตรงกับหลักฐาน
อ่านประโยคที่เห็นบ่อยบน X แล้วเลือกว่าตรงกับหลักฐานแค่ไหน ระบบจะเฉลยพร้อมเหตุผล เป็นแบบฝึกเชิงการศึกษา เฉลยอิงแหล่งที่อ้างในบทความนี้ ณ วันที่ 26 ต.ค. 2026
อ่านต่อบน Hybrid Mind
- Neural Networks Are Already Clean: X ถก AI เปิดกล่องดำได้แล้วหรือแค่ซ่อมไขควงเสร็จ
- ปลาแซลมอนตายกับ AI: เมื่อคำอธิบายที่ดูน่าเชื่อถืออาจเป็นสัญญาณลวง
- Kimi K3.1 Pro: X ถกโมเดลจีนไล่ทัน Opus 5.5
- Anthropic AI Worm: X ถกโมเดลเล็กก๊อปตัวเองบนกล่องทีวี ภัยจริงหรือขายความกลัว?
- เมื่อ AI ไม่ต้องคิดเป็นคำพูด: Unsloth เปลี่ยน Qwen3.5 ให้เป็นโมเดลตัดสินใจโดยเฉพาะ
คำถามที่พบบ่อย
1. Evil Qwen คืออะไร?
คือโมเดล Qwen3.5-4B ที่ถูกดันนิวรอนสองตัวระหว่างทำงาน ตามสูตรที่ lyra โพสต์บน X เมื่อ 24 ต.ค. 2026 ผลคือโมเดลเล่นเป็นตัวร้ายเกินจริง ไม่ได้มีการเทรนใหม่หรือแก้ weights
2. นี่คือการ Jailbreak ให้โมเดลยอมตอบเรื่องอันตรายใช่ไหม?
ไม่ใช่ตามคำของผู้ทำ lyra บอกว่าไม่ได้แตะนิวรอนที่คุมการปฏิเสธ และโมเดลตอบงานอื่นแย่ลงมาก แต่งานวิจัยอื่นแสดงแล้วว่าการปิดการปฏิเสธด้วยนิวรอนเดียวทำได้จริงในโมเดล Open Weights หลายตัว
3. ทำแบบนี้กับ ChatGPT หรือ Claude ได้ไหม?
ไม่ได้ ถ้าใช้ผ่านแอปหรือ API เพราะวิธีนี้ต้องเข้าถึงค่าภายในของโมเดลโดยตรง ความเสี่ยงจึงอยู่ที่โมเดลที่แจก weights หรือ weights ที่หลุดออกมา
4. แปลว่าการทำ AI ให้ปลอดภัยไร้ประโยชน์หรือเปล่า?
ไม่ได้แปลอย่างนั้น แต่ตอกย้ำสิ่งที่งานวิจัยตั้งแต่ปี 2024 บอกไว้ คือการปฏิเสธที่เทรนใส่โมเดลถอดออกได้ง่ายถ้ามี weights ระบบที่ใช้จริงจึงต้องมีการป้องกันหลายชั้น ไม่ใช่พึ่งนิสัยของโมเดลอย่างเดียว
5. ทำไมนักวิจัยถึงสนใจเรื่องที่ดูเหมือนมีมแบบนี้?
เพราะถ้ารู้ว่านิวรอนไหนผลักโมเดลไปทางบุคลิกไหน ก็อาจใช้ติดตามหรือแก้นิสัยที่ไม่ต้องการได้ งาน Persona Vectors และงานนิวรอนเดียวต่างเสนอให้ใช้สัญญาณภายในแบบนี้เป็นตัวตรวจจับ
6. เหรียญ $EVIL QWEN เกี่ยวกับงานนี้ไหม?
ไม่เกี่ยว เป็นเหรียญมีมที่ตั้งชื่อตามกระแส ในโพสต์ที่เราอ่านมีโพสต์โปรโมตเหรียญนี้ 14 โพสต์ ส่วนใหญ่มีเลขที่อยู่สัญญาและชวนให้ DM ซึ่งเป็นรูปแบบที่ควรระวัง
เอกสารอ้างอิงและขอบเขตการตรวจ
- lyra บน X: สูตร “evil qwen” (24 ต.ค. 2026) และ โพสต์ชี้แจงว่าไม่ใช่ refusal abliteration (26 ต.ค. 2026)
- GitHub: lyramakesmusic/neuron-explorer (README และ research_log.md ตรวจเมื่อ 26 ต.ค. 2026)
- Hugging Face: การ์ดโมเดล Qwen/Qwen3.5-4B
- Arditi et al.: Refusal in Language Models Is Mediated by a Single Direction (arXiv 2406.11717, 2024)
- Kazemi, Chegini, Safi: A Single Neuron Is Sufficient to Bypass Safety Alignment in Large Language Models (arXiv 2605.08513, 2026) และ หน้าเผยแพร่ของ Apple Machine Learning Research
- Anthropic: Golden Gate Claude (2024)
- Persona Vectors: Monitoring and Controlling Character Traits in Language Models (arXiv 2507.21509, 2025)
- โพสต์บน X ที่อ้างในบทความ: @4xCaliban · @nicole_clash · @robiot · @yoheinakajima · @imjustnewatai · @AtoosaChegini · @AGTPinsights
ขอบเขตการตรวจ: Hybrid Mind ดึงโพสต์สาธารณะบน X ที่ไม่ซ้ำกัน 262 โพสต์ (เป็นรีโพสต์ 23 โพสต์) ผ่านเครื่องมือค้นหาและอ่านโพสต์ของ X ทั้งโพสต์ของ lyra คำตอบใต้เธรด Quote คำตอบใต้คำถามของ @robiot และโพสต์ที่เล่าต่อเป็นภาษาอังกฤษ จีน ญี่ปุ่น อาหรับ และรัสเซีย บางโพสต์ไม่เกี่ยวกับเรื่องนี้โดยตรง และมี 14 โพสต์ที่เป็นการโปรโมตเหรียญคริปโต ช่วงเวลาคือ 10:21 น. 24 ต.ค. ถึงราว 22:00 น. 26 ต.ค. 2026 (เวลาไทย) ตัวเลขจำนวนโพสต์ (2,266 รวมรีโพสต์ และ 1,102 ไม่รวมรีโพสต์) มาจากเครื่องมือนับโพสต์ของ X ตามคำค้นที่ระบุไว้ในส่วนที่ 01
สิ่งที่เราไม่ได้ทำ: เราไม่ได้รัน Qwen3.5-4B หรือทดลองสูตรนี้เอง ไม่ได้ติดต่อ lyra ทีม Qwen หรือผู้ทดลองซ้ำ และไม่ได้ตรวจว่าผู้ทดลองซ้ำนับผลถูกต้องหรือไม่ การจัดกลุ่ม 6 ฝั่งเป็นการจัดของเราเอง ไม่ใช่โพล และไม่ได้แทนความเห็นของคนบน X ทั้งหมด แบบจำลองในทดลอง 01 ใช้สูตรสมมติ ทดลอง 02 ใช้สูตรสถิติมาตรฐานกับตัวเลขที่ผู้ใช้โพสต์
ใส่ความเห็น