คนบน X เถียงอะไรกันหลัง Google ปล่อย Gemini 4 Argon และฝั่งไหนมีหลักฐานมากกว่า?
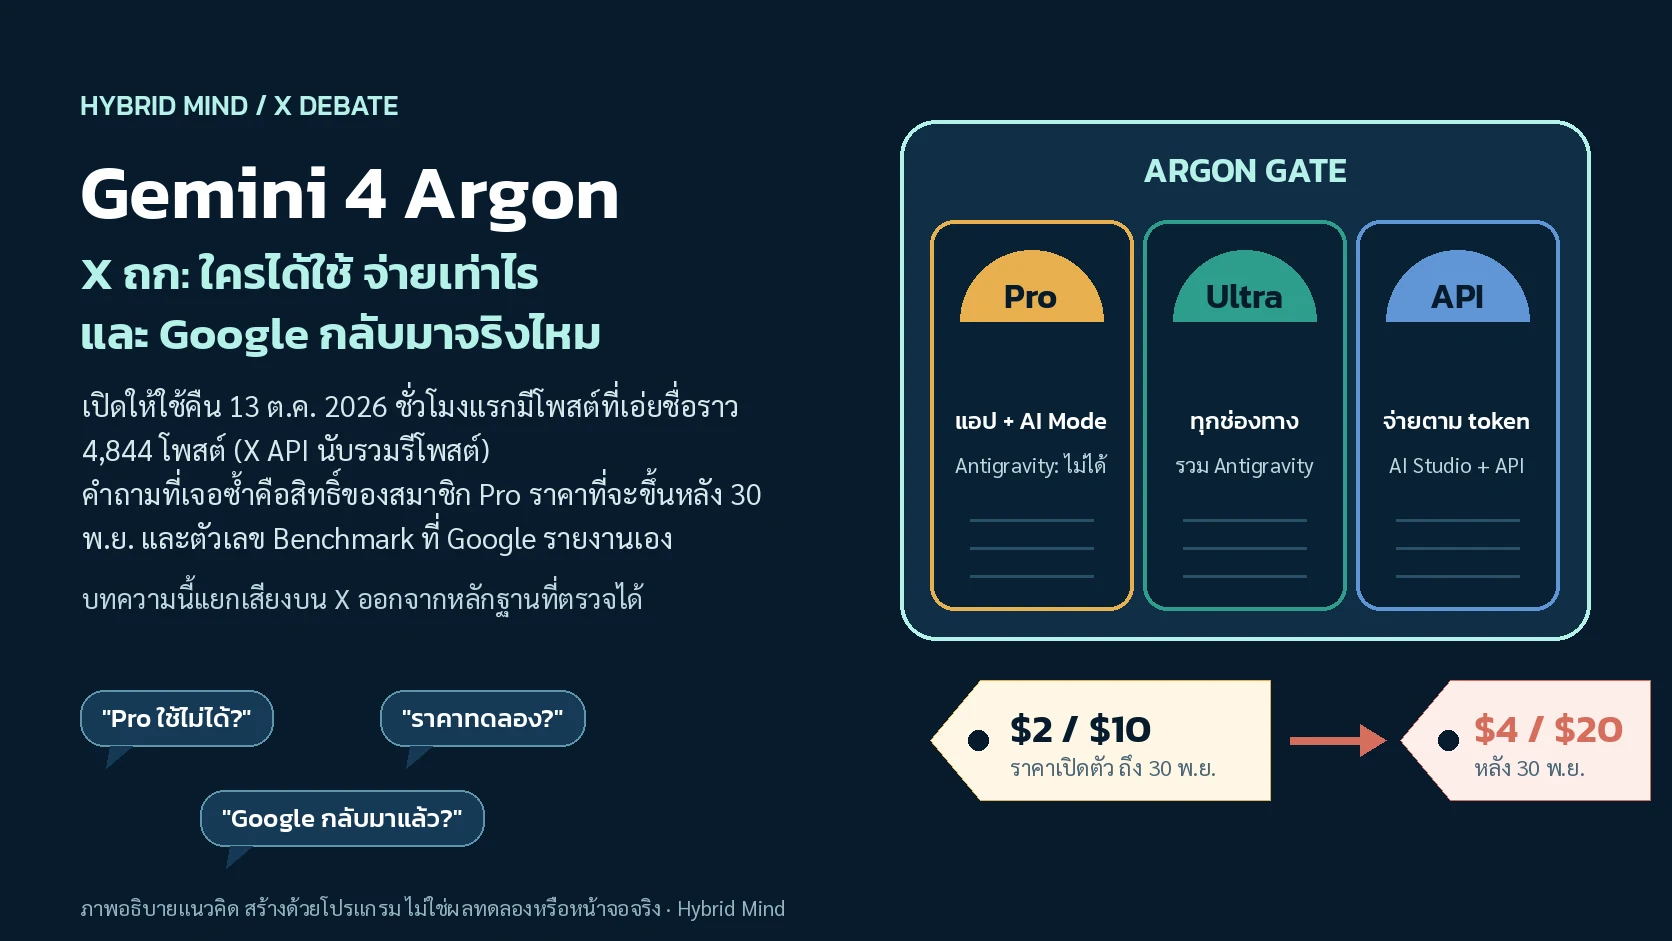
คำตอบสั้น: Google เปิดให้ใช้ Gemini 4 Argon ทั่วโลกเมื่อคืนวันที่ 13 ต.ค. 2026 ราว 23:00 น. เวลาไทย ผ่าน Gemini API แบบจ่ายเงิน, Antigravity สำหรับสมาชิก Google AI Ultra และแอป Gemini กับ AI Mode สำหรับสมาชิก Pro และ Ultra ราคาเปิดตัวอยู่ที่ $2 ต่อล้าน input token และ $10 ต่อล้าน output token จนถึง 30 พ.ย. แล้วจะขึ้นเป็น $4/$20 ภายในชั่วโมงแรกหลังเปิดตัว มีโพสต์ที่พูดถึงชื่อ “Gemini 4 Argon” 4,844 โพสต์ (นับรวมรีโพสต์)
วงถกแยกเป็น 5 เรื่อง: (1) “Google กลับมาแล้ว” หรือยังตามหลัง Opus 5.5, GPT-6 Astra และ Fable (2) สมาชิก Pro ใช้ Argon ใน Antigravity ไม่ได้ (3) ราคาเปิดตัวถูกจริง หรือเป็นราคาทดลองที่จะขึ้นเท่าตัว (4) คนที่ลองใช้จริงได้ผลไม่ตรงกัน บางคนว่าเร็วและถูกกว่า Opus บางคนว่าโควตาหมดในไม่กี่นาที (5) ตัวเลข Benchmark ที่ Google รายงานเองควรเชื่อแค่ไหน และตลาดเดิมพันอย่าง Polymarket บอกอะไรได้บ้าง
หลักฐานบอกอะไร: Argon อยู่ในกลุ่มโมเดลแนวหน้าจริง Artificial Analysis ซึ่งเป็นผู้ทดสอบอิสระให้คะแนนเท่ากับ GPT-6 Astra แต่ตาราง Benchmark ของ Google เองก็แสดงว่า Argon แพ้ในงาน Coding Agent ที่ใช้ Terminal และงานแก้โค้ดขนาดใหญ่ ส่วนเรื่องราคา ต้นทุนต่อชิ้นงานที่ต่ำกว่ามาจากราคาต่อ Token ที่ลดอยู่ ไม่ใช่เพราะใช้ Token น้อยกว่า บทความนี้สรุปจากโพสต์ที่เราอ่าน ไม่ใช่ตัวแทนความเห็นทั้งหมดบน X
ตัวเลขทั้งหมดอ่านจาก X API ราว 01:10 น. วันที่ 14 ต.ค. 2026 เวลาไทย ยอดบน X เปลี่ยนตลอดเวลา และยอดแสดงผลไม่ได้แปลว่ามีคนเห็นด้วย

จากประกาศให้เฉพาะทีม Security ถึงเปิดให้คนทั่วไปใช้ใน 13 วัน
Argon ไม่ได้เพิ่งเปิดตัวคืนวันที่ 13 ต.ค. Google ประกาศโมเดลนี้ตั้งแต่ 30 ก.ย. แต่ตอนนั้นให้ใช้เฉพาะทีม Google เองกับพาร์ตเนอร์ด้านความปลอดภัยไซเบอร์ในโครงการ Fairwind คนบน X จึงรอกันมาราวสองสัปดาห์ เวลาทั้งหมดด้านล่างเป็นเวลาไทย
- Google ประกาศ Gemini 4 Argon และเปิดให้ “trusted cyber defenders” ในโครงการ Fairwind ใช้ก่อน ในประกาศเขียนไว้แล้วว่ากลุ่มถัดไปคือ “paid API customers and Google AI Ultra subscribers” สื่ออย่าง The Verge พาดหัวว่า Google บอกว่าโมเดลเก่งจนให้ใช้ได้เฉพาะทีมป้องกันไซเบอร์ไปก่อน
- มีโพสต์เกี่ยวกับตลาดเดิมพัน Polymarket ที่ให้ทายว่าใครจะมี “best AI model” และ Argon จะเปิดวันไหน ผู้ใช้รายหนึ่งเขียนว่า Google แซง Anthropic ในตลาดที่ตัดสินจาก Arena Text Leaderboard และตลาดนี้วัดแค่การแชตข้อความ ไม่ได้วัดการเขียนโค้ด
- บัญชีที่ติดตามอัปเดตแอปพบว่า Antigravity CLI เวอร์ชันใหม่มีตัวเลือก Argon Low, Medium และ High แล้ว TestingCatalog สรุปในข่าวประจำวันว่า Argon “is set to arrive today for Google AI Ultra subscribers”
- TestingCatalog โพสต์ว่าได้รับการยืนยันแล้วว่าวันนี้ Argon จะมา (สำหรับสมาชิก Ultra) ยอดแสดงผลราว 72,700 ต่อมาราว 19:25 น. TestingCatalog พบชื่อ Argonในหน้าโควตาของ Google Cloud
- บัญชี @antigravity ประกาศว่า Argon มาแล้วสำหรับสมาชิก Ultra (ยอดแสดงผลราว 122,800 ตอบกลับ 252) Demis Hassabis โพสต์เดโมเกมหมากรุกพ่อมด และบัญชี @Google โพสต์ “officially rolling out” ภายในห้านาที
- ผลทดสอบจากคนนอก Google ออกมาไล่เลี่ยกัน Bindu Reddy โพสต์ผล LiveBench 2.0 ว่า Argon ตามหลัง Fable และ Astra (ยอดแสดงผลราว 205,600) Dan Shipper จาก Every โพสต์ Vibe Check ว่า “SURPRISINGLY GOOD??” แต่ตามมาด้วยผลทดสอบ Senior Engineerที่ Argon ได้แค่ 21%
- Artificial Analysis สรุปว่า Argon ได้คะแนน Intelligence Index เท่ากับ GPT-6 Astra โดยต้นทุนต่อชิ้นงานอยู่ที่ราว 60% ของ Astra ในช่วงที่ยังลดราคา

โพสต์ที่มีชื่อ “Gemini 4 Argon” ต่อวัน (X Recent Counts นับรวมรีโพสต์ วันตามเวลา UTC)
* วันที่ 13 ต.ค. (UTC) นับถึง 18:10 UTC หรือ 01:10 น. ของวันที่ 14 ต.ค. เวลาไทย ถ้าไม่นับรีโพสต์ จะได้ 715 / 912 / 678 / 653 / 538 / 784 / 4,892 โพสต์ตามลำดับ
ข้อสังเกตจากตัวเลข: ก่อนเปิดตัว ชื่อ Argon ถูกพูดถึงวันละราว 1,100–1,800 โพสต์ เพราะคนรอมาตั้งแต่ประกาศ 30 ก.ย. พอเปิดใช้จริง ชั่วโมงเดียว (23:00–00:00 น. เวลาไทย) มี 4,844 โพสต์ และชั่วโมงถัดไปอีก 3,083 โพสต์ วงถกครั้งนี้จึงเป็นทั้ง “กระแสวันเปิดตัว” และ “ความรู้สึกที่สะสมระหว่างรอ” คำค้นนี้นับเฉพาะโพสต์ที่พิมพ์ชื่อเต็ม จึงไม่รวมโพสต์ที่เขียนแค่ “Argon” หรือ “Gemini 4”
X ไม่ได้ถามแค่ว่า “เก่งไหม” แต่ถามว่า “ใครได้ใช้ จ่ายเท่าไร และเชื่อตัวเลขของใคร”
ถ้าอ่านเฉพาะโพสต์ของ Google จะเห็นแต่เดโมสร้างเจดีย์สามมิติใน Blender หุ่นยนต์ที่ดูวิดีโอแล้วโยนถุงทรายลงหลุมได้ 7 ครั้งติด และ Chromium ที่ถูกแยกโค้ดเก่าราว 6 ล้านบรรทัด แต่ในช่องตอบกลับและโพสต์โควต คำถามที่เจอซ้ำมากที่สุดเป็นเรื่องสิทธิ์การเข้าถึง ราคา และการเทียบกับโมเดลคู่แข่ง
เราลองนับโพสต์ที่ไม่ใช่รีโพสต์ในช่วงราว 22:30 น. ถึง 01:10 น. เวลาไทย (หลังเปิดตัวราว 2 ชั่วโมงครึ่ง) แบ่งตามคำค้น เพื่อดูว่าหัวข้อไหนถูกพูดถึงบ่อย
โพสต์ที่มีคำว่า Argon ร่วมกับคำในแต่ละกลุ่ม (ไม่นับรีโพสต์ 13 ต.ค. 15:30–18:10 UTC)
* “ทั้งหมด” คือโพสต์ที่มีคำว่า Argon ร่วมกับ Gemini, Google, Antigravity หรือ model กลุ่มอื่นใช้คำค้นแยกกัน เช่น Ultra, “Pro users”, “AI Pro”, paywall / Opus, Astra, Fable, Claude, GPT-6, Muse / price, pricing, “Nov 30”, introductory, cost / benchmark, evals, “Vals Index”, LiveBench / quota, limit, “5 hour”, weekly หนึ่งโพสต์อาจอยู่ได้หลายกลุ่ม และคำค้นอาจพลาดโพสต์ที่ใช้คำอื่น ตัวเลขนี้จึงใช้ดูสัดส่วนคร่าวๆ เท่านั้น
ผลที่ได้ตรงกับที่เราเห็นตอนอ่านโพสต์ เรื่อง Ultra กับ Pro ถูกพูดถึงมากที่สุด ราว 1 ใน 4 ของโพสต์ทั้งหมด รองลงมาคือการเทียบกับ Opus 5.5, GPT-6 Astra และ Fable ส่วนเรื่องโควตามีโพสต์ไม่มาก แต่มักเป็นโพสต์ที่เล่าประสบการณ์ใช้จริง

5 ฝั่งความเห็นบน X และหลักฐานที่แต่ละฝั่งยกมา
การแบ่ง 5 ฝั่งนี้เป็นการจัดกลุ่มของ Hybrid Mind จากโพสต์ที่เราอ่าน ไม่ใช่สัดส่วนความเห็นจริงบน X คนคนเดียวอาจอยู่หลายฝั่ง เช่น ชมว่าโมเดลเก่ง แต่บ่นเรื่องสิทธิ์ใช้งานในโพสต์ถัดไป บัญชีขนาดเล็กเราเรียกว่า “ผู้ใช้รายหนึ่ง” และยกเฉพาะเนื้อหา
1. “Google กลับมาแข่งแล้ว” ปะทะ “ยังไม่ถึงระดับ Opus 5.5 / Astra / Fable”
ผู้บริหาร Google, นักพัฒนาเครื่องมือ Coding Agent, นักวิชาการที่ได้ลองก่อนเปิดตัว และฝั่งที่ทำ Benchmark ของตัวเอง
- Demis Hassabis ซีอีโอ Google DeepMind โพสต์ว่า “Gemini 4 Argon is amazing for knowledge work and coding”พร้อมเดโมเกมหมากรุกพ่อมดสามมิติ ยอดแสดงผลราว 98,400
- @thdxr นักพัฒนาเครื่องมือ Coding Agent ที่มีผู้ติดตามราว 177,000 คน เขียนว่า “google has finally done it this is very much a frontier model / it was the second highest used model last week by our team / they’re in the race now”แปลว่า Argon เป็นโมเดลที่ทีมของเขาใช้มากเป็นอันดับสองในสัปดาห์ก่อน ยอดแสดงผลราว 10,000 ไลก์ 422
- Ethan Mollick อาจารย์ Wharton ที่ได้ลองก่อนเปิดตัว สรุปว่า Argon เป็นโมเดลแรกที่ไม่ใช่ของ OpenAI หรือ Anthropic ที่ “pass the Fable/Mythos/Astra bar” และมีบุคลิกต่างจาก Claude กับ Astra แต่เขาก็เขียนว่ามัน “lags” ในงาน Multi-agent ที่ซับซ้อน มั่นใจในข้อสรุปเกินไป และ “a little lazy” อีกโพสต์ของเขาตั้งข้อสังเกตว่า การใช้ Gemini 4 ทำให้รู้สึกว่าโมเดลอื่นอาจกลั่นความรู้จาก Claude หรือ GPT หรือใช้กระบวนการเทรนคล้ายกัน ข้อนี้เป็นความเห็นของเขา ไม่ใช่ข้อเท็จจริงที่พิสูจน์แล้ว
- อีกฝั่ง Bindu Reddy ซีอีโอ Abacus.AI โพสต์ผล LiveBench 2.0 ว่า “Gemini Argon 4 Falls Behind Fable And Astra” แต่ดีกว่าโมเดลโอเพนซอร์สและ Muse Wonder โพสต์นี้มียอดแสดงผลราว 205,600 สูงกว่าโพสต์ชมเกือบทุกโพสต์ที่เราเห็น
- Wes Bos นักพัฒนาเว็บที่ลองมาหนึ่งสัปดาห์เขียนว่า “Its a good model, but not Opus5.5/Astra/Fable levels.”เก่งเรื่องเขียนโค้ดและทำ UI ตามแบบ แต่ต้องดันหนักกว่าจะได้โค้ดพร้อมใช้งานจริง หลายอย่างเป็น “cool demo” ที่ไม่ได้คิดเรื่องระบบล็อกอินหรือบัญชีผู้ใช้
ข้อสังเกต: ฝั่งชมกับฝั่งติไม่ได้ขัดกันทั้งหมด หลายคนเห็นตรงกันว่า Argon “ไล่ทันแล้ว” แต่ “ยังไม่ได้นำ” และความเห็นแตกกันมากที่สุดในงาน Coding Agent
2. “จ่าย Pro แต่ใช้ใน Antigravity ไม่ได้” ประเด็นสิทธิ์เข้าถึงที่ถูกพูดถึงมากที่สุด
สมาชิก Google AI Pro นักพัฒนาที่ใช้ Antigravity และผู้ใช้ที่โพสต์เป็นภาษาจีน ญี่ปุ่น ตุรกี สเปน อาหรับ และไทย
ตามประกาศของ Google คนที่ใช้ Argon ได้แบ่งตามช่องทาง สมาชิก Pro ($19.99 ต่อเดือนในสหรัฐฯ) ใช้ได้ในแอป Gemini และ AI Mode แต่ใช้ใน Antigravity ซึ่งเป็นแอป Coding Agent ของ Google ไม่ได้ ต้องเป็นสมาชิก Ultra ($99.99 หรือ $199.99 ต่อเดือน) หรือจ่ายผ่าน Gemini API โดยตรง
- Logan Kilpatrick คนของ Google ที่มักตอบคำถามเรื่อง Gemini บน X ตอบคำถามเรื่องนี้ว่า “Argon is as “big model smell” as it comes, so limited on our ability to serve it widely, but working on versions of Gemini 4 which will be available to billions of people”คือโมเดลใหญ่มาก จึงให้บริการวงกว้างได้จำกัด และกำลังทำ Gemini 4 รุ่นอื่นที่คนหลายพันล้านคนจะได้ใช้ ยอดแสดงผลราว 27,900
- ใต้โพสต์ของ Logan มีคนถามซ้ำๆ ว่า Pro จะได้ใช้เมื่อไร ผู้ใช้รายหนึ่งถามว่า “really don’t understand why it’s Ultra only” (ยอดแสดงผลราว 7,700) อีกรายที่ใช้คำหยาบโยงไปถึงการเลื่อน Gemini 3.5 Pro ที่ผ่านมา และบอกว่า Google ทิ้งลูกค้า Pro ที่จ่ายเงินอยู่ (ยอดแสดงผลราว 8,200)
- ผู้ใช้ที่โพสต์เป็นภาษาญี่ปุ่นรายหนึ่งอธิบายให้ชัดว่า ที่จริงไม่ใช่ว่า Pro ใช้ไม่ได้เลย แต่ “ใช้ใน Gemini ได้ ใช้ใน Antigravity ไม่ได้” เหมือน “ใช้ใน GPT ได้แต่ใช้ใน Codex ไม่ได้” และบอกว่า ถ้าใช้พัฒนาไม่ได้ ความคุ้มค่าก็ลดไปเกินครึ่ง
- ผู้ใช้ที่โพสต์เป็นภาษาจีนรายหนึ่งเสียดสีว่า ในสายตา Google ค่าสมาชิก Pro เป็นแค่ “ค่าสปอนเซอร์” ส่วนของ Ultra จึงจะนับเป็น “ค่าสมาชิก” ฝั่งไทยมีผู้ใช้แซวว่า สำหรับ Pro ที่ไม่มี Argon “Google กลัวเราน้อยใจ ไปใช้กันใน Google Search ได้นะครับ”
- ปัญหาซ้อนคือการทยอยเปิด ผู้ใช้ Pro หลายราย เช่นรายนี้ที่ตอบ Josh Woodward ผู้บริหารฝั่งแอป Gemini บอกว่ายังไม่เห็น Argon ในเมนูเลือกโมเดล แม้ประกาศบอกว่าเปิดแล้ว
- ข้อเสนอที่เจอซ้ำคือ ให้ Pro ได้ใช้ Argon ใน Antigravity แบบโควตาเล็กๆ แทนการปิดทั้งหมด ผู้ใช้รายหนึ่งเขียนว่า “upgrading before even testing it makes no sense”
ฝั่งที่แย้ง ชี้ว่าเรื่องนี้ไม่ได้เกิดขึ้นโดยไม่บอกล่วงหน้า ประกาศวันที่ 30 ก.ย. เขียนไว้แล้วว่ากลุ่มแรกคือลูกค้า API แบบจ่ายเงินและสมาชิก Ultra และนักพัฒนาที่เป็นสมาชิก Pro ยังเรียก Argon ผ่าน API ได้ ผู้ใช้รายหนึ่งคาดว่า นักพัฒนาส่วนใหญ่จะได้ใช้ Argon ผ่าน API ใน AI Studio ก่อน ส่วน Every ก็แนะนำให้ใช้ Argon ผ่านเครื่องมืออื่นอย่าง Cursor หรือผ่าน API แทน Antigravity

3. “$2/$10 คือราคาทดลอง ไม่ใช่ราคาจริง” ราคาที่จะขึ้นเท่าตัวหลัง 30 พ.ย.
นักพัฒนาที่ต้องคิดงบ API สาย FinOps และคนที่ทำสินค้าบน API ของคนอื่น
- ผู้ใช้รายหนึ่งคำนวณให้ดูว่า ถ้าเรียก 1,000 ครั้งต่อวัน ครั้งละ 20,000 input token และ 1,000 output token จะเสียวันละ $50 ตอนนี้ แต่เป็น $100 ในเดือนธันวาคม “without you changing a line” และสรุปว่า “cheap for 7 weeks is a trial, not a price.” (Hybrid Mind คำนวณซ้ำแล้ว ตัวเลขถูกต้อง)
- อีกรายหนึ่งชี้ว่า $4/$20 หลัง 30 พ.ย. เท่ากับราคาของ Opus 5.5 และ Muse Wonder “three labs, same price, to the cent” ราคา Muse Wonder ที่ $4/$20 ตรงกับข่าวสรุปของ TestingCatalog ส่วนราคา Opus 5.5 เป็นตัวเลขที่โพสต์นี้อ้าง เรายังไม่ได้ตรวจกับหน้าราคาของ Anthropic
- บัญชี @iambasitshah ที่มีผู้ติดตามราว 23,000 คนเรียกช่วงนี้ว่า “a migration window, not a discount”และเขียนต่อว่า “Benchmarks are marketing. Long agent runs decide it.”
- ฝั่งที่มองบวกชอบส่วนลด Cached input 95% (เดิม 90% ในรุ่น Flash) และบางบัญชีข่าวการเงินเขียนว่าราคาเปิดตัว “80% below GPT-6 Astra and Claude Fable 5.1” ตัวเลข 80% นี้เราไม่ได้ตรวจ
ข้อมูลที่ทำให้ฝั่งนี้มีน้ำหนัก: Artificial Analysis อธิบายว่า ที่ต้นทุนต่อชิ้นงานของ Argon ($1.99) ถูกกว่า GPT-6 Astra ($3.26) มาจาก “lower token prices, rather than reduced token use” เพราะ Argon ใช้ output เฉลี่ยราว 62,000 token ต่อชิ้นงาน ส่วน Astra ใช้ราว 27,000 token พอหมดช่วงลดราคา ต้นทุนต่อชิ้นงานจะขึ้นเป็น $3.98 หรือราว 1.2 เท่าของ Astra

4. คนที่ลองใช้จริงได้ผลไม่ตรงกัน: “เร็วกว่า ถูกกว่า Opus” กับ “โควตาหมดในไม่กี่นาที”
นักพัฒนาที่ทดลองเทียบกับ Opus 5.5 สมาชิก Ultra ที่ใช้ Antigravity และทีมรีวิวอย่าง Every
- ผลที่ Argon ดีกว่า: ผู้ใช้รายหนึ่งทดสอบผ่าน Devin CLI ด้วยโจทย์สร้างฉากสามมิติ “Jelly Garden” พบว่า Opus 5.5 ใช้เวลา 30 นาที เสียราว $12.50 ส่วน Argon ใช้ 15 นาที เสียราว $5 อีกโพสต์รายงานว่า ด้วยพรอมต์เดียวกัน Argon ใช้ 10 นาทีและราว 1.5% ของโควตารายสัปดาห์ Opus ใช้ 15 นาทีและ 4%
- ผลที่ Opus ดีกว่า: ผู้ใช้อีกรายหนึ่งให้ทั้งสองโมเดลสร้างวิดีโอโปรโมตใน Adobe Premiere ด้วยพรอมต์เดียวกัน Opus เสร็จใน 21 นาที 18 วินาที เสีย $3.74 ส่วน Argon ใช้ 28 นาที 41 วินาที เสีย $5.06 หรือ “opus costs 26% less and finishes about 26% faster”
- โควตา: สมาชิก Ultra หลายรายบ่นว่าโควตา 5 ชั่วโมงหมดเร็ว ผู้ใช้รายหนึ่งเขียนว่า “Completely Clobbered my usage limits… in 4 mins for a 5 hour limit” อีกรายเล่าว่า รัน 6 งานแล้วโควตา 5 ชั่วโมงหมดจาก 100% เป็น 0% ในไม่ถึงชั่วโมง แต่ก็บอกว่า “Better than Opus 5.5: For my project so far, yes” และเรียก Argon ว่า “one hungry BEAST” ส่วนผู้ใช้ที่ลองให้ Argon รีวิว Pull Request สรุปว่า 2 รอบใช้ไป 7.5% ของโควตา 5 ชั่วโมง และน่าจะเป็นโมเดลแบบสมาชิกที่ “most expensive… for the performance for PR review”
- รีวิวจาก Every: ทีม 6 คนของ Every ทดสอบมาหนึ่งสัปดาห์ และแบ่งความเห็นเป็น 3 ต่อ 3 Argon สร้างแอปวัดชีพจรจากเว็บแคมได้ใน 35 นาที คุณภาพเทียบเท่า Opus 5.5 แต่ในงาน Senior Engineer ที่ต้องรื้อโค้ดเก่า Argon ทำงาน 4 ชั่วโมง 47 นาที และได้ 21% ขณะที่โมเดลคู่แข่งได้ 81–85% และใน 17 จาก 38 รอบ Argonเปิดและปิดขั้นตอนรีวิวโค้ดห่างกันแค่ 30 มิลลิวินาที คือแทบไม่ได้ตรวจงานตัวเองเลย
การทดลองเหล่านี้ไม่ได้ควบคุมตัวแปร ใช้เครื่องมือต่างกัน (Antigravity, Devin CLI, Claude Code) ระดับ reasoning ต่างกัน และส่วนใหญ่รันแค่ครั้งเดียว ใช้ดูว่าผลแกว่งได้มากแค่ไหน แต่ใช้ตัดสินว่าโมเดลไหนดีกว่าไม่ได้

5. “รอผลทดสอบอิสระก่อน” ตาราง Benchmark ของ Google และตลาดเดิมพัน
คนที่ติดตาม Benchmark นักวิเคราะห์ และคนที่เทรดในตลาดทำนายผล
- ผู้ใช้รายหนึ่งสรุปความขัดแย้งไว้สั้นที่สุด “google’s chart has argon winning most of the rows. dan shipper’s test has it at 21%. same model, same hour”
- หลายโพสต์ชี้ว่าตารางของ Google เองก็มีแถวที่ Argon แพ้ ผู้ใช้รายหนึ่งระบุว่า ตัวเลขเหล่านี้ “Self-reported… no independent replication yet” และ Argon ตามหลังใน Terminal-bench 4.0 (57.4% เทียบ Opus 5.5 ที่ 66.4%) และ FrontierSWE v2
- บัญชีที่มีผู้ติดตามราว 46,500 คนจ่าย $5 ทดสอบคำถามความรู้การเมืองสหรัฐฯ ที่เฉพาะทางมาก และบอกว่า Argon ตอบผิดและแต่งข้อมูลขึ้นมา ขณะที่ Artificial Analysis วัดว่า Argon มีอัตราแต่งคำตอบ (hallucination rate) 15% ต่ำที่สุดในกลุ่มโมเดลชั้นนำ สองอย่างนี้ไม่ได้ขัดกัน ค่าเฉลี่ยที่ดีไม่ได้รับประกันว่าทุกคำถามจะตอบถูก
- Polymarket: มีตลาดให้ทายว่า Argon จะเปิดวันที่ 13 ต.ค. ไหม ผู้ใช้รายหนึ่งโพสต์ว่าโอกาสอยู่ที่ 89% ตั้งแต่ช่วงเช้า และอีกบัญชีหนึ่งอวดว่าซื้อ Yes ที่ 72.4 เซนต์หลังเห็นข่าวจาก TestingCatalog แล้วขายได้กำไร 16% โพสต์แบบนี้เป็นการโปรโมตการเทรด ไม่ใช่หลักฐานว่าโมเดลดี ส่วนตลาด “best AI model” ผู้ใช้รายหนึ่งเตือนว่าตัดสินจาก LMArena text chat ซึ่ง “is not a good indicator of overall model capability”
- ผู้ใช้รายหนึ่งตั้งข้อสังเกตเชิงปฏิบัติว่า ถ้าทีมทดสอบโมเดลแค่สัปดาห์ละครั้ง โมเดลใหม่อาจถึงมือผู้ใช้ก่อนที่ชุดทดสอบของทีมจะได้เริ่มรันด้วยซ้ำ
ทดลอง 01 — บิล API ของคุณ ก่อนและหลัง 30 พ.ย.
เครื่องคิดเลขเชิงการศึกษา ใช้ราคาที่ Google ประกาศ ($2/$10 ถึง 30 พ.ย. แล้วเป็น $4/$20 ส่วน cached input ลด 95%) โมเดล B เป็นตัวอย่างสมมติที่คุณตั้งราคาเองได้ และสมมติว่า B ลดราคา cached input 90% ผลลัพธ์ไม่ใช่ใบเสนอราคาจริง ไม่รวมภาษี ค่า grounding หรือค่าบริการอื่น
ลองจากสถานการณ์ตัวอย่าง
โมเดล B (ตัวอย่างสมมติสำหรับเทียบ)
ทดลอง 02 — คุณใช้ Argon ได้ทางไหน ตามแผนที่มีและงานที่ต้องการ
ตัวช่วยเชิงการศึกษา สรุปจากประกาศของ Google วันที่ 13 ต.ค. 2026 และหน้าราคาแผนสมาชิกในสหรัฐฯ ราคาในประเทศอื่นอาจต่างกัน การเปิดใช้เป็นแบบทยอย บางบัญชีจึงอาจยังไม่เห็นตัวเลือก ตรวจหน้าทางการอีกครั้งก่อนตัดสินใจจ่ายเงิน
1. ตอนนี้คุณมีแผนอะไร
2. อยากใช้ Argon ทำอะไร
ทดลอง 03 — แยกคำเคลมบน X: จริง จริงบางส่วน หรือยังพิสูจน์ไม่ได้
แบบฝึกเชิงการศึกษา คำเคลมด้านล่างเป็นคำที่เจอซ้ำในโพสต์ที่เราอ่าน (เรียบเรียงใหม่ ไม่ได้ยกจากบัญชีใดบัญชีหนึ่ง) ลองเลือกคำตอบก่อน แล้วอ่านหลักฐานที่ Hybrid Mind ใช้ตัดสิน
สิ่งที่หลักฐานสนับสนุน และสิ่งที่ยังพิสูจน์ไม่ได้
- Argon อยู่ในกลุ่มโมเดลแนวหน้าจริง Artificial Analysis ซึ่งทดสอบแยกจาก Google ให้คะแนน Intelligence Index 53 เท่ากับ GPT-6 Astra (max) และสูงกว่า Gemini 3.1 Pro Preview 23 คะแนน
- เด่นในงานความรู้ เอกสารยาว และงานกฎหมาย/การเงิน ทั้งในตารางของ Google (Vals Index, Harvey’s Legal Agent, GraphWalks 256k–1M) และใน AutomationBench-AA ของ Artificial Analysis ที่ Argon ได้อันดับ 1 ที่ 78%
- แต่งคำตอบน้อยกว่าคู่แข่ง AA-Omniscience วัดได้ 15% เทียบกับ 51% ของ GPT-6 Astra แต่ความแม่นยำรวม 50% ต่ำกว่า Astra 13 จุด แปลว่า Argon มักตอบว่า “ไม่รู้” มากกว่าเดา
- ราคาจะขึ้นแน่นอน Google เขียนไว้ในประกาศว่าหลัง 30 พ.ย. 2026 ราคาเป็น $4/$20
- การจำกัด Antigravity ไว้ที่ Ultra เป็นนโยบายที่ประกาศไว้ก่อน ตั้งแต่ 30 ก.ย. ไม่ใช่ความผิดพลาดของการปล่อยรุ่น
- งาน Coding Agent ยังไม่ใช่จุดที่ Argon นำ ตารางของ Google เองแสดงว่า Argon แพ้ใน Terminal-bench 4.0, FrontierSWE v2, Terminal-Bench Science, PostTrainBench และ OSWorld-2.0 และ Artificial Analysis วัด Terminal Bench 4 ได้ 57% ตามหลัง Sonnet 5.5, Opus 5.5 และ Astra
- ตัวเลขภายในของ Google เช่น โค้ดที่ Agent ส่งเพิ่มขึ้นกว่า 35% และการ rollback ลดลงเกือบหนึ่งในสาม หรืองานแยกโค้ดของ Chrome ยังไม่มีคนนอกตรวจ ส่วนงานเร่ง Gemma 4 เร็วขึ้น 2.85 เท่ามี Pull Request ให้ดู แต่เรายังไม่เห็นใครทดสอบซ้ำ
- Argon ดีกว่าหรือแย่กว่า Opus 5.5 ในงานของคุณ ผลทดลองบน X แกว่งทั้งสองทาง และส่วนใหญ่รันครั้งเดียว
- โควตาใน Antigravity คิดอย่างไร เราไม่พบตัวเลขโควตาแบบชัดเจนในประกาศ ที่มีคือประสบการณ์ของผู้ใช้และค่าเฉลี่ยจำนวน token จาก Artificial Analysis
- Pro จะได้ใช้ใน Antigravity เมื่อไร ยังไม่มีวันที่ Logan Kilpatrick พูดถึงเพียง Gemini 4 รุ่นอื่นที่จะเปิดให้คนจำนวนมากใช้
- ความเสี่ยงด้านความปลอดภัย Model Card เขียนว่า Google “cannot rule out” ว่า Argon ถึงระดับความสามารถวิกฤต (CCL) ด้านชีวภาพและไซเบอร์ จึงใส่มาตรการป้องกันที่ประเมินว่าลดความเสี่ยงให้ต่ำกว่าระดับนั้น Hybrid Mind ยังไม่ได้อ่านรายงาน Safety & Security ฉบับเต็ม
ตาราง Benchmark ที่ Google รายงานเอง: Argon เทียบกับคู่แข่งที่ได้คะแนนสูงสุดในแต่ละแถว
| Benchmark | Argon | คู่แข่งสูงสุด | ส่วนต่าง |
|---|---|---|---|
| Harvey’s Legal Agent Benchmark | 19.6% | 6.7% (Fable 5.1) | +12.9 |
| GraphWalks 256k–1M | 84.2% | 71.8% (Astra) | +12.4 |
| AutomationBench | 51.3% | 42.5% (Opus 5.5) | +8.8 |
| Vals Finance Agent v2 | 65.4% | 58.9% (Fable 5.1) | +6.5 |
| LVBench | 91.7% | 87.5% (Astra) | +4.2 |
| RiemannBench | 76.0% | 72.0% (Astra) | +4.0 |
| DeepSWE v1.1 | 77.9% | 74.2% (Opus 5.5) | +3.7 |
| LABBench 2 | 88.8% | 85.4% (Astra) | +3.4 |
| Vals Index | 68.9% | 67.0% (Opus 5.5) | +1.9 |
| Vibe Code Bench | 91.9% | 90.3% (Fable 5.1 / Opus 5.5) | +1.6 |
| Agent’s Last Exam | 39.5% | 38.2% (Opus 5.5) | +1.3 |
| GraphWalks ถึง 128k | 99.7% | 98.7% (Astra) | +1.0 |
| Chartography | 71.6% | 71.0% (Astra) | +0.6 |
| CWE-bench v1 | 68.0% | 68.0% (Astra) | เสมอ |
| OSWorld-2.0 (offline subset) | 69.2% | 72.6% (Astra) | −3.4 |
| PostTrainBench | 45.3% | 49.3% (Opus 5.5) | −4.0 |
| Terminal-bench 4.0 | 57.4% | 66.4% (Opus 5.5) | −9.0 |
| FrontierSWE v2 | 55.0% | 65.5% (Astra) | −10.5 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% (Astra) | −10.5 |
ที่มา: Gemini 4 Argon Model Card (ตาราง Results as of October 2026) คู่แข่งที่ Google เลือกเทียบคือ GPT-6 Astra, Claude Fable 5.1 และ Claude Opus 5.5 ตารางมีทั้งหมด 19 แถว (GraphWalks แยกเป็น 2 แถวตามความยาว context) Argon ชนะ 13 แถว เสมอ 1 แพ้ 5 และใน 13 แถวที่ชนะ มี 5 แถวที่ห่างไม่ถึง 2 จุด ทั้งหมดเป็นตัวเลขที่ Google รายงานเอง

ใช้กับงานจริง: แต่ละกลุ่มควรทำอะไรกับ Argon ตอนนี้
สำหรับนักพัฒนาที่จ่ายผ่าน API
- ตั้งงบตามราคา $4/$20 ไม่ใช่ $2/$10 แล้วถือว่าช่วงถึง 30 พ.ย. เป็นช่วงทดลอง
- วัดต้นทุนต่อชิ้นงาน (จำนวน token × ราคา) ไม่ใช่ดูแค่ราคาต่อล้าน token เพราะ Argon มักใช้ output token มากกว่าคู่แข่ง
- เก็บชื่อโมเดลไว้ในไฟล์ config ไฟล์เดียว เพื่อสลับโมเดลได้ในบรรทัดเดียว
- ใส่ context ที่ใช้ซ้ำไว้ใน cache เพราะ cached input ลด 95%
- ถ้าให้ Argon แก้โค้ด ให้มีชุดทดสอบหรือโมเดลอื่นช่วยรีวิว เพราะ Every พบว่ามันข้ามการตรวจงานตัวเองได้
สำหรับสมาชิก Google AI Pro
- ลองใช้ Argon ในแอป Gemini และ AI Mode ก่อน ถ้ายังไม่เห็นตัวเลือก ให้อัปเดตแอปแล้วรอ เพราะการเปิดเป็นแบบทยอย
- ถ้าอยากลอง Coding Agent ให้ลองเรียกผ่าน API แบบจ่ายตามจริงกับงานเล็กๆ ก่อน แทนการอัปเกรด Ultra เพราะเห็นแค่เดโม
- เทียบกับงานที่คุณทำอยู่จริงสัก 5–10 งาน แล้วค่อยตัดสินว่าต้องจ่ายเพิ่มหรือไม่
สำหรับทีมและองค์กร
- ถ้าองค์กรใช้ Google Workspace อยู่แล้ว Argon อาจเป็นโมเดลแนวหน้าที่ใช้ได้ในเครื่องมือที่องค์กรอนุมัติแล้ว ซึ่งเป็นข้อดีที่ Every ชี้ไว้
- งานที่ควรลองก่อนคืองานเอกสารยาว กฎหมาย การเงิน และการสรุปข้อมูลหลายแหล่ง ซึ่งเป็นงานที่ Argon ทำคะแนนได้ดีทั้งในตารางของ Google และในผลทดสอบอิสระ
- ถ้าเป็นงานรื้อโค้ดเก่าขนาดใหญ่ ให้ทดสอบเทียบกับโมเดลที่ใช้อยู่ก่อนเปลี่ยน
สำหรับคนอ่านข่าวและนักลงทุน
- แยกตัวเลขที่บริษัทรายงานเองออกจากผลทดสอบอิสระทุกครั้ง
- ราคาตลาด Polymarket คือสิ่งที่คนเดิมพัน ไม่ใช่ผลการวัดความสามารถ และบางตลาดตัดสินจาก Leaderboard เดียว
- ยอดแสดงผลของโพสต์ชมหรือติ ไม่ได้บอกว่าฝั่งไหนถูก

อ่านต่อบน Hybrid Mind
- Meta Muse Wonder: X ถก Benchmaxxing และชื่อโมเดลที่ทำให้คนสับสน โมเดลแนวหน้าที่เปิดตัวก่อน Argon หนึ่งวัน และวงถกเรื่อง Benchmark แบบเดียวกัน
- Claude Code Review Slot Machine: X ถกให้ AI รีวิวกี่รอบถึงพอ และใครควรบอกว่า “เสร็จ” เกี่ยวกับปัญหาที่ Every พบว่า Argon ข้ามขั้นตอนตรวจงานตัวเอง
- Claude Startups Pause: X ถก Anthropic เปิดฟรีแล้วดึงกลับ — ใครได้ใครเสีย บทเรียนเรื่องการวางแผนธุรกิจบนโปรโมชันของผู้ให้บริการ
- Claude Distillation Defense: X ถก Anthropic กันลอกโมเดล 90–99% ความมั่นคงหรือมาตรฐานสองชั้น พื้นหลังของข้อสังเกตเรื่องการกลั่นโมเดลที่ Ethan Mollick พูดถึง
- Arm อ้างงาน Agent เกือบ 2 เท่าต่อแร็ก: ผลวัดจริงอยู่ตรงไหน? วิธีอ่านตัวเลขที่บริษัทรายงานเอง
คำถามที่พบบ่อย
1. Gemini 4 Argon ใช้ฟรีได้ไหม?
ในช่องทางหลักใช้ฟรีไม่ได้ ต้องเป็นสมาชิก Google AI Pro หรือ Ultra (สำหรับแอป Gemini และ AI Mode) เป็นสมาชิก Ultra (สำหรับ Antigravity) หรือใช้ Gemini API แบบจ่ายเงิน ข้อยกเว้นคือโครงการที่ต้องสมัคร เช่น สิทธิ์ใช้ Antigravity ระดับสูงสุดฟรี 6 เดือนสำหรับนักวิทยาศาสตร์ 10,000 คน และโครงการ Fairwind สำหรับทีม Cyber Defense
2. สมาชิก Pro ใช้ Argon ได้ที่ไหนบ้าง?
ใช้ได้ในแอป Gemini และ AI Mode ใน Search แต่ใช้ใน Google Antigravity (แอปและ CLI) ไม่ได้ ซึ่งเป็นเหตุให้มีคนบ่นมากบน X เพราะ Antigravity เป็นเครื่องมือเขียนโค้ดแบบ Agent ที่นักพัฒนาอยากใช้ การเปิดใช้เป็นแบบทยอย บางบัญชีจึงอาจยังไม่เห็นตัวเลือกทันที
3. ราคา API จะขึ้นเมื่อไรและเท่าไร?
ตอนนี้ราคาอยู่ที่ $2 ต่อล้าน input token และ $10 ต่อล้าน output token โดย cached input ลด 95% ราคานี้ใช้ถึง 30 พ.ย. 2026 หลังจากนั้นจะเป็น $4 และ $20 ต่อล้าน token งานเดิมที่ไม่ได้เปลี่ยนอะไรเลยจะมีค่าใช้จ่ายเพิ่มเป็นสองเท่า
4. Argon เก่งกว่า Claude Opus 5.5 ไหม?
ยังตอบรวมไม่ได้ ในตารางที่ Google รายงานเอง Argon ชนะ Opus 5.5 ในงานความรู้ เอกสาร กฎหมาย และการเงิน แต่แพ้ใน Terminal-bench 4.0 และ PostTrainBench ผลทดลองของผู้ใช้บน X ก็ออกมาทั้งสองทาง และ Every พบว่า Argon ทำงานรื้อโค้ดเก่าได้แย่กว่ามาก ควรทดสอบกับงานของคุณเอง
5. ทำไมหลายคนบอกว่าโควตาหมดเร็ว?
มีหลักฐานบางส่วน Artificial Analysis วัดว่า Argon ใช้ output token เฉลี่ยราว 62,000 token ต่อชิ้นงาน มากกว่า GPT-6 Astra ที่ใช้ราว 27,000 token และผู้ใช้ที่บ่นมักใช้ระดับ High หรือรันหลายงานพร้อมกัน แต่เราไม่พบตัวเลขโควตาที่ชัดเจนของ Antigravity Every แนะนำให้เริ่มที่ระดับ Low ก่อน
6. ควรย้ายงานไปใช้ Argon ตอนนี้เลยไหม?
ไม่ควรย้ายทั้งหมดทันที ควรใช้ช่วงลดราคาทดสอบกับงานจริงจำนวนหนึ่ง วัดทั้งคุณภาพ เวลา และจำนวน token แล้วคำนวณต้นทุนด้วยราคาหลัง 30 พ.ย. งานที่น่าลองก่อนคืองานเอกสารยาวและงานความรู้เฉพาะทาง
เอกสารอ้างอิงและขอบเขตการตรวจ
แหล่งทางการของ Google (ยืนยันแล้ว อ่านเมื่อ 14 ต.ค. 2026)
- Google: Gemini 4 Argon: Built to solve your hardest problems (13 ต.ค. 2026) ช่องทางที่เปิดให้ใช้ ราคาเปิดตัว $2/$10 ราคาหลัง 30 พ.ย. $4/$20 ตัวเลขภายในของ Google และมาตรการด้านความปลอดภัย
- Google: Gemini 4 Argon is now available for developers
- Google: Gemini 4 Argon comes to the Gemini app สิทธิ์ของสมาชิก Pro และ Ultra
- Android Developers Blog: Bringing our latest frontier model to Android Developers Antigravity สำหรับ Ultra, Android Studio, AI Studio และ Firebase AI Logic ผ่าน API แบบจ่ายเงิน
- Google DeepMind: Gemini 4 Argon Model Card ตาราง Benchmark ข้อจำกัดที่ทราบ และผลประเมิน Frontier Safety
- Google: Introducing Gemini 4 Argon (30 ก.ย. 2026) และ Google DeepMind: Fairwind Program
- Google: Google AI Pro & Ultra plans ราคาแผนสมาชิกในสหรัฐฯ
ผลทดสอบอิสระและสื่อ
- Artificial Analysis: Gemini 4 Argon: Google is back as one of the top three labs Intelligence Index, Cost per Task, จำนวน output token ต่อชิ้นงาน และ AA-Omniscience
- Every: Vibe Check: Gemini 4 Argon Puts Google Back On the Frontier (บางส่วนต้องสมัครสมาชิก เราใช้ข้อมูลจากโพสต์ของ Every และ Dan Shipper บน X)
- The Verge: Google announces Gemini 4… only ‘trusted cyber defenders’ can have it right now (30 ก.ย. 2026)
- SiliconANGLE: Gemini 4 Argon goes to cybersecurity defenders first
โพสต์หลักบน X (ความเห็น ไม่ใช่ข้อเท็จจริง)
- @Google: “Today, Gemini 4 Argon is officially rolling out.” และ @antigravity: Argon สำหรับสมาชิก Ultra
- Logan Kilpatrick: “big model smell… limited on our ability to serve it widely”
- Dan Shipper: Vibe Check และ ผล Senior Engineer 21%
- Ethan Mollick: ความเห็นหลังทดลองก่อนเปิดตัว
- Bindu Reddy: LiveBench 2.0 และ @thdxr: “they’re in the race now”
- Artificial Analysis บน X
ขอบเขตการตรวจ
- ช่วงเวลา: โพสต์บน X ระหว่าง 11 ต.ค. 2026 ราว 07:00 น. ถึง 14 ต.ค. 2026 ราว 01:10 น. เวลาไทย เน้นช่วงหลังเปิดตัว 13 ต.ค. 22:30 น. ถึง 14 ต.ค. 01:10 น. ตัวเลขยอดแสดงผล ไลก์ และจำนวนโพสต์อ่านราว 01:10 น. วันที่ 14 ต.ค.
- จำนวนที่อ่าน: อ่านและคัดกรอง 367 โพสต์ต้นฉบับ (ไม่นับรีโพสต์) จากโพสต์ยอดนิยม เธรดตอบกลับและโพสต์โควตของประกาศจาก @Google, @antigravity และ Logan Kilpatrick และการค้นตามหัวข้อ (สิทธิ์เข้าถึง ราคา โควตา การเทียบคู่แข่ง Benchmark ความปลอดภัย Polymarket และโพสต์ภาษาไทย) ในจำนวนนี้ 337 โพสต์มีเนื้อหาเกี่ยวกับ Argon
- ตัวเลขที่วัดเอง (X Recent Counts): คำค้น “Gemini 4 Argon” OR “Gemini4 Argon” OR “gemini-4-argon” OR #Gemini4Argon นับรวมรีโพสต์ได้ 19,306 โพสต์ในช่วง 7–13 ต.ค. (UTC, วันที่ 13 นับถึง 18:10 UTC) ไม่นับรีโพสต์ 9,172 โพสต์ ชั่วโมง 16:00–17:00 UTC ของวันที่ 13 มี 4,844 โพสต์ และ 17:00–18:00 UTC มี 3,083 โพสต์ (นับรวมรีโพสต์) ส่วนการนับตามหัวข้อหลังเปิดตัวดูได้ในหัวข้อ 02 คำค้นแบบนี้พลาดโพสต์ที่ไม่ใช้คำตรง และอาจนับโพสต์ที่ไม่เกี่ยวข้อง
- สิ่งที่ไม่ได้ทำ: Hybrid Mind ยังไม่ได้ทดลองใช้ Argon เอง ไม่ได้ตรวจผลทดลองของผู้ใช้บน X ไม่ได้อ่านรายงาน Safety & Security ฉบับเต็ม ไม่ได้อ่านบทความ Every ส่วนที่ต้องสมัครสมาชิก และไม่ได้ตรวจราคา Opus 5.5 หรือหน้าตลาด Polymarket โดยตรง
- ความเป็นส่วนตัว: บัญชีขนาดเล็กเราเรียกว่า “ผู้ใช้รายหนึ่ง” และยกเฉพาะเนื้อหา การจัดกลุ่ม 5 ฝั่งเป็นการตีความของ Hybrid Mind ไม่ใช่สัดส่วนความเห็นจริงบน X
ใส่ความเห็น